CausalRAG2: Hierarchical Causal Knowledge Graph Design for RAG
모듈 경계를 건너되, ‘인과’라는 말을 좁게 읽기: CausalRAG2
CausalRAG2는 계층형 지식 그래프의 멀어진 모듈을 LLM 기반 causal gate로 잇고, 질의 뒤에는 관련 경로만 다시 고르는 RAG다. 여기서 인과는 관측 데이터에서 발견한 원인이 아니라 텍스트의 논리·사건 의존성을 가리킨다.
Paper: Nengbo Wang; Tuo Liang; Vikash Singh; Chaoda Song; Van Yang; Yu Yin; Jing Ma; Jagdip Singh; Vipin Chaudhary (2026). "CausalRAG2: Hierarchical Causal Knowledge Graph Design for RAG." arXiv:2602.05143v2, ICML 2026. PDF
1. 두 가지 검색 실패를 겨냥한다
큰 지식 그래프는 비슷한 항목끼리 덩어리를 이룬다. 이것은 검색 범위를 줄이는 데는 좋지만, 답에 필요한 근거가 다른 덩어리에 있으면 시작 노드 주변만 맴돌 수 있다. 저자들은 이를 information isolation, 즉 recall이 빠지는 문제라고 부른다. 반대로 관련 주제라는 이유만으로 많은 노드를 따라가면, 답과 무관한 문맥이 섞여 precision이 떨어진다.
CausalRAG2는 이 두 문제를 순서대로 다룬다. 먼저 그래프를 여러 수준의 모듈로 나누고, 멀리 떨어졌지만 논리적으로 이어질 가능성이 있는 모듈 사이에 gate를 만든다. 질의 때는 세부 엔티티와 상위 모듈을 함께 출발점으로 삼아 gate를 건너 확장한다. 마지막으로 LLM이 후보 subgraph에서 질문의 설명 경로에 맞는 항목만 남긴다. 넓혀서 놓친 근거를 줄이고, 다시 좁혀 노이즈를 줄이는 구조다.
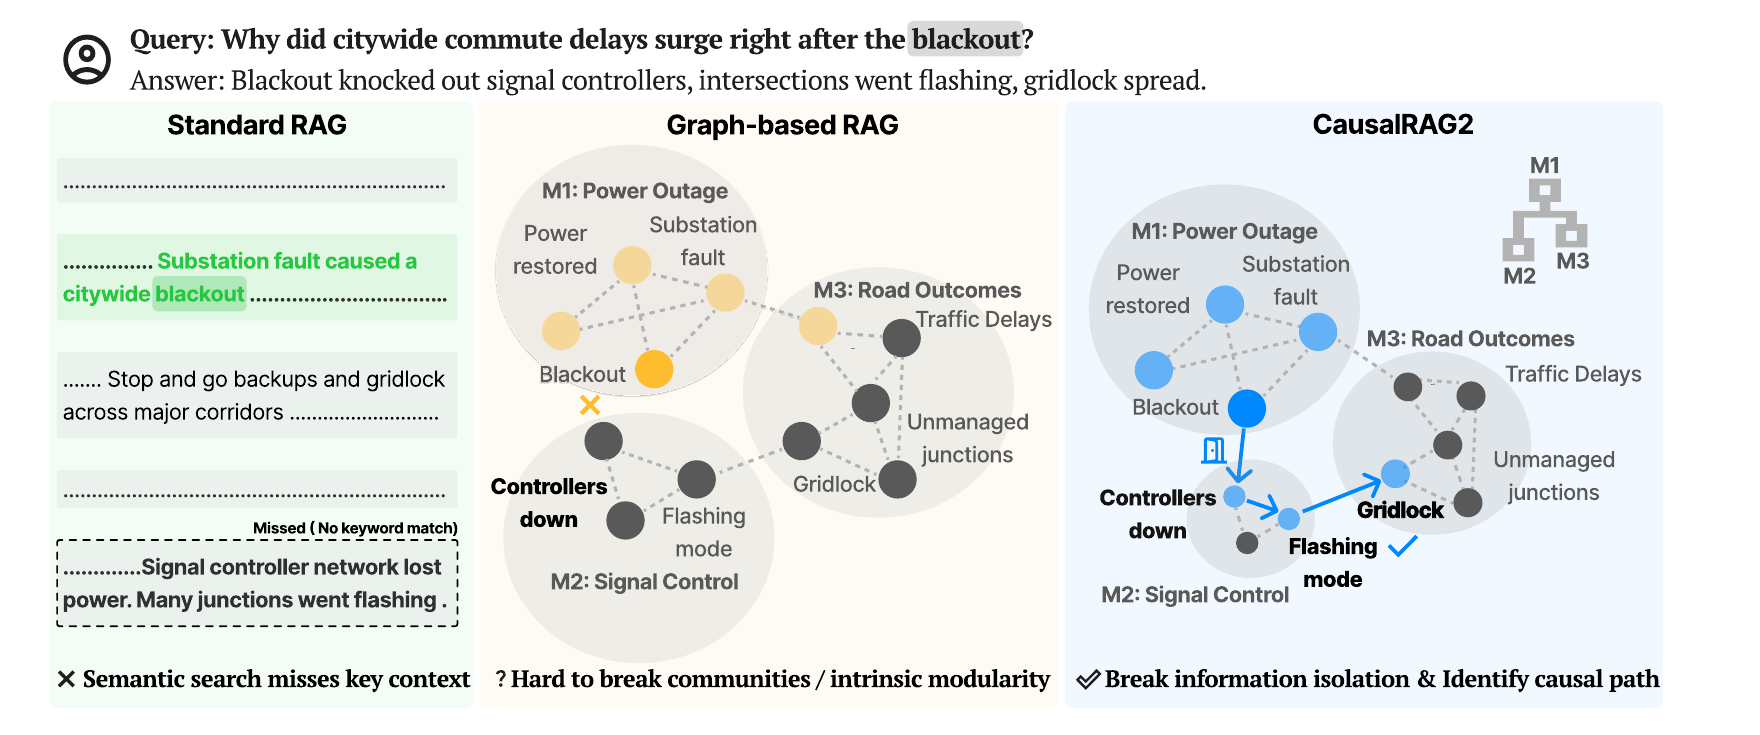
그림 1. Wang et al., Figure 1, arXiv:2602.05143v2 PDF p. 2의 원도판 크롭. 정전 뒤 교통 정체를 묻는 예에서 semantic retrieval, 일반 graph grouping, CausalRAG2의 gate 경로를 비교한다. 문제를 설명하는 도식이며, 모든 질의에서 인과 경로가 유일하게 정해짐을 보여주지는 않는다. CC BY 4.0.
2. 계층과 gate는 어떻게 만들어지는가
오프라인 단계에서 문서에서 엔티티 그래프를 만들고, Leiden 알고리즘으로 반복 분할해 아래에는 세부 사실, 위에는 큰 모듈이 있는 계층을 만든다. 각 모듈 요약은 상위 수준의 검색 닻 역할을 한다. 그 뒤 후보 모듈 쌍의 요약을 LLM에 주고 “인과 연결이 가능한가”를 묻는다. 긍정이면 두 모듈에 binary, undirected gate를 둔다.
모든 모듈 쌍을 비교하면 비용이 제곱으로 늘 수 있다. 논문은 top-down hierarchical pruning으로 후보를 줄인다. 따라서 계층형이라는 말만으로 색인비나 질의비가 작아지는 것은 아니다. 이 방법은 계층 구성, 모듈 요약, gate 판단이라는 추가 작업을 먼저 감수하고, 이후 검색 공간을 제어한다.
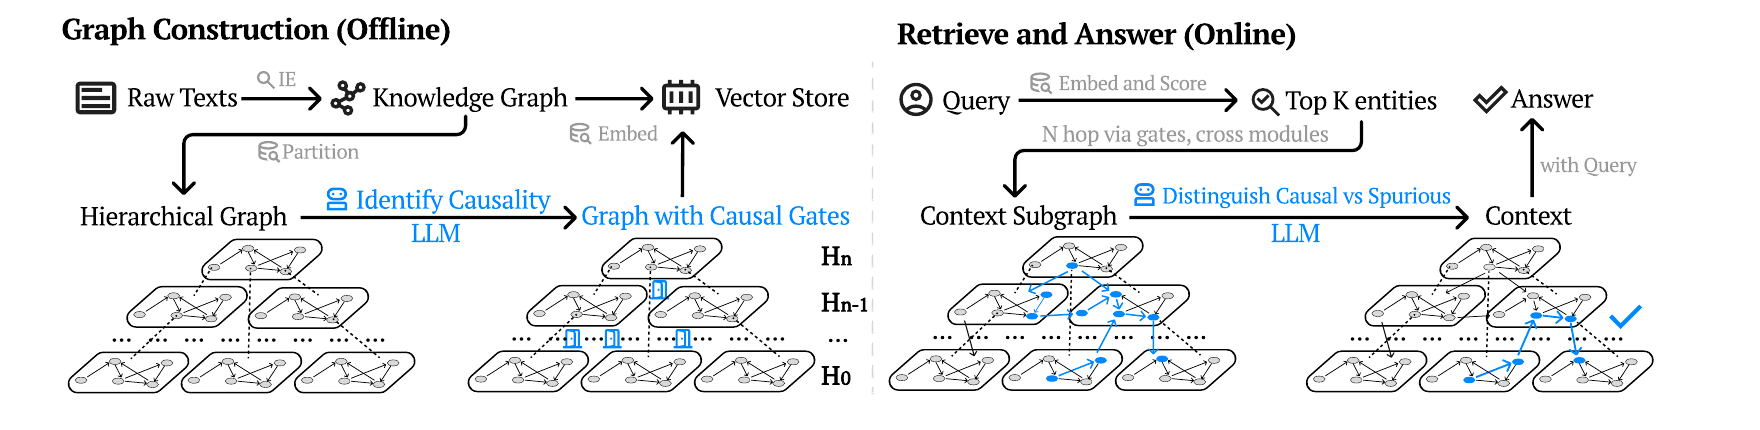
그림 2. Wang et al., Figure 2, arXiv:2602.05143v2 PDF p. 5의 원도판 크롭. 기본 그래프와 계층·gate를 만드는 오프라인 단계, 다층 seed와 gated traversal 뒤 LLM filtering을 수행하는 온라인 단계를 보라. gate는 sparse shortcut이며 모듈의 모든 원문 근거를 자동으로 검증하는 장치는 아니다. CC BY 4.0.
3. 여기서 ‘인과’가 뜻하는 것
이 논문은 ‘인과’의 뜻을 좁혀 쓴다. causal은 관측 자료에서 개입 효과를 추정하거나 숨은 교란을 통제해 식별한 인과관계가 아니다. 저자 정의상 텍스트에 서술된 명시적 논리 의존성과 사건 순서다. 또한 gate는 방향 없는 이진 연결이다. 실제 원인에서 결과로 향하는 인과 그래프를 복원했다고 이해하면 안 된다.
예컨대 “정전 → 신호 제어기 고장 → 점멸등 → 교통 정체”가 문서에 적혀 있다면, 이것을 설명 경로로 선택하도록 LLM을 유도한다. 그러나 같은 문서가 공통 원인, 반례, 시간 순서의 예외를 빠뜨렸다면 retrieval graph도 그 한계를 물려받는다. final prompt가 제공된 근거만 쓰도록 지시하는 것은 생성의 범위를 제한하는 장치이지, 근거 라벨 자체의 진실성을 보증하지는 않는다.
4. 실험 결과는 어떤 조건에서 나왔나
저자들은 MS MARCO, Natural Questions, HotpotQA, 2WikiMultiHopQA, QASC와 새 HolisQA를 평가했다. HolisQA는 다섯 학술 분야의 복합 이해를 겨냥한다. Table 3에서 다섯 HolisQA 분야를 단순 평균하면 CausalRAG2는 F1 39.76, Context Recall 64.21, Answer Relevancy 62.25이다. 이 평균은 표의 셀을 요약한 값이며 저자가 별도 통계 추정량으로 제시한 수치는 아니다.
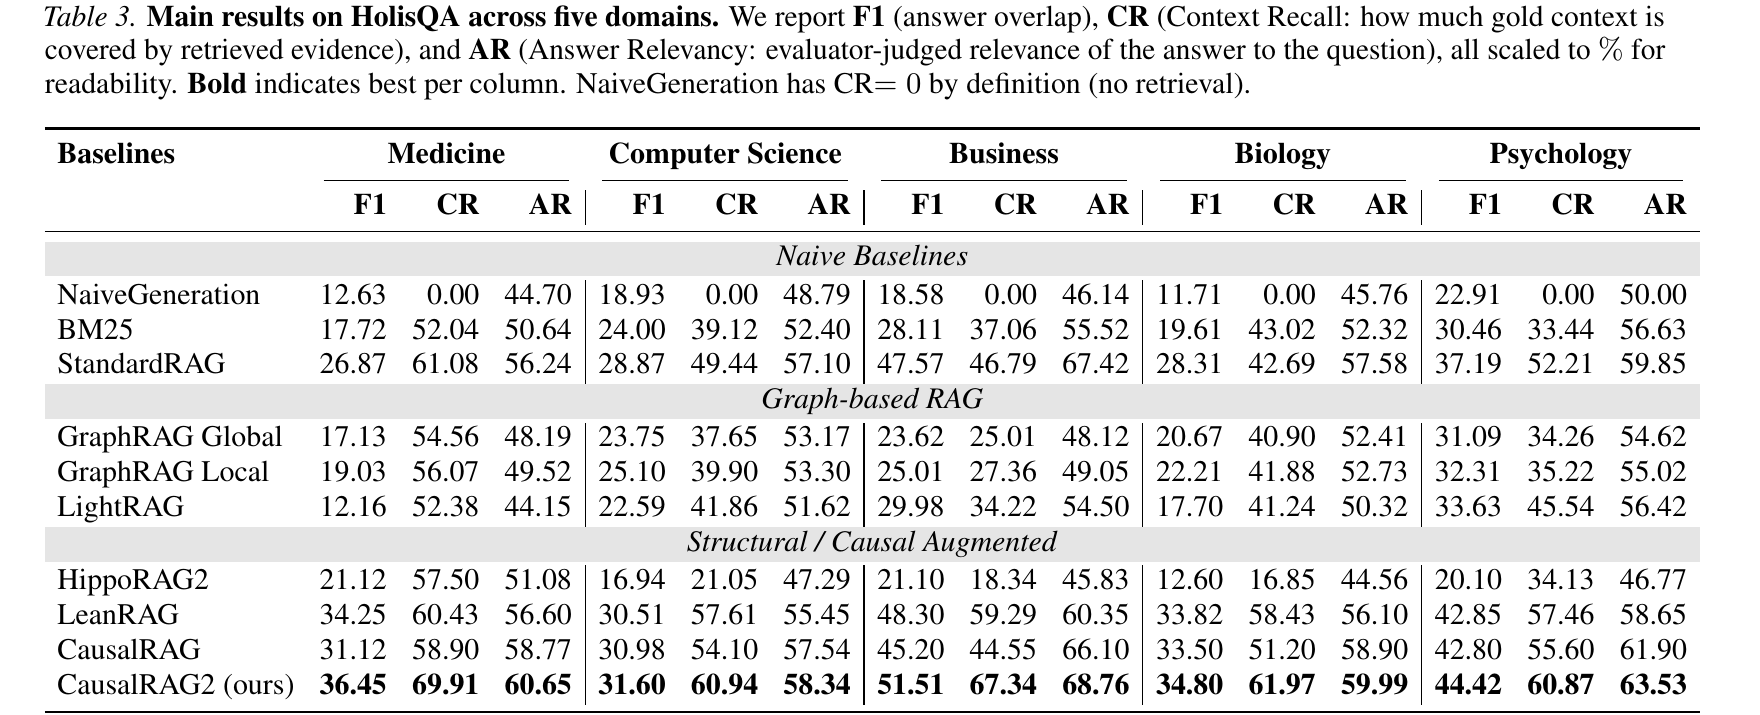
그림 3. Wang et al., Table 3, arXiv:2602.05143v2 PDF p. 7의 원도판 크롭. 다섯 HolisQA 도메인에서 F1, Context Recall, Answer Relevancy를 함께 읽어야 한다. 어떤 한 지표의 최고값을 일반적 정확도나 인과 식별 성능으로 바꾸어 해석할 수 없다. CC BY 4.0.
구성요소 제거에서는 hierarchy와 gate를 넣으면 recall을 넓히고, spurious-aware filtering을 더하면 precision 성격의 지표가 회복된다는 경향을 보고한다. 표준 QA에서는 15개 셀 가운데 11개 최고라는 저자 요약이지만, 모든 데이터셋·지표에서 일등은 아니다. 현재 v2의 한계 절에서도 hierarchy 깊이는 downstream task에 맞춰 최적화하지 않았고, HolisQA의 다섯 학술 영역 밖 일반화가 더 필요하다고 적는다.
5. 적용할 때의 체크 항목
이 방법은 모듈 간 연결이 실제로 자주 필요한 긴 문서 집합과 경로 설명을 사람에게 보여줘야 하는 경우에 맞는다. 도입 전에는 LLM이 만든 gate를 표본 감사하고, gate가 없는 baseline·무작위 gate·semantic gate와 같은 budget에서 비교하는 편이 좋다. 법률, 의학, 정책 자료처럼 ‘원인’이라는 표현이 결정을 바꾸는 분야라면 문서 라벨을 causal discovery 결과로 취급하지 말고, 출처 문장과 전문가 검토를 별도로 둬야 한다.
6. 정리
CausalRAG2는 계층형 graph의 강점과 약점을 함께 다룬다. 모듈 경계를 넘기 위해 LLM gate를 쓰고, 늘어난 후보를 다시 경로 filtering으로 줄인다. 이 설계는 텍스트에 적힌 논리·사건 의존성을 검색에 활용한다. 여기서 ‘causal’은 그런 뜻이다. 실제 세계의 원인과 결과를 식별했다는 뜻은 아니며, 성능 결과도 해당 벤치마크와 LLM 기반 라벨·판정 조건 안에서 읽어야 한다.
References
Wang, N., Liang, T., Singh, V., Song, C., Yang, V., Yin, Y., Ma, J., Singh, J., & Chaudhary, V. (2026). CausalRAG2: Hierarchical causal knowledge graph design for RAG (arXiv:2602.05143v2). arXiv. https://doi.org/10.48550/arXiv.2602.05143