IC2S2 2026 프로그램은 무엇을 검증하나: LLM 전환 그다음의 측정·타당성 국면
IC2S2 2026 프로그램에서 두드러진 의제: LLM을 쓰기 전에 검증하는 학회
IC2S2 2026 공식 프로그램은 LLM을 사회과학 도구로 쓰는 발표를 유지하면서도, 설문 시뮬레이션·주석·생성 에이전트의 타당성 측정과 보정에 주요 세션을 배정했다. 이 글은 발표 제목과 편성에서 읽은 동향이며 전수 논문 분석은 아니다.
Sources: International Conference on Computational Social Science (IC2S2) 2026 공식 프로그램·세션 목록·연결된 발표 초록. 이 글은 한 편의 논문 리뷰가 아니라 프로그램 편성과 제목을 종합한 conference trend다. 수치와 제목은 프로그램 스냅샷을 기준으로 하며, 발표가 모두 동료심사 논문으로 출판됐다는 뜻은 아니다.
1. 프로그램을 읽는 단위: 논문 성능이 아니라 의제의 배치
IC2S2 2026은 Burlington에서 열린 제12회 학회다. 보존된 공식 프로그램 집계는 구두 234편, 포스터 174편, 라이트닝 54편, 튜토리얼 10편, 기조 8슬롯(공동 슬롯 포함)을 기록한다. 이 숫자는 발표 형식의 편성 수이며, 채택률·참가자 수·주제의 질을 뜻하지 않는다.
이번 프로그램에서 두드러진 질문은 LLM 결과를 사회과학 증거로 받아들이기 전에 무엇을 검증할 것인가다. Understanding Large Language Models는 AI & Society, Explainability & Cognition, Bias, Surveys & Social Science 1·2의 다섯 하위세션으로 편성됐다. 그중 설문·사회과학 세션이 두 번 배정된 사실은 LLM을 단순 생성 도구보다 측정 장치로 다루는 질문을 별도 세션에서 다뤘다는 편성 근거다. 이전 해보다 비중이 늘었다는 뜻은 아니다.
2. 핵심 흐름: validate-then-simulate
발표 제목도 같은 방향을 가리킨다. *Can LLMs Approximate Public Opinion?*은 합성 설문 응답을 40 waves의 실제 설문과 대조한다고 밝히고, Validating LLM Simulations as Behavioral Evidence는 시뮬레이션을 행동 증거로 쓸 조건을 제목에 건다. *To Fine-Tune or to Rectify?*와 Evaluating LLM Text Annotations Without Ground Truth도 생성 자체보다 보정과 평가를 전면에 둔다.
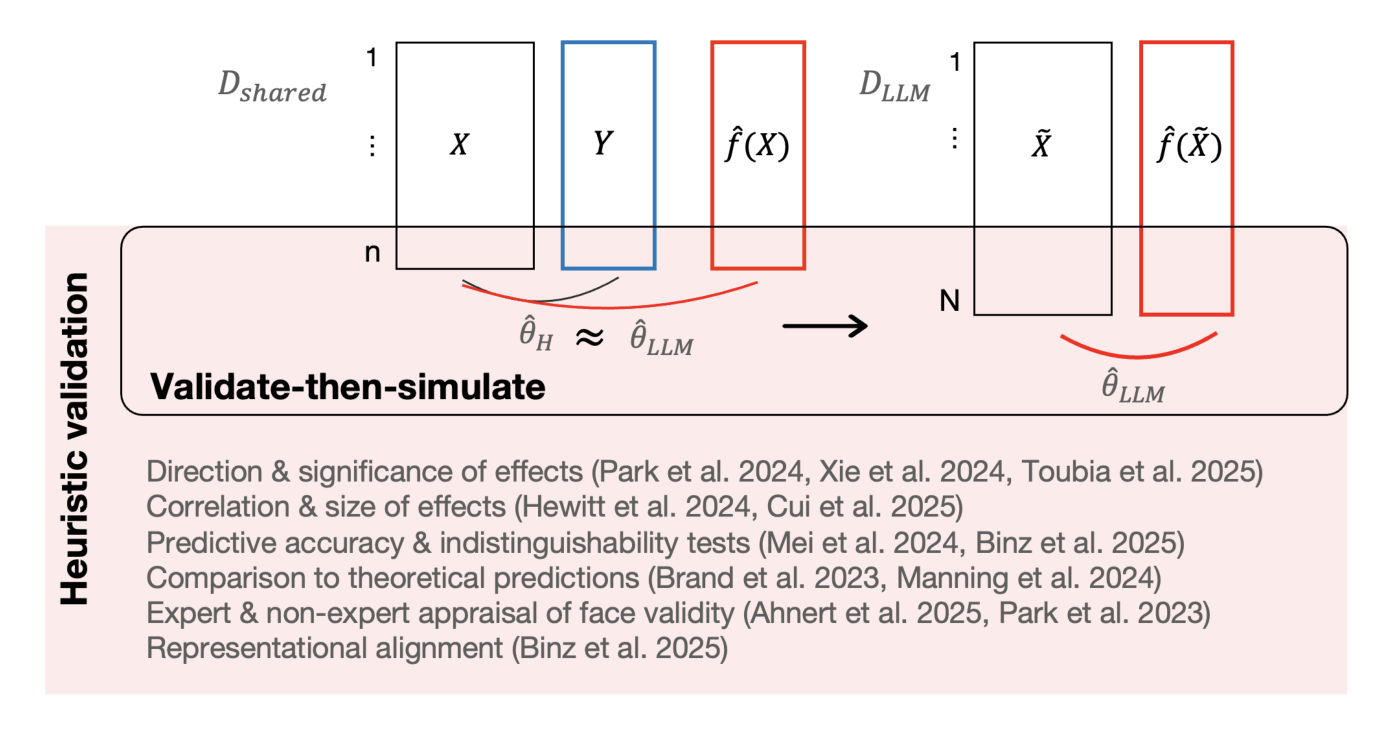
그림 1. Hullman et al.의 연결 논문, arXiv:2602.15785v1 PDF p. 4의 Figure 1을 인용한 공개 자산이다. 사람 관측치와 LLM 출력이 겹치는 공유 자료에서 먼저 충실도를 점검하고, 그 뒤 큰 LLM 자료를 쓰는 validate-then-simulate의 흐름을 그린다. 이는 IC2S2 전체의 공통 방법이 아니라 이 프로그램에 포함된 한 발표의 제안이다.
실무에서는 다음 조건을 살펴봐야 한다. LLM이 10,000명 가상 응답을 만들어도, 실제 인간 응답과 같은 추정량을 주는지는 자동으로 따라오지 않는다. 작은 사람 표본에서 방향·크기·집단별 편향을 점검한 뒤에야 큰 합성 표본을 보조 신호로 쓸 수 있다. 프로그램의 제목과 세션 구성은 이 절차를 연구 주제로 격상한 것으로 읽힌다.
3. 보정은 더 많은 가상 응답을 뜻하지 않는다
Valid survey simulations with limited human data가 제시하는 구성은 소수의 인간 응답과 큰 인구통계 자료를 함께 쓴다. 먼저 prompting 또는 fine-tuning으로 합성 응답을 만들고, 그 예측 오차를 추정해 최종 관심량과 신뢰구간을 보정한다. 핵심은 LLM 응답을 인간 관측치로 바꾸는 것이 아니라, 오차를 남긴 채 추정량에 결합하는 것이다.
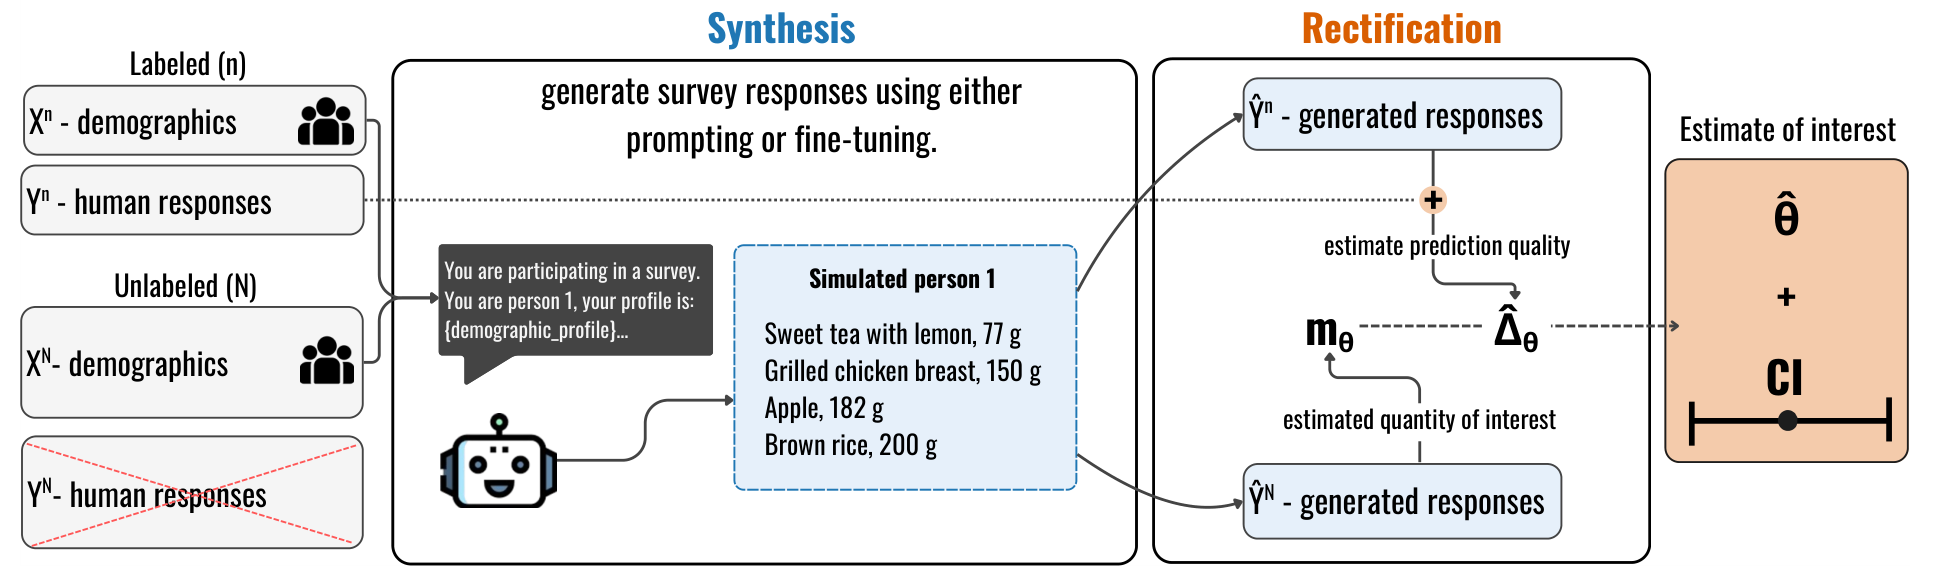
그림 2. Krsteski et al.의 연결 논문, arXiv:2510.11408v2 PDF p. 2의 Figure 1을 인용한 공개 자산이다. 왼쪽의 라벨된 인간 자료와 큰 비라벨 인구통계 자료, 가운데의 합성 응답, 오른쪽의 prediction-quality 보정과 신뢰구간을 실제 순서대로 보여 준다. 이 그림은 특정 조사·국가에서 정확도가 보장된다는 결과표가 아니다.
예를 들어 정책 선호의 전체 평균을 알고 싶다면, LLM이 낸 평균을 그대로 발표하지 않는다. 일부 응답자에게서 사람 답과 LLM 답을 모두 얻어 오차를 추정하고, 그 차이를 최종 평균과 불확실성에 반영한다. 이런 설계는 비용을 낮출 가능성이 있지만, 인구통계만으로 사람의 정치·문화적 맥락을 충분히 재현할 수 있다는 가정을 없애지 않는다.
4. LLM은 방법이면서 사회적 대상이다
Human-AI Interaction and Practice(구두 10, 포스터 12)와 Labor and the Future of AI Employment, AI in Education 같은 트랙은 다른 전환을 보여 준다. LLM은 설문 응답을 생성하는 방법인 동시에, 쇼핑 선택·교육·노동·동반자 관계에 개입하는 사회 현상이다. AI Shopping Agents Can Covertly Redirect Consumer Choices at Scale, Illusions of Connection, The Impact of LLM Adoption on Student Writing 같은 발표는 이 두 역할을 분리해서 볼 필요를 드러낸다.
이 구분을 점검 기준으로 삼을 수 있다. LLM을 도구로 쓸 때는 측정오차·대표성·보정을 묻고, LLM을 대상으로 연구할 때는 어떤 집단의 행동과 권력이 바뀌는지 묻는다. 같은 모델을 쓰더라도 연구 윤리와 필요한 관측 자료가 달라진다.
5. 이 동향을 어디까지 믿을까
프로그램 제목과 편성을 바탕으로 이 글에서 ‘검증 국면’이라 해석했다. 발표 수를 정규식으로 세는 방식은 제목에 LLM이 없지만 내용을 다루는 발표를 놓치고, 제목만 언급한 발표를 과대계상할 수 있다. 제목과 초록 중 어느 필드를 검색하는지, 어떤 표현까지 같은 주제로 묶는지에 따라 집계가 크게 달라진다. 이 글은 주제 점유율을 추정하지 않고, 공식 프로그램에 확인되는 세션과 발표 사례를 중심으로 읽는다.
따라서 2026을 ‘LLM 열광이 끝난 해’라고 부르기보다, 채택과 검증이 같은 무대에 놓인 해라고 부르는 편이 맞다. 인간 자료와 비교, 불확실성 보고, 집단별 실패 확인, 원문 근거를 따라가는 절차가 있을 때만 합성 응답은 사회과학의 보조 측정이 될 수 있다.
더 긴 프로그램 지도와 발표 목록은 심층 보기에서 확인할 수 있다.
References
International Conference on Computational Social Science. (2026). IC2S2 2026 official program [Conference program and presentation abstracts]. Burlington, VT. https://ic2s2-2026.org/program/
Hullman, J., Broska, D., Sun, H., & Shaw, A. (2026). This human study did not involve human subjects: Validating LLM simulations as behavioral evidence (arXiv:2602.15785). arXiv. https://arxiv.org/abs/2602.15785
Krsteski, S., Russo, G., Chang, S., West, R., & Gligorić, K. (2025). Valid survey simulations with limited human data: The roles of prompting, fine-tuning, and rectification (arXiv:2510.11408). arXiv. https://arxiv.org/abs/2510.11408