IC2S2 2025는 무엇을 검증했나: LLM이 '측정 도구'로 무대에 오른 해
IC2S2 2025가 던진 질문: LLM 출력을 사회과학 측정값으로 쓸 수 있을까
IC2S2 2025 공식 프로그램은 LLM을 사회과학의 측정·추론 도구로 다루되, 인간 주석과의 결합·실리콘 표본의 타당성·보정 문제를 중심에 놓았다. 이 글은 프로그램 기반 동향 해석이며 개별 발표의 확정된 결론을 뜻하지 않는다.
Sources: International Conference on Computational Social Science (IC2S2) 2025 공식 프로그램·일정 CSV·세션 목록·발표 제목. 이 글은 단일 논문이 아니라 Norrköping에서 열린 제11회 프로그램을 읽은 conference trend다. 각 발표가 출판 논문이거나 프로그램의 주장을 이미 입증했다는 뜻은 아니다.
1. 프로그램의 중심 질문은 ‘생성’보다 ‘측정’이었다
공식 일정의 보존본을 집계하면 IC2S2 2025에는 구두 284편, 포스터 323편, 라이트닝 15편, 기조 9편, 튜토리얼 10편이 배치됐다. 622건은 구두·포스터·라이트닝 일정 항목만 더한 수로, 기조와 튜토리얼은 포함하지 않으며, 분야 전체 연구량이나 채택률은 아니다.
기조의 두 제목이 눈에 띈다. Lisa Argyle의 Arti-'fickle' Intelligence는 LLM을 정치·사회과학 추론 도구로 쓰는 문제를, Brandon Stewart의 Design-Based Supervised Learning은 LLM 주석처럼 불완전한 예측 변수를 하류 분석에 타당하게 쓰는 틀을 다룬다. 이것이 한 해의 모든 발표를 설명하지는 않지만, 프로그램이 ‘모델이 그럴듯한 답을 만들 수 있는가’보다 ‘그 답을 추정량에 넣어도 되는가’를 전면에 둔 신호다.
2. LLM 주석은 사람 주석의 값싼 복사본이 아니다
텍스트 10만 건을 분류해야 할 때 LLM에게 전부 라벨을 붙이게 하는 일은 빠르다. 하지만 관심값이 ‘혐오 표현 비율’이나 ‘정당 지지의 변화’라면, LLM 라벨의 체계적 오차가 최종 평균과 신뢰구간을 바꾼다. Can Unconfident LLM Annotations Be Used for Confident Conclusions?는 바로 이 간극을 제목으로 삼은 발표다.
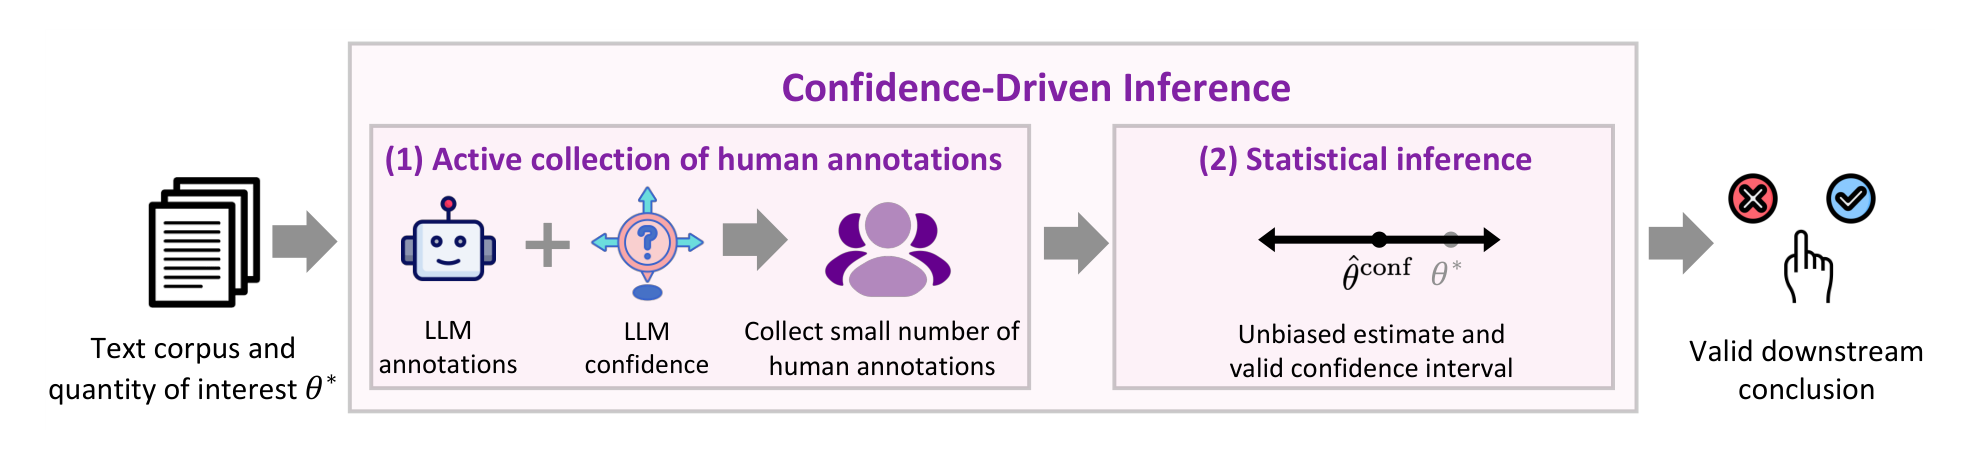
그림 1. Gligorić et al.의 연결 논문, arXiv:2408.15204v2 PDF p. 2의 Figure 1을 인용한 공개 자산이다. LLM 주석과 모델 신뢰도에서 인간 주석을 전략적으로 모으고, 그 정보를 사용해 편향 없는 추정과 신뢰구간을 목표로 하는 순서를 보여 준다. 이 그림은 IC2S2의 모든 주석 연구가 같은 추정기를 썼다는 뜻이 아니다.
핵심 직관은 ‘LLM의 확신이 높은 항목만 믿자’보다 조심스럽다. LLM이 불확실해하는 구간과 집단별로 틀리는 구간에 사람 라벨을 더 배정하고 그 오차를 최종 추정에 반영해야 한다. LLM이 사람보다 빠르다는 사실은 추정이 편향되지 않았다는 근거가 아니다.
3. 실리콘 표본: 관측치인가, 검증해야 할 예측인가
The Mixed Subjects Design은 인간만 쓴 실험, LLM이 만든 실리콘 표본만 쓴 실험, 둘을 결합한 설계를 나란히 둔다. 적절하게 표집·측정한 인간 표본은 기준 자료가 되지만 비싸고, 실리콘 표본은 싸고 정밀하게 보일 수 있지만 그 자체로 타당하다고 볼 수 없다. 혼합 설계는 인간 자료에서 LLM 예측이 얼마나 교환 가능하거나 보정 가능한지 먼저 확인한 뒤, 큰 합성 자료를 보조로 쓴다는 구상이다.
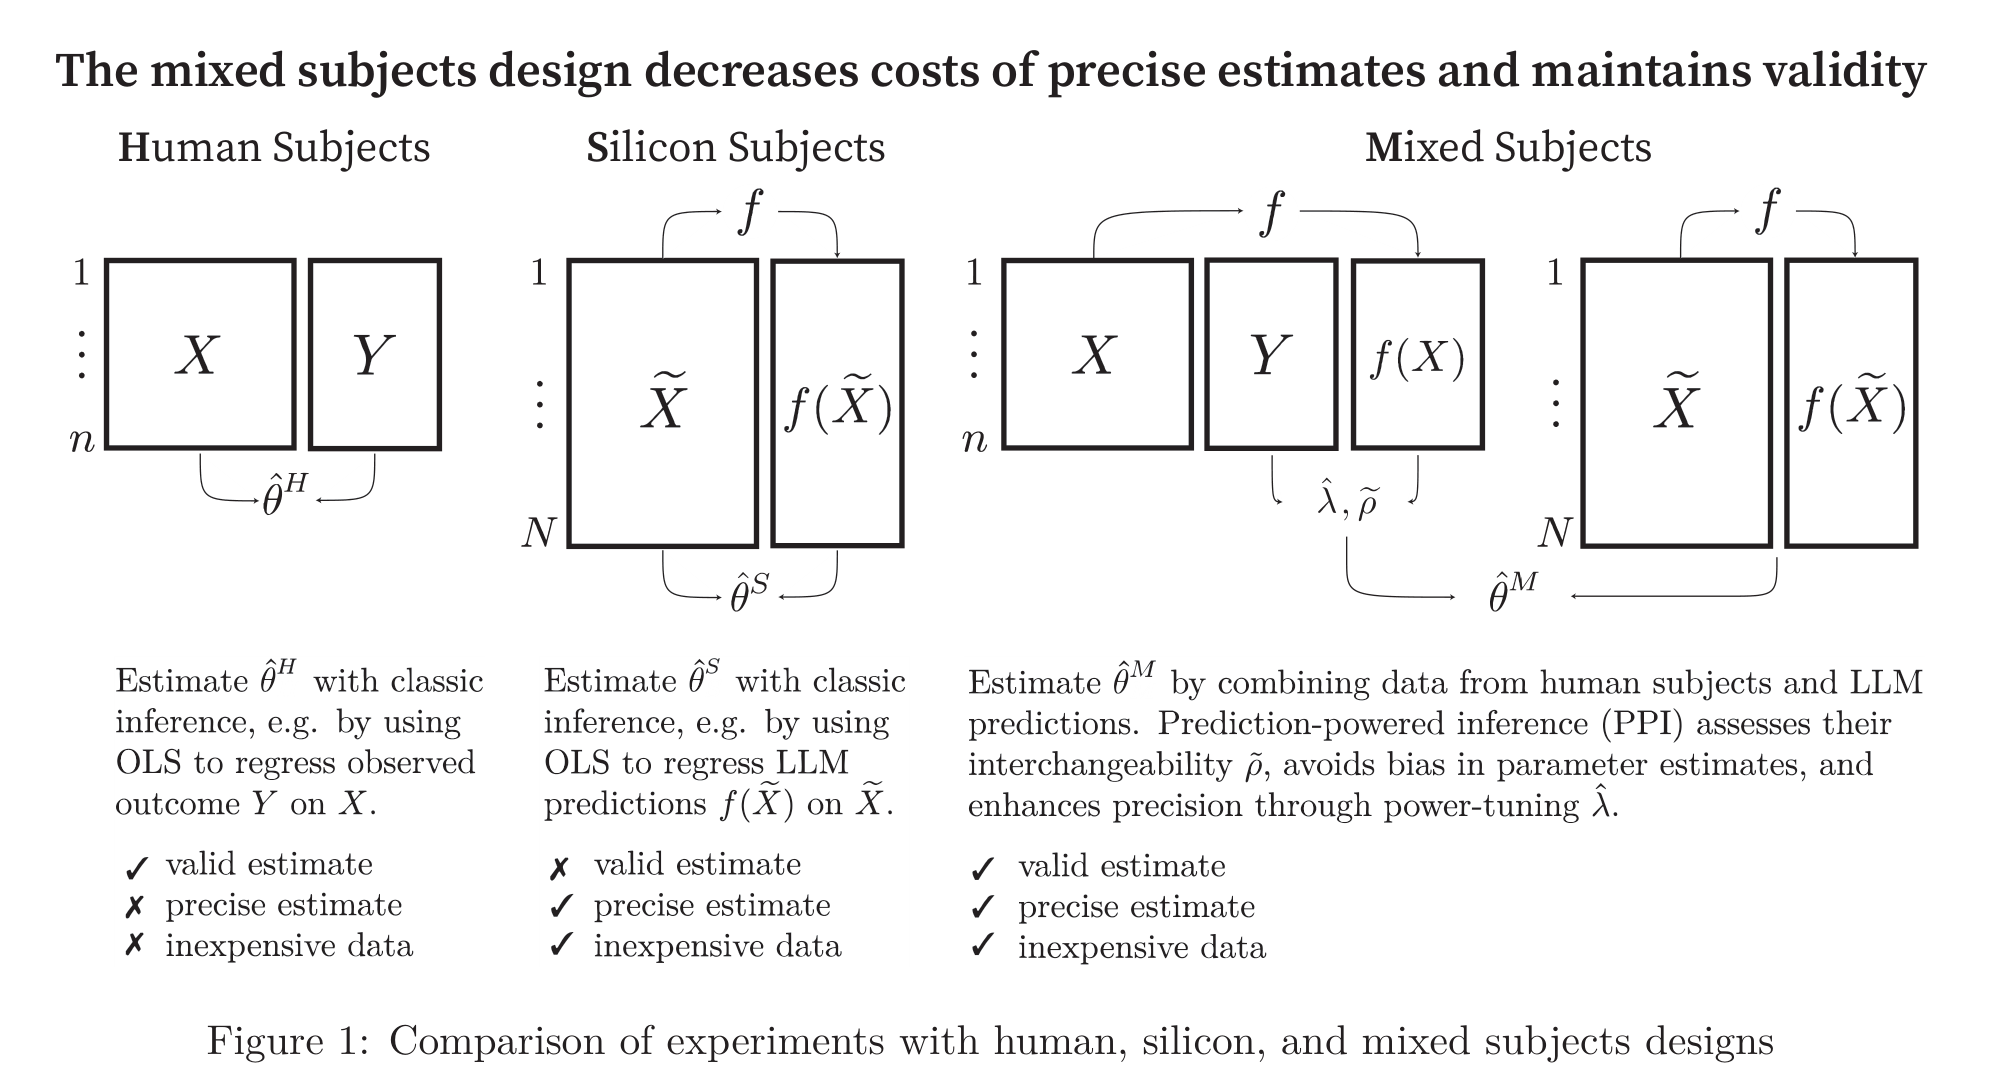
그림 2. Broska et al.의 연결 논문 Figure 1을 인용한 공개 자산이다. 적절히 설계한 인간 표본에도 정밀성·비용의 제약이 있고, 실리콘 표본은 반대의 성질을 가진다는 대비와 혼합 추정의 위치를 보여 준다. 도식의 체크표는 방법의 목표를 나타내며 모든 모집단에서 검증된 성능표가 아니다.
예를 들어 선거 선호를 추정할 때, 인구통계 프로필을 넣은 LLM 10만 회의 응답 평균이 실제 유권자 평균과 같다고 가정해서는 안 된다. 일부 인간 설문에서 LLM과 인간이 어디서 갈리는지 확인하고, 그 차이와 불확실성을 반영해야 한다. 이 관점에서는 실리콘 표본을 검증이 필요한 예측값으로 다룬다. ‘더 싼 참가자’로 볼 수는 없다.
4. 생성 에이전트와 플랫폼 연구가 만나는 곳
프로그램에는 Validating Generative Agent-based Models, 인간·LLM 시뮬레이션 인구의 상식을 비교하는 발표, 다중 LLM 에이전트의 도덕 추론과 성별 역학을 다루는 발표가 함께 있다. 이 배열은 생성 에이전트를 쓸 수 있다는 주장과, 그것이 인간 행동의 증거인지 확인해야 한다는 주장이 공존했음을 보여 준다.
동시에 오정보·양극화는 알고리즘 감사와 현장 개입으로, 텍스트 연구는 이미지·위성·영상까지 넓어졌다. 이를 ‘LLM이 기존 전산사회과학을 대체했다’고 읽으면 과장이다. 더 정확한 해석은 LLM이 하나의 데이터 생산·주석 도구가 되면서, 기존의 인과 추론·측정오차·재현성 문제가 오히려 더 전면으로 나왔다는 것이다.
5. 동향 글의 경계와 실무적 결론
발표 내용은 제목의 키워드만 세어 판정할 수 없다. 제목과 초록 중 어느 필드를 검색하는지에 따라서도 결과가 달라지므로, 여기서는 주제별 비율을 제시하지 않는다. 발표 제목은 문제의식만 말하고 결과·데이터·검증 조건은 생략할 수 있다. 그러므로 이 글의 ‘측정론적 전환’은 주제 편성과 대표 제목에 근거한 편집 해석이며, 인용 수·정책 영향·재현 성공률의 순위가 아니다.
그럼에도 적용할 원칙은 분명하다. LLM 출력을 사회과학 통계에 넣기 전에 사람 기준 자료와 비교하고, 오류가 특정 집단·언어·주제에 몰리는지 보고, 보정 뒤에도 신뢰구간을 유지해야 한다. 모델이 유창하게 말하는 것과 모집단에 대해 타당한 결론을 내리는 것은 별개의 일이다.
더 긴 세션·발표 지형은 심층 보기에서 확인할 수 있다.
References
International Conference on Computational Social Science. (2025). IC2S2 2025 official program [Conference schedule and presentation titles]. Norrköping, Sweden. https://ic2s2-2025.org/program/
Broska, D., Howes, M., & van Loon, A. (2025). The mixed subjects design: Treating large language models as potentially informative observations. Sociological Methods & Research. https://doi.org/10.1177/00491241251326865
Gligorić, K., Zrnic, T., Lee, C., Candès, E. J., & Jurafsky, D. (2024). Can unconfident LLM annotations be used for confident conclusions? (arXiv:2408.15204). arXiv. https://arxiv.org/abs/2408.15204