Agent Plasticity: Measuring Self-Improvement Through Experience
고정된 언어 모델이 경험을 영속 도구와 기억으로 바꾸는 과정을 보드게임과 NetHack에서 추적하고, held-out 성능 향상과 학습 비용을 함께 측정합니다.
Paper: Harman Singh; Anton Bakhtin; Rulin Shao; Gabriel Synnaeve; Ilia Kulikov; Rob Fergus; Sanjeev Arora; Kurt Keutzer; Jason Weston; Anuj Mahajan; Anirudh Goyal (2026). "Agent Plasticity: Measuring Self-Improvement Through Experience". arXiv preprint, arXiv:2610.08902v1, 2026년 10월 6일, 43쪽. PDF
에이전트 평가에서는 보통 현재 무엇을 할 수 있는지 측정합니다. 이 논문은 한 걸음 더 나아가, 모델이 경험을 도구·기술·메모리로 남겨 다음 인스턴스에 전달하면 이후 성능이 어떻게 달라지는지 살펴봅니다. 특히 최종 점수와 경험을 성능 향상으로 바꾸는 비용을 나누어 측정합니다.
1. 성능의 현재값과 경험을 통한 변화
두 모델이 같은 점수로 시작해도 경험 뒤의 경로는 다를 수 있습니다. 한쪽은 실패를 바탕으로 다시 쓸 수 있는 도구를 만들고, 다른 쪽은 바뀌지 않거나 성능이 낮아질 수 있습니다. 논문은 이런 차이를 관찰하기 위해 모델의 가중치는 고정하고, 영속 파일의 모음인 inventory만 갱신하는 절차를 사용합니다. 이 논문에서 agent plasticity는 모델만의 변하지 않는 속성이라기보다 특정 모델·환경·feedback·가격으로 이루어진 protocol에서의 성능 획득 효율입니다.
2. 바뀌는 것은 모델이 아니라 다음 인스턴스의 inventory입니다
각 게임은 새 대화 맥락과 임시 작업공간에서 시작합니다. 과거 대화나 게임 중 만든 임시 파일은 이어지지 않고, Python 도구와 전략·기술, 텍스트 메모리 같은 영속 산출물(artifact)만 다음 평가 시점(checkpoint)으로 전달됩니다. 게임을 수행한 actor와 경험을 되짚어 산출물을 수정하는 reflection은 같은 모델을 사용합니다. 보드게임의 reflection은 training 게임 기록을 받지만 별도로 둔 평가 게임(held-out)과 점수는 보지 않습니다.
제안된 수정은 구조와 실행 가능성 검사를 통과해야 inventory에 남습니다. 이 검사는 파일이 적재되고 실행 가능한지 확인할 뿐, held-out 성능이 좋아지는지를 보지는 않습니다. 거절된 수정도 비용에 포함됩니다. checkpoint 0에는 영속 artifact가 없지만, actor가 해당 게임에서만 쓸 임시 도구를 만드는 것은 허용됩니다.
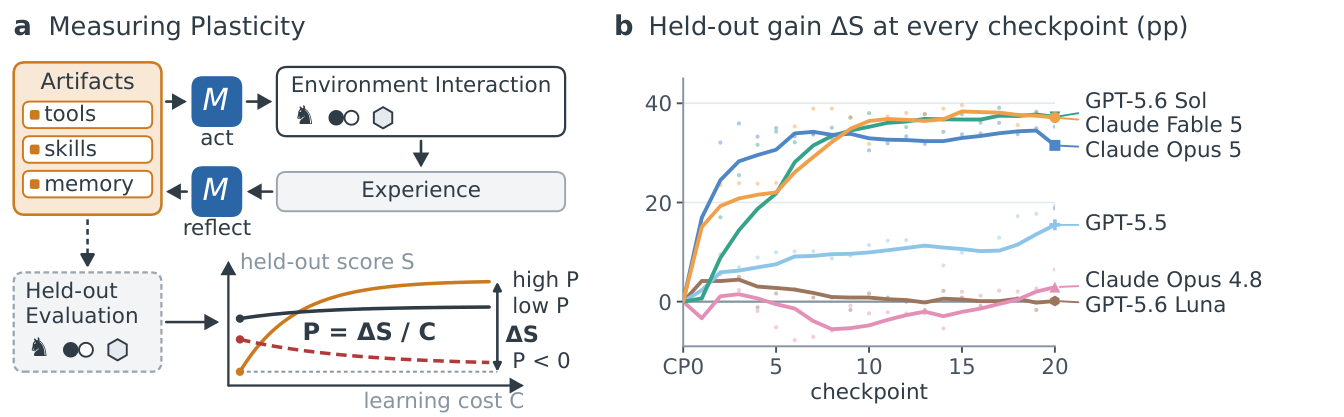
그림 1. Singh et al. (2026), Figure 2, arXiv v1 PDF p.2. Training 결과는 reflection에 전달되지만 held-out 게임의 trace와 점수는 공개되지 않습니다. 다음 episode는 새 context에서 시작합니다.
3. 보드게임과 NetHack의 평가 설계는 다릅니다
보드게임의 각 checkpoint에서는 training 게임을 한 뒤 그 결과만 reflection에 줍니다. ID 평가는 training과 비슷한 난이도, OOD 평가는 더 강한 상대를 사용합니다. 따라서 여기서 OOD는 다른 과제가 아니라 같은 게임에서 상대의 난이도를 높인 transfer 평가입니다.
| 환경 | checkpoint | Train / held-out ID / held-out OOD 게임 | 평가 조건 |
|---|---|---|---|
| Chess Hard | 0–20 | 16 / 12 / 12 | Stockfish 16; skill 1–8 / 3–8 / 12 |
| Chess Easy | 0–20 | 16 / 16 / 12 | Stockfish 16; skill 2–5 / 2–5 / 8–10 |
| Go 5×5 | 0–20 | 20 / 20 / 12 | GNU Go level 5–9 / 5–9 / 10 |
| Hex 6×6 | 0–20 | 40 / 40 / 32 | engine 10k–1M / 10k–1M / 10M nodes |
Chess에서는 training move에 skill-20 Stockfish의 비교 annotation도 reflection feedback으로 제공됩니다. Go의 KataGo와 Hex의 더 깊은 engine 비교는 실패 사례를 분석할 때만 쓰며 agent에게 주는 teacher feedback은 아닙니다. 반면 NetHack은 별도 설계로, 매 checkpoint에서 새 게임 10개를 먼저 평가한 뒤 그 결과를 reflection에 줍니다.
4. 성능 향상과 학습 비용을 함께 봅니다
저자들은 training 게임과 reflection에 사용한 모델 호출의 provider API 비용을 누적해 학습 비용으로 둡니다. 실패하거나 거절된 reflection 시도도 포함하지만, held-out 평가와 배포 호출은 포함하지 않습니다. GPU·CPU·엔진의 물리적 계산량이나 wall-clock 시간도 이 비용은 아닙니다.
기본 지표는 관측된 held-out 점수가 checkpoint 0보다 얼마나 올랐는지를 그때까지의 누적 학습 비용으로 나눈 값입니다. 논문은 이를 1,000달러당 score points로 표시합니다. 이 값은 평가 구간에 따라 달라질 수 있습니다. Headline 지표인 P_sat은 각 성능 곡선에 포화 형태의 함수를 맞춘 뒤, fitted 상승량의 90%에 도달한 첫 관측 checkpoint까지의 점수 증가를 비용으로 나눕니다. 적합한 총 상승량의 90%가 10점 미만이면 0을 부여하고, 마지막 checkpoint 뒤 최대 3배 비용까지 외삽해도 교차하지 않으면 포화 대신 현재까지의 효율을 기록합니다. 따라서 P_sat=0은 학습이 없었다는 증명이 아니며, P_sat도 순간 기울기는 아닙니다.
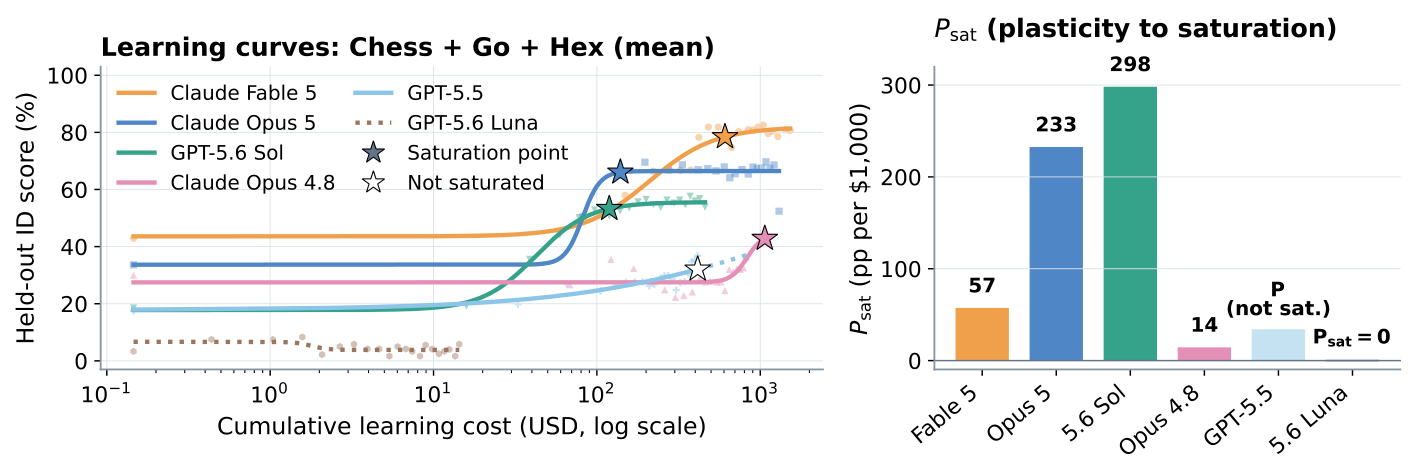
그림 2. Singh et al. (2026), Figure 1, arXiv v1 PDF p.1. 세 게임 family의 집계 곡선과 포화 기준까지의 점수 향상/비용을 보여 줍니다.
보고된 보드게임 P_sat은 GPT-5.6 Sol 298, Claude Opus 5 233, Claude Fable 5 57, Claude Opus 4.8 14, GPT-5.6 Luna 0입니다. GPT-5.5는 관측이 끝날 때까지 상승 중이어서 포화를 정하지 못했습니다. Fable 5는 fitted 최종 점수가 가장 높지만 Sol은 비용당 획득 효율이 더 높습니다. 두 값은 각각 최종 성능과 그 성능을 획득하는 효율을 나타냅니다.
게임별 궤적도 다릅니다. Hard chess에서 Fable 5의 held-out ID는 CP0 37.5%에서 CP16–20 평균 73.3%로, Opus 5는 25.0%에서 66.4%로 올랐습니다. Go에서 Fable 5는 ID 20%→80%, OOD 0%→50%였고, Hex에서 Sol은 ID 40%→77.5%, OOD 28.1%→78.1%였습니다. 개선이 모든 모델·게임에서 같은 방향으로 나타나지는 않았습니다.
5. NetHack은 checkpoint마다 새로운 10게임을 사용합니다
NetHack 실험은 Claude Code와 Codex의 native harness에서 시작하며 CP0–40을 다룹니다. 각 모델은 checkpoint마다 새로운 seed의 10게임을 진행하고, 그 게임을 점수화한 다음 reflection에 전달합니다. 한 모델당 하나의 lineage이므로 게임의 난이도 변화가 학습 변화와 함께 반영됩니다. 이 평가는 보드게임의 영구 held-out set과 다릅니다. 게임별 최고 원점수를 모아 checkpoint의 평균·중앙값·최댓값을 보고합니다.
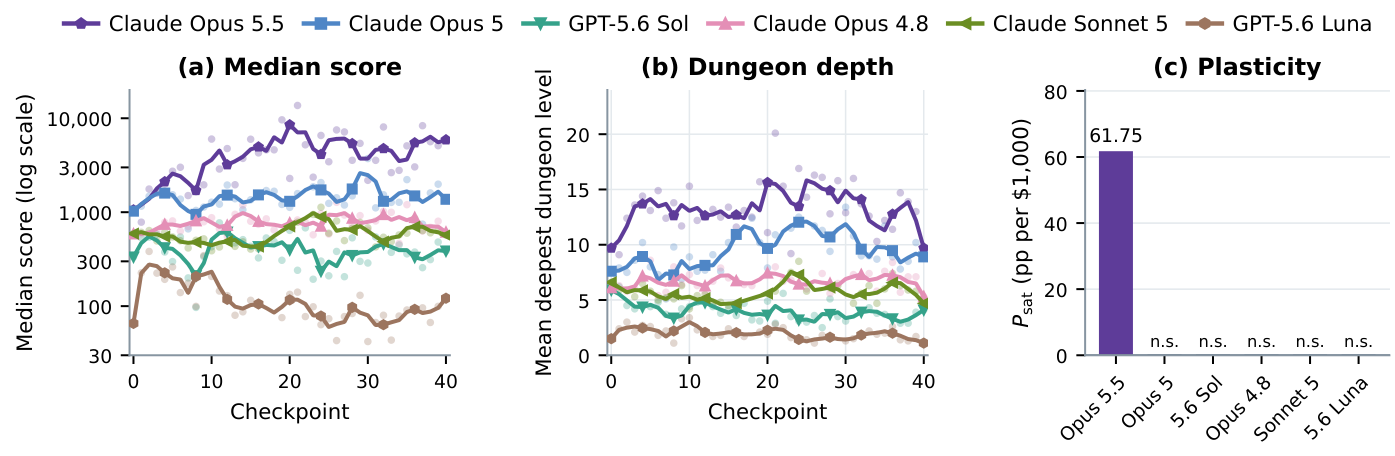
그림 3. Singh et al. (2026), Figure 5, arXiv v1 PDF p.6. 게임별 최고 원점수 10개의 중앙값과 평균 최고 dungeon level을 표시합니다. Mean score는 논문의 Figure 10에 별도로 제시됩니다.
NetHack score는 기준점 213.6을 0, 6,526.98을 100으로 두어 plasticity 비교에 쓰지만, 이 수치는 가능한 점수의 하한과 상한이 아닙니다. Claude Opus 5.5의 fitted 상승량은 68.95 normalized points이며, CP11에서 90% 기준을 처음 넘습니다. 그 checkpoint의 fitted gain은 66.25, 누적 비용은 1,072.73달러이고, 보고된 P_sat은 1,000달러당 61.75 points입니다. 다른 다섯 모델은 같은 분석에서 reliable rise를 보이지 않았습니다. 점수 단위와 harness가 달라 이 값을 보드게임 P_sat과 직접 비교하지 않습니다.
6. artifact 재사용과 실패는 서로 다른 분모로 셉니다
저자들은 먼저 artifact가 결정을 내리거나 실행하는 데 관련될 수 있는 relevant decision을 정하고, 그중 실제로 artifact가 쓰인 비율을 계산합니다. 한 결정에 관련 artifact가 여러 개 있어도 하나라도 사용했다면 재사용으로 한 번만 셉니다. 별도로 확인된 실패를 artifact가 없었는지, 있었지만 사용하지 않았는지, 사용했는데도 실패가 남았는지 분류합니다.
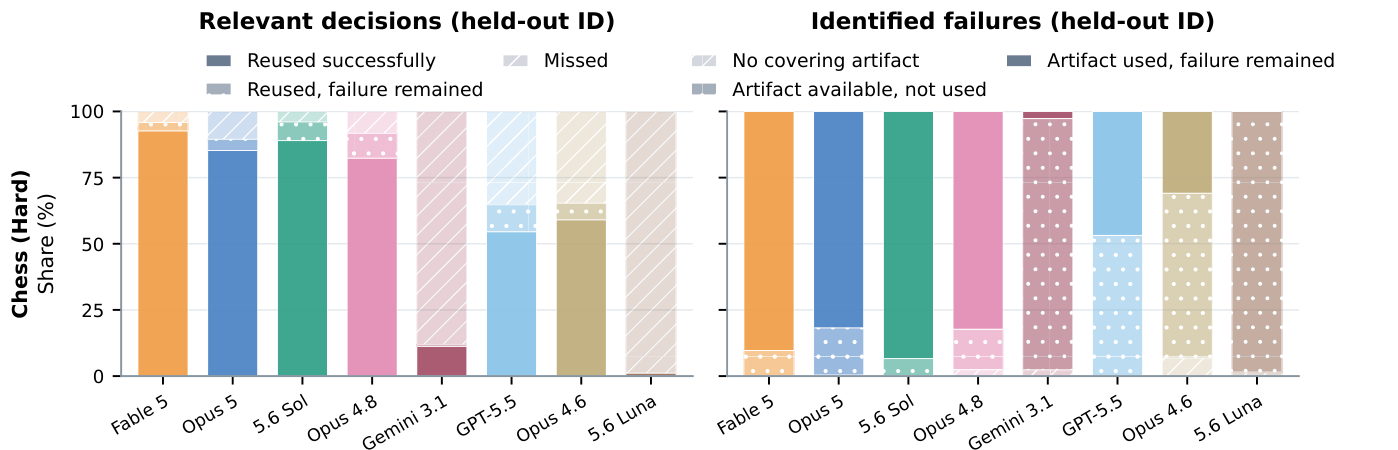
그림 4. Singh et al. (2026), Figure 4, arXiv v1 PDF p.4. 왼쪽은 관련 결정의 재사용 결과, 오른쪽은 확인된 실패만 세 유형으로 나눕니다.
Hard와 Easy chess를 합쳤을 때 relevant decision에서 artifact를 사용하지 않은 비율은 Luna 약 98%, Gemini 3.1 Pro 약 87%, Opus 4.6 약 51%, GPT-5.5 약 28%였습니다. 반면 Fable 5, Opus 5, Opus 4.8, Sol은 약 2–6%였습니다. 실패가 확인된 사례만으로 분류한 share는 전체 게임 실패율이 아닙니다. failure 수를 relevant decision 수로 나눈 값도 한 결정에 여러 실패가 생길 수 있어 확률이 아닌 정규화된 count입니다. Artifact를 사용한 결정 중 성공한 비율은 또 다른 분모를 씁니다.
재사용이 많더라도 실패가 모두 없어지지는 않았습니다. 강한 improver 그룹에서 남은 실패의 83–99%는 relevant artifact를 사용한 상태에서 발생했습니다. 논문은 재사용과 점수 향상의 연관을 보고하지만, 관찰 결과만으로 artifact 사용의 인과효과를 확정하지 않습니다.
7. 결과의 범위와 한계
저자들은 frozen weight와 새 context가 영속 적응을 분리하지만 training feedback의 효과와 reflection에 든 추가 계산을 분리하지 않는다고 밝힙니다. API 비용은 deployment 비용을 포함하지 않으며 provider 가격, 시작 점수의 headroom, 학습 horizon, 포화 곡선 fit에 따라 달라집니다. Artifact 재사용 진단은 관찰적이고, 유한한 평가 게임은 checkpoint 수준의 noise를 포함합니다. NetHack은 매 checkpoint 새 게임을 쓰므로 학습과 난이도 변화가 섞이며, 별도 lineage만으로 과제 간 transfer를 입증하지 않습니다. 긴 context에서 지시를 따르는 능력이 artifact 생성과 적용에 기여한 정도도 실험에서 분리하지 않습니다.
References
Singh, H., Bakhtin, A., Shao, R., Synnaeve, G., Kulikov, I., Fergus, R., Arora, S., Keutzer, K., Weston, J., Mahajan, A., & Goyal, A. (2026). Agent plasticity: Measuring self-improvement through experience [Preprint]. arXiv. https://arxiv.org/abs/2610.08902v1