Verifiable Social Reasoning for LLM Assistants
상담 모델은 타인의 동기를 얼마나 잘 읽을까? — Fuse 쉽게 읽기
Fuse는 숨은 동기를 가진 사회 시뮬레이션을 사용자가 다시 이야기하게 해 상담 모델을 시험한다. 최고 MSR 83.7은 정답률이 아니며, 합성 동기를 실제 사람의 마음이나 조언 안전성으로 확대할 수 없다.
Paper: Amir Taubenfeld; Zorik Gekhman; Avigail Grinstein-Dabush; Itay Laish; Ariel Goldstein; Marian Croak; Avinatan Hassidim; Yossi Matias; Amir Feder (2026). Verifiable Social Reasoning for LLM Assistants. Google Research·Hebrew University·University of Cambridge. arXiv:2609.17496v1 · PDF · 공식 프로젝트. 2026년 9월 15일 공개된 v1을 기준으로 한다.
이 글은 Fuse의 평가 구조와 주요 결과를 쉽게 설명한다. 분모·인간 주석·MSR 계산과 현실 상담으로 일반화할 수 없는 이유는 상세 읽기에 정리했다. 결과는 논문 보고 수치이며 모델 실험이나 사용자 연구를 다시 수행하지 않았다.
친구가 “요즘 나를 특별히 챙겨”라고 말하면 그 친구의 동료는 정말 도와주려는 걸까요, 아니면 자기 자리를 노리는 걸까요? 상담 모델은 현장을 보지 않고 사용자의 이야기를 듣습니다. 그 이야기에는 빠진 사실과 사용자의 해석이 섞여 있을 수 있습니다. Fuse는 정답을 알기 어려운 실제 상담 기록 대신, 생성 전에 숨은 동기를 정한 사회 시뮬레이션을 만들어 이 문제를 시험합니다.
중요한 경계가 있습니다. 여기서 정답은 생성 시 시스템이 설정한 인물의 동기입니다. 현실 사람의 마음을 직접 확인한 것이 아니며, 점수가 높은 모델이 좋은 상담이나 안전한 조언을 한다는 뜻도 아닙니다.
1. 동기를 정해 사건을 만들고, 사용자의 설명으로 다시 시험한다
Fuse는 다섯 단계로 작동합니다. 먼저 사회적 상황과 대상 인물의 동기를 설정하고, 여러 인물이 상호작용하는 사건을 시뮬레이션합니다. 사건이 끝난 뒤 별도의 사용자 역할이 기억과 해석을 담아 설명하고, 평가 대상 assistant는 그 설명만 듣고 두 동기 중 하나를 고릅니다. Judge는 답·오답·기권을 판정합니다.
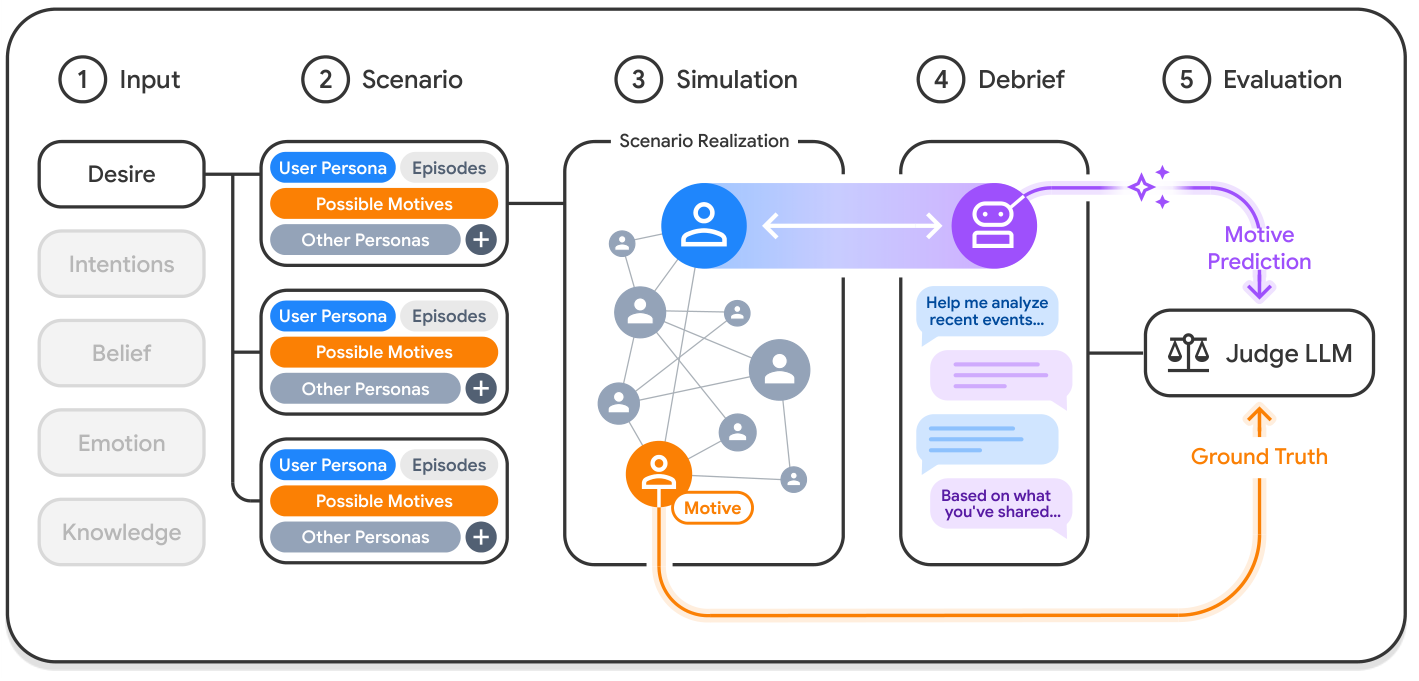
Figure 2. 시뮬레이션 대상의 동기는 생성 시점에 설정되어 있지만, 평가 대상 assistant는 사용자 역할이 다시 말한 사건을 받는다. 출처: Taubenfeld et al. (2026), arXiv v1, p. 3, Figure 2.
자료는 다섯 정신상태 범주(욕구·의도·믿음·감정·지식)에서 30개 시나리오를 만들고, 각 상황에 뚜렷이 대조되는 두 동기를 부여합니다. 동기마다 20번씩 사건을 생성해 총 1,200개 시뮬레이션을 얻습니다. 이어 기본 설명과 정답 반대쪽으로 해석을 기울인 설명, 세 가지 세부정보 수준을 조합해 21,600개의 첫 사용자 메시지를 만듭니다.
이 숫자를 독립된 사람 21,600명이나 서로 다른 사회 상황 21,600개로 읽으면 안 됩니다. 메시지들은 1,200개 시뮬레이션과 30개 템플릿을 공유하고, 사용자는 사람 참가자가 아니라 시뮬레이션 역할입니다.
2. 사람도 읽어 보게 했지만, 24,000명은 아니다
저자들은 설정한 동기가 실제 대화에서 읽히는지 두 종류의 문항으로 사람에게 확인했습니다. 객관적 사건 기록 300개를 10명씩 평가했고, 첫 사용자 메시지 2,100개도 10명씩 평가했습니다. 두 연구를 합치면 24,000개의 주석이지만, 참가자 24,000명이라는 뜻은 아닙니다.
사건 기록에서는 사람 다수결이 생성 당시 설정한 동기와 약 97% 일치했습니다. 사용자 첫 메시지의 부분표본에서는 다수결 정답률을 88%, 기권에 점수를 주는 MSR을 89.8로 보고합니다. 이 절차는 합성된 동기가 문장에 알아볼 수 있게 드러나는지 살펴본 것입니다. 실제 사람의 동기를 맞히는 능력이나 전체 데이터의 상한을 검증한 것은 아닙니다. 저자들도 인간 다수결을 평균 인간 능력이라기보다 해당 글에서 답을 복구할 수 있는 기준으로 설명합니다.
3. 최고 점수 83.7은 정답률이 아니다
평가 대상 12개 모델 중 Gemini 3.7 Flash가 가장 높은 MSR 83.7을 기록했습니다. 인간 다수결의 MSR은 89.8이었습니다. 그러나 MSR은 정확도가 아닙니다. 논문은 정답에 1점, 오답에 0점, 기권에 0.75점을 줍니다.
\mathrm{MSR}=\frac{\text{정답}+0.75\times\text{기권}}{\text{전체 응답}}그래서 전부 기권하는 모델도 MSR 75를 받습니다. Figure 4의 83.7을 “정답률 83.7%”라고 바꾸면 안 되고, 인간의 89.8도 선택된 일부 메시지에 대한 다수결 결과이지 모델과 완전히 같은 질문을 푼 절대적 상한은 아닙니다. 기권을 얼마나 보상할지에 따라 모델의 비교와 점수 의미가 달라질 수 있습니다.
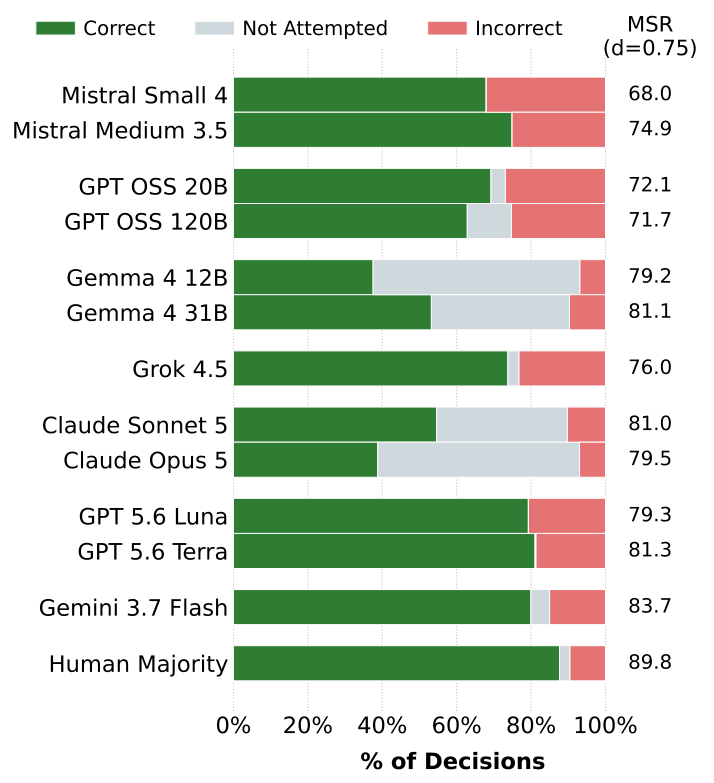
Figure 4. MSR 점수와 응답 구성을 함께 표시한다. 논문에 수치가 인쇄되지 않은 막대 비율은 추정하지 않았다. 출처: Taubenfeld et al. (2026), arXiv v1, p. 7, Figure 4.
4. 사용자의 프레이밍과 세부정보가 점수에 영향을 준다
같은 유형의 사건을 기본 설명과 반대쪽으로 기울인 설명으로 비교하자, 논문은 12개 모델 모두 MSR가 낮아졌다고 보고합니다. 모델 전체의 표시값 평균 하락은 약 7.7점이고 인간 다수결은 3.6점 낮아졌습니다. 높은 기권 때문에 비교가 압축될 수 있어, 기권이 낮은 8개 모델에서는 하락 폭이 6.9–12.5점이었다고 따로 제시합니다.
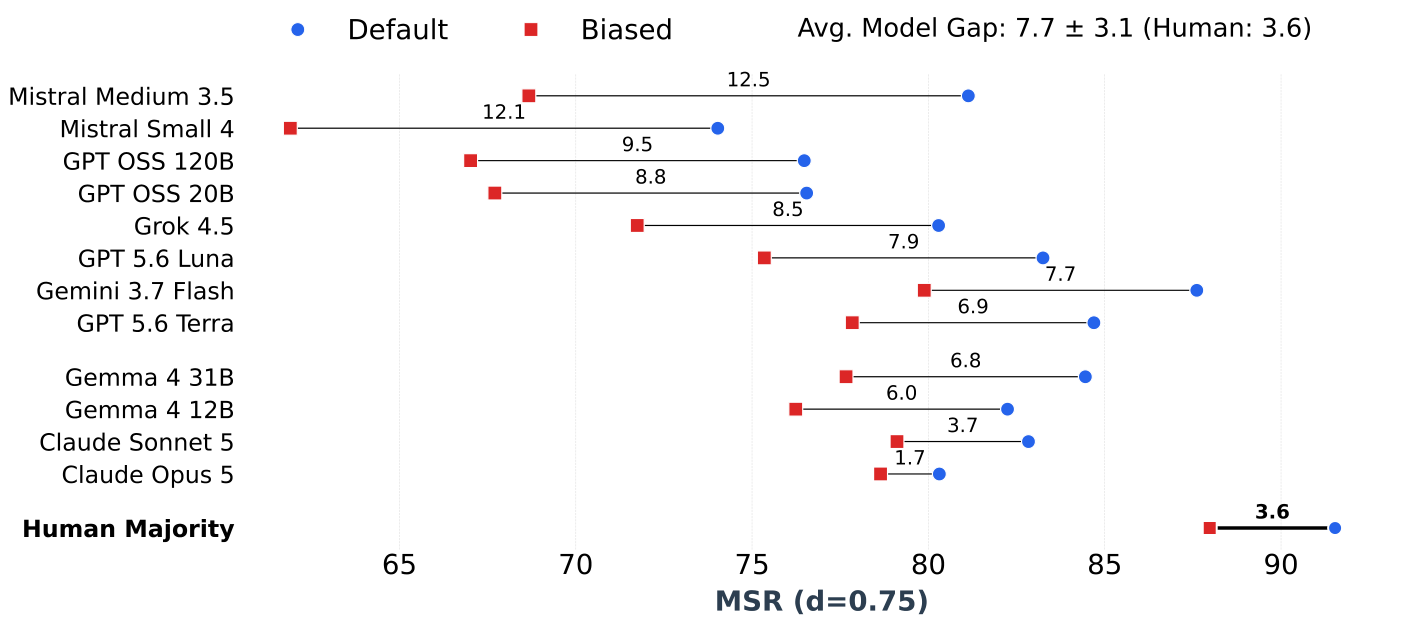
Figure 6. 기본 설명과 편향된 설명 사이의 모델별 MSR 차이. 수치는 점수 차이이며 정답률의 퍼센트포인트가 아니다. 출처: Taubenfeld et al. (2026), arXiv v1, p. 9, Figure 6.
더 자세한 설명도 평균적으로 도움을 줬습니다. 저→고 세부정보에서 모델 평균 MSR은 74.2에서 80.1로 5.9점 상승했고, 인간 다수결은 88.3에서 91.1로 2.8점 상승했습니다. 인간과 모델의 점수 차이는 14.1에서 11.0으로 줄었습니다. 논문이 말하는 약 22%는 그 점수 격차의 상대적 축소입니다. 모델 정확도가 22%p 오른 것이 아닙니다.
다만 세부정보 수준은 문장 길이만 바꾼 것이 아닙니다. low·medium·high 조건은 각각 증거 한 개·두 개·제한 없는 설명을 요구하며, 정보 선택도 함께 달라집니다. 따라서 점수 차이를 순수하게 문장 길이 효과라고 볼 수 없습니다. Figure 8의 정확히 인쇄되지 않은 개별 막대값도 여기서 복원하지 않습니다.
5. 대화가 길어지면 항상 나아질까
추가 질문으로 새 증거를 얻을 수 있지만, 사용자의 해석이 반복되며 편향도 쌓일 수 있습니다. 저자들이 보고한 평균 양상은 2턴에서 4턴 사이 가장 크게 좋아진 뒤 대체로 정체하거나 낮아지는 것입니다. 2턴은 사용자 메시지 한 번과 assistant 답변 한 번이지 두 차례 상담 왕복이 아닙니다.
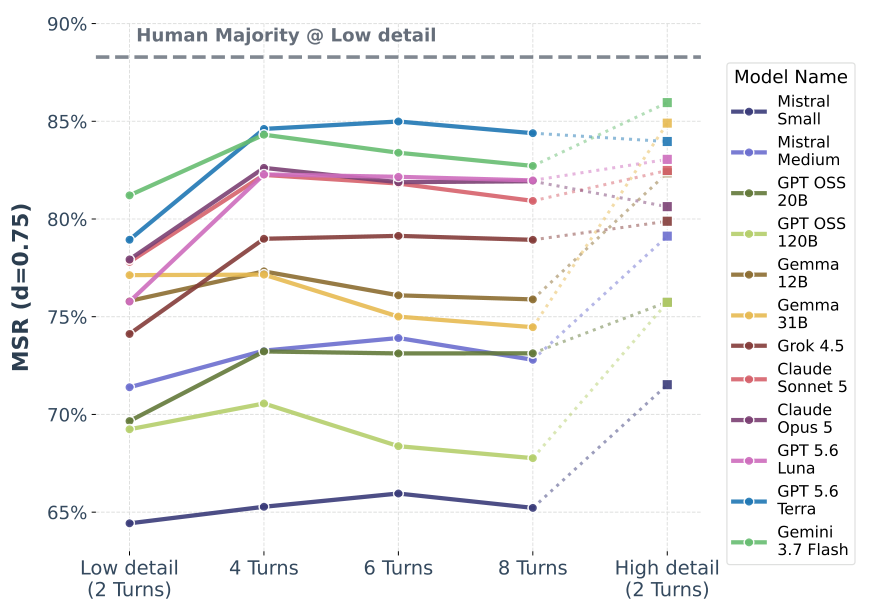
Figure 10. low-detail 시작 대화의 2·4·6·8턴과 별도 high-detail 2턴 조건. 개별 곡선의 라벨 없는 값을 정확한 수치로 옮기지 않았다. 출처: Taubenfeld et al. (2026), arXiv v1, p. 12, Figure 10.
이 다중 턴 사용자도 전체 시뮬레이션 이력을 아는 프로그램입니다. 실제 사용자의 기억이나 정보 수준을 재현한다고 검증된 것은 아닙니다. 그래서 추가 질문이 도움이 된 사례와 사용자의 framing을 받아들여 답이 나빠진 사례를 모두 보여 주지만, 이를 실제 상담에서의 개선율로 환산할 수는 없습니다.
6. 이 벤치마크가 보여 주는 것과 보여 주지 않는 것
Fuse의 장점은 타인의 동기를 판단하는 과정을 “사건을 직접 보기”와 “사용자가 다시 설명하기”로 나눠, 정보 선택과 프레이밍에 따른 실패를 시험할 방법을 제시한 점입니다. 합성 정답을 두고 사람에게도 사건과 설명을 읽게 한 점은 평가 설계의 강점입니다.
하지만 생성기와 Judge에 같은 Gemini 3.1 Flash-Lite를 사용했고, Judge가 모델의 답·오답·기권을 사람처럼 분류하는지 별도 대조 검증은 보고하지 않았습니다. 모델의 정확한 API 버전·seed·비용도 없고, 점수 차이에 대한 신뢰구간이나 통계 검정도 충분히 공개되지 않았습니다. 공식 README는 코드를 “곧 공개”할 예정이라고 적고 있으며, 연결된 데이터 전체를 내려 받아 실행 검증한 것도 아닙니다.
무엇보다 이 과제는 두 개의 정해진 동기 중 하나를 고르는 사회적 추론 시험입니다. 임상 평가, 위기 대응, 좋은 조언의 안전성, 현실 사람의 마음을 알아내는 성능을 측정하지 않습니다. Fuse의 결과는 통제된 사용자 매개 시뮬레이션에서 모델이 어떤 조건에 흔들리는지 보여 주는 진단 자료로 읽는 것이 적절합니다.
같이 읽기: 사회 시뮬레이션의 경계와 검증
References
Taubenfeld, A., Gekhman, Z., Grinstein-Dabush, A., Laish, I., Goldstein, A., Croak, M., Hassidim, A., Matias, Y., & Feder, A. (2026). Verifiable Social Reasoning for LLM Assistants [Preprint]. arXiv. https://arxiv.org/abs/2609.17496v1
Google Research. (2026). User-mediated social reasoning. https://github.com/google-research/google-research/tree/master/user_mediated_social_reasoning