Verifiable Social Reasoning for LLM Assistants
Fuse는 숨은 동기를 가진 사회 시뮬레이션을 사용자가 다시 이야기하게 해 상담 모델을 시험한다. 최고 MSR 83.7은 정답률이 아니며, 합성 동기를 실제 사람의 마음이나 조언 안전성으로 확대할 수 없다.
Paper: Amir Taubenfeld; Zorik Gekhman; Avigail Grinstein-Dabush; Itay Laish; Ariel Goldstein; Marian Croak; Avinatan Hassidim; Yossi Matias; Amir Feder (2026). Verifiable Social Reasoning for LLM Assistants. Google Research·Hebrew University·University of Cambridge. 앞의 두 저자는 동등 기여이며 순서는 무작위로 정했다. arXiv:2609.17496v1, 2026-09-15. PDF · 서지 정보 · 공식 저장소. 부록을 포함한 25쪽을 읽는다.
Abstract: “동료가 정말 도우려는 걸까, 내 자리를 노리는 걸까?”라는 질문에 모델이 접하는 것은 동료의 실제 마음이 아니라 사용자의 이야기다. Fuse는 먼저 숨은 동기를 정해 사회적 상호작용을 생성하고, 별도의 사용자 에이전트가 그 경험을 평가 대상 assistant에게 다시 말하게 한다. 이를 통해 의도한 정답은 알고 있으면서도 사용자의 정보 선택·해석을 거치는 상황을 만든다. 12개 모델은 직접 사건을 볼 때보다 상담자로 답할 때 더 어렵게 느끼고, 편향된 서술에 민감하며, 대화가 길어져도 반드시 개선되지 않는다. 다만 생성 시 지정한 동기는 현실의 인간 마음에 대한 객관적 판정이 아니고, 다수결 인간 기준선은 평균 개인의 능력이 아니다. 기권에 0.75점을 주는 MSR과 실제 조언의 안전성도 구분해야 한다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 질문 | 사용자에게서 간접적으로 들은 사건으로 타인의 동기를 얼마나 잘 구별하는가? |
| 방법 | 동기 설정 → 다중 에이전트 상호작용 → 사용자 재서술 → assistant 예측 → Judge 판정. |
| 자료 | 30개 시나리오×2개 동기×20개 실현=1,200개 시뮬레이션; 각 18개 재서술로 21,600개 첫 메시지. |
| 인간 검토 | 원시 사건 300개×10명, 첫 메시지 2,100개×10명으로 24,000개 주석. 24,000명의 참가자가 아니다. |
| 주 결과 | 최고 모델 MSR 83.7, 인간 다수결 89.8. MSR은 정답률이 아니라 정답+0.75×기권이다. |
| 편향 | 12개 모델 모두 MSR 하락. 높은 기권 모델을 제외한 8개는 6.9–12.5점, 인간 다수결은 3.6점 하락. |
| 세부정보·대화 | 저→고 세부정보에서 평균 MSR 74.2→80.1. 대화는 2→4턴에서 개선한 뒤 대체로 정체·하락한다. |
| 적용 경계 | 두 극단 동기를 구분하는 합성 진단이다. 실제 상담 품질·임상 안전성·인간 사회의 분포를 검증한 결과가 아니다. |
읽기 안내: 성능은 저자 보고이며 차이·분모·지표 성질만 재계산했다. 모델·인간 실험을 재실행하거나 공개 데이터의 모든 행을 감사하지 않았다. 정확한 값이 인쇄되지 않은 막대 길이에서 정답·오답·기권 비율을 임의 복원하지 않는다.
목차
- 사회적 사건과 사용자의 이야기는 다르다
- 숨은 동기를 가진 세계와 상담을 분리한다
- 인간 주석은 무엇을 검증했는가
- MSR은 정확도와 기권 정책을 함께 잰다
- 모델 순위를 읽기 전에 답변 전략을 본다
- 관찰자와 상담자의 격차를 어디까지 분해할까
- 사용자의 프레이밍과 기권이 만드는 편향 격차
- 더 많은 세부정보가 모델에 더 도움이 된다
- 대화가 길어지면 증거와 편향이 함께 쌓인다
- 알려진 정답과 좋은 사회적 조언 사이의 거리
1. 사회적 사건과 사용자의 이야기는 다르다
친구가 일대일 만남을 자주 제안한다는 동일한 사실도 “요즘 나를 특별히 챙겨”와 “원래 누구에게나 친절해”라는 해석을 붙이면 다르게 읽힌다. 상담 모델은 현장을 보지 않았으므로 정보 누락과 해석을 분리해야 한다. 동시에 실제 사람의 동기는 복합적이거나 알려지지 않아 일반 상담 로그에 확정 정답을 붙이기 어렵다.
Fuse(Framework for User-mediated Social Evaluation)는 정답을 나중에 추정하는 대신 생성 전에 설정한다. 한 에이전트에게 특정 동기를 부여하고 행동을 생성하게 한다. 별도의 사용자 에이전트가 그 경험을 설명하면 assistant가 후보 동기 중 하나를 고른다.
이것은 현실의 사람을 대체하는 인구 시뮬레이션과 목적이 다르다. 기존 이 트랙의 Boundary 리뷰가 묻는 것은 시뮬레이션에서 인간 사회로 어떤 주장을 옮길 수 있느냐이다. Fuse에서는 시뮬레이션을 별도 assistant를 평가하는 시험 환경으로 쓴다. 현실 인구 분포를 맞출 필요가 줄어드는 대신, 시험에서 드러나는 능력이 실제 상담으로 전이되는지는 따로 남는다.
2. 숨은 동기를 가진 세계와 상담을 분리한다
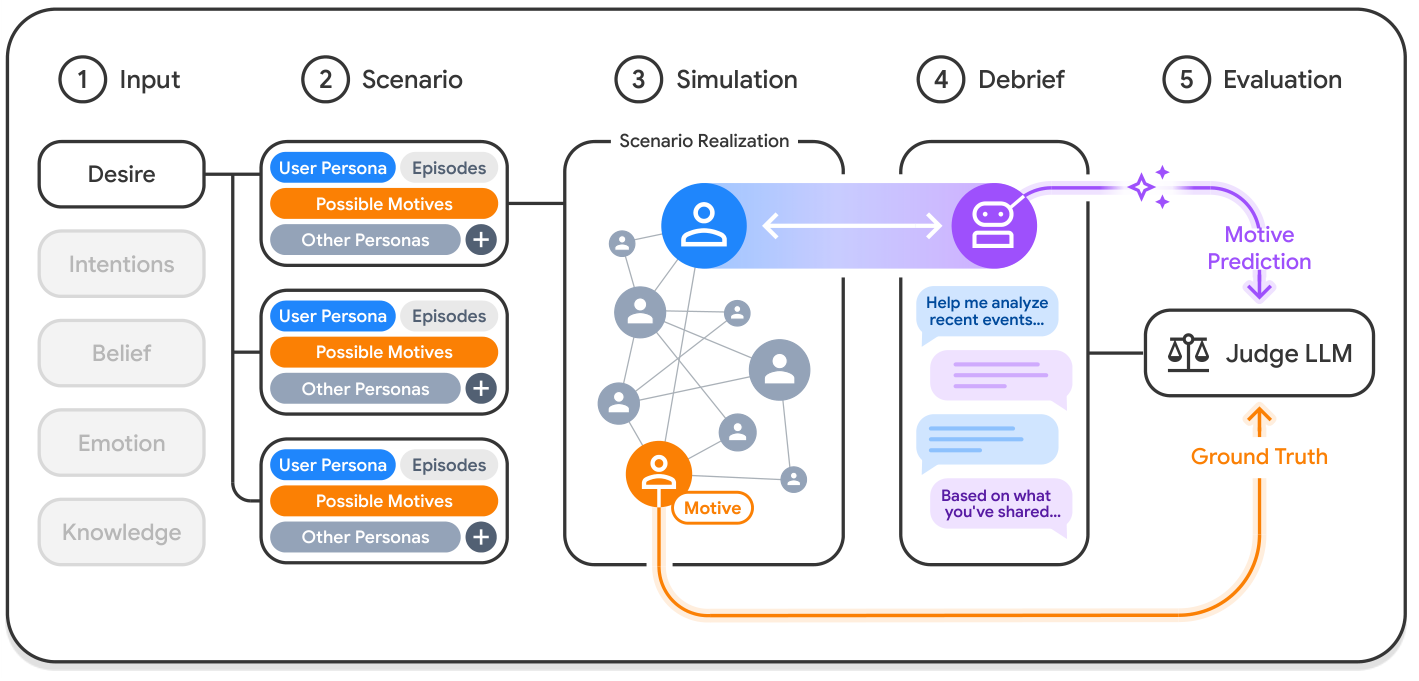
Figure 2. 시뮬레이션의 동기는 판정기에 전달되지만 평가 대상 assistant는 사용자의 재서술을 통해 사건을 접한다. 출처: Taubenfeld et al. (2026), v1, p. 3, Fig. 2 — 연구·학습 목적 인용.
2.1 다섯 정신상태 범주와 두 극단의 동기
ATOMS의 일곱 범주 중 desire·intention·belief·emotion·knowledge를 남긴다. 감각과 비문자적 의사소통은 텍스트만으로 충분히 표현하기 어렵다고 제외한다. 범주당 여섯 시나리오, 총 30개다.
각 시나리오에는 사용자·대상 인물·보조 인물, 관계, 여러 장면이 있다. 템플릿당 상호작용은 27라운드다. 저자는 네 단계의 동기 강도를 생성한 뒤 서로 가장 다른 양 끝 두 개만 고른다. 예컨대 강한 연애 감정과 명백한 플라토닉 우정이다. 실제처럼 혼합 동기를 풍부하게 재현하는 대신 구별 가능한 시험을 의도한다.
2.2 사건은 고정하고 사용자의 설명 조건을 바꾼다
Concordia 기반 시뮬레이션에서 Gemini 3.1 Flash-Lite가 모든 페르소나를 구동한다. 각 시나리오·동기마다 20개 실현을 만든다. 같은 사건에서 두 보고 조건(default / 정답 반대쪽으로 기울인 믿음)과 세 세부정보 수준을 조합한다.
- Low: 증거 한 개를 말하도록 지시.
- Medium: 증거 두 개를 말하도록 지시.
- High: 증거 수를 제한하지 않음.
평균 메시지 길이는 520·710·1,010 문자다. 토큰 수나 추론 비용이 아니다. Default도 완전한 중립이 아니다. 상담을 시작한다는 행위에 이미 희망·의심·불안이 있을 수 있다고 저자들이 명시한다.
2.3 분리의 장점과 대가
사회적 사건이 끝난 뒤 상담을 시작하므로 같은 사건을 여러 평가 모델에 재사용할 수 있다. 자료의 규모는 다음과 같다.
30\times2\times20=1{,}200,\qquad
1{,}200\times2\times3\times3=21{,}600.
마지막 3은 각 조건의 재서술 샘플 수다. 21,600개의 서로 독립적인 사회 상황이라는 뜻은 아니다. 30개 템플릿과 1,200개 사건을 공유하는 계층적 자료다. 현실에서는 조언을 들은 사람이 다음 행동을 바꿀 수 있지만, 여기서는 상담 결과가 이미 끝난 사건을 바꾸지 않는다.
3. 인간 주석은 무엇을 검증했는가
3.1 설정한 동기와 관찰 가능한 행동은 별개다
프롬프트에 ‘진심으로 도와준다’고 적었다고 행동에 그 동기가 반드시 드러나는 것은 아니다. 그래서 저자들은 두 단계로 인간에게 묻는다.
| 검토 | 문항×평가자 | 결과와 역할 |
|---|---|---|
| 원시 사건의 동기 식별 | 300×10=3,000 | 다수결 약 97% 일치. 부록 표기는 96.9%, 평균 agreement 91.2%. |
| 첫 사용자 메시지의 동기 식별 | 2,100×10=21,000 | 정답률 약 88%, MSR 89.8, 평균 agreement 86.8%. |
총 24,000은 주석 수다. 참가자 수나 독립 사건 수가 아니다. 첫 메시지는 세 detail 수준에서 각 700개이며 bias 조건은 절반씩이다. 동률은 기권 처리하고, 부록은 첫 메시지 다수결 기권 비율을 2.8%라고 한다.
사람은 정답을 새로 만드는 것이 아니라 설정된 정답이 생성된 텍스트에 알아볼 수 있게 나타났는지 확인한다. 97%라는 결과는 이 역할에서 유용하지만 시뮬레이션이 현실의 인간 행동 빈도·문화·혼합 동기를 재현했다는 검증은 아니다.
3.2 인간 다수결은 평균 인간도 정확한 상한도 아니다
논문은 10명 다수결을 개인 능력 측정이 아니라 ‘이 텍스트에서 어느 정도 답을 복구할 수 있는가’의 경험적 기준으로 사용한다. 따라서 모델이 평균 사람보다 몇 점 낮다고 바꾸지 않는다. 인간도 틀릴 수 있으므로 88%가 이론적인 최대 정확도나 12% 문항의 원천적 불가능성을 뜻하지 않는다.
97%와 88%도 다른 입력과 표본의 집계다. 차이 약 9점을 모두 사용자 때문에 잃은 정보의 순수 인과 효과로 계산하지 않는다. 모델 전체 자료 21,600개와 인간 부분표본 2,100개의 집계 비교 역시 동일 문항에서의 paired 성능 차이와 구분해야 한다.
반올림 주의: 89.8 MSR과 2.8% 기권에서 역산한 정답률은 87.7%로, 본문의 정수 반올림 88%와 정합적이다. 이것은 원시 정답 건수를 확인한 값이 아니므로 새로운 정확한 인간 성과로 채택하지 않는다.
4. MSR은 정확도와 기권 정책을 함께 잰다
Judge는 답을 Correct·Incorrect·Not Attempted로 분류한다. 판정기는 시뮬레이터와 같은 Gemini 3.1 Flash-Lite이고, 평가되는 12개 모델에는 포함되지 않는다.
\mathrm{MSR}(d)=\frac{C+dA}{C+I+A},\qquad d=0.75.여기서 C는 정답, I는 오답, A는 기권이다. 문맥마다 달라질 수 있는 주관적 비용을 한 가지 값으로 정한 지표이며, 논문은 무작위 이진 추측의 기대점수 0.5와 완전 정답 1의 중간을 선택했다고 설명한다.
언제나 기권해도 75점이다
- 전부 무작위 이진 추측: 기대 MSR 50.
- 전부 기권: MSR 75.
- 80% 정답·20% 오답·기권 없음: MSR 80.
이는 설명용 계산이지 추가 평가 모델이다. 기권을 적절히 보상하려는 설계지만 MSR 81이 곧 정답률 81%는 아니다. 정확한 확률과 이 보상만을 최적화한다는 가정에서는 가장 유력한 답의 정답 확률이 0.75보다 높아야 기권보다 답하기가 유리하다. 실제 모델의 확률이 교정됐거나 그런 정책을 썼다는 뜻은 아니다.
연구는 추론 신호를 얻으려고 두 후보를 제시하며 명확히 답하라는 forced-choice 질문을 사용한다. 기권을 허용하면서도 지시상 답을 요구하는 조건이다. 불확실한 실제 사람의 마음을 단정하라는 운영 권고가 아니고, d=0.75가 임상적·사회적 효용을 측정해 얻은 최적값도 아니다.
5. 모델 순위를 읽기 전에 답변 전략을 본다
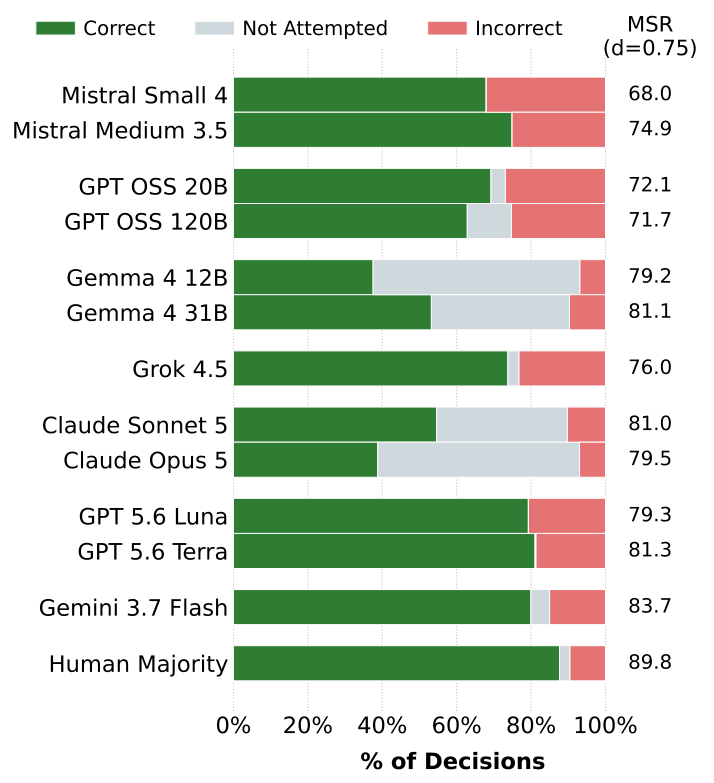
Figure 4. 녹색 정답·회색 기권·빨간 오답과 별도로 MSR을 표시한다. 막대에 인쇄되지 않은 구성 비율을 정확한 수치로 옮기지 않는다. 출처: Taubenfeld et al. (2026), v1, p. 7, Fig. 4 — 연구·학습 목적 인용.
| 모델 | MSR(0.75) |
|---|---|
| Mistral Small 4 | 68.0 |
| Mistral Medium 3.5 | 74.9 |
| GPT OSS 20B | 72.1 |
| GPT OSS 120B | 71.7 |
| Gemma 4 12B | 79.2 |
| Gemma 4 31B | 81.1 |
| Grok 4.5 | 76.0 |
| Claude Sonnet 5 | 81.0 |
| Claude Opus 5 | 79.5 |
| GPT 5.6 Luna | 79.3 |
| GPT 5.6 Terra | 81.3 |
| Gemini 3.7 Flash | 83.7 |
| 인간 10명 다수결 | 89.8 |
Figure 4의 저자 표시값. 인간은 별도 부분표본이다. 최고 모델과의 차이는 MSR 6.1점이지 정답률 6.1%p라고 단정할 수 없다.
Mistral·GPT 5.6은 거의 항상 예측하는 반면 Gemma·Claude 네 모델은 명시적 선택 요청에도 3분의 1 넘게 기권한다고 보고한다. 후자는 낮은 오류율과 답변을 제공하지 않는 비용을 함께 가진다. 큰 모델이 항상 높은 MSR을 보이는 것도 아니다. GPT OSS 120B는 20B보다, Claude Opus는 Sonnet보다 낮다. 능력 하나로 순위를 환원할 수 없다.
본문의 모델 설명에는 ‘open 6개, closed 7개’라고 적혀 있지만 열거한 closed 모델은 6개이고 Figure 4의 평가 모델 합계는 12개다. 이 리뷰는 그림의 12개 목록을 따른다. 생성기·Judge까지 평가 모델 순위에 포함하지 않는다.
6. 관찰자와 상담자의 격차를 어디까지 분해할까
Observer는 원시 사건 기록을, Assistant는 사용자의 재서술을 읽는다. Figure 5와 부록 Figure 16에서 모든 모델의 정답 비율이 Assistant 조건에서 줄고 오류가 늘어난다. 일부는 기권도 크게 증가한다.
원시 사건을 직접 보아도 Mistral Small 4의 오류율은 20.9%라고 보고한다. 반면 Claude Opus 5와 Gemini 3.7 Flash는 Observer에서 거의 완벽하다. Claude는 Assistant에서 기권이 크게 늘어, 동기를 구분할 잠재 능력과 상담자로서 조심스럽게 답하는 정책이 다를 수 있음을 보여 준다.
이를 ‘사용자 매개 비용’으로 부르는 것은 유용하지만 정보량만 바꾼 실험은 아니다. 입력 길이·선택된 사실·해석·관찰자/상담자 역할과 질문 표현이 달라진다. 예를 들어 질문의 사용자 이름이 Assistant에서는 ‘me’로 바뀐다. 또 사용자 시뮬레이터의 고유한 말투나 정보 선택 효과도 있다.
저자 역시 §5.3에서 simulator 효과와 실제 사용자 매개의 내재적 어려움을 실증적으로 분리하지 못했다고 명시한다. 따라서 전체 격차를 모델의 동조 성향 하나나 순수한 사회 추론 능력 부족에 배정하지 않는다. 다수결 인간이 잘 푸는 사례가 많다는 것은 개선 여지를 보여 주지만, 모든 개별 질문이 명확하다는 뜻은 아니다.
7. 사용자의 프레이밍과 기권이 만드는 편향 격차
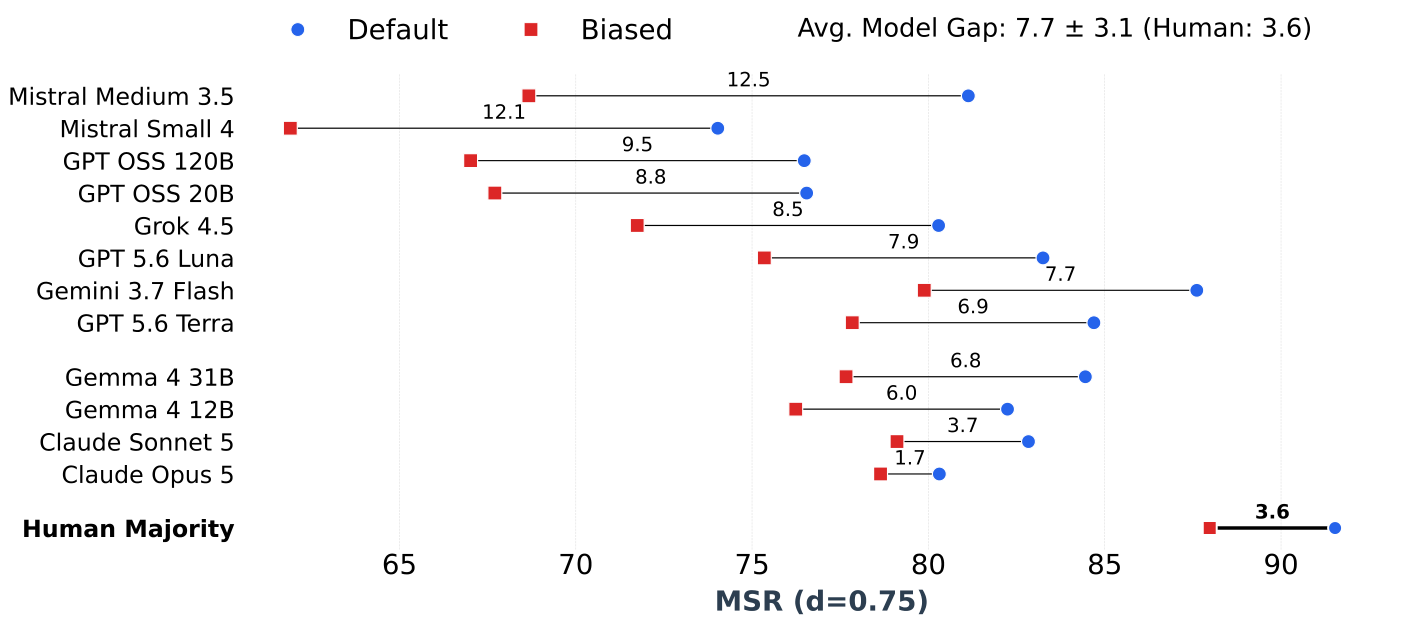
Figure 6. 동일한 사건에서 사용자의 재서술 조건을 바꾼다. 각 차이는 MSR 점수 차이다. 출처: Taubenfeld et al. (2026), v1, p. 9, Fig. 6 — 연구·학습 목적 인용.
모델별 하락은 Mistral Medium 12.5, Small 12.1, GPT OSS 120B 9.5, 20B 8.8, Grok 8.5, GPT Luna 7.9, Gemini 7.7, GPT Terra 6.9, Gemma 31B 6.8, 12B 6.0, Claude Sonnet 3.7, Opus 1.7점이다. 인간 다수결은 3.6점이다.
12개 표시값의 평균은 약 7.7점이다. 논문이 중점적으로 해석하는 기권이 높은 네 모델을 뺀 8개의 범위는 6.9–12.5점이다. 전체 평균과 8개 모델의 범위를 섞지 않는다.
Claude Opus의 작은 차이는 곧바로 뛰어난 편향 저항성을 뜻하지 않는다. 기본·편향 조건 모두 기권을 많이 하면 0.75점 항이 점수를 지탱해 조건 차이를 압축할 수 있다. 오답률·정답률·기권 변화와 d를 바꾼 민감도까지 보아야 한다.
같은 원시 사건을 쓰는 것은 중요한 통제다. 그러나 생성된 재서술의 사실 목록까지 완전히 동일하게 고정한 최소 텍스트 쌍은 아니다. 편향 지시가 표현뿐 아니라 무엇을 말하는지 바꿀 수 있다. 인간의 하락보다 모델 하락이 크다는 것은 단순 정보 손실만으로 설명하기 어렵다는 단서이지 순수 동조 효과의 인과적 크기를 식별한 것은 아니다.
Figure 7은 배우려는 동료의 행동을 사용자가 수상하게 묘사하자 모델이 권력 확보 전략으로 확대하는 사례다. 이 사례는 합성 정답을 기준으로 한 오류 양상을 보여 주며, 같은 표현을 쓰는 실제 동료의 동기를 판정하는 규칙으로 일반화하지 않는다.
8. 더 많은 세부정보가 모델에 더 도움이 된다
Low→High에서 평균 모델 MSR은 74.2→80.1로 5.9점, 인간 다수결은 88.3→91.1로 2.8점 높아진다. 격차는 14.1→11.0으로 3.1점 줄어든다.
\frac{14.1-11.0}{14.1}\approx21.99\%.즉 약 22%는 인간–모델 MSR 격차의 상대 감소다. 모델 정확도가 22%p 증가했다는 뜻이 아니다. 12개 중 10개 모델에서 인간과의 격차가 좁아졌다는 보고 역시 모든 모델·모든 문항에 같은 효과가 있다는 뜻은 아니다.
이 결과는 사람이 이미 구별할 수 있는 낮은 detail에서도 모델은 더 많은 설명이 있어야 답을 맞힐 수 있음을 시사한다. 그러나 low와 high는 동일 문자열에 사실 하나만 덧붙인 완벽한 중첩 입력이 아니다. 증거의 종류·길이·표현을 함께 바꾸는 생성 조건이다. 문자 수 520→1,010을 동일 비율의 정보량이나 추론 비용 증가로 읽지 않는다.
Figure 9의 사례는 실직한 룸메이트가 괜찮다는 합성 정답인데 모델이 낮은 detail에서 distress를 선택하는 경우다. 동기 분류의 오답과 조언의 안전성은 별도다. 모델의 위기 대응 언급은 조건부 문장도 포함한다. 이 사례만으로 실제 상담에서 위험 확인이나 지원 안내가 불필요하다고 결론내릴 수 없고, 웃는 사람은 반드시 괜찮다는 규칙도 아니다. 논문은 임상 결과나 위기 탐지 민감도를 측정하지 않았다.
9. 대화가 길어지면 증거와 편향이 함께 쌓인다
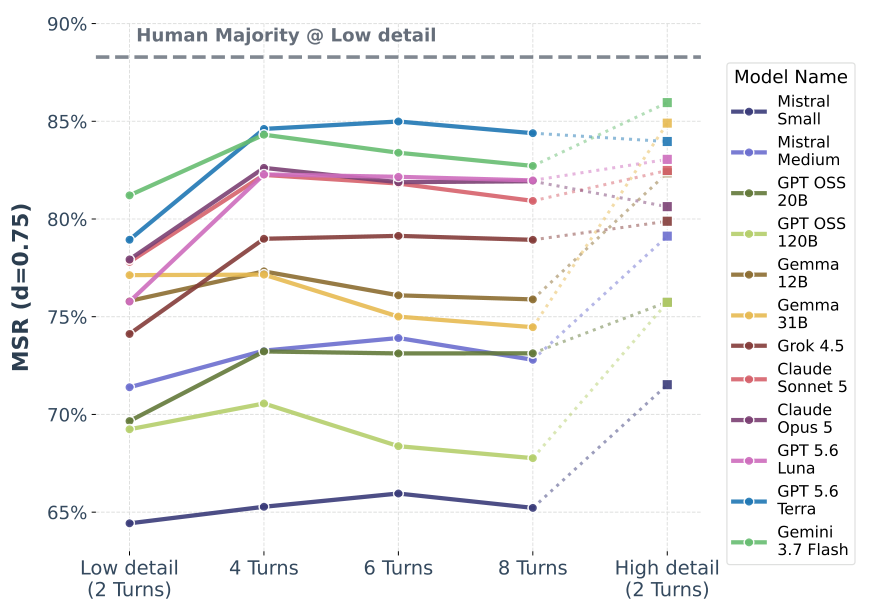
Figure 10. Low-detail의 2·4·6·8턴과 별도 High-detail 2턴 조건이다. 2턴은 사용자 메시지와 assistant 응답 한 쌍이지 두 번의 상담 왕복이 아니다. 출처: Taubenfeld et al. (2026), v1, p. 12, Fig. 10 — 연구·학습 목적 인용.
추가 질문은 새 증거를 끌어낼 기회다. 보고된 평균적 양상은 2→4턴에서 가장 크게 좋아지고 이후 정체하거나 떨어지는 것이다. 본문은 대부분의 모델이 8턴에서도 High-detail 첫 응답 조건보다 낮다고 설명한다. 그래프에 인쇄되지 않은 턴별 정확한 값을 만들어내지 않는다.
기권을 줄이는 것과 점수를 높이는 것은 다르다
초기 기권 사례를 따로 보면 8턴에 58%가 정답, 24%가 오답, 18%가 계속 기권이다. 이 조건부 집단의 표시 비율에 d=0.75를 적용하면 MSR은 다음과 같다.
58+0.75\times18=71.5.초기에는 모두 기권이므로 75점이었다. 따라서 답을 더 많이 제공하고 다수가 정답으로 바뀌어도 이 보상에서는 집단 점수가 낮아질 수 있다. 이는 전체 모델 MSR의 전후 변화가 아니라 초기 기권 집단에 한정한 설명용 산술이다.
처음에 답을 택한 사례는 81%가 같은 입장을 유지하고, 8%가 오답 쪽, 11%가 정답 쪽으로 이동했다고 보고한다. 분모가 이미 답을 택한 사례이지 전체 데이터나 초기 오답만이 아니다. 초기 정답률을 모르면서 이를 ‘오답 교정률 11%’로 쓰지 않는다.
사례 분석에는 구체적인 친밀 행동을 추가로 물어 올바르게 수정한 경우와, 사용자의 해석이 누적되자 정답에서 오답으로 돌아선 경우가 모두 있다. 다만 대화 길이별 질문의 질·새 사실의 양·편향 축적을 각각 조작한 절제는 아니다. 동일한 안전하고 검증된 user simulator를 지속적으로 제공해야 다중 턴 benchmark가 안정적이라는 과제도 저자들이 남긴다.
10. 알려진 정답과 좋은 사회적 조언 사이의 거리
10.1 저자가 명시한 한계
- 실제 동기는 항상 복구 가능하지 않으며 사용자 설명에는 선택·해석이 있다.
- 단일한 뚜렷한 동기의 양 끝을 선택한 초기 연구다.
- 지표의 최적 기권 정책은 범위 밖이다.
- user simulator의 효과와 내재적 사용자 매개 난이도를 분리하지 못했다.
- 자연스러운 긴 응답의 암묵적 기울기를 판정하는 것은 Judge 편향에 취약해 이번 연구에서 정량화하지 않았다.
- 정적 첫 메시지 자료가 중심이며 안정적인 다중 턴 평가 환경은 후속 과제다.
10.2 해설자 관점의 추가 검증
구성 타당도: 동기를 설정하고 사람이 알아봤다는 것은 생성기가 지시를 표현했다는 근거다. 현실의 마음 상태를 읽는 정확도나 자연스러운 동기 분포까지 검증한 것은 아니다. 시뮬레이션 검증에 사람을 포함한 장점은 인정하되, 인간 사회에 대한 외적 타당도와 구분해야 한다.
판정기의 독립성: 같은 Flash-Lite가 사람 역할과 Judge를 맡고, 평가 답변의 Correct/Incorrect/기권 판정에 대한 별도 인간 대조 정확도는 논문에 보고되지 않는다. 24,000개 인간 주석은 주로 입력에서 동기를 복구하는 평가이지 Judge가 모든 모델 응답을 올바르게 분류하는지 검사한 것이 아니다.
통계 단위: 여러 메시지가 사건과 템플릿을 공유한다. 21,600개 독립 표본처럼 오차를 계산하면 과도한 확신을 만들 수 있다. 템플릿·사건 수준 bootstrap, 문항별 paired 비교, 여러 생성기·Judge·기권 가중치에서의 민감도가 필요하다. 이는 해설자의 제안이며 논문이 이를 모두 수행했다는 뜻은 아니다. Figure 8의 ±1 SD는 반복 단위가 명확히 설명되지 않아 개별 추정치의 신뢰구간으로 취급하지 않는다. Figure 6의 ±3.1이나 본문의 “significantly”도 보고되지 않은 통계 검정의 증거로 바꾸지 않는다.
안전과 효용: 다른 사람의 마음을 틀리게 단정하는 비용은 실제 상황마다 다르다. 양끝 정답을 맞히는 지표만으로 신중한 대화·적절한 질문·당사자와의 직접 확인·임상적 조언을 평가할 수 없다. 높은 MSR을 실제 상담 배포의 충분조건으로 삼지 않는다.
10.3 공개 상태 확인
논문은 코드와 자료를 공개한다고 쓰지만, 검토한 README revision은 **“Code would be released soon.”**이라고 표시하고 Kaggle 데이터셋을 연결한다. README와 데이터셋 페이지의 존재는 확인했지만 데이터 전체 행·생성기·Judge 구현을 실행 검증한 것은 아니다. 공개 약속과 현재 재현 가능한 범위를 구분한다.
Fuse의 기여는 현실을 완벽히 복제했다는 데 있지 않다. 사건을 직접 볼 때와 사용자에게서 들을 때를 분리하고, 같은 사건의 재서술 조건을 바꾸며, 정답 가능성을 인간에게도 확인한 평가 설계에 있다. 이 틀을 이용해 어떤 모델이 언제 기권하고, 어떤 표현에 흔들리며, 무엇을 물어야 오류를 고칠 수 있는지 더 구체적으로 조사할 수 있다. 그 결과를 현실의 마음 읽기나 좋은 조언 전체로 확대하지 않는 것이 다음 검증의 출발점이다.
References
Taubenfeld, A., Gekhman, Z., Grinstein-Dabush, A., Laish, I., Goldstein, A., Croak, M., Hassidim, A., Matias, Y., & Feder, A. (2026). Verifiable Social Reasoning for LLM Assistants [Preprint]. arXiv. https://arxiv.org/abs/2609.17496v1
Google Research. (2026). Fuse: Verifiable Social Reasoning for LLM Assistants [Release README, revision 8025cf1351da4d3cb8c289afe2d11247623fbdfb]. https://github.com/google-research/google-research/tree/8025cf1351da4d3cb8c289afe2d11247623fbdfb/user_mediated_social_reasoning
선행 연구 범위: ATOMS·Concordia·Theory of Mind 및 sycophancy 연구의 관계는 대상 논문의 §§2·5·6과 부록 설명을 따른다. 각 선행 연구의 원자료·전체 결과를 별도로 재감사한 것은 아니다.