Harness-Aware Distillation for Small Language Model Agents
Harness가 남아 있을 때, 작은 모델은 무엇을 배워야 할까요?
같은 학생 방문 상태에서 harness 유무만 달리한 교사 행동을 비교하고, 학생 reasoning 뒤에서 행동 선호를 학습한다. HAD의 전체 응답 NLL·유효성 마스크·세 환경의 점수와 harness 지표를 살펴본다.
Paper: Moonseok Choi; Taehong Moon; Giung Nam; Juho Lee (2026). "Harness-Aware Distillation for Small Language Model Agents". Choi·Nam·Lee는 KAIST AI 소속이며, Moon은 독립 연구자입니다. arXiv:2610.02858v1 · v1 PDF · 프로젝트. 2026년 10월 2일 공개된 v1, 28쪽을 기준으로 합니다.
언어 모델 에이전트는 환경에서 관측을 받고 행동하며 여러 차례 과제를 수행합니다. 이 논문에서 harness는 모델 주변에서 문맥·도구·피드백을 관리하고, 위치나 사용 가능한 행동 같은 정보를 모델에게 보여 주는 소프트웨어입니다. **교사(teacher)**는 더 큰 모델, **학생(student)**은 교사의 출력을 학습하는 작은 모델입니다. **증류(distillation)**는 교사가 만든 출력을 학생이 배우는 과정이며, rollout은 에이전트가 환경과 주고받은 관측과 행동의 이력입니다.
1. Harness를 남기고 무엇을 가르칠까요?
학생을 배포할 때에도 같은 harness가 계속 동작한다면, 학생이 모든 상태 기록을 가중치에 복사할 필요는 없습니다. 학생에게 필요한 것은 harness가 보여 준 현재 위치·보유물·실패 이력을 보고 다음 행동을 고르는 능력입니다. HAD는 harness를 없애지 않고, 배포 때도 harness가 텍스트 정보를 제공합니다. 행동 선택을 대신하는 별도 controller나 행동을 차단하는 규칙을 추가하지 않습니다.
논문의 환경에서 에이전트는 Thought: <brief reasoning>과 Action: <one command> 두 줄로 응답합니다. 여기서 reasoning은 Thought에 쓰는 짧은 판단이고, action은 환경이 실행할 command입니다. HAD의 학생은 이 행동 형식을 유지하면서 교사의 응답과 행동 비교를 학습합니다.
2. 같은 방문 이력에서 교사 행동을 비교합니다
학습 중 학생이 harness를 켠 채 환경과 상호작용하고, 자신이 방문한 각 상태에서 같은 교사에게 두 입력을 줍니다. 하나는 현재 harness 정보가 들어간 이력이고, 다른 하나는 그 이력에서 harness가 덧붙인 정보만 지운 이력입니다. Harness를 보며 이미 선택한 과거 행동과 그 결과는 그대로 남아 있습니다. 따라서 두 번째 입력은 처음부터 harness 없이 다시 실행한 별도 궤적이 아닙니다.
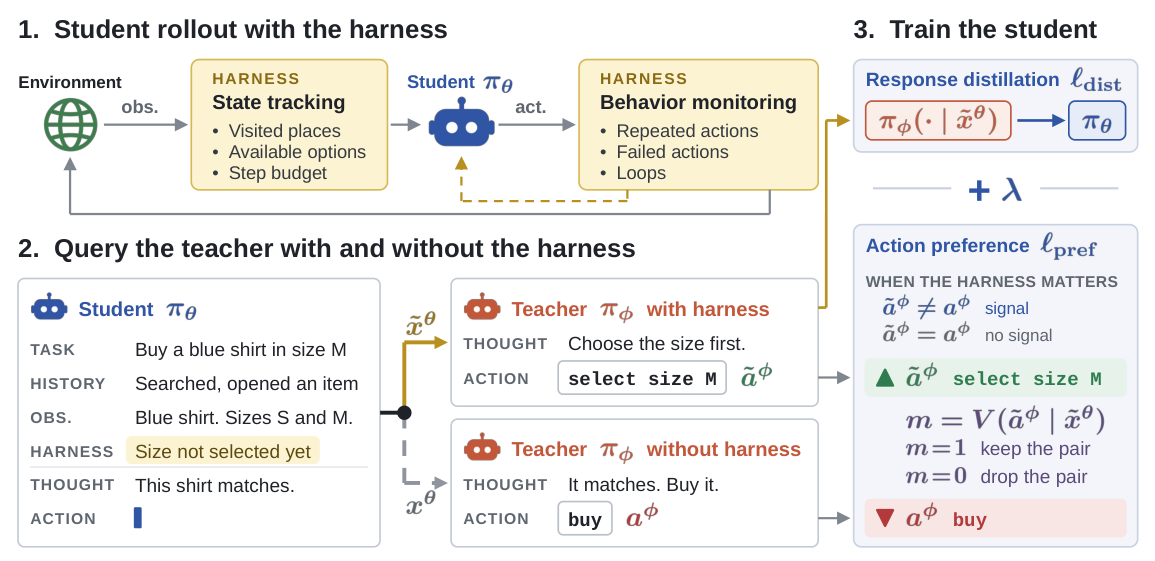
Figure 3, Choi et al. (2026), v1 PDF p.5. 같은 학생 방문 상태에서 harness 포함·제거 입력으로 teacher response를 만들고, student의 reasoning을 공통 prefix로 action을 비교합니다.
이 비교에서 harness를 본 교사의 행동을 positive, harness 정보를 지운 교사의 행동을 negative로 둡니다. 이는 현재 입력의 차이를 만드는 방법이지, harness가 궤적 전체에 미친 영향을 지운 counterfactual은 아닙니다. 평가에서 harness를 끄더라도 환경이 원래 보여 주는 admissible command와 prompt history는 남습니다.
3. 응답 전체와 행동만을 서로 다르게 학습합니다
첫째, HAD는 harness를 본 교사의 전체 응답을 학습합니다. 교사의 reasoning과 action token 모두를 평균 token NLL(음의 로그우도)로 따라갑니다. 학생이 교사 응답에 낮은 확률을 줄수록 커지는 손실입니다. 그래서 validity checker가 어떤 positive action을 유효하지 않다고 표시하더라도 그 action이 포함된 teacher response의 NLL 학습은 그대로 남습니다.
둘째, HAD는 positive와 negative 교사 행동을 학생이 실제로 만든 reasoning 뒤에서 비교합니다. 두 action은 같은 학생 prefix로 점수를 받고 action token만 비교 대상입니다. 교사 reasoning의 길이나 문체가 preference 점수를 직접 좌우하지 않습니다. 이 preference 학습은 response NLL과 다른 항입니다. 특히 비교군 OPD가 학생이 생성한 응답에서 교사와 학생의 토큰 확률분포 차이인 reverse-KL을 계산하는 것과 달리, HAD의 응답 학습은 샘플한 teacher full response의 NLL입니다.
4. 현재 기록으로 선호 쌍을 거릅니다
현재 harness 기록과 모순되는 positive action은 preference 항에서만 제외합니다. 예를 들어 사용 가능한 command 목록에 없거나, 들고 있지 않은 물체를 쓰거나, 같은 상태에서 효과가 없다고 기록된 행동을 반복하는 경우가 포함됩니다. Negative action에는 같은 검사를 적용하지 않습니다. 이 checker는 task 완료 여부를 확인하는 성공 판정기가 아닙니다.
HAD의 학습 손실과 현재 상태 checker에는 task reward, success label, 미래 trajectory가 들어가지 않습니다. 다만 이 사실을 개발 과정 전체에 reward나 성공 레이블이 전혀 쓰이지 않는다고 넓혀 말할 수는 없습니다. Harness warning threshold는 성공한 validation episode에서 보정합니다. 학습 전 모델의 성공한 validation episode에서 harness가 경고를 내는 step의 비율이 5% 이하가 되도록 기준을 보정합니다. 이 validation task는 evaluation task와 분리됩니다.
5. 세 환경에서 무엇을 측정했을까요?
논문은 ALFWorld, WebShop, ScienceWorld를 평가합니다. **SR(success rate)**은 task 성공 비율입니다. ALFWorld에서는 task 완료, WebShop에서는 reward가 1인 경우, ScienceWorld에서는 final task score가 100 이상인 경우를 성공으로 셉니다. WebShop의 score는 평균 final reward에 100을 곱한 값이고, ScienceWorld의 score는 음수도 가능한 final task score입니다. 따라서 WebShop score와 ScienceWorld score는 서로 같은 척도가 아닙니다.
| 환경 | 학생 ← 교사 | Test 조건; 최대 step / 응답 token | HAD 결과(SR: %) |
|---|---|---|---|
| ALFWorld | Qwen3-1.7B ← 8B | unseen 134, seen 140; 30 / 2,048 | SR 63.43 / 51.43 |
| WebShop | Qwen3-0.6B ← 30B-A3B | 500 goals, 1,000-product 버전; 15 / 512 | score 47.19, SR 19.60 |
| ScienceWorld | Qwen3-0.6B ← 30B-A3B | 149 variations, 30 types; 15 / 128 | score 4.17, SR 9.40 |
ALFWorld에서 unseen의 최강 학생 baseline은 47.01이고 seen에서는 41.43입니다. HAD는 각각 16.42, 10.00 percentage points(pp) 높습니다. Teacher의 수치는 51.49/50.00입니다. WebShop에서는 HAD SR 19.60%가 최고 baseline인 OPD 19.00%보다 0.60 pp 높고, score 47.19는 최고 baseline score 43.89보다 3.30점 높습니다. ScienceWorld에서는 HAD SR 9.40%가 최고 baseline OPD 8.05%보다 1.35 pp 높고, score 4.17은 최고 baseline score 0.77보다 3.40점 높습니다. 두 환경의 teacher는 score/SR 각각 49.96/18.80, 20.26/20.13입니다.
절제 실험의 57.4% SR은 표에 표시된 unseen 63.43%, seen 51.43%의 산술평균을 반올림한 값과 일치합니다. 반면 각 test 규모 134·140을 가중치로 적용해 표시값을 평균하면 약 57.3%입니다. 두 집계 방식은 다릅니다.
6. Harness 이용과 정체 회복은 어떻게 셀까요?
논문의 **harness utilization(HU)**은 다섯 가지 규칙—사용 가능한 action, 보유물, budget warning, 실패, stall—을 각각 적용 가능한 step에서 평가하고, 그 다섯 준수율의 단순 평균을 냅니다. HAD의 구성 점수는 93.3, 99.0, 87.7, 91.1, 33.8이고, HU는 81.0입니다. 그러므로 HU 81.0은 모든 action 중 81%가 정답이라는 뜻이 아닙니다.
Stall 규칙은 warning 뒤 5 step 안에 episode에서 처음 보는 상태에 도달하거나 성공하면 그 행동 흐름을 일관된 대응으로 셉니다. 이는 offline 평가에서 미래 step을 보는 정의이며, 앞서 설명한 학습 시점 validity checker와 다릅니다. 논문에서 HAD의 prevention은 stall 없이 끝난 episode 비율로 75.9, recovery는 관측된 stall에서 벗어난 비율로 59.7입니다. 새로운 상태에 도달한 회복과 task 성공은 구분됩니다.
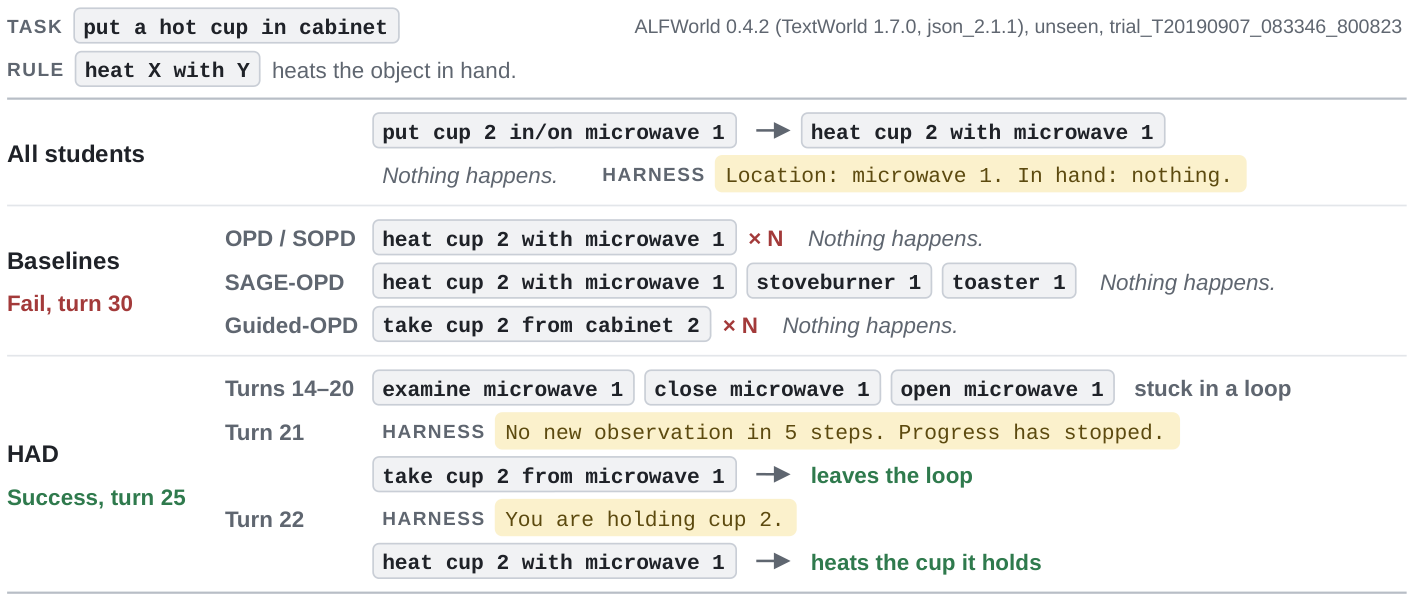
Figure 4, Choi et al. (2026), v1 PDF p.7. 빈손으로 가열을 시도한 뒤 cup을 다시 집어 진행하는 한 rollout의 회복 행동입니다.
7. 절제 실험과 harness 유지 조건을 살펴봅니다
ALFWorld 절제 결과는 HAD가 57.4 SR·81.0 HU입니다. Validity filter를 빼면 50.8·78.9, negative action을 제외한 positive-only 조건은 52.4·74.4, preference 항을 없앤 조건은 43.5·73.1입니다. 이 변형들은 서로 다른 구성 요소를 비교합니다.
기본 조건에서 HAD는 방문 상태마다 교사에게 harness 포함·제거 입력을 모두 주므로 OPD/SOPD보다 교사 응답을 한 번 더 받습니다. 논문의 budget 비교는 OPD와 SOPD의 trajectory 수와 update 수를 각각 2배로 한 조건입니다. ALFWorld unseen/seen SR은 OPD가 47.0/40.0에서 47.8/45.7, SOPD가 45.5/41.4에서 50.8/42.9로 바뀌며, HAD는 63.4/51.4입니다. 이 비교는 총 token 수, GPU 시간, wall-clock을 같게 맞춘 결과는 아닙니다.
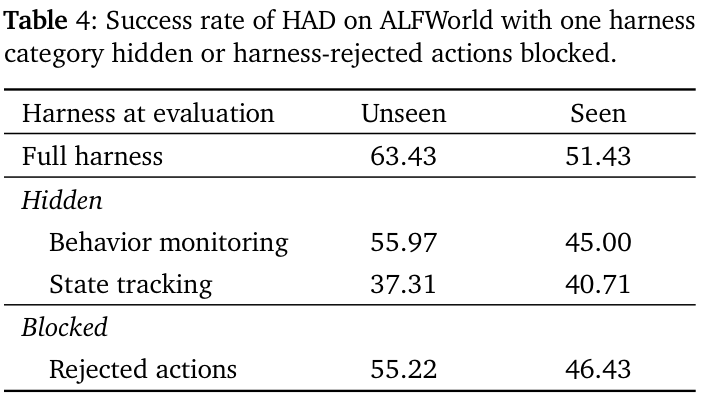
Table 4, Choi et al. (2026), v1 PDF p.8. ALFWorld에서 state tracking·behavior monitoring 정보를 가리거나 harness가 거부한 행동을 차단한 조건을 비교합니다.
Qwen HAD의 ALFWorld unseen SR은 harness를 켰을 때 63.43, 끈 조건에서 40.30입니다. ScienceWorld score는 harness on 4.17, off 4.37입니다. Gemma 모델군의 harness-off unseen에서는 SOPD가 29.85, HAD가 23.88입니다. 따라서 결과는 일부 feedback이 학생에게 학습될 수 있음을 보여 주지만, student weights가 harness의 모든 정보를 대체했다는 뜻은 아닙니다.
저자들은 세 텍스트 환경, 작은 학생, 최대 30B급 교사, 손으로 만든 harness를 평가 범위로 듭니다. 더 큰 모델, tool-calling이나 software agent, 학습·자동 최적화되는 harness로의 확장은 논문의 향후 연구 범위입니다.
References
Choi, M., Moon, T., Nam, G., & Lee, J. (2026). Harness-aware distillation for small language model agents [Preprint]. arXiv. https://arxiv.org/abs/2610.02858v1