Context Language Models
대화 기록을 파일로 바꿔 에이전트가 고치게 하다: CLM 쉽게 읽기
CLM은 대화 기록을 늘어나는 로그가 아니라 에이전트가 고치는 다음 입력으로 다룬다. 긴 작업에서 문맥 관리·스킬 학습·강화학습과 suffix cache 절감이 어떻게 다른지, 정확도·계산량의 분모와 안전성 한계를 함께 살펴본다.
Paper: Rulin Shao; Shannon Zejiang Shen; Junjie Oscar Yin; Yuetai Li; Minheng Wang; Hamish Ivison; Radha Poovendran; Nathan Lambert; Teng Xiao; Mike Lewis; Wen-tau Yih; Luke Zettlemoyer; Pang Wei Koh (2026). Context Language Models. arXiv:2609.37725v1 · PDF. 부록을 포함한 27쪽을 기준으로 읽는다.
이 글은 핵심 발상과 결과를 쉽게 요약한다. 자세한 비용 계산·평가 조건·공개 harness의 경계는 상세 읽기에 정리했다. 수치는 논문 보고와 명시된 재계산을 구분했으며 모델 학습이나 서버 실행을 재현하지 않았다.
오래 일하는 에이전트는 대화 기록과 도구 출력을 계속 쌓는다. 필요한 기록이 길이 제한 밖으로 밀리면, 흔히 외부 프로그램이 요약하거나 오래된 문맥을 지운다. Context Language Models(CLM)의 발상은 그 관리 결정을 모델이 다음 입력 문맥을 직접 편집하도록 맡기는 것이다.
1. 기록이 아니라 다음 입력 상태를 편집한다
일반적인 채팅은 새 내용을 기존 기록 끝에 붙인다. CLM은 현재 대화 문맥을 파일로 보이고 모델이 Bash 같은 일반 코드로 내용을 삭제·치환·재배열하게 한다. 편집 결과가 다음 모델 호출에 들어갈 문맥이 된다. 아무것도 편집하지 않으면 평소처럼 새 출력을 덧붙인다.
예를 들어 웹 검색 결과 전문을 지우고 질의와 검증된 사실만 남기거나, 실험 진행표에 새 줄을 계속 쌓는 대신 최신 상태를 갱신할 수 있다. 논문의 표현을 빌리면 단순히 답을 더하는 것이 아니라 다음 입력이 무엇일지를 행동으로 정한다. 새 신경망 구조를 만든 것과는 다르다. 기존 모델도 이런 실행 규약을 따를 수 있다.
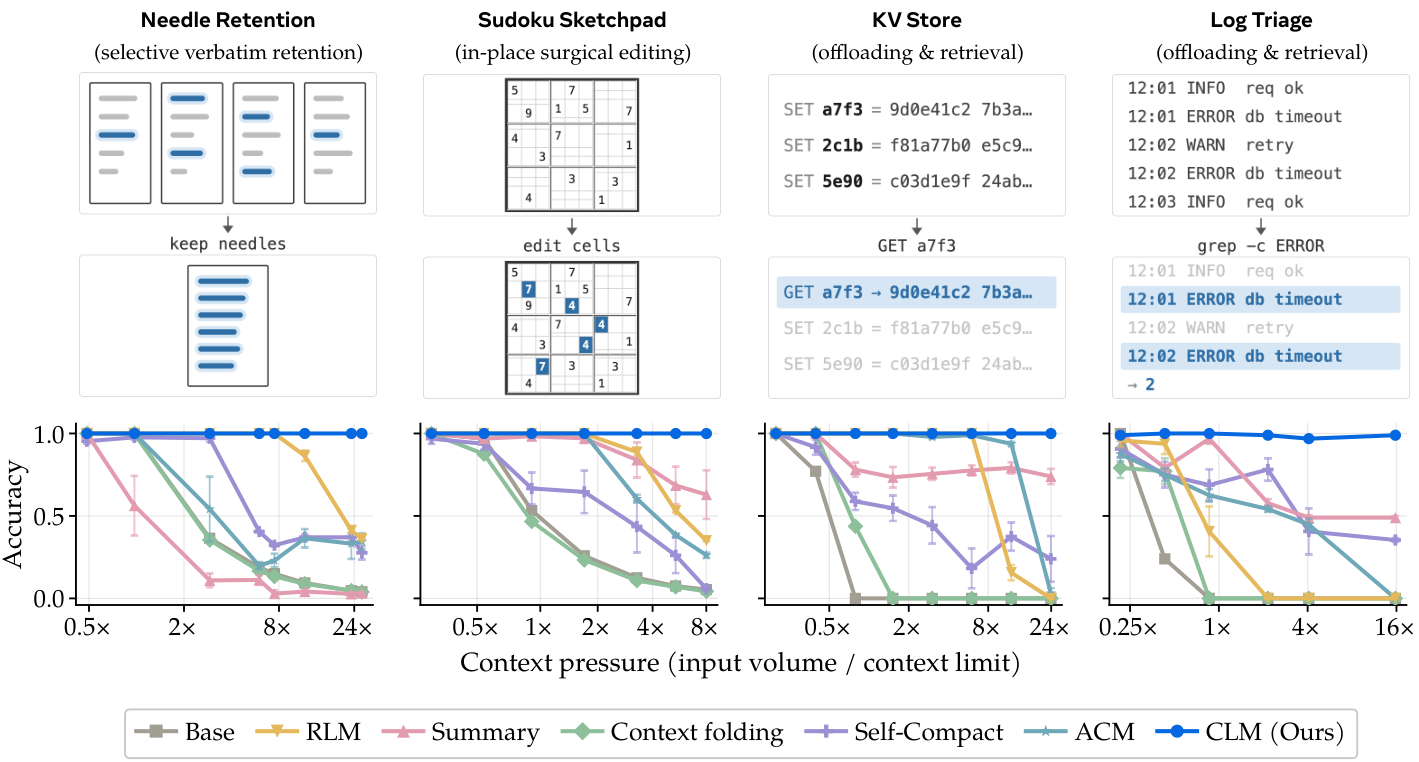
Figure 2. Needle Retention, Sudoku Sketchpad, KV Store, Log Triage에서 입력 스트림이 문맥 한도의 여러 배가 될 때의 정확도를 비교한다. 가로축은 한 번에 넣는 prompt 길이가 아니라 누적 입력량을 32K 제한과 나눈 문맥 압력이다. 그래프 좌표를 임의로 더 정밀하게 읽지는 않는다. 출처: Shao et al. (2026), arXiv v1, p. 4, Figure 2.
이 시험은 정보를 골라 보존하거나 표의 값을 고치는 능력을 분리해 본다. 모든 입력은 먼저 문맥에 들어오며, 답이 외부 파일에만 남고 문맥에 복원되지 않으면 인정하지 않는다. 그래서 문맥 관리 전략을 시험하기에는 유용하지만, 입력 전에 필터링·검색을 하는 실제 시스템과는 조건이 다르다. 또 비교 방법마다 과제 설명과 맞춤형 관리 도구가 주어졌으므로, 무지침 상태의 순수한 영샷 비교도 아니다.
2. 모델의 자유와 실행 하네스는 별개다
문맥 편집 권한은 에이전트에게 모든 제약이 없다는 뜻이 아니다. 논문은 파일 편집을 넓은 행동 공간으로 설명하지만, 검토한 공식 공개 harness 문서는 시스템 지시와 원래 과제를 고정하고, 변경된 대화가 유효한지 확인하는 편집 gate와 예산 초과 시 되돌리기·재시도를 설명한다. 이 공개 구현의 확인을 모든 논문 실험이 같은 설정을 썼다는 증명으로 확대하지 않는다.
여전히 외부 시스템이 파일 동기화, 모델 호출, 도구, 컨텍스트 예산, rollback, 서버 cache와 채점기를 맡는다. CLM은 하네스 자체를 없애기보다, 정해진 요약 도구를 고르는 대신 문맥 관리 정책을 모델의 코드 행동으로 넓힌다. 모델이 원문 기록을 지우거나 편집된 지시문을 남길 때를 어떻게 감사하고 복구할지는 별도의 운영 문제다.
3. 긴 작업에서 좋아진 점과 비용의 분모
학습 없이 비교한 BrowseComp-Plus에서 저자들은 Qwen3.6-27B CLM의 정확도 59.4%, Summary 기준 상대 정확도 +11.4%, prefix-cache FLOPs 21.5% 감소를 보고한다. 여기서 +11.4%는 정확도 점수 차이가 아니라 Summary 대비 상대 증가율이다. 원문 Figure 5에 비교 기준의 정확도·FLOPs 원수치가 인쇄되어 있지 않아 독립 산술로 그 비율을 재현했다고 말할 수는 없다. FLOPs도 시간·API 비용이 아니라 prefix 재사용 조건의 계산량 추정치다.
더 긴 저장소 작업인 32K EdgeBench-10에서 Summary는 42.3점과 trial당 평균 437 PFLOPs, CLM은 44.6점과 179 PFLOPs를 보고했다. 점수는 세 seed 중 최고 결과이고 비용은 평균 trial이라, 둘을 “평균 실행에서 44.6점을 179 PFLOPs로 얻었다”처럼 연결하면 안 된다.
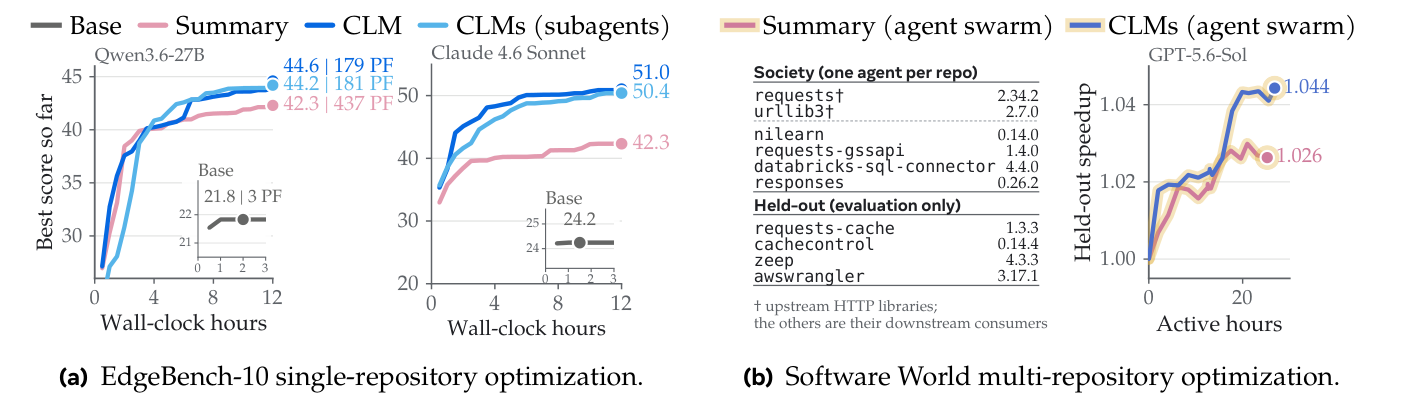
Figure 6. 왼쪽의 EdgeBench-10은 장시간 단일 저장소 최적화, 오른쪽 Software World는 여러 저장소를 에이전트 여섯 개로 개선한 결과다. EdgeBench의 최고 점수와 평균 trial 계산량, Software World의 speedup 지표는 서로 다른 측정이다. 출처: Shao et al. (2026), arXiv v1, p. 8, Figure 6.
Software World에서 보고된 speedup은 Summary swarm 1.026배, CLM swarm 1.044배다. 저자의 “65% 더 큰 개선”은 기준 속도 1.0을 넘는 개선분끼리 비교한 말이지, 전체 실행이 65% 빨라졌다는 뜻이 아니다. 논문은 이 스웜 결과의 비용을 누적 API 지출로 설명하므로, 다른 실험의 PFLOPs와 같은 계산 예산이라고 단정하지 않는다.
4. 스킬 진화와 강화학습은 별도 실험이다
CLM은 모델 가중치를 바꾸지 않고 자연어 지시를 바꿔 편집 행동을 조정할 수 있다. 또 rollout에서 스킬 문서를 만들고 개발 자료에서 고른 뒤, 별도 test로 평가하는 skill evolution을 한다. 예를 들어 assisted evolution의 KV Store test 정확도는 38.3%에서 74.2%로 올랐는데, +35.9 percentage points는 이 task의 held-out 시험 결과이지 네 과제 전체나 무학습 CLM의 공통 향상이 아니다.
이와 별도로 Qwen3.5-9B를 강화학습한 결과가 있다. BrowseComp-Plus 정확도는 CLM 학습 전 28.8%에서 42.5%로 +13.7점, 상대 +47.6%가 됐다. 그러나 학습된 Summary와 비교한 차이는 +0.4점이다. 따라서 “+47.6%”를 학습 전 CLM이 아니라 다른 기준선과 비교하거나, 이를 무학습 결과라고 부르면 틀린다. 이 세 결과—프롬프트로 조정, 텍스트 스킬 진화, 가중치 RL—는 조건이 서로 다르다.
5. Suffix Cache Reuse: 바뀐 앞부분 뒤의 cache를 근사 재사용
문맥 앞쪽을 고치면 표준 prefix cache는 첫 변경점 뒤의 입력을 다시 계산해야 한다. 논문은 수정되지 않은 뒷부분의 KV 상태를 새 위치에 맞춰 옮기는 Suffix Cache Reuse(SCR)를 제안한다. 서버의 한 BCP 조건에서는 정확도 60.2%를 유지하며 질문당 보고 FLOPs가 10.98에서 7.14로, 약 35% 줄었다.
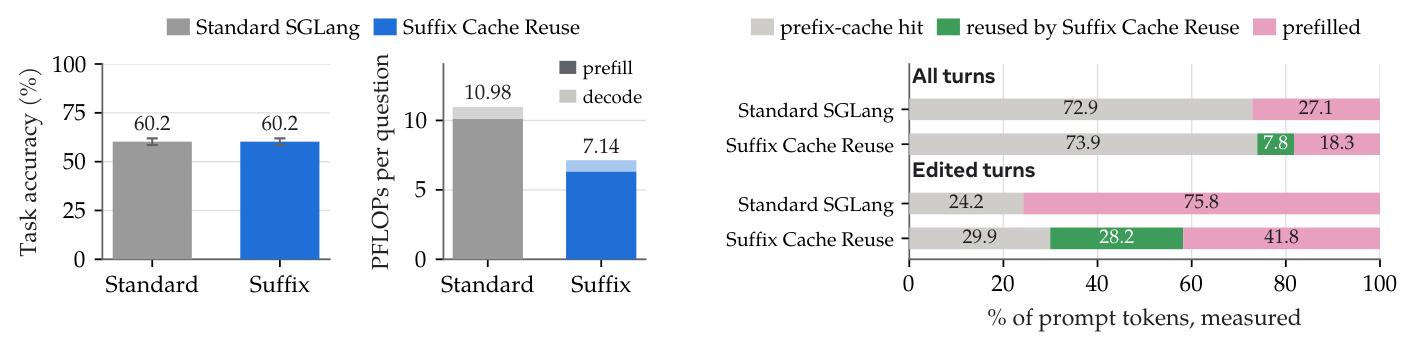
Figure 9. 왼쪽은 특정 BCP 서빙 조건의 정확도, 가운데는 질문당 PFLOPs, 오른쪽은 처리한 prompt token 비율이다. 정확도·계산량·토큰 비율의 분모는 서로 다르다. 출처: Shao et al. (2026), arXiv v1, p. 9, Figure 9.
SCR은 지워진 앞부분의 영향을 반영해 뒷부분 KV를 정확히 다시 계산하지 않는다. 위치를 보정해도 옛 prefix에서 만들어진 stale cache state가 남는 근사다. 따라서 60.2%가 같았다는 한 평가가 일반적 동등성이나 삭제 정보의 완전한 제거를 보증하지 않는다. 논문에서 SCR이 추가로 재사용한 prompt token 7.8%p 중 5.3%p는 추론 토큰 제거에서, 2.5%p는 다른 문맥 편집에서 나왔다. 모든 절감이 CLM의 편집 능력만으로 생긴 것은 아니다.
6. 어디까지 믿고 적용할까
CLM은 긴 작업에서 모델이 무엇을 남길지 직접 관리하게 한다는 유망한 인터페이스다. 하지만 결과는 하나의 조건 없는 능력이 아니라 학습 없는 문맥 비교, skill 문서 선택, 별도 RL, 근사 cache reuse 등 다른 실험 층의 묶음이다. 비용도 PFLOPs 추정치, API 지출, 지연 시간을 구별해야 한다.
안전성은 특히 남은 과제다. 저자들은 편집 가능한 문맥이 악성 입력이나 모델이 만든 지시를 여러 턴에 이어지게 할 수 있다고 지적하며 방어는 future work로 남긴다. 편집 이력과 원문 감사, 권한 경계, 되돌리기, stale cache의 격리는 별도로 다뤄야 한다. 결국 CLM이 보여 주는 것은 “모델에 무제한 문맥 권한을 줘도 된다”가 아니라, 문맥을 편집 가능한 상태로 만들면 정책·비용·안전 경계를 함께 설계해야 한다는 점이다.
같이 읽기: EvoOntology · SkillOpt
References
Shao, R., Shen, S. Z., Yin, J. O., Li, Y., Wang, M., Ivison, H., Poovendran, R., Lambert, N., Xiao, T., Lewis, M., Yih, W.-t., Zettlemoyer, L., & Koh, P. W. (2026). Context language models [Preprint]. arXiv. https://arxiv.org/abs/2609.37725v1