SkillOpt: Executive Strategy for Self-Evolving Agent Skills
SkillOpt는 모델 가중치를 고정하고 외부 스킬 문서를 검증 점수로 갱신한다. 두 단계의 채택 관문과 기각 기록이 작동하려면 자동 평가 가능한 과제가 필요하다.
Paper: Yifan Yang; Ziyang Gong; Weiquan Huang; Qihao Yang; Ziwei Zhou; Zisu Huang; Yan Li; Xuemei Gao; Qi Dai; Bei Liu; Kai Qiu; Yuqing Yang; Dongdong Chen; Xue Yang; Chong Luo (2026). "SkillOpt: Executive Strategy for Self-Evolving Agent Skills". PDF · arXiv:2605.23904v2
에이전트가 스프레드시트·문서·검색 과제를 반복해서 틀린다면, 모델 가중치를 다시 학습하지 않고도 바꿀 것이 있다. “파일 구조를 먼저 검사하라”, “날짜·단위를 확인하라” 같은 스킬 문서다. SkillOpt는 이 문서를 텍스트 공간의 학습 변수로 보고, rollout에서 실패와 성공을 모은 뒤 작은 편집 후보를 만든다. 단, 후보는 held-out selection split에서 현재 스킬보다 엄격히 더 좋아야 채택한다. 논문은 선택 관문과 기각 편집 기록을 중심 장치로 둔다.
1. 왜 스킬을 그냥 다시 쓰지 않나
LLM에게 “더 나은 지침을 써라”라고 한 번 요청하면 문장이 길어지거나, 한 실패를 막으려다 기존의 좋은 규칙을 지우거나, 훈련 예제에만 맞는 요령을 배울 수 있다. SkillOpt는 이를 딥러닝의 학습률·validation·momentum에 비유해 통제한다. 이 비유는 수렴 정리가 아니다. 자연어 편집에는 미분 가능한 gradient가 없으므로, 논문은 경험적 rollout과 verifier score를 이용하는 시스템을 제안한다.
대상 모델은 동결된다. 학습되는 것은 외부 skill.md이며, 배포 때는 선택된 best_skill.md를 모델에 주입한다. 그래서 배포 추론 중에 별도의 최적화 호출이 필요 없다는 장점이 있지만, 좋은 문서를 얻기 위한 학습 단계에는 많은 rollout과 optimizer 호출이 든다.
2. 한 번의 갱신은 어떻게 진행되나
데이터를 D_tr(편집 아이디어 생성), D_sel(채택 판단), D_test(마지막 평가)로 나눈다. 현재 스킬로 D_tr의 작은 묶음을 실행해 trajectory와 verifier 점수를 모은다. optimizer는 실패와 성공을 함께 읽어 “무엇을 add/delete/replace할지”라는 textual update를 제안한다. edit budget L_t가 한 번에 바꿀 범위를 제한한다.
후보 스킬은 D_sel에서 현재 점수보다 높을 때만 채택한다. 동점도 기각한다. 기각된 편집과 점수 하락 이유는 reject buffer에 남겨 다음 제안이 같은 실수를 반복하지 않게 한다. epoch 끝에는 여러 step의 증거를 요약하는 slow/meta update 후보가 있다. 이 후보도 같은 selection split에서 현재 스킬보다 점수가 엄격히 높아야 채택된다. 논문 기본값인 cosine schedule은 초기에 큰 편집을 허용하고 뒤로 갈수록 작은 편집으로 줄인다.
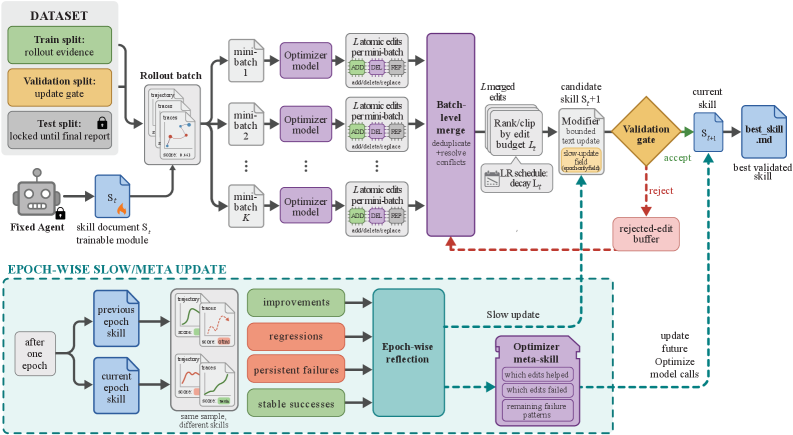
그림 1. Yang et al. (2026), Figure 2, PDF p. 4의 원도판. train rollout→반성→bounded edit→selection gate→reject buffer→best skill의 폐루프를 보인다. 그림의 validation gate는 test 성능을 직접 보는 장치가 아니라 후보 채택용 held-out 분할이다.
3. 스프레드시트 예로 보기
스프레드시트 agent가 수식이 든 workbook을 바꿀 때를 보자. 원문 Figure 4(PDF p. 15)의 대표적인 배포 규칙은 workbook 구조와 수식을 검사하고, 대상 범위에 검증기가 기대하는 계산된 static value를 쓰도록 한다. 이는 SpreadsheetBench의 대상 범위와 채점 방식에 맞춘 결과다. 이런 편집 후보도 D_sel에서 현재 스킬보다 높은 점수를 받아야 남는다.
이 사례에는 강점과 한계가 함께 있다. 규칙은 SpreadsheetBench에 매우 구체적이라 유용하지만, 일반 workbook에서 수식을 값으로 바꾸라는 권고는 아니다. 다른 작업이나 검증기에는 그대로 옮기면 맞지 않을 수 있다. SkillOpt가 보편 지능을 만든 것이 아니라, 검증 가능한 과제 분포에서 외부 행동 지침을 찾아낸 것이다.
4. 원문 결과는 무엇을 조건으로 하나
Table 1은 SearchQA, SpreadsheetBench, OfficeQA, DocVQA, LiveMathematicianBench, ALFWorld의 disjoint held-out test split 점수를 백분율로 보고한다. GPT-5.5 direct-chat 조건의 여섯 벤치마크 평균은 no skill 58.8에서 SkillOpt 82.3으로 올랐고, 각 벤치마크 셀에서 경쟁 방법 여섯 가지 중 최고를 고르는 oracle baseline 76.9보다 5.4%포인트 높다. 이 oracle은 같은 최적화 비용을 쓴 단일 방법과의 비교가 아니다. 큰 폭의 개선은 SpreadsheetBench 41.8→80.7, OfficeQA 33.1→72.1 등 strict procedural benchmark에서 나타난다.
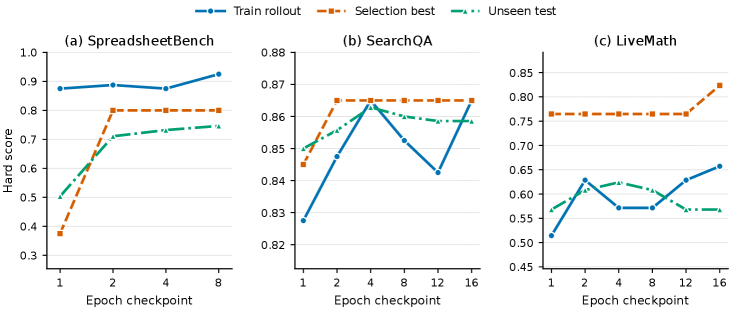
그림 2. Yang et al. (2026), Figure 3, PDF p. 12의 원도판. SpreadsheetBench·SearchQA·LiveMath에서 train rollout, selection-best, unseen test 점수의 epoch 경향을 보인다. 선택 점수가 test 경향을 따라간 사례이며, 모든 새 과제에서 gate가 일반화를 보장한다는 증명은 아니다.
Table 3의 matched ablation에서는 reject buffer를 빼면 SearchQA·SpreadsheetBench·LiveMath가 각각 1.6, 4.6, 2.4점 낮아지고, slow/meta를 빼면 SpreadsheetBench는 77.5에서 55.0으로 낮아진다고 보고한다. 이 숫자는 GPT-5.5/student·GPT-5.5/teacher와 논문의 default configuration에서의 component 실험이다. 다른 optimizer, verifier, split 크기에도 같은 차이가 난다는 주장은 아니다.
5. 실제 도입 전에 확인할 조건
신뢰할 수 있는 자동 verifier가 가장 먼저 필요하다. selection gate가 점수 하나를 비교하므로, 보상이 애매하거나 쉽게 게임될 수 있으면 스킬은 사람에게 좋아 보이는 행동보다 verifier를 통과하는 행동으로 갈 수 있다. 논문 Limitations도 scored trajectory와 held-out selection split에 의존하므로 자동 검증 과제에 가장 직접적으로 맞는다고 적는다.
훈련 비용도 따로 봐야 한다. Table 6의 최종 스킬은 379–1,995 tokens(중앙값 약 920)로 작지만, 여섯 GPT-5.5/student–teacher 실행은 벤치마크별 총 20.8M–213.8M training tokens를 사용했다. 0.6M–3.6M은 그중 세 절차형 과제에서 시험 점수 1%포인트당 학습 토큰 수를 계산한 범위다. 전체 과제의 비용/점수 범위는 0.6M–46.4M이다. 결과 스킬의 길이와 rollout·optimizer 호출을 포함한 탐색 비용을 구분해야 한다. 또 selection split을 반복해서 쓰면 그 분할에도 과적합할 수 있으므로, 논문의 D_test처럼 최종 평가는 분리해야 한다.
6. 결론
SkillOpt는 편집을 검증으로 통과시킨다는 아이디어를 중심에 둔다. “스킬을 진화시킨다”는 표현보다 구체적이다. bounded edit, strict held-out gate, reject buffer, slow/meta update는 텍스트 편집의 드리프트를 줄이려는 설계다. 다만 이는 이론적 최적성 보증이 아니며, 좋은 verifier·대표성 있는 split·감당 가능한 rollout 비용이 있을 때의 경험적 방법으로 읽어야 한다.
더 긴 알고리즘·전이 실험·비용 표는 심화 보기에서 확인할 수 있다.
References
Yang, Y., Gong, Z., Huang, W., Yang, Q., Zhou, Z., Huang, Z., Li, Y., Gao, X., Dai, Q., Liu, B., Qiu, K., Yang, Y., Chen, D., Yang, X., & Luo, C. (2026). SkillOpt: Executive strategy for self-evolving agent skills (arXiv:2605.23904v2). arXiv. https://arxiv.org/abs/2605.23904v2