Context Language Models
CLM은 대화 기록을 늘어나는 로그가 아니라 에이전트가 고치는 다음 입력으로 다룬다. 긴 작업에서 문맥 관리·스킬 학습·강화학습과 suffix cache 절감이 어떻게 다른지, 정확도·계산량의 분모와 안전성 한계를 함께 살펴본다.
Paper: Rulin Shao; Shannon Zejiang Shen; Junjie Oscar Yin; Yuetai Li; Minheng Wang; Hamish Ivison; Radha Poovendran; Nathan Lambert; Teng Xiao; Mike Lewis; Wen-tau Yih; Luke Zettlemoyer; Pang Wei Koh (2026). Context Language Models. University of Washington·Meta Superintelligence Labs·MIT·Trillium Labs. arXiv:2609.37725v1. PDF · 서지 정보 · 공식 코드. 부록 포함 27쪽을 읽는다. arXiv v1 표기는 2026-09-29, 논문 안 Date는 September 30, 2026이다.
Abstract: 에이전트가 오래 일할수록 대화 기록은 커지지만, 중요한 정보가 기록의 끝에만 있는 것은 아니다. Context Language Models(CLMs)는 실시간 문맥을 파일로 노출하고 모델이 일반 코드를 통해 삭제·치환·재배열하게 한다. 별도 학습 없이도 여러 긴 작업에서 좋은 성능–계산량 교환이 나타나며, 편집 전략을 자연어 스킬이나 강화학습으로 개선할 수 있다. 이 논문은 문맥 편집이 prefix cache를 깨뜨리는 비용까지 계산하고, 남은 suffix의 오래된 상태를 재사용하는 근사 서빙도 제안한다. 다만 ‘모델 고유 능력’은 harness가 사라졌다는 뜻이 아니며, 스웜의 65%는 전체 실행 속도 65% 증가가 아니다. 실험 예산·평가자·학습 전후의 조건과 공개 구현의 경계를 구분해 읽어야 한다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 핵심 발상 | 다음 입력 문맥을 append-only 기록이 아니라 모델이 편집하는 상태로 취급한다. |
| 실제 구현 | 문맥 파일을 Bash로 수정하면 다음 호출에 반영한다. 공개 harness는 시스템·원래 과제를 고정하고 파싱·편집 gate·예산 회복을 담당한다. |
| 학습 없는 결과 | Qwen3.6-27B의 BrowseComp-Plus 정확도 59.4%, Summary 대비 상대 +11.4%와 계산량 −21.5%를 저자가 보고한다. |
| 긴 작업 | 32K EdgeBench-10에서 42.3→44.6, 평균 trial 비용 437→179 PFLOPs. 최고점은 세 seed 중 best-of-three다. |
| 스킬 학습 | KV Store의 별도 test 정확도 38.3→74.2, +35.9점. 개발 집합의 개선과 구분한다. |
| RL | Qwen3.5-9B는 28.8→42.5%, +13.7점·상대 +47.6%. 학습된 Summary와의 차이는 +0.4점이다. |
| 서빙 | SCR은 60.2% 정확도를 유지한 보고 실행에서 10.98→7.14 PFLOPs, 약 35% 감소. 오래된 cache state를 쓰므로 정확한 재계산과 동치는 아니다. |
| 주요 경계 | FLOPs와 지연·API 비용은 다르다. 편집 횟수 제한·rollback·예산·평가자 차이가 있고, 안전성·삭제 정보의 잔존 문제는 열려 있다. |
읽기 안내: 성능은 저자 보고이며 차이·비율과 비용식은 리뷰에서 재계산했다. 모델 실험·RL·서버를 실행하지 않았다. 논문과 공개 구현 문서의 증거도 구분한다. 아래 ‘점’은 정확도·평가점수의 절대 차이이고 상대 증가는 별도로 표시한다.
목차
- 문맥을 늘리는 대신 다음 문맥을 만든다
- 자유로운 편집과 실제 harness의 경계
- ContextBench는 무엇을 분리해 측정하는가
- 짧아진 문맥이 항상 싼 것은 아니다
- 학습 없이 얻은 성능과 긴 작업의 분모
- 문장으로 지시하고 스킬 문서를 진화시킨다
- 성공한 궤적 안에서 효율을 학습한다
- Suffix Cache Reuse는 무엇을 보존하고 생략하는가
- 공정한 비교와 안전한 운영에 남는 질문
- 문맥 관리 권한을 모델에 준다는 것
1. 문맥을 늘리는 대신 다음 문맥을 만든다
일반적인 에이전트는 사용자 입력, 모델 응답, 도구 결과를 기록 끝에 붙인다. 모델이 긴 검색 결과를 파일에 보관하더라도 이미 들어온 도구 출력이 live context에서 자동으로 사라지지는 않는다. 그래서 길이가 차면 외부 harness가 요약하거나, 모델이 정해진 압축 도구를 호출한다.
CLM은 다음 상태를 정의하는 관점을 바꾼다.
\text{일반 LM: }c_{t+1}=c_t\oplus f^{\mathrm{LM}}_\theta(c_t),\qquad
\text{CLM: }c_{t+1}=f^{\mathrm{CLM}}_\theta(c_t).
이 식은 Transformer를 다른 신경망으로 바꿨다는 뜻이 아니다. 모델이 코드로 문맥 파일을 고치고, 그 결과를 다음 모델 호출의 입력으로 사용하는 상태 전이의 권한을 바꾼다. 고치지 않으면 기존처럼 새 출력을 덧붙인다.
예를 들어 검색 결과 본문은 지우고 질의·문서 ID·검증한 사실만 남길 수 있다. 진행 중인 실험의 최고 점수나 하위 에이전트 상태는 기록을 계속 추가하는 대신 같은 표의 셀을 갱신할 수 있다. Figure 3에는 상태판, 내부 notes 표식, 오래된 검색 결과를 치우는 반복문, 37번 재사용한 압축 함수 등의 관찰 사례가 나온다. 이는 사례이지 모든 실행이 이런 전략을 안정적으로 찾아낸다는 보장은 아니다.
RLM·외부 메모리와의 차이
RLM은 긴 입력을 REPL 변수로 두고 필요한 부분을 읽는다. CLM은 이미 들어온 상호작용 기록 자체를 바꾼다. 외부 메모리는 나중에 꺼내 쓸 정보를 저장하는 공간이고, live context 파일은 바로 다음 호출이 보는 입력을 정한다. 둘은 대체재라기보다 함께 사용할 수 있는 장치다.
Declarative Attention처럼 입력 정보의 이용 방식을 바꾸는 문제와 연결되지만, 여기서는 주의 함수가 아니라 입력 상태를 구성하는 에이전트의 행동이 중심이다.
2. 자유로운 편집과 실제 harness의 경계
2.1 문맥 파일이 곧 운영체제의 무제한 권한은 아니다
논문은 Bash로 문맥 파일을 임의 수정할 수 있다고 설명한다. 이를 ‘시스템 지침·원래 과제도 마음대로 지운다’거나 ‘harness가 완전히 없다’고 읽으면 공개 구현과 어긋난다.
별도 구현 근거: 공식 저장소의 고정 revision harness 문서를 확인했다. 이 문서는 다음을 명시한다.
- 시스템 프롬프트와 원래 과제 이후의 대화를
[[CTX_TURN ...]]블록으로 파일에 비춘다. - 수정 결과를 유효한 메시지 목록으로 파싱하되 시스템·원래 과제는 고정한다.
- 편집 gate가 수락 여부를 결정한다.
fit은 예산 안에 들어가는 수정,shrink는 문맥을 줄이는 수정을 허용한다. - 토큰 예산 알림, 초과 시 rollback·재시도, 종료 정책과 호출 수 제한은 harness에 남는다.
같은 revision의 context_env/edit_gate.py도 fit/shrink 설정 선택을 보여 준다. 다만 이것은 공개 시점의 코드·문서 확인이며 모든 논문 실험에서 같은 설정을 사용했음을 재현한 것은 아니다.
따라서 핵심은 관리 전략을 미리 정한 도구 목록에서 일반 코드로 넓힌 것이지 모든 제약과 기반 시설을 제거한 것이 아니다. 모델이 파일에서 만든 notes 표식 역시 새로운 권한 계층을 발명했다는 뜻으로 확대하지 않는다.
2.2 여러 문맥 파일은 여러 에이전트의 상태가 된다
각 에이전트의 live context 파일을 따로 두면 여러 상태가 공존한다. 파일의 생성·삭제와 해당 실행을 연동해 하위 에이전트를 관리할 수 있다는 것이 논문의 확장이다. 하지만 에이전트 생성·수명·서버 호출·동시 편집의 운영을 실제로 연결하는 실행 환경은 필요하다.
Self-Organizing Agent Teams의 팀 전략 학습과도 구분된다. CLM의 다중 에이전트 결과는 주로 문맥을 각자 갱신하는 장시간 협업 환경이며, 협업 전략 bank를 과거 데이터에서 학습해 동결하는 같은 실험이 아니다.
3. ContextBench는 무엇을 분리해 측정하는가
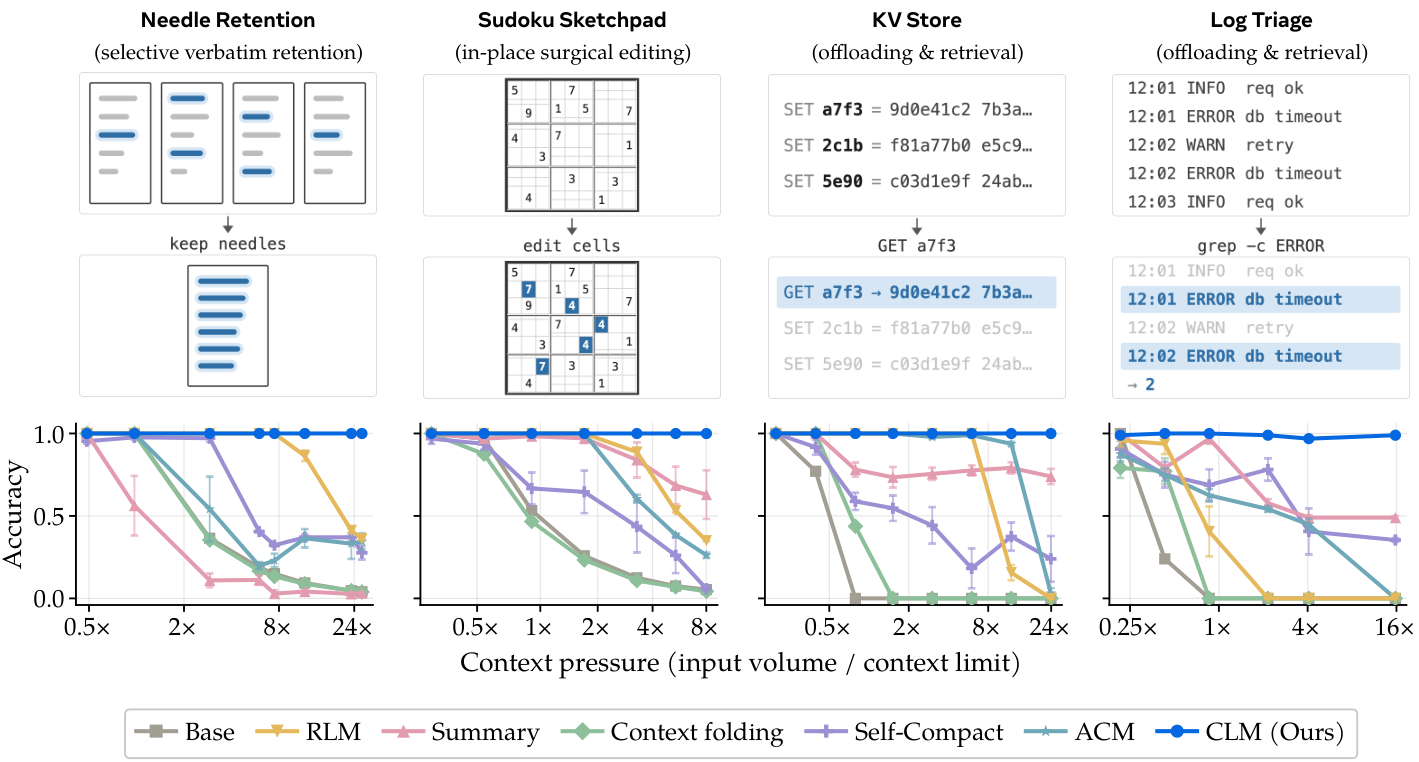
Figure 2. GPT-5.4, 32K 문맥 제한에서 입력량/문맥 제한의 비율을 높인다. 곡선의 정확한 좌표를 임의로 수치화하지 않는다. 출처: Shao et al. (2026), v1, p. 4, Fig. 2 — 연구·학습 목적 인용.
| 과제 | 필요한 행동 | 채점 대상 |
|---|---|---|
| Needle Retention | 방해 문장을 버리고 지정 문장을 그대로 남김 | 최종 문맥의 원문 보존 |
| Sudoku Sketchpad | 16×16 보드의 지정 칸과 버전을 갱신 | 각 보드 상태의 정확한 재현 |
| KV Store | 대량의 SET 값을 내보내고 GET 때 복구 | 정확한 값 |
| Log Triage | 로그를 저장·조회하고 조건별 개수를 셈 | 정확한 응답 |
Tables 3–4, pp. 19–21. Sudoku를 푸는 추론 문제가 아니라 제공된 이동을 반영하는 상태 관리 과제다.
문맥 압력은 에피소드 동안 들어온 입력 토큰 합을 32,768로 나눈 값이다. 24배 압력이라고 모델이 한 번에 24배 긴 입력을 읽는다는 뜻은 아니다. 스트림을 받으며 필요한 상태만 유지해야 한다.
부록은 응답용 2,048토큰을 남기고, 한 번의 입력 및 유지해야 할 정보가 가용 예산에 들어가도록 생성기를 제한한다. 모든 입력은 먼저 문맥에 들어오며 harness가 도착 전에 잘라 내거나 외부로 보내지 못한다. 답이 파일에만 있고 문맥에 복원되지 않으면 점수를 받지 못한다.
이 통제는 문맥 관리를 직접 시험하는 데 유용하지만 현실 전체를 대표하지 않는다. 실제 시스템은 입력 전 필터링·분할·검색을 할 수 있고, 그러한 설계의 이득을 이 과제는 의도적으로 제외한다. 원문 자체를 보존·수정하는 채점은 live-context 편집과 특히 잘 맞는다.
또한 Figure 2는 무지침 상태의 순수 zero-shot 진단이 아니다. 모든 방법에 과제 설명과 각자의 도구에 맞는 상세 관리 스킬을 준다. 네 seed, 일부 수준은 여덟 seed를 썼다. 이후 스킬 진화의 ‘아무 관리 지침 없이 시작’하는 초기점과 같은 조건으로 합치면 안 된다.
4. 짧아진 문맥이 항상 싼 것은 아니다
4.1 앞부분을 바꾸면 남은 뒷부분도 다시 계산한다
표준 prefix cache는 일치하는 앞부분의 KV 상태만 재사용한다. 앞쪽 검색 결과를 지우면 그 뒤의 글자가 같아도 이전 prefix에 의존해 계산한 상태를 그대로 쓸 수 없으므로 다시 prefill한다.
논문의 기본 비용 지표는 이를 포함한다.
F_{\mathrm{prefix\ reuse}}=F_{\mathrm{prefill\ of\ unmatched\ suffix}}+F_{\mathrm{decode}}.매 turn의 입력 길이를 P, 출력 길이를 G, 재사용한 prefix를 R이라고 쓰면 부록의 근사식은 다음과 같다.
F_t=C_{\mathrm{token}}(P-R+G)+C_{\mathrm{attn}}
\left[\frac{P^2-R^2}{2}+GP+\frac{G^2}{2}\right].
Qwen3.6-27B의 보고 상수는 C_{\mathrm{token}}\approx48.70\times10^9, C_{\mathrm{attn}}\approx3.93\times10^5다. P=20,000, G=500이라는 설명용 설정에서 R=18,000/10,000/0이면 비용은 약 1.41/5.74/10.81\times10^{14} FLOPs다. 맨 앞 편집은 append-only 예시의 약 7.7배가 된다. 이 값은 실제 평가 실행의 평균이 아니다.
4.2 FLOPs·토큰 수·응답 시간은 다른 지표다
이 모델은 MLP·projection·full attention 연산을 계산하지만 embedding/output layer, 선형 attention의 recurrent-state update, normalization·activation·softmax 등을 생략한다. API 가격·네트워크·도구 실행 시간·메모리 병목까지 포함한 벽시계 지연도 아니다.
따라서 기본 CLM 결과의 ‘계산량 감소’와 SCR의 별도 서버 계측, Software World의 누적 API 비용을 하나의 FLOPs 표로 합치면 안 된다. 모델이 작은 문맥을 유지해도 앞부분을 자주 고치면 계산 비용이 커질 수 있으며, 이것이 삭제 토큰 수 대신 prefix-reuse 비용을 학습 신호로 쓰는 이유다.
5. 학습 없이 얻은 성능과 긴 작업의 분모
5.1 검색·터미널 작업
Qwen3.6-27B의 BrowseComp-Plus(BCP)는 830문항에서 정확도 59.4%다. 저자는 Summary 대비 상대 +11.4%, prefix-reuse FLOPs −21.5%를 보고한다. 11.4 점 상승이 아니며, 그래프의 좌표에서 기준선 수치를 임의로 정확한 값처럼 복원하지 않는다.
TerminalBench 2.1에서는 가장 강한 Summary와 같은 정확도에 약 29.5% 적은 비용을 보고한다. TBLite는 67.0→73.7%, +6.7점에 Summary 비용의 약 91%다. 모든 과제에서 더 정확하다는 결과가 아니라, 일부는 정확도 유지와 비용 감소다.
이 비교는 학습된 기존 방법의 논문 최고 점수를 그대로 가져온 것이 아니다. 공통 base model에서 학습 없이 harness·관리 행동을 비교한다. RL로 학습한 MEM1 등 원래 방법의 모든 잠재력을 포함한 순위라고 해석하지 않는다.
5.2 수학 최적화: 좋은 best-of-run, 반복 통계는 아니다
| 방법 | 원 채우기 ↑ | Heilbronn ↑ | Min/max 거리 지표 ↑ | Erdős 겹침 ↓ |
|---|---|---|---|---|
| OpenEvolve | 2.541 | 0.03127 | 0.07690 | 0.38123 |
| OpenEvolve-Agent | 2.525 | 0.03053 | 0.07724 | 0.38167 |
| CLM | 2.618 | 0.03653 | 0.07758 | 0.38094 |
| CLM + subagents | 2.636 | 0.03617 | 0.07758 | 0.38109 |
Table 1, p. 7. Claude 4.6 Sonnet, 32K, 100번 채점 또는 5시간, 방법당 한 실행의 최고점이다.
CLM 단독의 OpenEvolve 대비 원 채우기 상대 개선은 약 3.03%, Heilbronn은 약 16.82%다. 네 문제 모두 좋은 최종 점수가 관찰됐지만, 한 실행으로 반복 안정성·유의성을 주장할 수 없다. 같은 채점 횟수·시간 제한이지 같은 생성 토큰이나 FLOPs로 맞춘 비교도 아니다. 하위 에이전트가 모든 문제를 더 좋게 만드는 것도 아니다.
5.3 EdgeBench: 최고점과 평균 비용을 구분한다
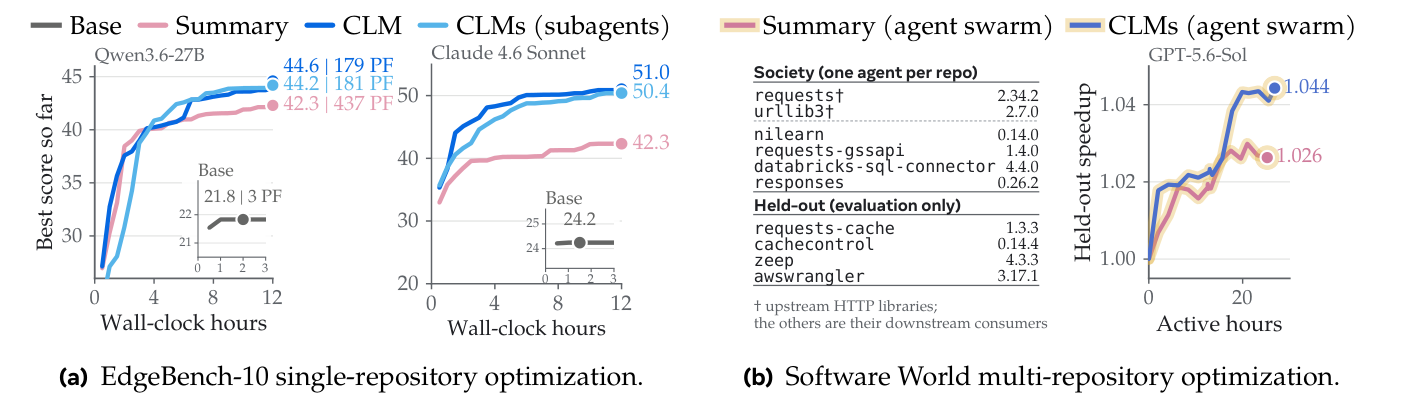
Figure 6. 왼쪽은 12시간 EdgeBench-10, 오른쪽은 여섯 저장소를 공동 개선하는 Software World다. EdgeBench는 best-of-three 점수와 평균 trial FLOPs를, Software World는 보지 못한 다운스트림의 기하평균 speedup을 제시한다. 출처: Shao et al. (2026), v1, p. 8, Fig. 6 — 연구·학습 목적 인용.
| Qwen3.6-27B·32K | 점수 | 평균 PFLOPs/trial |
|---|---|---|
| Summary | 42.3 | 437 |
| CLM | 44.6 | 179 |
| CLM + subagents | 44.2 | 181 |
44.6−42.3=2.3점, 상대 약 5.44%이고 계산량은 약 59.04% 줄었다. 헤드라인 ‘5% 높고 59% 저렴’은 이 조건이다. 점수는 과제별 세 seed에서 고른 최고점이고 비용은 평균 trial이므로 ‘평균 실행에서 44.6을 얻는 데 179PF가 든다’고 바꾸면 안 된다. 평가도 전체 48개 runnable 과제가 아닌 10개 subset이다.
128K에서는 결과가 달라진다. Summary 47.8/222PF, CLM 47.3/142PF, subagent CLM 50.2/219PF다(Figure 19). 단독 CLM은 더 싸지만 점수가 0.5 낮고, 하위 에이전트가 가장 높은 점수를 낸다. 32K에서 subagent 추가 이득이 작았다는 결론을 모든 예산으로 일반화하지 않는다.
5.4 스웜의 65%는 전체 속도 65%가 아니다
Software World는 여섯 에이전트가 연결된 저장소를 개선하고, 직접 보지 못한 네 다운스트림 패키지의 17개 CPU benchmark로 평가한다. 지표는 실행 명령 수 기준 speedup의 기하평균이며 고장 난 benchmark는 1.0으로 처리한다. 측정된 벽시계 서비스 지연과는 다르다.
Figure 6의 끝점은 Summary 1.026배, CLM 1.044배다. 개선분은 기준 1에서 각각 약 0.026·0.044이며 논문은 이 개선분이 65% 더 크다고 보고한다. 표시된 세 자리 값으로 계산하면 약 69.2%지만, 작은 개선분의 반올림 오차에 민감하므로 이를 확정적 산술 오류라고 단정하지 않는다. 전체 speedup 비율끼리 비교하면 1.044/1.026-1\approx1.75%다.
비용 통제도 부록에서는 누적 API 지출 USD로 설명한다. 이를 정확히 같은 FLOPs에서 얻은 결과로 바꾸지 않는다. 원래 저장소와 분리된 다운스트림 평가라는 장점은 분명하지만 반복 수·변동성의 근거는 제한적이다.
6. 문장으로 지시하고 스킬 문서를 진화시킨다
6.1 지시를 따르는 능력은 관찰되지만 완벽하지 않다
Claude 4.6 Sonnet에게 16K·24K·32K에서 압축하라고 하면 최초 압축 시점의 중앙값은 약 16.0K·23.6K·30.9K가 된다. 하위 질문 경계에서 압축하라는 지시는 2턴 이내 압축률을 0.40→0.88로 높인다. 편집 전에 백업하라는 지시는 full backup 비율 0→0.68, partial backup 약 0.09를 만든다(Figure 7).
문장 하나로 행동이 바뀌지만 백업 준수율은 100%가 아니다. 안전상 반드시 필요한 백업을 자연어 요청만으로 강제한다고 보기 어렵다. 이 조향 실험은 예산 reminder가 없는 별도 조건이며, 길이 지시에는 도구 결과의 현재 크기 정보가 언급된다. 외부 신호 없이 모델이 정확히 토큰을 셌다는 시험도 아니다.
6.2 스킬 진화는 개발 집합으로 선택하고 test에서 확인한다
모델 가중치는 고정하고 관리 지침 문서 s를 개선한다. 학습 rollout을 읽은 proposer가 후보 스킬을 만들고, 개발 집합에서 정확도·비용으로 Pareto 후보를 골라 다음 라운드로 넘긴다.
- Assisted evolution: Qwen3.6-27B 실행자, Claude Fable 5.1 proposer.
- Self-evolution: Opus 5가 실행자와 proposer를 겸한다.
이름이 self라고 외부 실험 환경·채점·선택 규칙까지 사라지는 것은 아니다. SkillOpt처럼 학습되는 상태가 텍스트 문서라는 점에서, 뒤의 RL 가중치 업데이트와 다르다. CLM이 SkillOpt 알고리즘을 사용했다는 뜻은 아니다.
Assisted KV Store의 개발 정확도는 22.3→83.8이지만, 별도 test는 38.3→74.2, +35.9점이다. Log Triage의 개발 0→100을 test 성과로 대신 쓰면 안 된다. 부록은 archive를 동결한 뒤 assisted test 102개 인스턴스를 세 seed로 한 번 평가했다고 설명한다.
비용 그래프의 모집단도 주의해야 한다. 부록 E는 예산 안에 끝난 실행의 비용이라고, Figure 20 캡션은 solved runs의 비용이라고 표현한다. 성공률과 함께 보아야 하며 모든 시도·스킬 탐색 비용까지 포함한 평균이라고 해석하지 않는다.
7. 성공한 궤적 안에서 효율을 학습한다
7.1 편집 전 입력을 보존해야 정책 경사를 계산할 수 있다
에이전트가 과거 문맥을 지우면 마지막 문맥에는 이전 행동을 생성할 때의 입력이 남아 있지 않다. 따라서 각 호출의 원래 입력·출력 segment를 보존하고, 완성된 궤적의 결과 advantage를 각 segment에 적용한다. 문맥 편집 자체를 미분해 gradient를 통과시키는 것이 아니다.
7.2 실패한 궤적은 효율 보너스를 받지 않는다
같은 질의의 성공 rollout 집합을 \mathcal G^+, 성공 궤적 평균 비용을 \bar c라고 하면 다음 보정항을 쓴다.
A_i^{\mathrm{eff}}=
\begin{cases}
\mathrm{clip}((\bar c-c_i)/\bar c,-1,1),&i\in\mathcal G^+,\\
0,&\text{그 외}.
\end{cases}
성공이 둘 미만이면 모두 0이다. 성공한 두 궤적 비용이 1과 3이라면 평균 2를 기준으로 +0.5와 −0.5다. 실패 비용이 0.1이어도 이 보너스는 0이다. 이는 설명용 계산이며 관측 데이터가 아니다.
최종 advantage는 결과 항에 효율 항을 더한다. 부록 구현은 가중치 0.25를 context-management 토큰에 적용하고 실패 도구 호출·잘못된 출력의 패널티도 둔다. 쓸데없이 편집을 많이 하거나 무조건 삭제하도록 보상하지 않는 설계다. 다만 task judge가 잘못 성공 판정을 하면 그 안에서 비용을 최적화하므로 의미적 정확성 자체를 보장하지는 않는다.
7.3 큰 향상은 학습 전 CLM 대비다
| Qwen3.5-9B | 정확도 전→후 | PFLOPs/문항 전→후 |
|---|---|---|
| Summary | 34.7→42.1 | 4.01→2.19 |
| CLM | 28.8→42.5 | 1.52→1.34 |
Table 2, p. 9. OpenResearcher에서 학습하고 BCP에서 평가한다.
CLM은 +13.7점, 상대 +47.57%이며 비용은 약 11.84% 낮아진다. 그러나 학습된 Summary와 비교하면 정확도 차이는 +0.4점, 비용은 약 38.81% 적다. ‘47.6% 더 잘한다’의 분모를 다른 모델이나 학습된 기준선으로 바꾸면 안 된다.
훈련은 3,040개 프롬프트, step당 8개 질의×32 rollout, 70 step이며 policy 16개·rollout 48개의 H200을 사용한다. 최고 checkpoint는 별도 500개 OpenResearcher validation에서 고른다. 따라서 test 최고점을 직접 고른 설정으로 비판하는 것은 부정확하다.
반면 ‘같은 recipe’라는 본문 표현에는 세부 차이가 있다. 부록의 CLM은 28K·80턴(편집 제외), Summary는 28,672에서 압축·100턴이며 Table 2의 Summary는 task reward만, CLM은 효율 항·패널티를 추가한다. Figure 21에는 두 방식의 효율 보상 유무 절제도 제시된다. 주 표의 차이를 오직 파일 편집 하나의 인과 효과로 배정하지 않는다.
8. Suffix Cache Reuse는 무엇을 보존하고 생략하는가
8.1 같은 텍스트라도 올바른 KV 상태는 달라질 수 있다
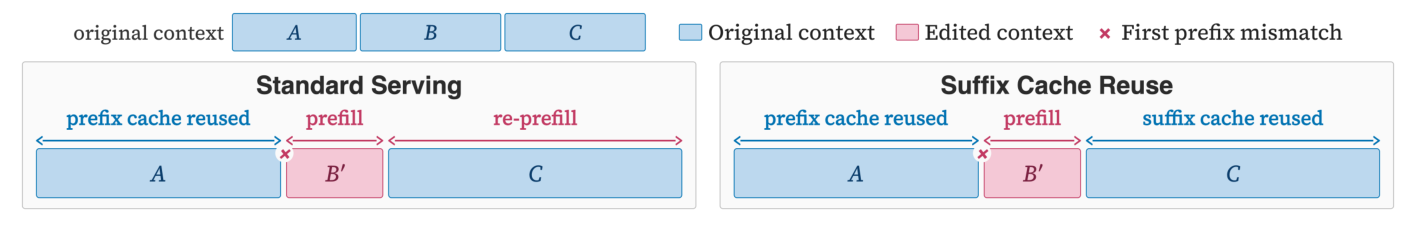
Figure 4. ABC에서 B를 B′로 바꾸면 표준 방식은 B′C를 다시 계산하지만 SCR은 C의 이전 상태를 재사용한다. 이것은 정확한 재계산과 동치가 아닌 근사다. 출처: Shao et al. (2026), v1, p. 6, Fig. 4 — 연구·학습 목적 인용.
표준 full attention에서 C의 KV는 앞서 있던 B의 영향을 받는다. SCR은 이전 prompt와 새 prompt를 비교해 살아남은 span을 찾고, 가장 긴 것부터 최대 K=6개를 옮긴다. key의 RoPE 위치를 새 위치에 맞춰 회전하고 value와 상태는 재사용한다. 위치를 맞추는 것이 내용 의존성까지 재계산하는 것은 아니다.
옮긴 상태는 세션 전용 슬롯에 두어 공유 radix tree에는 들어가지 않게 하며, 슬롯을 확보하지 못하면 표준 재계산으로 돌아간다. 이는 중요한 구현 경계지만 stale state의 의미적 정확성을 증명하는 장치는 아니다.
8.2 Hybrid 모델에서는 삭제된 정보가 recurrent state에도 남는다
Qwen3.6-27B는 64층 중 48층이 선형 attention, 16층이 full attention이다. 토큰별 KV가 없는 선형 attention 층은 편집 전 recurrent-state snapshot에서 계속한다. 새 B′ 자체를 그 선형층에서 다시 계산하지 않지만, full-attention 층에서 다시 계산된 B′의 표현이 뒤의 선형층 입력에 영향을 줄 수 있다.
따라서 현재 문맥 파일이 같아도 과거 cache가 다르면 실행 상태가 달라질 수 있다. SCR을 사용한 시스템의 재현에는 텍스트만 아니라 cache 이력도 중요하다. 문맥에서 지운 내용의 영향을 세션의 cache·recurrent state에서도 확실히 지웠다고 보장하지는 않는다. 이는 논문이 명시한 stale state 메커니즘에서 나오는 운영상 해석이며, 삭제 정보가 모델 가중치에 남거나 외부로 복구됐다는 주장은 아니다. 민감정보 유출을 실제 실험으로 확인한 것도 아니다.
K 제한은 한 번에 옮기는 span 개수를 제한할 뿐 오차 크기에 대한 수학적 상한은 아니다. 부록의 K sweep은 BCP 64문항과 반복 실행에서 성능 저하가 관찰되지 않았다는 소규모 결과다.
8.3 35% 감소는 어디서 나오는가
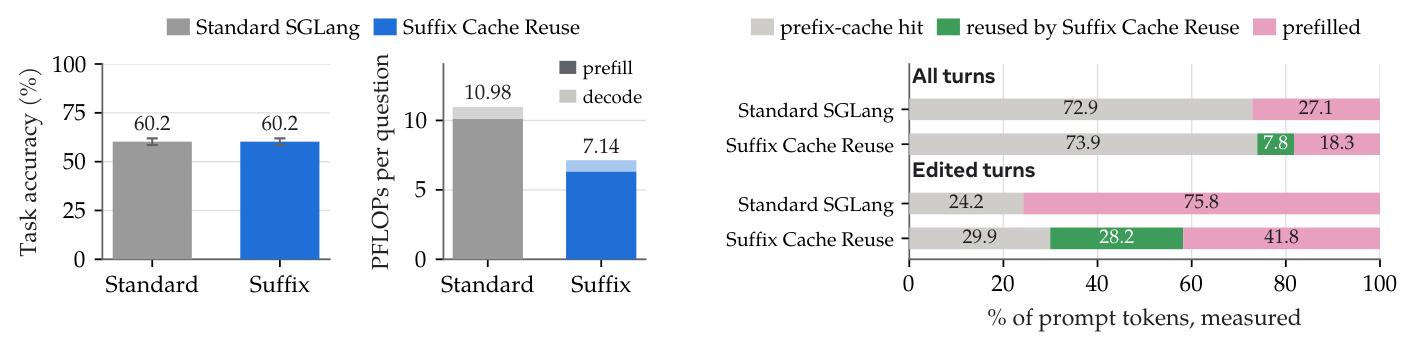
Figure 9. BCP·Qwen3.6-27B의 표준 SGLang과 SCR 비교. 왼쪽 계산량과 오른쪽 토큰 비중은 서로 다른 분모다. 출처: Shao et al. (2026), v1, p. 9, Fig. 9 — 연구·학습 목적 인용.
정확도는 두 조건 모두 60.2%, 비용은 10.98→7.14PFLOPs로 약 34.97% 감소한다. 모든 출력이 같거나 모든 문제에서 오차가 없었다는 뜻은 아니다. 기본 Figure 5의 vLLM 조건 59.4%와 이 별도 SGLang 조건을 섞어 단일 실행의 전후 효과로 만들지도 않는다.
부록 Figure 12는 SCR 추가 재사용 7.8%p의 prompt tokens 중 5.3%p가 이전 reasoning 토큰 제거에서, 2.5%p가 다른 문맥 편집에서 왔다고 나눈다. 약 68%는 추론 기록을 지우는 일반 채팅 서빙에서도 발생할 수 있는 부분이다. 이 비율을 FLOPs 절감분의 정확한 기여율로 바꾸면 안 되지만, 모든 이득이 CLM의 능동 편집 때문에 생겼다는 해석은 배제한다.
9. 공정한 비교와 안전한 운영에 남는 질문
9.1 논문이 명시한 한계
- 편집 가능한 문맥은 prompt injection이나 모델이 만든 지침을 여러 턴에 지속시키는 채널이 될 수 있다(§6).
- 기존 모델은 긴 문맥 길이를 잘 추정하지 못하고 환경의 토큰 힌트가 도움이 된다(Appendix G).
- SCR은 stale state를 쓰는 근사이며 여러 span의 근사가 누적될 수 있다(Appendix B).
- hybrid SGLang의 prefix checkpoint가 성기면 원래 재사용할 수 있는 앞부분도 다시 계산한다. SCR만으로 해결되지 않는다(Appendix B).
- 더 큰 RL과 기존 harness 전략의 증류는 향후 방향이며 이 논문이 완성한 범용 능력이 아니다.
9.2 해설자 관점: 관리 권한과 실험 지원을 분리해야 한다
| 항목 | 확인한 경계 |
|---|---|
| 공통 32K·100턴 표기 | Figure 5 캡션과 달리 부록 E는 terminal 64턴, BCP 23,560-token budget·100턴을 기술한다. 정확한 실행 설정을 확인해야 한다. |
| 편집 턴 | BCP와 CLM RL은 편집 턴을 task-turn 제한에서 제외한다. 공통 task-turn 제한이 총 LM 호출 수 동등을 뜻하지 않는다. FLOPs에는 그 비용을 반영한다. |
| 초과 처리 | BCP CLM은 최대 6회 rollback, EdgeBench는 최대 50회다. 순수 모델 편집 능력과 환경의 복구 지원을 분리할 필요가 있다. |
| subagent 개수 | EdgeBench 본문은 최대 5, 부록은 최대 6을 적는다. 성능 차이를 정밀 재현하려면 구성 확인이 필요하다. |
| 작은 모델 초기점 | Figure 17의 9B BCP 39.9%와 Table 2 학습 전 28.8%를 같은 조건의 시작점으로 합치지 않는다. 일반 BCP 절은 Qwen3.5-27B 채점을 명시하지만 RL 절은 GPT-5.4-nano 보상을 설명한 뒤 “same judge”라고 적는다. Figure 21은 RL 평가를 32K로 표기한다. 실제 판정자·turn cap과 이 수치들의 대응은 저자 설정 확인 전 단정하지 않는다. |
| 자원 비용 | FLOPs, USD, scored attempts, wall-clock 제한을 각각 사용한다. ‘같은 계산량’이라는 하나의 표현으로 모두 합치지 않는다. |
고정한 시스템 프롬프트가 있다고 주입 위험이 사라지지는 않는다. 신뢰할 수 없는 도구 출력이 live context의 지속적인 지침처럼 재작성될 수 있기 때문이다. 다만 이 논문은 공격 성공률·방어 효과를 측정하지 않아 위험의 크기까지 확정할 수 없다. 운영 시에는 원본 감사 로그와 편집 후 입력의 구분, 되돌릴 수 있는 기록, 권한 경계, 캐시 재사용 정책을 별도로 검토해야 한다.
9.3 공개 코드는 재현의 시작이지 실행 결과 자체가 아니다
검토한 revision 18dc11115f50f261233c5bba7937834491e307e8의 최상위 README는 clm_harness·clm_icl·clm_rl·suffix_cache_reuse 디렉터리를 나열하고 ContextBench를 Coming soon으로 표시한다. 이 문서만으로 각 구현 내용이나 완결된 재현 스크립트를 확인한 것은 아니다. 이 시점의 공개 상태를 논문의 모든 벤치마크가 완전히 재현 가능한 패키지라는 주장으로 바꾸지 않는다.
또 harness README의 BCP preset은 28,672토큰·500 task steps를 소개하며, 다른 turn 수를 사용한 실행도 언급한다. 논문 부록의 23,560·100과 자동으로 같다고 가정해서는 안 된다. 리뷰는 문서와 작은 edit-gate 파일을 확인했으며 전체 코드 보안 감사나 논문 실험 실행을 한 것은 아니다.
10. 문맥 관리 권한을 모델에 준다는 것
CLM은 문맥 관리의 학습 단위를 넓힌다. 외부 harness가 정해 둔 압축 시점·요약 형식만 고르는 대신, 에이전트가 무엇을 남기고 어떤 상태를 고칠지 일반 코드로 표현한다. 이 행동을 텍스트 스킬로 개선하거나 결과·효율 보상으로 학습할 수 있다는 점이 중요하다.
관측된 결과는 특히 긴 작업에서 유망하다. 동시에 성능의 근거는 여러 층으로 나뉜다. 학습 없는 harness 비교, task-specific 스킬 진화, 9B의 RL, 근사 cache reuse는 서로 다른 모델·예산·비용 지표를 사용한다. 하나의 마법 같은 ‘컨텍스트 모델’이 모든 수치를 동시에 달성한 것으로 읽으면 안 된다.
실용적 결론은 모델에게 쓰기 권한을 주되 경계를 없애지 않는 것이다. 어떤 입력을 모델이 고칠 수 있는지, 편집 비용을 어떻게 계산하는지, 지운 정보가 cache에 남는지, 실패를 어떻게 복구하는지가 실제 시스템의 성질을 결정한다. 문맥을 파일로 만드는 단순한 인터페이스의 힘과 그 뒤에 남는 운영 책임을 함께 보는 것이 이 논문을 읽는 핵심이다.
References
Shao, R., Shen, S. Z., Yin, J. O., Li, Y., Wang, M., Ivison, H., Poovendran, R., Lambert, N., Xiao, T., Lewis, M., Yih, W.-t., Zettlemoyer, L., & Koh, P. W. (2026). Context language models [Preprint]. arXiv. https://arxiv.org/abs/2609.37725v1
Facebook Research. (2026). Context Language Models [Source code and documentation, revision 18dc11115f50f261233c5bba7937834491e307e8]. https://github.com/facebookresearch/context-language-models/tree/18dc11115f50f261233c5bba7937834491e307e8
관련 연구의 확인 범위: RLM·MEM1·ACM·Self-Compact·OpenEvolve·SGLang과 선행 non-prefix cache 연구의 관계는 대상 논문의 §§2·A·B에 따라 소개했다. 각 선행 논문의 전체 결과나 구현을 별도로 재감사한 것은 아니다.