Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion
여러 검색 방향을 배워 빠르게 결과를 모으기: R4T 쉽게 읽기
R4T는 강화학습으로 여러 검색 방향을 발견하고, 그 결과를 작은 확산 검색기의 학습 자료로 옮긴다. 검색 묶음의 다양성·참조 커버리지와 교사 대비 학생의 품질 손실, 그리고 ‘single-pass’와 실제 샘플링 비용의 차이를 함께 살펴본다.
Paper: Pengcheng Jiang; Judith Yue Li; Moonkyung Ryu; R. Lily Hu; Kun Su; Zhong Yi Wan; Liam Hebert; Hao Peng; Jiawei Han; Dima Kuzmin; Craig Boutilier (2026). Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion. arXiv:2603.06397v1 · PDF. 부록을 포함한 24쪽을 기준으로 읽는다.
이 글은 논문의 핵심 아이디어와 평가 결과를 쉽게 설명한다. 보상 함수, 합성 자료, 지표 정의와 재현성 쟁점은 상세 읽기에 정리했다. 수치는 저자 보고이며, 학습·검색 실험을 다시 실행하지 않았다.
검색할 때 원하는 것이 문서 하나가 아니라 서로 다른 관점을 보여 주는 결과 묶음일 수 있다. 예를 들어 “보헤미안 축제 스타일” 검색에서 거의 같은 옷만 열 개 보여 주면 다양성이 부족하고, 전혀 어울리지 않는 항목을 섞어도 검색 의도에서 벗어난다. Fan-out은 넓은 질의를 여러 하위 질의로 나눠 각각 검색한 뒤 결과를 합치는 방식이다.
R4T는 먼저 큰 언어모델이 검색 결과 묶음을 평가받으며 하위 질의를 만들도록 학습한다. 다음으로 그 모델의 출력에서 학습 자료를 만들고, 작은 확산 모델을 학습시켜 배포 때 여러 검색 방향을 생성한다. 강화학습은 매 사용자 요청에 직접 쓰기보다, 학생 모델을 위한 검색 행동을 미리 찾아내는 데 쓰인다.
1. 검색의 ‘좋은 결과’를 보상으로 표현한다
R4T에는 두 과제가 있다. OAR는 패션 테마나 음악 분위기처럼 열린 질의를 다룬다. 가능한 좋은 결과 묶음이 하나로 정해져 있지 않아, 시스템은 검색 결과가 질의와 어울리는지, 서로 다양한지를 평가한다. WSCR은 참조 outfit에 포함된 항목을 얼마나 많이 찾아오는지 본다. 이때 참조 묶음은 가능한 구성 중 하나이지 유일한 정답은 아니다.
첫 단계에서는 Fan-Out 언어모델(FOLM)이 여러 하위 질의를 만들고, 고정된 검색기가 각 질의를 실행한다. OAR 보상은 질의가 실제 데이터 항목 가까이에 있는지, 하위 검색 결과가 다양한지, 원래 넓은 질의와 가까운지를 결합한다. WSCR은 참조 항목 집합을 얼마나 회수했는지를 보상한다.
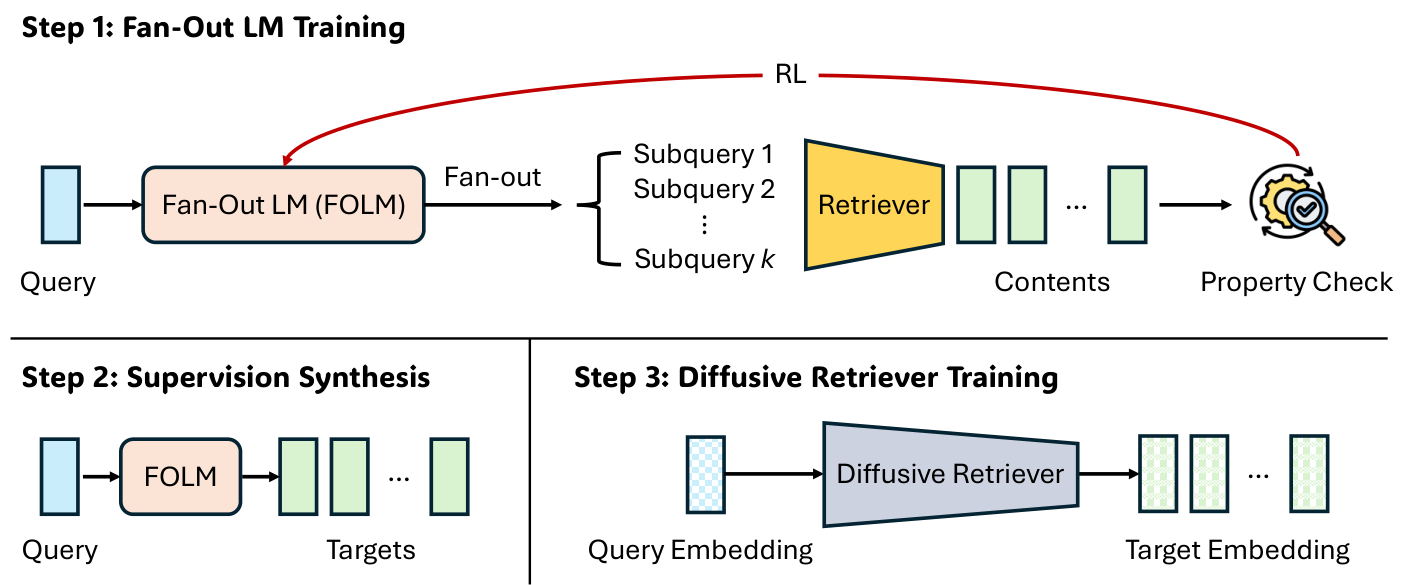
Figure 1. 1단계에서 검색 결과에 보상을 주며 FOLM을 학습하고, 2단계에서 그 출력으로 표적을 만든 뒤, 3단계에서 확산 검색기를 학습한다. 출처: Jiang et al. (2026), arXiv v1, p. 3, Figure 1.
이 보상은 사람이 실제로 “좋은 코디”라고 판단하는 정답표가 아니다. 임베딩 거리와 다양성 점수 같은 대리 지표다. 저자들은 groundedness 하나만 높이면 검색 임베딩에 가까운 무의미한 반복 문자열이 생길 수 있음을 보였다. 정합성 보상을 더해도 반복 패러프레이즈로 붕괴하는 경우가 있었다.
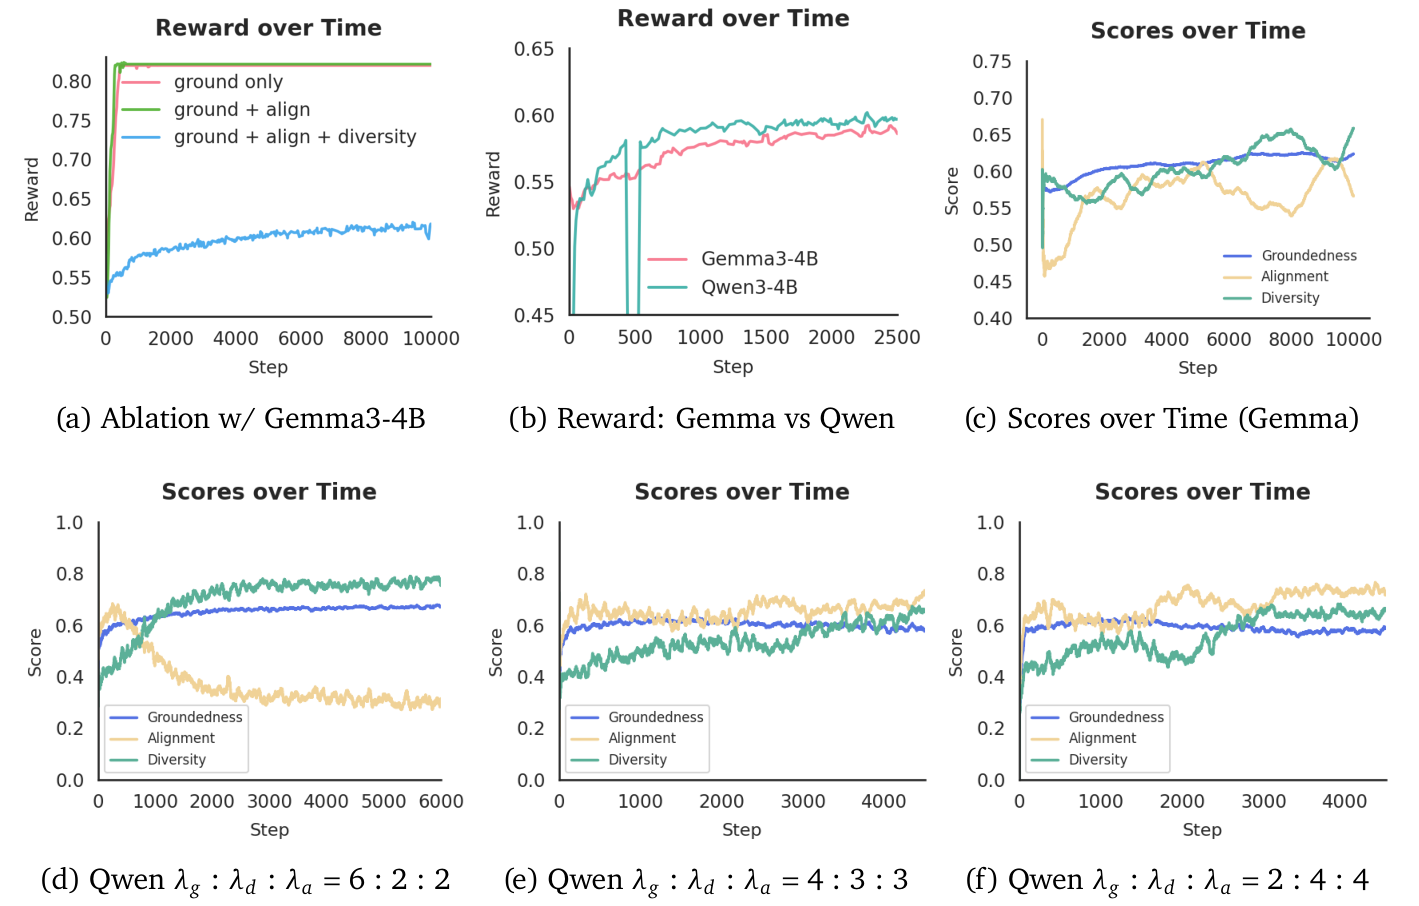
Figure 4. 위쪽 왼쪽은 groundedness만 쓸 때 보상이 높아져도 다양성·정합성은 확보되지 않을 수 있음을 보여 준다. 아래쪽은 Qwen 보상 가중치를 바꾼 비교다. 서로 다른 패널의 척도를 직접 견주지는 않는다. 출처: Jiang et al. (2026), arXiv v1, p. 9, Figure 4.
세 보상을 합친 설정은 실험한 조건에서 이런 붕괴를 완화했지만, 어떤 지름길도 불가능하게 만든다는 보증은 아니다. 보상 함수를 잘못 맞추면 그 편향이 생성 자료와 학생 모델에 이어질 수 있다.
2. 큰 교사의 행동을 작은 모델에 옮긴다
R4T는 RL로 학습한 FOLM을 그대로 쓰는 방법과, 그 출력으로 확산 학생을 학습하는 방법을 비교한다. 둘은 같은 것을 배우지 않는다. OAR 학생은 교사가 찾아낸 콘텐츠 임베딩을 목표로 삼고, WSCR 학생은 교사가 만든 하위 질의의 임베딩을 목표로 삼는다. 즉 가중치나 문장 생성 과정을 복사하는 것이 아니라 검색 방향의 표적을 합성해 학습한다.
논문은 확산 모델을 “single-pass” 검색기로 소개하지만 이를 신경망을 단 한 번 호출한다는 뜻으로 읽으면 안 된다. 부록은 SDE 샘플러에 256단계를 사용한다고 명시한다. 여러 검색 방향을 자기회귀로 하나씩 만들지 않고 한 번의 샘플링 과정에서 병렬로 생성한다는 의미가 더 정확하다.
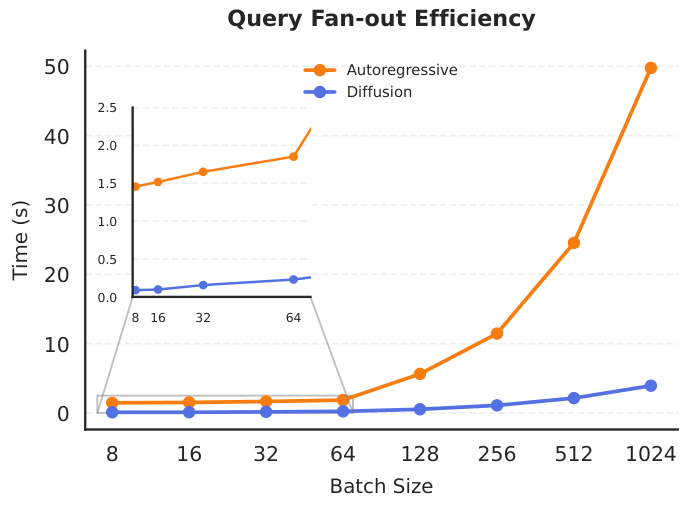
Figure 5. 여덟 질의를 묶은 배치에서 저자 보고 시간은 자기회귀 방식 약 1.46초, 확산 방식 0.07초다. 이는 팬아웃 생성 시간이지 배치 1의 사용자 지연이나 검색 전체 비용이 아니다. 출처: Jiang et al. (2026), arXiv v1, p. 10, Figure 5.
배치 1,024에서는 자기회귀 방식이 거의 50초, 확산 방식은 4.21초로 보고되어 큰 배치의 팬아웃 생성은 약 11.9배 차이다. 하지만 이 시간에 질의 임베딩, 최근접 이웃 검색, 후보 합치기와 후처리가 어디까지 포함되는지는 충분히 나뉘어 있지 않다. RL과 학생 학습에 든 총 비용도 별도다. 따라서 “요청 전체가 12~20배 빨라졌다”고 바꾸어 말할 수 없다.
3. 결과에는 교사와 학생의 교환이 드러난다
OAR에서 Gemma 계열 RL 교사의 보고 평균 점수는 Best-of-5보다 Polyvore에서 40.9→49.1, Music에서 49.2→58.1로 높았다. 다만 논문은 평가를 1–5 Likert로 설명하면서 표에는 22~77 정도의 수치를 제시하고, 변환 방법을 명확히 적지 않는다. 이 차이는 표에 표시된 점수 단위의 차이지, 정확도 퍼센트포인트 상승이라고 해석할 수 없다.
확산 학생은 모든 성질을 교사 그대로 보존하지 않았다. WSCR에서 Qwen 교사 대비 학생의 Recall@5K는 20.9에서 16.5로, Hit@5K는 64.6에서 57.5로 낮아졌지만 Vendi 점수는 27.5에서 34.7로 높아졌다. 참조 항목을 더 많이 회수하는 성질과 실행 간 다양성이 서로 바뀐 결과다. 여기의 Vendi는 한 결과 묶음 안의 다양성이 아니라, 같은 질의를 다섯 번 실행했을 때 얻은 대표 임베딩들 사이의 변동성이다.
OAR 확산 학생 표에는 하위 질의가 없어 groundedness와 전체 평균이 비어 있다. 이를 0점이나 만점으로 채워 비교하면 안 된다. 또한 OAR 평가 Judge는 본문에 Gemini-2.5-Pro, 부록에 Gemini-2.5-Flash라고 서로 다르게 적혀 있어 실제 평가 모델을 확정하기 어렵다.
4. 어디까지 유망한가
R4T의 핵심 아이디어는 검색의 다양성이나 참조 커버리지를 큰 모델의 보상으로 표현하고, 그 행동을 대량의 합성 자료로 바꿔 더 작은 검색기에 학습시키는 것이다. 패션·음악의 실험 결과는 그 접근이 가능성을 보인다는 근거다. 하지만 기존 outfit·플레이리스트 자료와 임베딩, LLM 생성·평가에 의존하므로 “아무 사람 감독이나 외부 모델도 필요 없다”는 주장은 아니다.
해석할 때는 몇 가지 경계를 기억해야 한다. 평가 데이터는 한정된 패션·음악 풀이고, 음악 자료는 비공개다. 참조 항목 Recall은 추천 묶음의 최종 품질과 같지 않다. 부록의 팬아웃 길이 12와 본문의 10개 질의 설정이 어떻게 이어지는지도 설명되지 않는다. 따라서 현재 결과는 특정 데이터와 지표에서 보인 교환이지, 모든 도메인에서 교사 품질과 의미적 안전성을 그대로 보존한다는 뜻은 아니다.
같이 읽기: H+ Embedding · Hierarchical BM25 · GraphCert
References
Jiang, P., Li, J. Y., Ryu, M., Hu, R. L., Su, K., Wan, Z. Y., Hebert, L., Peng, H., Han, J., Kuzmin, D., & Boutilier, C. (2026). Efficient, property-aligned fan-out retrieval via RL-compiled diffusion [Preprint]. arXiv. https://arxiv.org/abs/2603.06397v1