Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion
R4T는 강화학습으로 여러 검색 방향을 발견하고, 그 결과를 작은 확산 검색기의 학습 자료로 옮긴다. 검색 묶음의 다양성·참조 커버리지와 교사 대비 학생의 품질 손실, 그리고 ‘single-pass’와 실제 샘플링 비용의 차이를 함께 살펴본다.
Paper: Pengcheng Jiang; Judith Yue Li; Moonkyung Ryu; R. Lily Hu; Kun Su; Zhong Yi Wan; Liam Hebert; Hao Peng; Jiawei Han; Dima Kuzmin; Craig Boutilier (2026). Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion. Google Research·University of Illinois Urbana-Champaign. arXiv:2603.06397v1. PDF · 서지 정보. 부록을 포함한 24쪽을 기준으로 읽는다. arXiv v1 표기는 2026-03-06이고 PDF 첫머리에는 2026-03-09도 적혀 있다. 별도 판본으로 해석하지 않는다.
Abstract: 넓은 검색 의도에는 하나의 정답 문서보다 다양하면서도 서로 어울리는 결과 묶음이 필요할 수 있다. R4T(Retrieve-for-Train)는 언어모델이 여러 하위 질의를 생성하도록 집합 수준 보상으로 강화학습하고, 그 출력에서 합성 감독을 만든 뒤 작은 확산 검색기를 학습한다. 배포 시에는 자연어 하위 질의를 길게 생성하는 대신 여러 검색 임베딩을 함께 샘플링한다. 패션·음악의 추상적 검색과 패션의 약한 참조 집합 검색에서 개선이 관찰되지만, 학생이 교사의 모든 품질을 보존하는 것은 아니다. 특히 본문의 single-pass 표현과 부록의 256-step solver, 평가 Judge의 Pro/Flash 표기, 팬아웃 10개와 길이 12의 설정을 함께 확인해야 한다. 이 글은 비용을 온라인에서 오프라인으로 옮기는 원리와 그 대가를 구분한다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 질문 | 집합의 다양성·의도 정합성·참조 항목 커버리지를 학습하면서도 매 요청마다 큰 언어모델을 실행하지 않을 수 있는가? |
| 방법 | RL 팬아웃 언어모델 → 합성 감독 → 53.9M 매개변수 확산 검색기. 동결한 임베딩 검색기를 공통으로 사용한다. |
| 감독의 차이 | OAR 학생은 검색된 콘텐츠 임베딩을, WSCR 학생은 교사가 만든 하위 질의 임베딩을 배운다. |
| OAR 결과 | Gemma 계열 FOLM의 표상 평균은 Best-of-5 대비 Polyvore +8.2, Music +8.9. Diffusion에는 groundedness·전체 평균이 없다. |
| WSCR 결과 | Qwen 교사→학생 Recall@5K는 20.9→16.5로 낮아지고, Vendi Score는 27.5→34.7로 높아진다. 품질의 완전한 보존이 아니라 교환이다. |
| 비용 | 배치 8의 팬아웃 생성은 1.46→0.07초, 약 20.9배. 배치 1 지연·전체 검색 지연·총학습 비용의 배율은 아니다. |
| 핵심 주의 | single-pass는 한 번의 신경망 호출로 읽으면 안 된다. 부록은 256단계 샘플링을 명시한다. |
| 판단 | 보상에 맞는 합성 자료를 만들어 빠른 모델에 옮기는 접근은 유망하다. 의미적 보장·최종 묶음 품질·실서비스 비용은 별도 검증이 필요하다. |
읽기 안내: 수치는 저자 보고이고, 차이·배율만 이 리뷰에서 재계산했다. 학습·검색 실험이나 Judge 평가를 재실행하지 않았다. Table 1의 점수 척도 변환이 명확하지 않아 그 차이를 정확도 퍼센트포인트로 부르지 않는다.
목차
- 검색 결과 하나가 아니라 묶음을 최적화한다
- 강화학습을 배포 경로에서 학습 자료로 옮긴다
- OAR의 세 보상과 WSCR의 참조 커버리지
- 보상 최적화는 의미적 안전장치가 아니다
- 확산 학생이 실제로 배우는 것
- 어떤 데이터와 기준선으로 평가했는가
- OAR 개선과 평가에서 비어 있는 칸
- WSCR에서는 커버리지와 다양성이 교환된다
- 빠른 팬아웃과 single-pass 표현의 간격
- 저자 한계와 재현을 위해 확인할 조건
1. 검색 결과 하나가 아니라 묶음을 최적화한다
“Bohemian festival style”에 맞는 패션을 찾는다고 하자. 같은 드레스 사진 열 장은 각각 질의와 가깝더라도 다양한 코디를 살펴보려는 목적에 충분하지 않을 수 있다. 반대로 신발·가방·상의가 제각각 관련 있어도 함께 어울리는 구성이라는 보장은 없다.
Fan-out은 하나의 넓은 질의를 여러 하위 질의로 나누어 각각 검색한 뒤 결과를 합치는 방식이다. 이때 좋은 하위 질의 열 개는 단순히 가장 비슷한 문장 열 개가 아니다. 서로 다른 해석을 덮거나, 참고 코디의 여러 구성품을 찾아야 한다.
R4T는 이 문제를 보상으로 원하는 집합 성질을 명시하고, 그 성질에 맞는 감독 자료를 만들어 작은 생성 검색기로 옮기는 문제로 다룬다. 전통적인 감독 검색을 전부 top-1 문제로 환원할 필요는 없지만, 개별 질의–항목 관계만으로 다양성·보완성 같은 집합 성질을 직접 표현하기 어렵다는 동기는 타당하다.
H+ Embedding이 비교할 표현 단위를, Hierarchical BM25가 방문할 검색 영역을 바꾼다면, R4T는 하나의 의도에서 여러 검색 방향을 만드는 정책과 그 학습 자료를 바꾼다. 최종 카탈로그 항목을 찾는 임베딩 공간은 동결되어 있다.
2. 강화학습을 배포 경로에서 학습 자료로 옮긴다
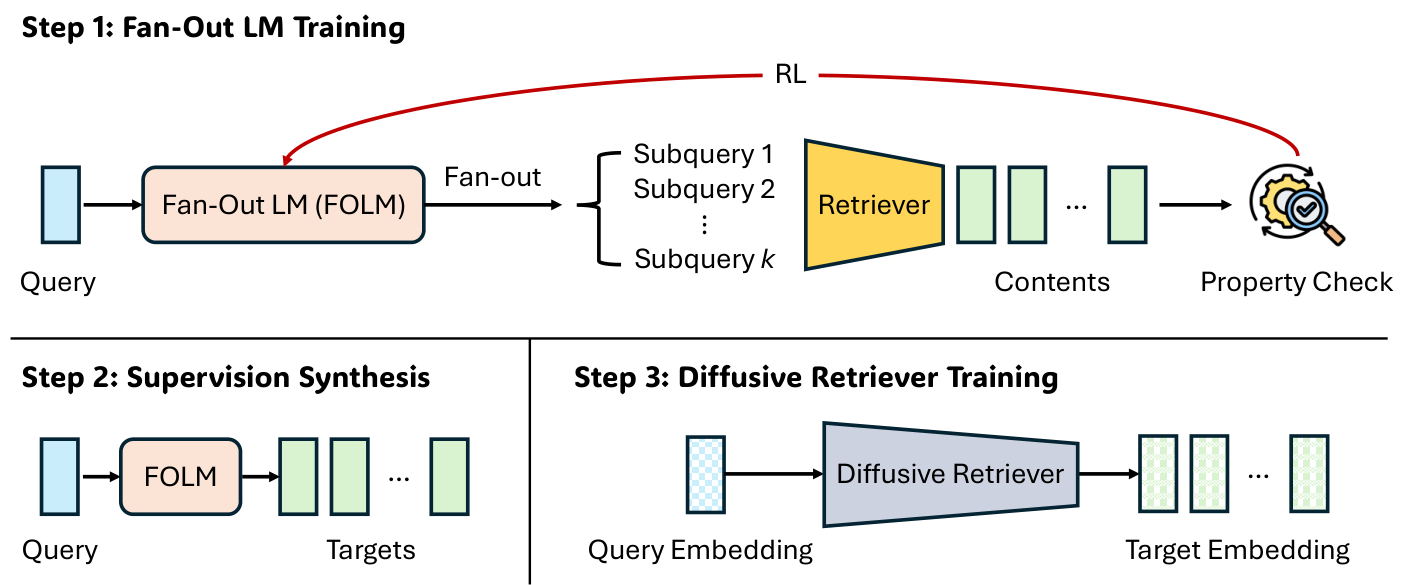
Figure 1. Step 1은 검색 결과를 보상으로 평가해 언어모델을 학습하고, Step 2는 그 정책으로 감독을 만들며, Step 3은 검색 방향을 생성하는 확산 모델을 학습한다. 출처: Jiang et al. (2026), v1, p. 3, Fig. 1 — 연구·학습 목적 인용.
2.1 RL 교사는 실제 검색 결과로 보상을 받는다
입력 q에 대해 팬아웃 언어모델(FOLM)이 Q={q_1,\ldots,q_k}를 만든다. 동결한 검색기 R이 데이터베이스 D에서 각 하위 질의를 실행하고 결과를 합친다.
\mathcal R(Q)=\bigcup_{i=1}^k R(q_i,D).보상은 생성된 문장의 모양만이 아니라 검색 결과의 다양성이나 참조 항목 회수를 평가한다. RL은 Gemma3-4B 또는 Qwen3-4B 기반 팬아웃 정책을 바꾸며, 콘텐츠 인코더나 카탈로그를 함께 학습하는 것은 아니다.
2.2 학생에게 옮기는 것은 가중치나 추론 문장이 아니라 감독 쌍이다
교사의 출력으로 질의 임베딩 z_q와 목표 텐서 Z_{\mathrm{target}}\in\mathbb R^{L\times d}의 쌍을 만든다. 각 행은 하나의 검색 방향이다. 중요한 차이는 다음과 같다.
| 과제 | 학생의 목표 행 | 옮기려는 것 |
|---|---|---|
| OAR | 교사의 팬아웃으로 검색한 콘텐츠의 임베딩 | 데이터베이스 콘텐츠에 연결된 결과 분포 |
| WSCR | RL로 최적화한 하위 질의의 임베딩 | 참조 묶음을 덮는 검색 분해 전략 |
OAR에서 학습한 결과 임베딩과 WSCR에서 학습한 검색 질의 임베딩을 모두 ‘정답 항목 벡터’로 부르면 틀린다. 두 과제는 같은 3단계 틀을 쓰지만 학생이 따라가는 대상이 다르다.
2.3 두 배포 모델은 품질과 비용을 분리해 보여 준다
- R4T-FOLM: RL 교사를 그대로 실행해 자연어 하위 질의를 생성하고 검색한다.
- R4T-Diffusion: 합성 감독으로 학습한 작은 모델이 여러 벡터를 함께 생성하고 최근접 이웃 검색으로 실제 콘텐츠에 연결한다.
‘RL-compiled’는 보상을 최적화한 행동을 데이터로 옮겨 다른 모델에 학습시킨다는 의미다. 교사의 정책·보상·분포를 수학적으로 보존하는 컴파일러가 아니다. 교사의 로짓이나 가중치를 직접 맞추는 증류 손실도 제시하지 않는다.
GraphCert도 생성물을 학습 자료로 바꾸지만 실행 재검사로 자료를 선별한다. R4T의 핵심은 실행 인증이 아니라 검색 결과의 성질을 보상으로 삼아 생성 자료의 분포를 바꾸는 것이다.
3. OAR의 세 보상과 WSCR의 참조 커버리지
3.1 OAR: 유일한 정답 묶음이 없는 탐색
Open-Ended Abstract Retrieval은 테마나 분위기를 입력받아 서로 다른 의류 컬렉션·음악 플레이리스트를 찾는다. 보상은 세 항의 가중합이다.
R_{\mathrm{OAR}}=0.6r_{\mathrm{ground}}+0.2r_{\mathrm{div}}+0.2r_{\mathrm{align}}.Groundedness는 하위 질의 벡터가 데이터베이스의 최근접 콘텐츠에서 얼마나 멀리 떨어졌는지 본다.
r_{\mathrm{ground}}=1-\frac1k\sum_i\min_{c\in D}
\lVert e_{\mathrm{text}}(q_i)-e_{\mathrm{content}}(c)\rVert_2.Diversity는 각 하위 질의가 찾은 대표 콘텐츠, 예컨대 top-1 결과의 임베딩에 Vendi Score를 적용한다. 같은 방향으로 모인 결과보다 서로 다른 의미 방향을 보상하려는 지표다.
Alignment는 각 하위 질의와 원래 넓은 질의 사이의 코사인 유사도를 평균한다.
r_{\mathrm{align}}=\frac1k\sum_i\cos(e_{\mathrm{text}}(q_i),e_{\mathrm{text}}(q)).세 보상은 사람이 보기에 ‘진짜로 어울리는 코디’를 직접 판정하는 규칙이 아니라 임베딩 공간의 대리지표다. 0.6·0.2·0.2라는 계수만으로 실제 영향력의 비중을 단정할 수도 없다. 항들의 척도·정규화에 따라 기여가 달라지기 때문이다.
또한 카탈로그 최근접 이웃을 반환한다는 존재 보장과 의미적으로 질의에 맞는다는 관련성은 다르다. 없는 상품 ID를 직접 생성하지 않더라도 원래 의도와 무관한 실제 상품을 고를 수 있다.
3.2 WSCR: 참조 묶음은 가능한 정답 중 하나다
Weakly Supervised Compositional Retrieval에서는 q에 참조 항목 집합 Y가 연결되어 있다.
R_{\mathrm{WSCR}}=\frac{|Y\cap\mathcal R(Q)|}{|Y|}.서로 다른 하위 질의가 Y의 다른 항목을 찾으면 합집합의 커버리지가 높아진다. 다만 이 식은 참조 항목의 ID 회수를 보상한다. 참조에 없는 대안 코디가 똑같이 좋더라도 점수는 받지 못한다. 모든 의미적 다양성·보완성·스타일 일관성을 동시에 최적화하는 보상은 아니다.
이것은 방법의 실패라기보다 약한 감독의 선택이다. 논문은 Y가 유일한 정답이 아니라고 명시하고 recall을 엄격한 정확도가 아닌 커버리지 proxy로 해석한다. 그렇다고 낮은 recall의 모든 대안이 타당하다고 자동으로 인정되는 것은 아니다.
4. 보상 최적화는 의미적 안전장치가 아니다
4.1 Soft-GRPO는 같은 질의의 생성물끼리 비교한다
질의당 G개 출력의 보상을 평균·표준편차로 정규화한다.
A_i=\frac{r_i-\mu_G}{\sigma_G+\epsilon}.Table 3의 그룹 크기는 8이다. 정책 비율 clipping에 더해 현재 정책과 샘플링 정책 사이의 양방향 KL 항을 사용한다. 학습률은 10^{-7}, global batch 512, clip 0.2, 두 KL 계수는 각각 0.05다. Soft-PPO는 업데이트를 규제하는 장치이지 잘못 설계된 보상의 의미를 고쳐 주는 장치는 아니다.
4.2 Groundedness만 높이면 말이 안 되는 문자열도 이길 수 있다
저자들은 groundedness만 보상하면 특정 데이터베이스 벡터에 가까워지는 반복 문자열, 예를 들어 “line ending line ending line ending”으로 붕괴했다고 보고한다. 여기에 alignment만 더하면 원래 질의의 비슷한 표현을 반복하는 방식으로 더 빨리 붕괴할 수 있었다(pp. 8–9).
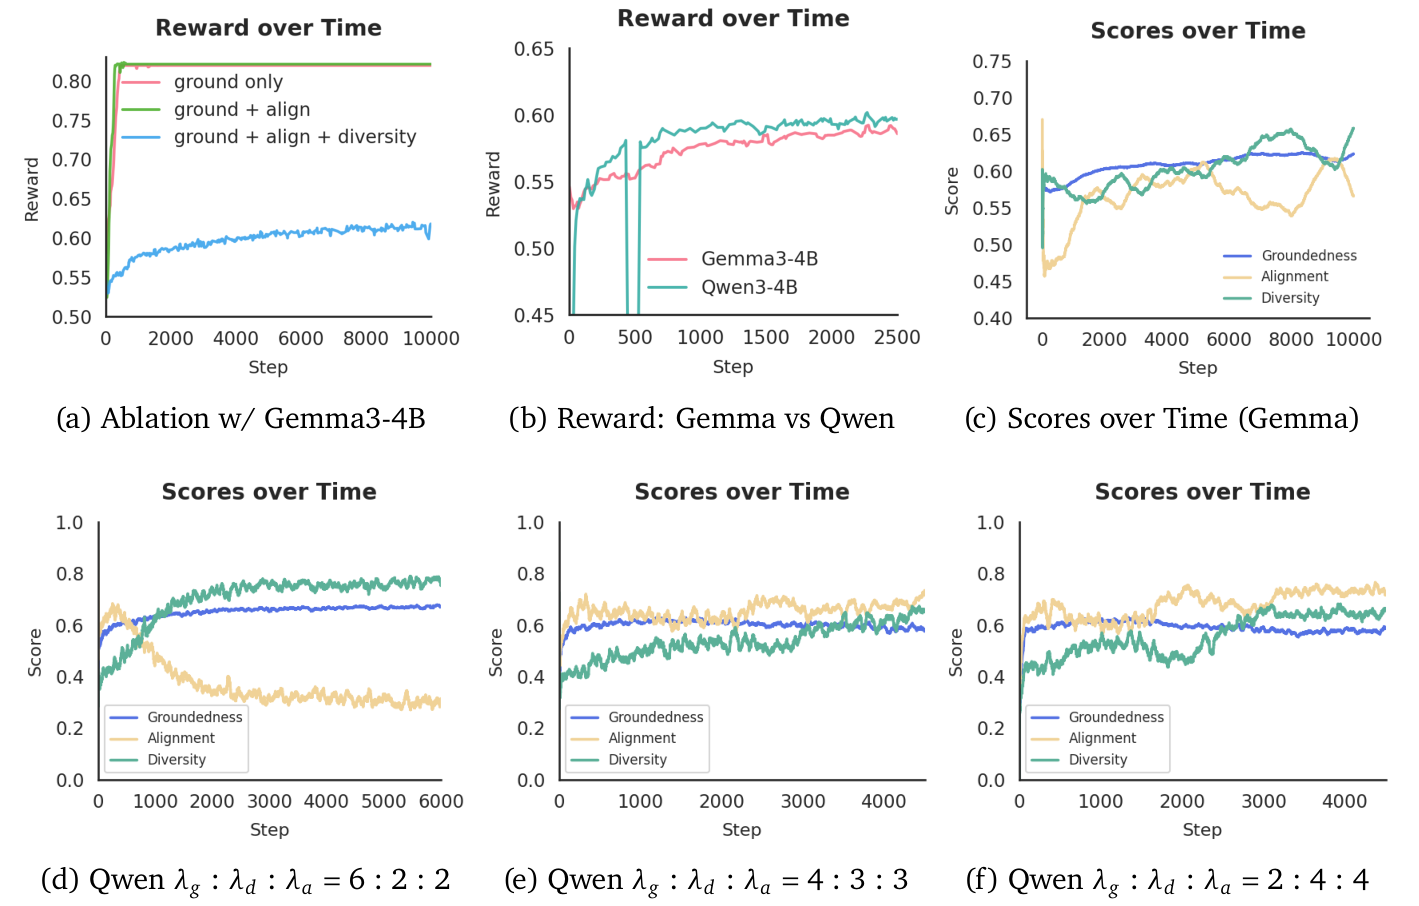
Figure 4. (a)는 보상 조합, (b–c)는 모델·시간에 따른 변화, (d–f)는 Qwen의 가중치 비율 6:2:2·4:3:3·2:4:4를 보여 준다. 각 패널의 가로 범위와 세로 척도가 다르다. 출처: Jiang et al. (2026), v1, p. 9, Fig. 4 — 연구·학습 목적 인용.
세 항을 결합하면 관찰된 반복 붕괴가 완화된다. 하지만 서로 다른 보상 함수를 쓴 곡선의 높이만으로 어떤 모델이 의미적으로 더 낫다고 판단할 수는 없다. Figure 4(a)의 ground-only 높은 보상은 바로 ‘잘못된 해도 보상을 크게 받을 수 있다’는 사례다.
4.3 세 항을 더했다고 보상 해킹이 불가능해지는 것은 아니다
기본 6:2:2에서 Qwen의 alignment가 떨어지고 diversity가 커지는 모습은 계수의 교환을 드러낸다. 4:3:3 또는 2:4:4의 곡선도 보여 주지만, 같은 조건의 최종 검색 품질·오차 범위를 모두 비교한 절제 표는 아니다.
본문은 높은 보상을 받으려면 의미 있는 질의를 생성해야 한다는 강한 설명을 한다. 그러나 제시한 결과는 특정 모델·설정에서 관찰한 붕괴 방지다. 가능한 모든 지름길을 제거했다는 증명이나 적대적 스트레스 테스트로 읽으면 안 된다. 학습된 교사가 보상 함수를 오해하면 합성 자료를 통해 학생에도 그 편향이 전달될 수 있다.
5. 확산 학생이 실제로 배우는 것
5.1 목표 텐서에 노이즈를 넣고 복구한다
확산 학생은 여러 목표 임베딩을 함께 복구하는 VE/EDM denoiser다.
\mathcal L_{\mathrm{diff}}=\mathbb E_{\sigma,\varepsilon}
\left[w(\sigma)\lVert D_\phi(Z_{\mathrm{target}}+\sigma\varepsilon;\sigma,z_q)-Z_{\mathrm{target}}\rVert^2\right].
노이즈 크기에 따른 가중치는 w(\sigma)=(\sigma^2+\sigma_{\mathrm{data}}^2)/(\sigma\sigma_{\mathrm{data}})^2다. Transformer가 행들 사이의 관계를 모델링하고, 질의 임베딩을 cross-attention으로 주입한다. 학습 중 질의 조건을 일부 제거해 classifier-free guidance를 사용할 수 있게 한다.
학생이 직접 최적화하는 식에는 원래 OAR·WSCR 보상이 들어 있지 않다. 보상은 교사와 합성 데이터 분포를 통해 간접적으로 전달되고, 학생은 그 자료의 노이즈 제거를 학습한다. 그래서 실제로 얼마나 보존되는지는 교사–학생 결과를 비교해야 한다.
5.2 순서 섞기는 엄격한 순열 불변성 증명이 아니다
목표 텐서의 행 순서를 무작위로 바꾸어 순서 변화에 강해지도록 한다. 이는 집합을 임의 순서에 과적합시키지 않기 위한 데이터 증강이다. 구조 자체의 순열 불변성이나, 중복 없는 결과·정확히 한 벌의 코디라는 제약을 보장하는 것은 아니다.
생성한 벡터를 최근접 콘텐츠에 연결하면 여러 벡터가 같은 항목으로 매핑될 수도 있다. 합집합은 중복을 제거하지만 남는 항목 수와 의미적 보완성을 별도로 검증해야 한다.
5.3 합성 감독의 크기와 선별 규칙
부록은 질의당 temperature 0.9로 128개 샘플을 생성한다고 명시한다. 개요에는 성공적인 고보상 궤적의 수집·필터링이 등장하지만, 구체적인 보상 컷오프·보존율·실패 생성물 처리 규칙은 충분히 제시하지 않는다. 따라서 ‘128개가 모두 고품질 인증 자료’라고 해석할 수 없다.
Table 3은 확산 학습 총 1천만 step, batch 512를 보고한다. 이 값의 실행 시간·총 가속기 시간은 별도로 제공되지 않는다. RL을 온라인에서 없앴다고 전체 학습 비용이 작아진 것은 아니며, 충분한 질의량으로 초기 비용을 상각할 수 있는지가 배포 판단에 중요하다.
6. 어떤 데이터와 기준선으로 평가했는가
6.1 카탈로그 크기와 검색 단위
| 과제·도메인 | 후보 풀 | 검색 대상 |
|---|---|---|
| OAR·Polyvore | 21,888 | 의류 컬렉션·추상 단위 |
| OAR·Music | 8,522 | 플레이리스트 임베딩 |
| WSCR·Polyvore | 142,472 | 개별 패션 항목 |
원문 pp. 6–7. Music은 비공개 산업 데이터다. WSCR의 음악 실험은 보고하지 않는다.
Polyvore는 matryoshka 방식으로 학습한 CLIP 계열 표현을 사용하며 주 실험 차원은 128이다. Music은 음악–텍스트 공동 표현인 MuLan을 사용한다. 현재 결과는 수천~십여만 후보 풀에서의 결과이지 10억 단위 검색 실험이 아니다.
6.2 질의는 실제 사용자 로그가 아니라 합성 자료다
OAR는 테마·계절·활동 등의 템플릿으로 LLM이 만든 2–6단어 질의를 중복 제거해 43,874개를 얻고 8:1:1로 나눈다. WSCR는 기존 outfit의 항목명에서 LLM이 넓은 질의를 만든 뒤 묶음을 재조합해 총 84,704개 질의를 구성한다.
WSCR 학습 증강은 원래 묶음과 무작위 항목으로 50개 후보를 만들고, LLM이 서로 다른 10개짜리 묶음 8개와 질의를 생성한다. 시험 증강도 원래 묶음 일부와 30개 후보 풀을 사용한다. 분할·증강의 기술만으로 같은 원본 outfit에서 파생한 자료가 엄격하게 다른 split으로 격리됐는지는 확인하기 어렵다. 누출이 있었다고 단정할 수 없지만 원본 그룹 기준 분할·중복 검사가 재현에 필요하다.
‘사람 라벨 없이’는 새 보상 정렬 질의–목표 감독을 합성한다는 범위로 읽어야 한다. 기존 사용자가 큐레이션한 outfit, 전문가 플레이리스트, 사전학습 인코더, LLM 생성·평가에 의존하지 않는다는 뜻은 아니다.
6.3 기준선과 예산
- No Fan-out: 원래 질의 하나로 같은 명목상의
n\times k개 콘텐츠를 검색한다. - Zero-shot: 학습 전 Gemini-2.5-Flash·Gemma3-4B·Qwen3-4B가 10개 하위 질의를 만든다.
- Best-of-N: zero-shot 팬아웃을 5번 생성해 학습 보상으로 가장 좋은 것을 고른다.
- R4T-FOLM / Diffusion: 보상을 학습한 교사와 합성 자료를 학습한 학생이다.
No Fan-out을 이론적 하한으로 볼 수는 없다. 실제로 Music에서 일부 zero-shot 모델의 groundedness는 더 낮다. Best-of-5도 오프라인 정책 학습과 다른 test-time 계산 예산을 사용하므로 품질뿐 아니라 비용을 함께 비교해야 한다.
7. OAR 개선과 평가에서 비어 있는 칸
7.1 교사의 향상은 뚜렷하지만 학생은 일부 성질만 비교된다
| 계열·방법 | Polyvore 다양성 / 정합성 | Music 다양성 / 정합성 |
|---|---|---|
| Gemma Best-of-5 | 61.0±2.1 / 32.7±1.7 | 43.2±2.3 / 53.0±1.9 |
| Gemma R4T-FOLM | 76.8±2.7 / 39.8±2.3 | 49.2±2.4 / 62.0±2.0 |
| Gemma R4T-Diffusion | 74.3±3.4 / 37.6±2.8 | 46.7±3.1 / 59.6±2.6 |
| Qwen Best-of-5 | 40.3±2.5 / 24.0±1.9 | 40.3±2.7 / 43.7±2.1 |
| Qwen R4T-FOLM | 62.8±2.9 / 28.0±2.0 | 44.8±2.5 / 49.4±2.1 |
| Qwen R4T-Diffusion | 65.0±3.6 / 27.4±2.7 | 44.5±3.0 / 52.0±2.8 |
Table 1 표시값, p. 6. ±는 저자 표기의 표준편차다. 이 표는 비교 가능한 다양성·정합성 두 축만 발췌했다.
Gemma 교사는 Best-of-5보다 Polyvore 다양성 +15.8, 정합성 +7.1이다. 학생은 교사 대비 각각 −2.5, −2.2지만 Best-of-5보다 높다. Qwen Polyvore 학생은 교사보다 다양성이 +2.2 높고 정합성은 −0.6이다. 단순히 모든 점수를 동일하게 보존했다기보다 생성 분포의 성질이 달라졌다고 보는 편이 정확하다.
Gemma의 groundedness까지 포함한 원문 평균은 Polyvore 40.9→49.1, Music 49.2→58.1이다. 하지만 Diffusion 행에는 groundedness와 평균이 없다. 하위 질의가 없어 ‘생성 질의와 검색 콘텐츠의 대응’을 평가할 수 없기 때문이다. 빈칸은 0점도 만점도 아니며 학생의 세 축 평균을 임의 계산해서는 안 된다.
7.2 학습 보상과 평가 점수는 다르다
OAR 학습은 임베딩 거리·Vendi·코사인 유사도를 사용하지만 Table 1은 LLM Judge가 다양성·원질의와 콘텐츠의 정합성·하위 질의와 콘텐츠의 대응을 판정한다. 학습 alignment는 하위 질의–원질의이고 평가 alignment는 결과 콘텐츠–원질의라는 차이도 있다.
별도 평가자가 다른 관점에서 본다는 장점이 있으나, 원문에는 두 가지 재현 문제가 있다.
- 본문 p. 8은 Gemini-2.5-Pro, 부록 B.1 p. 16은 Gemini-2.5-Flash를 Judge라고 적는다. 어느 모델이 Table 1을 만들었는지 확정하지 않는다.
- 프로토콜은 1–5 Likert 척도를 설명하지만 Table 1은 22.4·76.8 같은 수치다. 변환식이 명시되지 않아 이를 정답률이나 백분율로 읽지 않는다. 평균±표준편차는 보고하지만 그 변동이 어떤 반복·표본 단위에서 계산됐는지도 충분히 특정하지 않는다.
저자들은 항목 순서를 무작위로 하고 방법명을 숨기며 근거 설명을 요구한다. 이는 평가 편향을 줄이는 절차지만 사람 평가와의 일치도를 이 데이터에서 직접 검증한 것은 아니다.
7.3 ‘항상 우위’라는 서술에는 예외가 있다
Music No Fan-out의 groundedness는 48.8인데 Gemini zero-shot은 45.8, Qwen zero-shot은 42.0이다. 팬아웃을 한다고 모든 성질이 좋아지는 것은 아니다. 또한 Music 다양성에서 Gemma Diffusion 46.7은 Gemini Best-of-5 48.4보다 낮다. R4T의 장점은 자기 계열의 많은 지표에서 개선되는 것이지 모든 모델·항목을 일괄 지배한다는 뜻은 아니다.
8. WSCR에서는 커버리지와 다양성이 교환된다
8.1 5K는 큰 후보 풀이지 최종 추천 열 개가 아니다
하위 질의 10개마다 500개 항목을 검색하므로 한 번의 추론에서 명목상 5,000개 후보를 만든다. 중복을 합치면 고유 항목 수는 그보다 적을 수 있다. Recall@5K는 참조 항목 중 후보 풀에 들어온 비율, Hit@5K는 참조 항목을 하나 이상 찾은 질의 비율이다.
142,472개 풀의 5,000개는 약 3.51%다. 이 지표는 후보 생성 능력을 보지만 최종 top-10 추천 정확도·완성된 코디의 품질을 직접 측정하지 않는다.
| 방법 | Recall@5K | Hit@5K | Vendi Score |
|---|---|---|---|
| Gemini-2.5-Flash | 15.7 | 52.1 | 33.4 |
| Gemma3-4B | 6.0 | 25.9 | 44.2 |
| Qwen3-4B | 10.1 | 33.9 | 46.4 |
| R4T-FOLM·Gemma | 16.9 | 54.4 | 40.5 |
| R4T-FOLM·Qwen | 20.9 | 64.6 | 27.5 |
| R4T-Diffusion·Gemma | 15.0 | 54.1 | 46.2 |
| R4T-Diffusion·Qwen | 16.5 | 57.5 | 34.7 |
저자 보고, Table 2, p. 6. 원문 표는 Recall·Hit을 15.7 등의 단위로 표시한다. 오차 범위는 이 표에 없다.
8.2 RL의 이득과 학생으로 옮기면서 생긴 손실
Qwen zero-shot→FOLM에서 Recall은 10.1→20.9, Hit은 33.9→64.6으로 높아지고 VS는 46.4→27.5로 낮아진다. 참조 회수 보상에 집중하면서 출력 변동성이 줄었다는 설명과 정합적이다.
교사→Diffusion에서는 Recall 20.9→16.5(−4.4), Hit 64.6→57.5(−7.1), VS 27.5→34.7(+7.2)이다. Recall의 교사 대비 상대 감소는 약 21.1%다. Gemma에서도 Recall은 16.9→15.0으로 낮아지고 VS는 40.5→46.2로 높아진다.
학생은 빠르고 zero-shot보다 좋은 커버리지를 보이지만, RL 교사의 커버리지를 그대로 보존한 것은 아니다. 또 Gemma 학생 Recall 15.0은 Gemini 15.7보다 낮지만 Hit은 54.1로 Gemini 52.1보다 높다. 지표에 따라 순위가 바뀐다.
8.3 여기의 Vendi는 한 묶음 안의 다양성과 다르다
부록 B.2는 질의당 5번 독립 실행하고, 각 실행의 하위 질의 임베딩들을 평균해 대표 벡터를 만든 뒤 실행 간 대표 벡터들의 Vendi Score를 계산한다고 적는다. Table 2 캡션은 5×10=50 하위 질의를 언급하지만 50개 모두를 한 집합으로 넣는 것과 평균 벡터 5개를 비교하는 것은 같은 연산이 아니다.
이 리뷰는 부록의 명시적 계산 절차에 따라 VS를 실행 간 의미적 변동성으로 읽는다. OAR 보상에서 top-1 콘텐츠들 사이의 다양성을 계산하는 방식과 구분한다. 높은 VS가 한 번 반환한 코디의 내부 다양성·일관성이 모두 좋다는 증거도 아니고, 참조 밖 결과가 유효하다는 판정도 아니다.
9. 빠른 팬아웃과 single-pass 표현의 간격
9.1 보고된 배치 시간의 배율은 확인된다
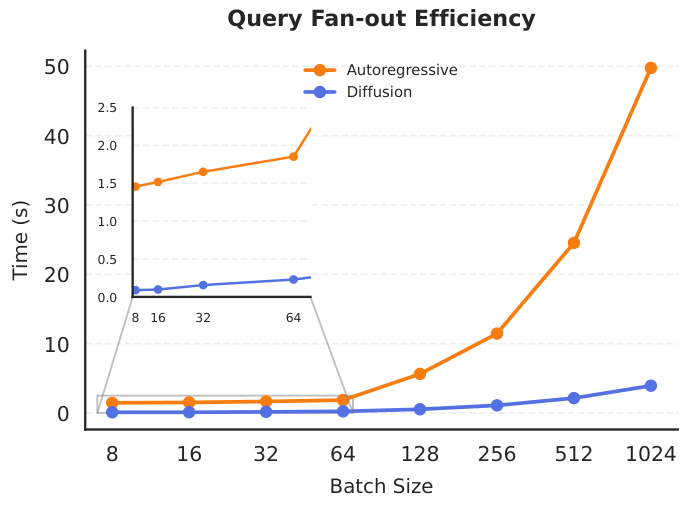
Figure 5. 가로축은 배치 크기가 두 배씩 커지는 척도, 세로축은 초다. 한 질의의 지연이나 전체 검색 처리량으로 바로 바꾸지 않는다. 출처: Jiang et al. (2026), v1, p. 10, Fig. 5 — 연구·학습 목적 인용.
| 배치 크기 | 자기회귀 팬아웃 | 확산 팬아웃 | 재계산 |
|---|---|---|---|
| 8 | 약 1.46초 | 0.07초 | 약 20.9배 |
| 1,024 | 약 50초 | 4.21초 | 약 11.9배 |
§3.4의 보고값. 50초는 원문에서 ‘거의 50초’라고 한 근삿값이다.
논문의 약 12–20배 가속이라는 요약과 대체로 맞는다. 하지만 batch 8의 0.07초는 여덟 질의를 처리한 배치 시간이지 배치 1에서 측정한 지연이 아니다. 이를 8로 나눈 값도 바로 단일 요청 지연이라고 부를 수 없다.
53.9M 학생과 수십억 매개변수 언어모델의 차이에는 출력 공간, 모델 크기, 자기회귀 여부가 함께 들어간다. 이 결과만으로 확산 과정 자체가 모든 빠른 생성 구조보다 유리하다고 판단할 수 없다.
9.2 여러 방향을 동시에 만든다는 것과 한 번 호출한다는 것은 다르다
본문은 여러 곳에서 single-pass 또는 single forward pass라고 설명한다. 그러나 부록 F와 Table 3은 SDE solver 256 steps를 명시한다(pp. 20–22). 이는 일반적으로 여러 번 denoiser를 평가하는 반복 샘플링이다. 정확한 함수 평가 횟수는 solver에 따라 달라지므로 256번이라고 단정하지도 않는다.
따라서 이 방법은 한 샘플링 과정 안에서 여러 검색 방향을 병렬로 생성하는 비자기회귀 방식이라고 설명하는 것이 안전하다. 1-step diffusion이나 한 번의 신경망 호출로 결과를 만든다고 읽을 근거는 없다. Figure 5가 정확히 어떤 solver·step 수로 측정됐는지도 실행 로그가 필요하다.
9.3 전체 검색 비용은 분리되어야 한다
§3.4의 측정 명칭은 query fan-out generation이다. 설명에는 언어모델의 반복 검색도 등장하지만, 질의 인코딩·최근접 이웃 검색·후보 병합·후처리가 타이머에 어느 범위까지 들어갔는지는 충분히 분해하지 않는다. 확산도 생성 벡터를 실제 데이터베이스 항목에 연결하는 검색이 필요하다.
부록은 RL·확산 학습에 TPUv6e-16, 합성에 TPUv6e-4를 사용했다고 적는다. 이것을 Figure 5의 정확한 추론 하드웨어·서비스 설정이라고 대신 쓰면 안 된다. 배치 크기에 따른 팬아웃 비용의 이득과 전체 검색 서비스의 tail latency·비용 절감은 별도 주장이다.
10. 저자 한계와 재현을 위해 확인할 조건
10.1 논문이 직접 인정한 한계
Appendix A(p. 16)는 네 가지를 밝힌다.
- 반복 검색·보상 계산을 포함한 RL 초기 비용은 크거나 자주 바뀌는 데이터베이스에서 부담이 될 수 있다.
- 창의성·문화적 민감성 등 모든 사용자 선호를 스칼라 보상으로 표현하기 어렵다.
- LLM Judge가 가진 편향과 사람 평가의 부족이 남는다.
- 결과는 백본 언어모델·임베딩 공간·확산 구조에 영향을 받으며 다른 도메인으로의 일반화는 미해결이다.
고정된 카탈로그에 맞춰 좋은 자료를 한 번 만들고 반복 서비스하는 조건에서는 상각 논리가 설득력 있다. 상품이나 음악 풀이 자주 바뀌면 교사와 학생을 언제 다시 학습할지, 기존 보상이 여전히 의미 있는지를 추가로 판단해야 한다.
10.2 해설자가 추가로 확인한 불일치와 공백
| 쟁점 | 확인된 범위와 필요한 정보 |
|---|---|
| single-pass / 256 steps | 비자기회귀 다방향 생성은 맞지만 한 번의 모델 호출이라는 표현은 부록과 맞지 않는다. 실제 sampler 설정이 필요하다. |
| 팬아웃 10 / 시퀀스 길이 12 | 본문은 k=10, Table 3은 L=12다. 패딩·특수 위치·잘라내기 여부가 설명되지 않는다. |
| OAR Judge Pro / Flash | 두 표기가 충돌한다. 실제 Table 1 평가 모델을 확인해야 한다. |
| 1–5 척도 / 표의 수십 단위 | 점수 변환과 ± 계산 단위를 알아야 비교의 의미를 재현할 수 있다. |
| 합성 자료 선별 | 128샘플의 필터·보존 기준과 최종 학습 건수가 충분히 제시되지 않는다. |
| WSCR 분할 | 원본 outfit·파생 묶음의 그룹 격리와 중복 검사가 필요하다. 누출을 확인한 것은 아니다. |
| 학생의 이득 출처 | 같은 구조를 비RL 교사 자료·원래 참조 자료로 학습한 대조가 없어 RL 자료와 확산 구조의 기여를 완전히 분리하기 어렵다. |
10.3 이 논문에서 가져갈 핵심
R4T의 실용적인 발상은 비싼 RL 언어모델을 매번 호출하는 대신, 그 모델이 발견한 검색 행동을 대량의 감독으로 바꾸는 것이다. 이는 무거운 교사로 가벼운 학생을 학습하는 일반적인 아이디어를 집합 검색의 보상 정렬 자료 생성에 적용한다.
다만 결과는 ‘더 빠른데 같은 품질’이라는 한 줄로 끝나지 않는다. OAR에는 학생의 groundedness 평가가 없고, WSCR에서는 교사 대비 커버리지가 낮아지며 실행 간 다양성이 높아진다. 비용은 팬아웃 생성에서 줄지만 전처리·학습·최근접 검색까지 포함한 총비용은 남는다. 이 교환을 받아들일 수 있는 서비스인지 판단하는 것이, single-pass나 compiled라는 이름보다 중요하다.
References
Friedman, D., & Dieng, A. B. (2022). The Vendi score: A diversity evaluation metric for machine learning [Preprint]. arXiv. https://arxiv.org/abs/2210.02410
Jiang, P., Li, J. Y., Ryu, M., Hu, R. L., Su, K., Wan, Z. Y., Hebert, L., Peng, H., Han, J., Kuzmin, D., & Boutilier, C. (2026). Efficient, property-aligned fan-out retrieval via RL-compiled diffusion [Preprint]. arXiv. https://arxiv.org/abs/2603.06397v1
기술적 출처의 범위: VE 확산·EDM은 원문이 인용한 Song et al. (2020)·Karras et al. (2022), Diffusion Transformer는 Peebles & Xie (2023)·Tomasi et al. (2025), 데이터·표현은 Han et al. (2017)·Kusupati et al. (2022)·Huang et al. (2022)에 따른다. 이 리뷰는 대상 논문의 설명·실험·부록을 대조했으며 이들 선행 구현을 모두 재현하거나 전수 감사한 것은 아니다.