Hierarchical BM25: Lexical Search at Billion-Document Scale
10억 문서 검색을 빠르게: Hierarchical BM25 쉽게 읽기
Hierarchical BM25는 10억 문서 전체를 훑는 대신 주제별 클러스터를 먼저 골라 검색량을 줄인다. 방문한 문서의 BM25 점수는 정확히 계산하지만, 전역 정답 순위와 10억 문서에서의 품질은 보장하지 않는다.
Paper: Umesh Deshpande; Swaminathan Sundararaman (2026). Hierarchical BM25: Lexical Search at Billion-Document Scale. arXiv:2608.00229v1 · PDF. 2026년 7월 31일자, 11쪽 v1을 기준으로 읽는다.
이 글은 논문의 검색 구조와 결과를 쉽게 정리한다. 클러스터 점수식, 저장량 계산, 비교 실험의 세부 검증은 상세 읽기에서 다룬다. 수치는 논문이 보고한 결과이며, 검색 실험을 다시 실행한 것은 아니다.
핵심 아이디어는 문서 전체를 다 검색하지 말고, 검색할 만한 주제별 묶음부터 골라 보자는 것이다. 10억 문서 규모의 역색인을 매 질의마다 넓게 읽으면 저장장치 접근이 느려진다. Hierarchical BM25는 먼저 약 1,000개 클러스터 가운데 40개를 선택하고, 선택된 클러스터 안에서 BM25 점수를 계산한다. 전체의 약 4%를 먼저 살펴보는 셈이다.
가장 중요한 구분은 이렇다. 선택된 문서의 점수는 정확할 수 있지만, 선택되지 않은 곳의 더 좋은 답은 찾지 못할 수 있다. 따라서 ‘정확한 BM25 점수’가 ‘정확한 전체 검색 결과’를 뜻하지 않는다.
1. 색인 전체 대신 필요한 부분을 고른다
BM25는 질의 단어가 문서에 얼마나 중요하게 나타나는지 점수화해 문서를 정렬하는 검색 방식이다. 보통은 질의 단어 중 하나라도 포함하는 후보 문서를 찾아 평가한다. 코퍼스가 크면 읽을 색인도 커진다.
Hierarchical BM25는 문서를 주제에 따라 약 1,000개의 균형 잡힌 클러스터로 나눈다. 작은 라우팅 색인이 질의를 보고 가능성이 높은 40개 클러스터를 고르고, 정밀 색인은 그 안에서 문서를 채점한다. 마치 도서관에서 책 한 권씩 전부 찾는 대신 주제별 서가부터 좁히는 것과 비슷하다.
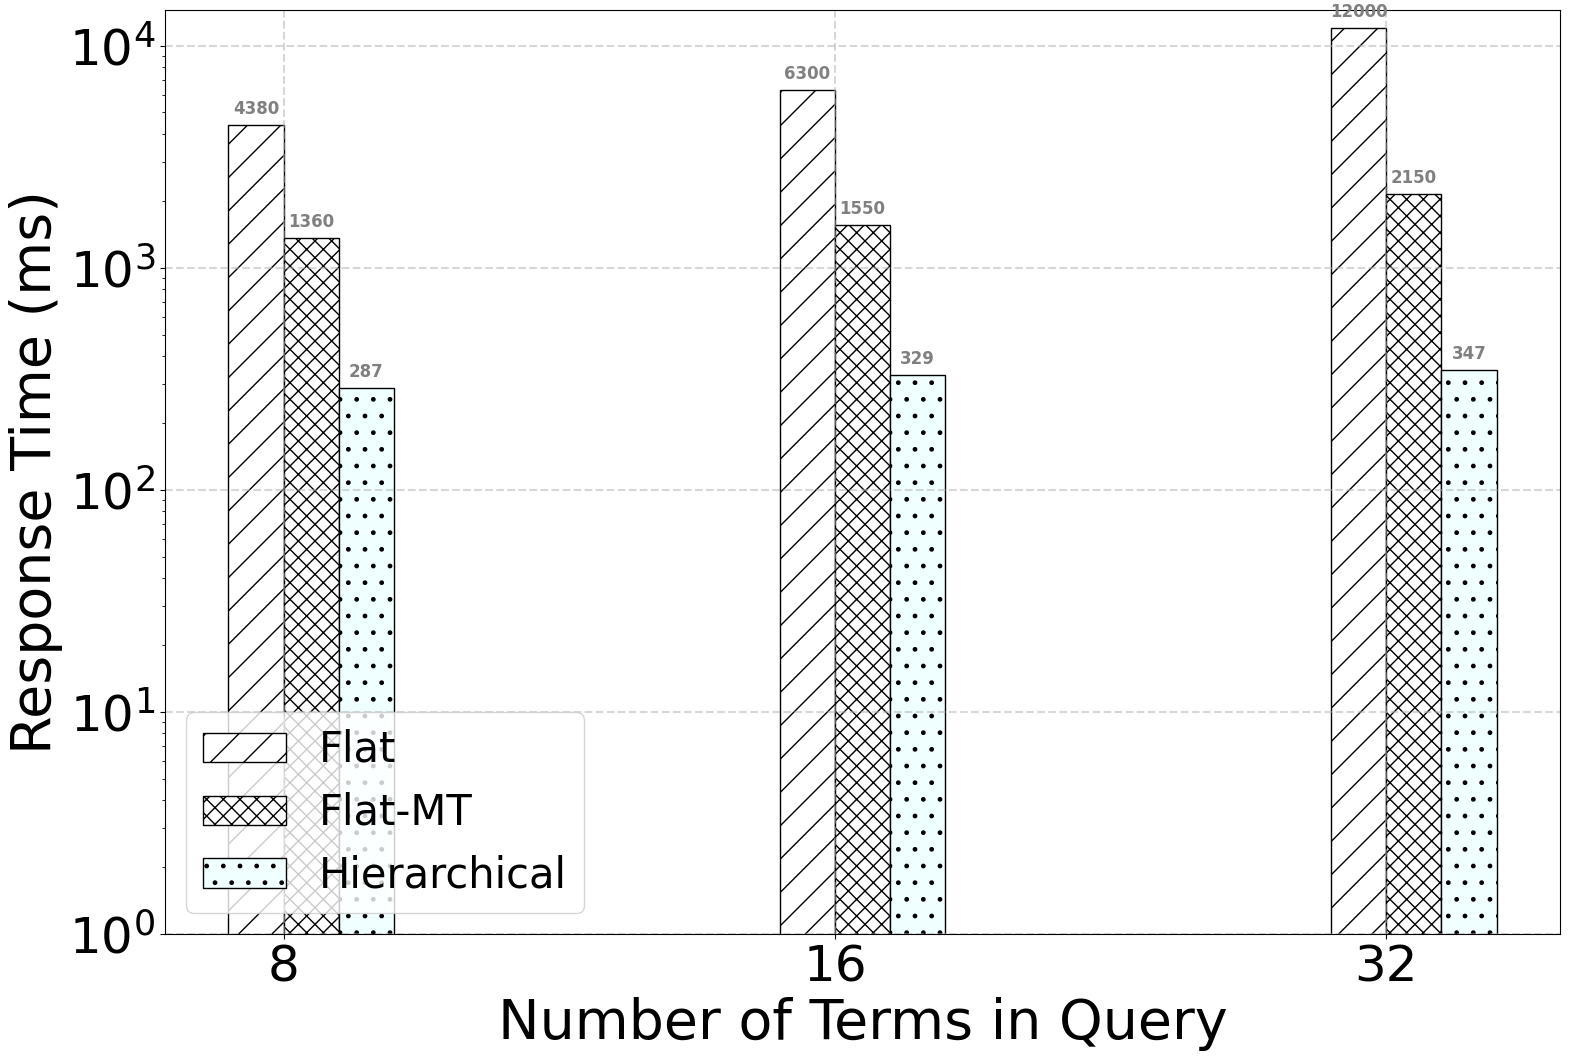
Figure 3. 10억 문서 실험에서 질의 길이별 단일 요청 지연을 비교한다. 세로축은 로그 척도의 밀리초다. 16단어 질의에서는 Hierarchical BM25가 329ms, 평면 멀티스레드 검색(Flat-MT)이 1,550ms였다. 32단어에서는 그림의 숫자가 347ms지만 본문은 387ms라고 보고한다. 출처: Deshpande & Sundararaman (2026), arXiv v1, p. 8, Figure 3.
2. 빠른 선택과 정확한 점수는 서로 다른 단계다
클러스터를 고를 때는 두 가지 신호를 합친다. 첫째는 그 묶음에 질의 단어가 전반적으로 많이 나타나는지다. 둘째는 중요한 질의 단어들이 같은 문서에 함께 나타나는지다. 이렇게 선택된 클러스터에 속한 문서는 전체 코퍼스의 문서 수와 단어 빈도 통계를 사용해 점수를 계산한다.
전역 통계를 공유하므로, 방문한 문서의 BM25 점수는 평면 색인에서 계산한 점수와 일치하도록 설계됐다. 하지만 라우터가 선택하지 않은 클러스터의 문서는 아예 비교 대상이 되지 않는다. 전체 검색 결과의 상위 문서가 그곳에 있으면 놓칠 수 있다. 블록 상한으로 불가능한 후보만 건너뛰는 BlockMax-WAND와 달리, 이 방식은 전역 top-k 순위의 완전성을 보존한다고 주장하지 않는다.
그 때문에 검색 후 다른 검색기나 재순위화기가 후보를 보완하는 시스템에 쓸 수 있다는 설명은 가능성이지, 논문이 측정한 결과는 아니다. dense 검색이나 재순위화기와 결합해 최종 답의 품질을 유지하는지 시험하지 않았다.
3. 논문이 보여 준 속도는 어느 조건에서 나왔나
저자들은 10억 문서, 64개 CPU 코어, NVMe SSD 8개 환경에서 검색 시간을 측정했다. 단일 요청 실험은 색인을 미리 캐시에 올리지 않은 조건이고, 8·16·32개의 단어를 사전에서 무작위로 뽑아 질의를 만들었다. 저자 보고 기준 8~16단어 질의는 대략 300ms, 32단어 질의도 약 350~390ms 수준이었다.
32단어 수치는 원문 안에서 서로 다르다. Figure 3은 347ms, 본문은 387ms라고 쓴다. 본문의 속도 배율과 QPS도 387ms와 더 잘 맞지만, 어느 하나를 오기로 확정할 자료는 없다. 숫자를 임의로 고치지 않고 둘 다 남겨야 한다.
동시 요청에서는 결과가 달라진다. Figure 5의 cold 조건 평균 지연은 요청이 많아지면 1초를 넘고 32개 요청에서 2초 이상으로 보인다. 캐시를 미리 데운 실험은 더 많은 요청을 처리하지만, 단일 cold 요청과 같은 조건은 아니다. 평균 응답 시간은 최악 지연 보장도 아니다. 따라서 약 300ms라는 단일 요청 결과만으로 모든 부하에서 1초 안에 끝난다고 말할 수 없다.
4. 검색 품질을 보여 주는 0.92는 재현율이 아니다
품질 실험은 10억이 아닌 50만 문서와 500개 클러스터에서 진행됐다. 저자들은 전체 평면 검색 결과와 비교해, Hierarchical BM25가 반환한 문서들의 BM25 점수 합이 얼마나 되는지를 측정했다. 클러스터의 5~10%를 방문했을 때 이 비율은 약 0.83~0.92였다.
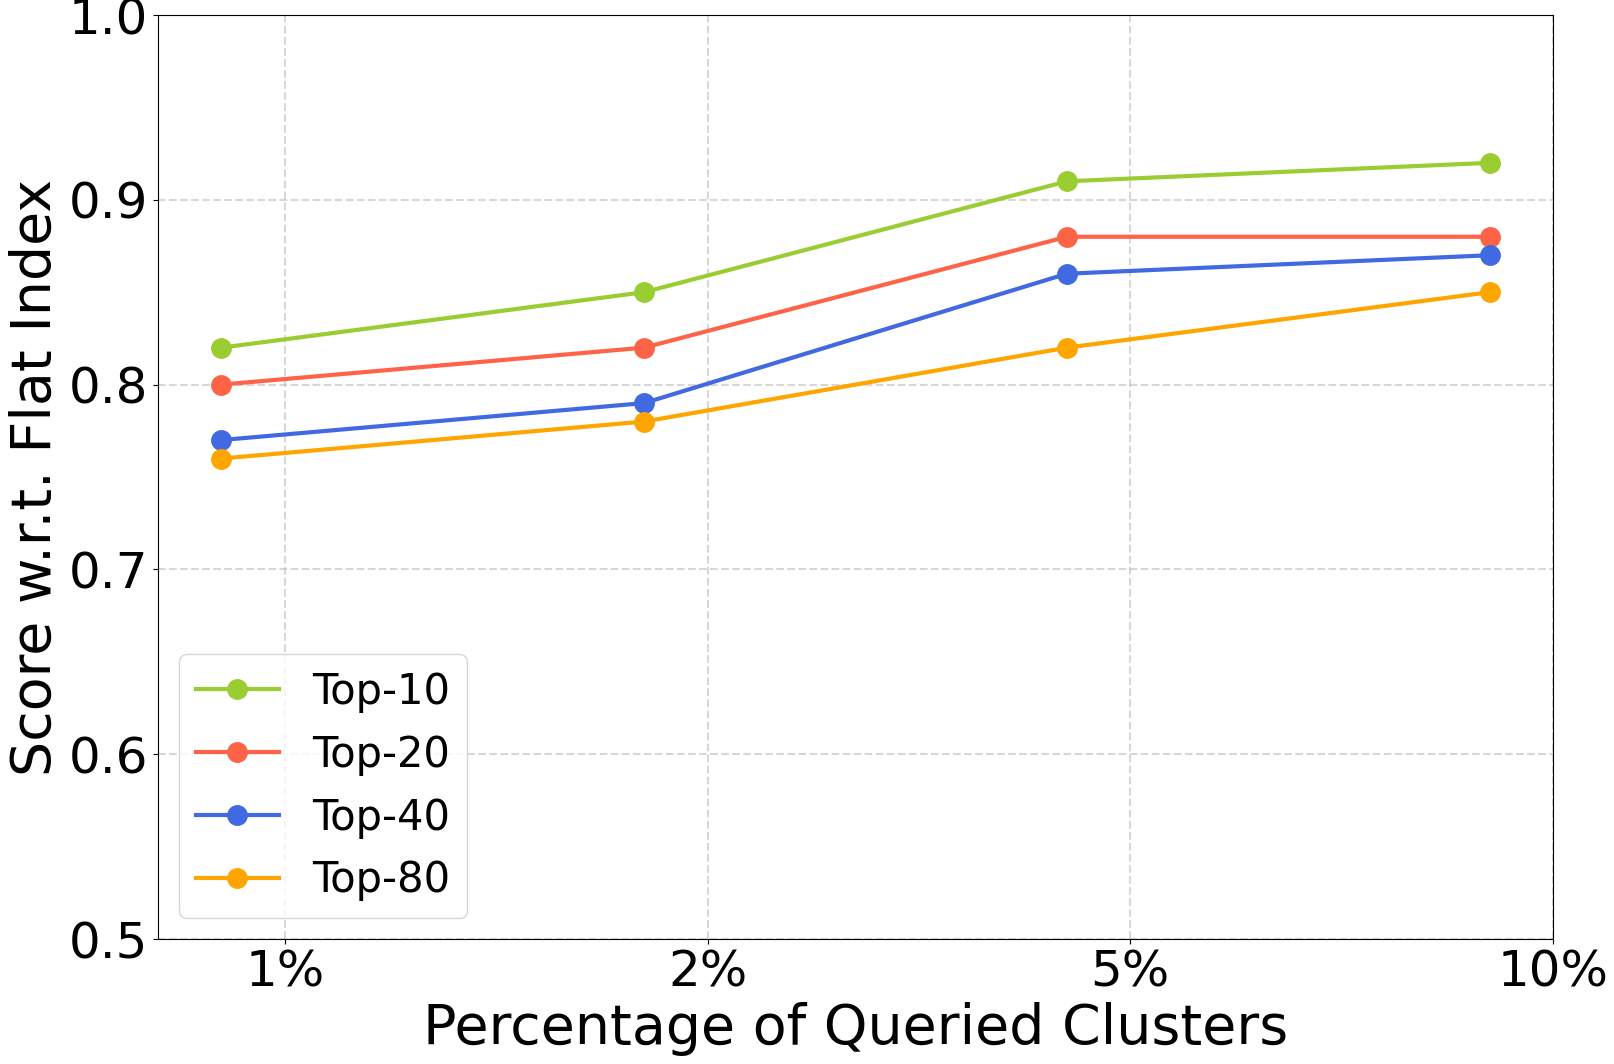
Figure 7. 방문 비율과 반환 깊이에 따른 전수 검색 대비 BM25 점수 합 비율이다. 이 값은 같은 문서를 몇 개 찾았는지, 사람이 관련 있다고 판단한 결과를 얼마나 찾았는지를 직접 재지 않는다. 출처: Deshpande & Sundararaman (2026), arXiv v1, p. 9, Figure 7.
점수 합이 92%라고 해서 정답 문서의 92%를 찾았다는 뜻은 아니다. 점수가 비슷한 다른 문서로 바뀌어도 합계는 높을 수 있다. 사람의 관련도 판단에 대한 nDCG도 보고되지 않았다. 또 50만에서 10억으로 커질 때 평균 클러스터 크기가 크게 달라지므로, 작은 실험의 품질이 그대로 유지된다고 가정할 수 없다.
논문의 Figure 8에는 별도의 recall 그래프도 있지만 기준 집합이 명확하지 않다. 본문 설명처럼 flat 결과 자체를 기준으로 삼았다면 flat은 100%여야 하는데 도표에서는 그렇지 않다. 따라서 이 그림에서 정확한 Recall@k나 보장된 문서 일치율을 읽기는 어렵다.
5. 메모리와 확장성도 측정 조건 안에서 읽는다
저자들은 10억 문서 운영점에서 약 4.4GB의 상주 공간을 보고한다. 이 수치는 400GB 전체 색인이 없어졌다는 뜻이 아니다. 정밀 색인은 디스크에 남고, 작은 라우팅 색인과 일부 캐시 등을 메모리에 둔다. 공출현을 세는 보조 색인의 공간이 전체 메모리 표에서 어떻게 분리되는지는 더 자세한 설명이 필요하다.
40개 클러스터를 고정해도 문서 수가 늘면 방문하는 전체 문서 수도 늘어난다. 같은 처리량을 유지하려고 클러스터 수를 늘리면 라우팅 데이터와 메타데이터도 커진다. 그래서 4.4GB와 300ms는 논문이 측정한 특정 운영 조건이지, 어떤 코퍼스·질의·동시성에서도 유지되는 상한은 아니다.
6. 어떤 상황에서 검토할 만한가
큰 역색인의 디스크 접근량이 병목이고, 전체 top-k를 항상 보존할 필요가 없는 서비스라면 주제별 라우팅은 유용한 후보 축소 방법일 수 있다. Hierarchical BM25가 보여 준 강점은 방문 범위를 줄여 측정한 조건에서 전수 ranked-OR보다 빠르게 검색했다는 점이다. 또 선택된 문서 안에서는 전역 BM25 통계를 사용해 점수를 정합적으로 계산한다.
그러나 최신 정확 검색기와 같은 품질에서 더 빠른지, 자연 질의에서도 품질이 유지되는지, 10억 문서에서 점수 비율이 유지되는지는 검증되지 않았다. 정확한 전체 top-k를 보장하는 BlockMax-WAND와 직접 비교도 없다. 따라서 이 논문은 “BM25 검색을 정확히 대체한다”기보다 빠른 근사 후보 검색을 위한 계층형 설계와 특정 조건의 성능 측정으로 읽는 것이 타당하다.
같이 읽기: ColPali 문서 검색 · H+ Embedding 검색과 재순위화
References
Deshpande, U., & Sundararaman, S. (2026). Hierarchical BM25: Lexical search at billion-document scale [Preprint]. arXiv. https://arxiv.org/abs/2608.00229v1