Hierarchical BM25: Lexical Search at Billion-Document Scale
Hierarchical BM25는 10억 문서 전체를 훑는 대신 주제별 클러스터를 먼저 골라 검색량을 줄인다. 방문한 문서의 BM25 점수는 정확히 계산하지만, 전역 정답 순위와 10억 문서에서의 품질은 보장하지 않는다.
Paper: Umesh Deshpande; Swaminathan Sundararaman (2026). Hierarchical BM25: Lexical Search at Billion-Document Scale. IBM Research, San Jose. arXiv:2608.00229v1. PDF · 서지 정보. 11쪽의 v1을 기준으로 읽는다. 원문 표기는 2026-07-31이며, 별도의 학회 게재는 확인하지 않았다.
Abstract: 10억 문서의 역색인을 매번 넓게 읽으면 디스크 접근량이 지연을 지배한다. Hierarchical BM25는 문서를 균형 잡힌 주제별 클러스터로 나누고, 작은 라우팅 색인이 고른 묶음만 정밀 검색한다. 핵심 교환은 명시적이다. 방문한 문서의 BM25 점수는 전역 통계로 정확히 계산하지만 방문하지 않은 묶음의 정답은 놓칠 수 있다. 저자들은 약 4.4GB 상주 공간과 단일 요청 약 300ms를 보고한다. 그러나 성능은 좁은 어휘와 무작위 질의 조건에서 측정됐고, 품질 평가는 50만 문서에서만 이루어졌다. 이 글은 집계와 공출현의 두 라우팅 신호, 전역 IDF의 역할, 메모리·지연 보장의 범위, 347/387ms의 원문 불일치와 recall 도표의 기준 집합 문제를 나누어 분석한다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 문제 | 10억 문서·약 400GB 역색인을 전수 ranked-OR로 검색할 때의 디스크 I/O 부담. |
| 방법 | 약 1,000개 균형 주제 클러스터 중 40개를 고른 뒤 해당 묶음에서 BM25를 계산한다. |
| 선택 신호 | 클러스터별 단어 집계 A와, 분산된 고-IDF 단어가 같은 문서에 나타나는지를 보는 B의 합. |
| 정확성 | 전역 N·df·평균 문서 길이를 공유해 방문 문서 점수를 맞춘다. 전체 top-k를 보존하는 rank safety는 포기한다. |
| 속도 | 16단어 질의는 Figure 3 기준 329ms. 32단어는 도표 347ms, 본문 387ms로 달라 관련 배율을 확정할 수 없다. |
| 품질 | 50만 문서에서 5–10% 클러스터를 방문하면 정답 리스트의 BM25 점수 합 대비 0.83–0.92. 이것은 Recall@k나 nDCG가 아니다. |
| 남은 검증 | 10억 문서 품질, 자연 어휘, B의 독립 기여, 재정렬한 BlockMax-WAND·MaxScore와의 비교. |
| 판단 | 선택적 검색의 비용 절감은 관찰됐다. 4.4GB·1초를 모든 규모·부하에서의 상한으로 읽거나 최신 정확 검색보다 우월하다고 결론내릴 근거는 부족하다. |
읽기 안내: 측정 수치는 저자 보고이며 모델·검색 실험은 재실행하지 않았다. 본문의 산술과 도판을 재확인했고, 원문 내부 불일치는 값을 임의로 수정하지 않고 병기한다.
목차
- 정확한 점수와 정확한 순위는 다르다
- 주제별로 나누되 큰 묶음을 만들지 않는다
- 집계 신호와 문서 공출현을 함께 쓴다
- 클러스터마다 다른 IDF를 쓰면 점수가 어긋난다
- 4.4GB와 고정 비용의 조건
- 긴 질의에서 BMW보다 유리하다는 논증의 범위
- 단일 요청과 동시 요청은 다른 결과다
- 0.92의 점수 비율이 92퍼센트 재현율은 아니다
- 논문이 인정한 한계와 추가 검토
- 빠른 근사 검색을 평가하는 데 필요한 비교
1. 정확한 점수와 정확한 순위는 다르다
BM25는 질의 단어별 IDF와 문서 내부 빈도·길이 정규화를 합쳐 문서를 채점한다. 일반적인 ranked-OR 검색에서는 질의 단어 하나라도 포함한 문서가 후보가 된다. 모든 후보를 채점하면 정확하지만, 코퍼스가 크고 질의가 길수록 읽어야 하는 posting이 많아진다.
BlockMax-WAND(BMW)는 점수 상한으로 top-k에 들 수 없는 구간을 건너뛴다. 정확한 순위를 보존한 채 계산을 생략하는 방식이다. Hierarchical BM25는 다른 선택을 한다. 유망해 보이는 클러스터만 방문하므로 실제 top-k 문서가 방문하지 않은 묶음에 있으면 놓친다.
| 방법 | 생략하는 대상 | 전수 검색과 같은 top-k 보장 |
|---|---|---|
| 전수 ranked-OR | 없음 | 있음 |
| BlockMax-WAND | 상한으로 탈락을 증명한 후보·블록 | 있음 |
| Hierarchical BM25 | 라우팅 점수가 낮은 클러스터 전체 | 없음 |
가령 전역 10위 문서를 놓치고 11위 문서를 돌려줄 수 있다. 이때 반환 문서의 점수 계산 자체는 정확해도 반환 집합은 정확하지 않다. 이 구분이 논문의 설계를 이해하는 출발점이다.
저자들은 hybrid retrieval의 후보를 reranker가 다시 고르므로 이런 교환이 실용적일 수 있다고 주장한다. 그러나 dense 검색·reranker·최종 RAG 답 품질을 함께 측정하지는 않았다. ‘후보 하나가 바뀌어도 최종 답은 같을 것’이라는 직관은 동기이지 결과가 아니다.
2. 주제별로 나누되 큰 묶음을 만들지 않는다
2.1 Level-1은 라우팅, Level-2는 실제 문서 검색이다
| 구성 | 대상 | 저자 보고 크기 | 배치 |
|---|---|---|---|
| 평면 색인 | 10억 문서 | 약 400GB | 디스크 |
| Level-1 | 약 1,000개 문서 묶음 | 약 4GB | 상주 |
| Level-2 | 전체 문서별 통계 | 총 약 400GB | 약 400MB 캐시 + NVMe |
| 전역 통계 | 약 20,680개 단어의 df 등 | 약 100KB | 상주 |
Table 3, p. 3. 상주량과 전체 저장량을 구분한다.
질의당 상위 40개 클러스터를 선택한다. 균등 분할이라면 전체의 약 4%다. 전체 Level-2 색인이 사라지거나 4.4GB로 압축되는 것이 아니다. 400GB 규모의 정밀 색인은 디스크에 남고, 그중 읽을 범위를 줄인다.
2.2 LDA 표현과 용량 제한 할당
문서를 무작위나 유입 순서로 나누면 모든 묶음의 단어 분포가 비슷해져 라우팅할 근거가 사라진다. 저자들은 LDA의 토픽 비율 벡터를 사용하고, 매우 흔한 단어와 희귀한 꼬리를 제외한 중간 IDF 대역 약 10K 단어로 주제를 표현한다.
단순히 가장 확률이 높은 토픽에 문서를 모두 넣으면 인기 주제에 거대 클러스터가 생긴다. 그래서 용량 제한 할당과 overflow splitting으로 크기를 맞춘다. 최선의 클러스터가 차면 다음 후보로 보내므로 주제 순수성과 크기 균형 사이에 교환이 생긴다.
실험 어휘는 20,680개로 제한되어 있고 자연스러운 희귀 꼬리가 없다는 점을 뒤에서 다시 본다. 따라서 중간 빈도 특징을 사용하는 설계의 자연 코퍼스 효과와 이 벤치마크에서 측정한 속도는 같은 증거가 아니다.
2.3 증분 분할은 전체 재클러스터링을 없애지 않는다
코퍼스가 커지면 목표 크기를 넘는 묶음을 이미 저장한 토픽 벡터의 보조 주제에 따라 분할한다. 부모 posting만 다시 나누고 자식 Level-1 통계를 갱신하므로 다른 클러스터는 건드리지 않아도 된다. 기존 문서 집합의 분할만 바뀐다면 전역 df 합은 그대로다. 문서 추가로 N·df가 바뀌는 경우와는 구분해야 한다.
저자들은 분할만으로 문서가 다른 계보의 클러스터로 이동하지 못해 주기적 전체 재클러스터링은 여전히 필요하다고 명시한다(p. 4). 실제 업데이트 비용·중단 시간·동시 갱신 프로토콜은 별도 측정하지 않았다.
3. 집계 신호와 문서 공출현을 함께 쓴다
3.1 A: 클러스터 전체에 얼마나 많이 나타나는가
클러스터 c 안에서 단어 t의 총 출현 횟수, 즉 collection frequency를 f_c(t)라고 하자. Level-1은 빈도가 높은 단어를 유지하고 다음 가중치를 저장한다.
w_c(t)=\big(\log_2\max(f_c(t),1)\big)^2,\qquad
A(c,Q)=\sum_{t\in Q}\mathrm{idf}(t)w_c(t).
여기서는 단어를 포함한 문서 수 df가 아니라 전체 출현 횟수의 합을 집계한다. BM25 자체의 유한 상한 TF 포화와 같은 함수도 아니다. log 제곱은 원시 빈도보다 느리게 증가하지만 무한히 증가한다.
A는 주제 단어가 많은 묶음을 찾지만, 여러 질의 단어가 같은 문서에 있는지는 모른다. 단어 a가 문서 1에, b가 문서 2에 있어도 둘을 같은 문서가 포함한 경우와 구분하기 어렵다. 또한 여러 단어가 조금씩 있는 묶음이 한 단어가 아주 강한 묶음을 항상 이긴다는 보장도 이 합의 식에는 없다.
3.2 B: 의미 있는 단어들이 같은 문서에서 만나는가
B는 A가 놓치기 쉬운 단어에 집중한다. IDF는 높지만 여러 클러스터에 널리 흩어진 단어다. 특정 묶음에 집중된 단어는 A만으로도 그 묶음을 찾기 쉬운 반면, 흩어진 단어는 어느 한 묶음의 집계 점수도 충분히 올리지 못할 수 있다.
추적할 단어 집합 T_M은 \mathrm{idf}(t)H_{\mathrm{clu}}(t)가 높은 M개다. H_{\mathrm{clu}}는 클러스터별 df 분포의 엔트로피이며 M=1,000을 사용한다. posting은 (문서 ID, 클러스터 ID)를 저장하고 문서 ID순으로 정렬한다.
Q_M=Q\cap T_M,\qquad
B(c,Q)=\max_{d\in c}\sum_{t\in Q_M\cap d}\mathrm{idf}(t).
질의의 추적 단어 posting을 문서 ID로 합쳐 동일 문서의 IDF 합을 구하고, 클러스터별 최댓값을 취한다. 이것은 샘플 문서가 아닌 해당 단어들의 전체 posting에서 계산한 값이다. 다만 B의 정확한 계산은 BM25 점수 상한이나 정답 클러스터의 보존과 다르다. B에는 전체 질의의 모든 단어, 문서 길이, BM25 TF 포화가 들어가지 않는다.
3.3 두 신호의 결합도 여전히 휴리스틱이다
\mathrm{Score}(c,Q)=A(c,Q)+\lambda B(c,Q).저자들은 \lambda=1을 시작점으로 제안하며 경험적 조정은 남겨 둔다. 둘 다 IDF를 포함한다고 수치 규모가 자동으로 맞는 것은 아니다. A는 log 제곱 집계 가중치를 곱하고 B는 문서별 IDF 합이므로 상대 기여는 분포와 계수에 달려 있다.
B를 더해도 T_M 밖의 단어가 만드는 A의 잡음은 남는다. 추적 대상이 아닌 단어들만으로 높은 BM25를 얻는 문서가 낮은 라우팅 점수의 클러스터에 있을 수도 있다. 저자들도 M·가중치 민감도 실험과 B의 독립 품질 효과를 아직 측정하지 않았다고 밝힌다(pp. 7–8).
선택적 검색 자체는 새 골격이 아니다. 논문은 Selective Search와 주제별 shard를 고르는 구조를 공유한다고 인정한다. CORI·Taily의 집계 통계, ReDDE의 일부 문서 샘플과 비교해 추적 단어의 동일 문서 공출현을 전수로 보려는 점을 차별화한다. 그러나 이 선택기들과의 직접 효과 비교도 남아 있다.
4. 클러스터마다 다른 IDF를 쓰면 점수가 어긋난다
독립 BM25 색인은 보통 자신이 가진 문서 수와 df로 IDF를 계산한다. 하지만 한 주제에 집중된 묶음에서는 그 주제 단어가 흔해 보인다. 전체에서는 희귀한 단어라도 로컬 IDF가 낮아질 수 있다. 서로 다른 기준으로 계산한 점수를 단순히 합쳐 정렬하면 전역 BM25와 다른 문제가 된다.
BM25 점수는 단어별 기여의 합이므로 클러스터 전체에 상수 하나를 곱하는 사후 보정으로는 단어마다 다른 IDF 오차를 일반적으로 복구할 수 없다. 저자들은 다음 전역 통계를 공유한다.
- 전체 문서 수 N
\mathrm{df}(t)=\sum_c\mathrm{df}_c(t)- 전역 평균 문서 길이 avgdl
실제 문서의 TF와 길이는 로컬에 그대로 있다. 같은 토큰화·BM25 공식·k_1,b·길이 정의를 사용하는 조건에서 이 전역 통계를 적용하면 방문 문서의 점수는 평면 색인의 점수와 같다. 방문한 클러스터별 top-k를 합쳐 정렬하면 방문 문서 집합의 top-k를 얻는다. 방문하지 않은 곳의 더 좋은 문서를 복원하지는 않는다.
이 처리는 정확성을 위해 중요하지만, 협력하는 단일 소유자 shard들이 통계를 공유하는 원리 자체가 새 발명인 것은 아니다. 논문도 관련 연구에서 이를 통상적인 비교 가능 점수 계산으로 인정한다(p. 2). 여기의 ‘버그 수정’은 로컬 통계를 전역 기준처럼 합치던 설계의 문제를 고쳤다는 범위로 읽는 편이 정확하다.
5. 4.4GB와 고정 비용의 조건
5.1 고정한 것은 방문 클러스터 수다
균형 분할에서 방문 가능한 문서 규모는 대략 다음과 같다.
W_{\mathrm{visited}}\approx k_{\mathrm{clu}}\frac{N}{K}.이는 방문 영역의 크기이지 모든 문서가 실제 posting 후보로 채점된다는 뜻은 아니다. k_{\mathrm{clu}}=40, N=10^9, K=1,000이면 약 4천만 문서의 영역이다. K를 고정한 채 N이 두 배가 되면 방문 영역도 두 배가 된다. 일을 유지하려면 K도 늘려야 하며 Level-1과 클러스터 핸들 등의 비용이 따라 증가한다.
초록·§1은 메모리가 코퍼스 크기와 무관하고 지연도 구조적 상한이라고 강조한다. 그러나 §6은 4.4GB와 1초 미만이 모두 측정한 10억 문서 운영점의 수치이며 규모 독립적인 점근 성질은 아니다라고 제한한다. 이 후자의 설명을 기준으로 읽어야 한다.
5.2 라우팅도 질의 길이와 무관하지 않다
A의 계산은 질의 단어마다 약 K개 클러스터 가중치를 누적하므로 대략 O(qK)다. B가 다루는 posting 양은 다음 값에 의존한다.
P_B(Q)=\sum_{t\in Q\cap T_M}\mathrm{df}(t).M이 고정되어도 질의에 포함된 추적 단어 수가 늘면 비용이 늘 수 있고, 코퍼스가 커져 df가 증가하면 저장량과 검색량도 커진다. ‘방문 클러스터 수가 고정’과 ‘전체 검색 비용이 q·N에 독립’은 다른 주장이다. 같은 개수의 추적 단어라도 빈도에 따라 비용이 다르다.
5.3 공출현 색인과 OS 캐시의 메모리 회계가 필요하다
Table 3은 Level-1 4GB, Level-2 캐시 400MB, 전역 표 100KB를 나열하지만 B의 문서별 posting 저장량을 별도 항목으로 분해하지 않는다. 이것이 4GB에 포함되는지, 추가 작업 메모리와 함께 얼마나 차지하는지 재현 가능한 상세 회계가 필요하다. 실제 저장량은 \sum_{t\in T_M}\mathrm{df}(t)와 posting 표현 방식에 달려 있다.
구현 설명은 각 클러스터의 핸들을 미리 열고 파일을 memory-map하며 OS page cache를 이용한다고 적는다. 명시적인 posting별 LRU는 쓰지 않는다(p. 6). 그러나 memory mapping과 OS의 통상적 캐시 회수만으로 요청당 최악 paging량이나 프로세스 전체 RSS의 특정 상한이 자동 증명되지는 않는다. 캐시 제한의 강제 방식, 동시 질의 작업 공간, 핸들·메타데이터 포함 여부를 구분해야 한다.
‘400GB→4.4GB, 약 90배’도 전체 평면 색인을 메모리에 올리는 경우와 계층형의 상주 예산을 비교한 수치다. 실험의 평면 기준선은 디스크 상주 색인이므로 두 실행 프로세스의 실측 RSS가 각각 400GB와 4.4GB였다고 바꾸면 안 된다.
6. 긴 질의에서 BMW보다 유리하다는 논증의 범위
6.1 무작위 독립 단어 모델의 후보 집합
논문은 단어 하나를 포함할 확률을 p\approx0.005로 두고 독립 단어 q개의 OR 후보 비율을 계산한다.
\Pr(\text{하나 이상 일치})=1-(1-p)^q.N=10억일 때 8/16/32단어의 후보는 약 3,931만/7,707만/1억 4,820만 문서다. 원문의 39M/77M/148M과 맞는다. 긴 질의가 전수 ranked-OR의 후보량을 늘린다는 설명에는 유용하다.
하지만 이 수치는 posting 합집합의 크기이지 BMW가 실제로 평가하거나 방문해야 하는 문서 수의 하한이 아니다. BMW는 블록 상한과 현재 top-k 임계값으로 구간을 생략한다. 단어 간 상관, TF·문서 길이, ID 배치와 상한의 타이트함이 실제 실행량에 영향을 준다. OR 후보가 많다는 식 하나로 BMW의 시간복잡도나 열세를 입증할 수는 없다.
6.2 관련도보다 접근 영역을 먼저 줄이는 설계
A는 단어가 같은 문서에서 만나지 않아도 클러스터 전체의 단일 단어 집중도를 이용한다. 저자들은 이 신호가 긴 비상관 질의에서 유리하다고 주장한다. 동시에 관련 없는 단어가 많아지면 A의 신호 대 잡음비가 대략 1/\sqrt q로 낮아질 수 있다는 거친 분석도 제시한다. B는 그 약점을 보완하려는 장치다.
중요한 것은 이 절이 같은 정확도에서의 시간 비교가 아니라는 점이다. BMW는 rank-safe이고 제안 방법은 아니다. BMW가 느리더라도 더 정확한 일을 하고 있다면 속도 비율만으로 우월성을 판단하기 어렵다.
저자들은 문서 ID를 주제별로 재정렬하는 recursive graph bisection이 BMW의 생략 성능을 바꿀 수 있고, 긴 disjunction에서 MaxScore가 다른 행동을 보인다고 명시한다. 재정렬한 BMW·MaxScore와의 직접 비교는 수행하지 않았다. 이 부분은 기계적 작동 원리에 대한 가설이지 검증된 경쟁 결과가 아니다.
7. 단일 요청과 동시 요청은 다른 결과다
7.1 실험은 큰 규모지만 자연 검색 질의는 아니다
| 항목 | 조건 |
|---|---|
| 규모 | 10억 문서, 약 1,000개 균형 클러스터 |
| 방문량 | 상위 40개, 약 4% |
| 하드웨어 | 64 AMD EPYC 7343 CPU cores, Intel P5500 NVMe 8개 RAID-0 |
| 질의 | 사전에서 무작위로 뽑은 8·16·32단어 |
| 어휘 | 약 20,680개, 평균 df 약 500만 |
| 단일 요청 캐시 | 사전 warming 없이 디스크에서 읽는 조건 |
| 기준선 | 같은 코퍼스의 단일 스레드·멀티스레드 전수 ranked-OR |
저자 보고, §5.1, p. 8. Dense 검색과 질의 확장은 결합하지 않았다.
자연 코퍼스보다 어휘가 매우 좁고 흔한 단어가 많다. 무작위 질의는 디스크 fan-out을 크게 만드는 stress test지만, 주제 기반 라우팅과 B의 실제 관련도 효과를 보여 주는 질의는 아니다. 저자들도 자연 어휘 코퍼스에서의 검증을 남은 과제로 인정한다.
7.2 Figure 3의 숫자와 본문은 32단어에서 다르다
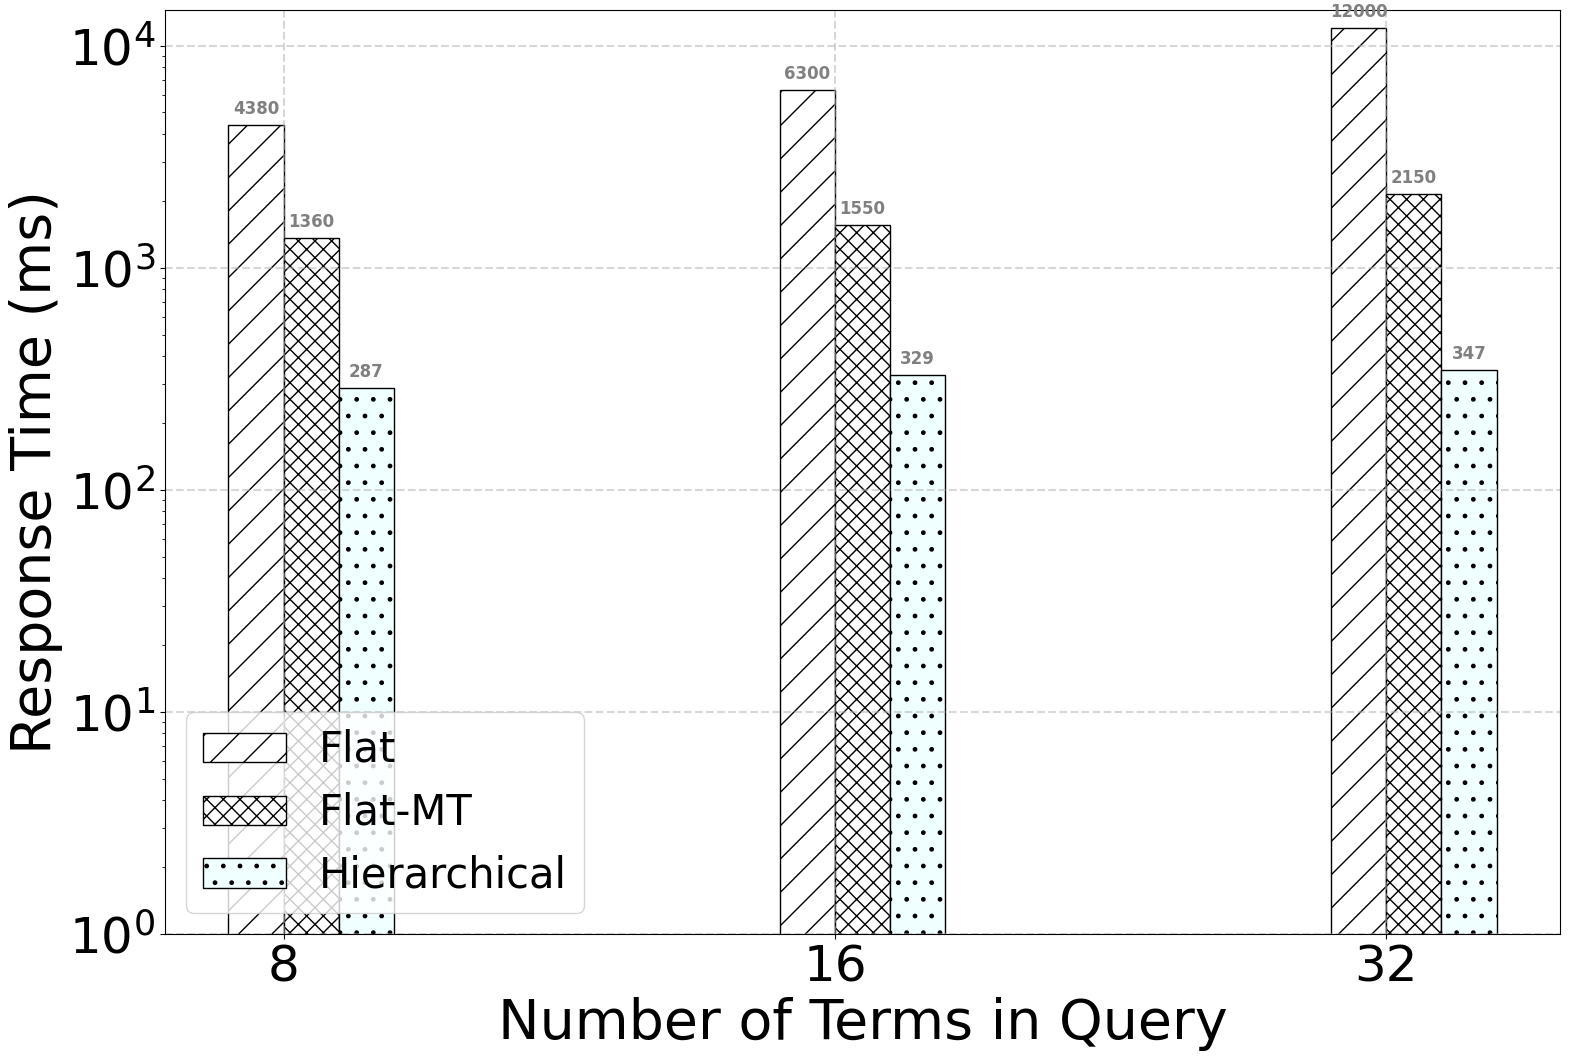
Figure 3. 세로축은 ms의 로그 척도다. 32단어 Hierarchical 막대의 숫자는 347로 표시되어 있으나 §5.2 본문은 387ms를 보고한다. 출처: Deshpande & Sundararaman (2026), v1, p. 8, Fig. 3 — 연구·학습 목적 인용.
| 질의 단어 수 | Flat | Flat-MT | Hierarchical |
|---|---|---|---|
| 8 | 4,380ms | 1,360ms | 287ms |
| 16 | 6,300ms | 1,550ms | 329ms |
| 32 | 12,000ms | 2,150ms | 그림 347ms / 본문 387ms |
원문 그림의 숫자 라벨을 직접 전사했다. 32단어의 두 값을 병기한다.
8단어의 Flat-MT 대비 배율은 1,360/287≈4.74, 16단어는 1,550/329≈4.71이다. 32단어는 그림 값을 쓰면 2,150/347≈6.20배, 본문 값을 쓰면 2,150/387≈5.56배다. 원문의 ‘4.7–5.6배’는 후자와 맞는다.
Figure 4는 별도 실험이 아니라 지연에 \mathrm{QPS}=1000/\mathrm{ms}를 적용한 그림이라고 명시한다. 347ms면 약 2.88QPS, 387ms면 약 2.58QPS이며 원문의 2.6QPS·지연 증가 1.35배는 387ms와 맞는다. 원시 로그가 없으므로 347을 오기로 확정하거나 임의 수정하지 않는다. 이 불일치가 약 300ms 수준의 결과 자체를 없애지는 않지만, 끝점의 속도 배율은 달라진다.
7.3 동시 요청에서는 cold 지연이 1초를 넘는다
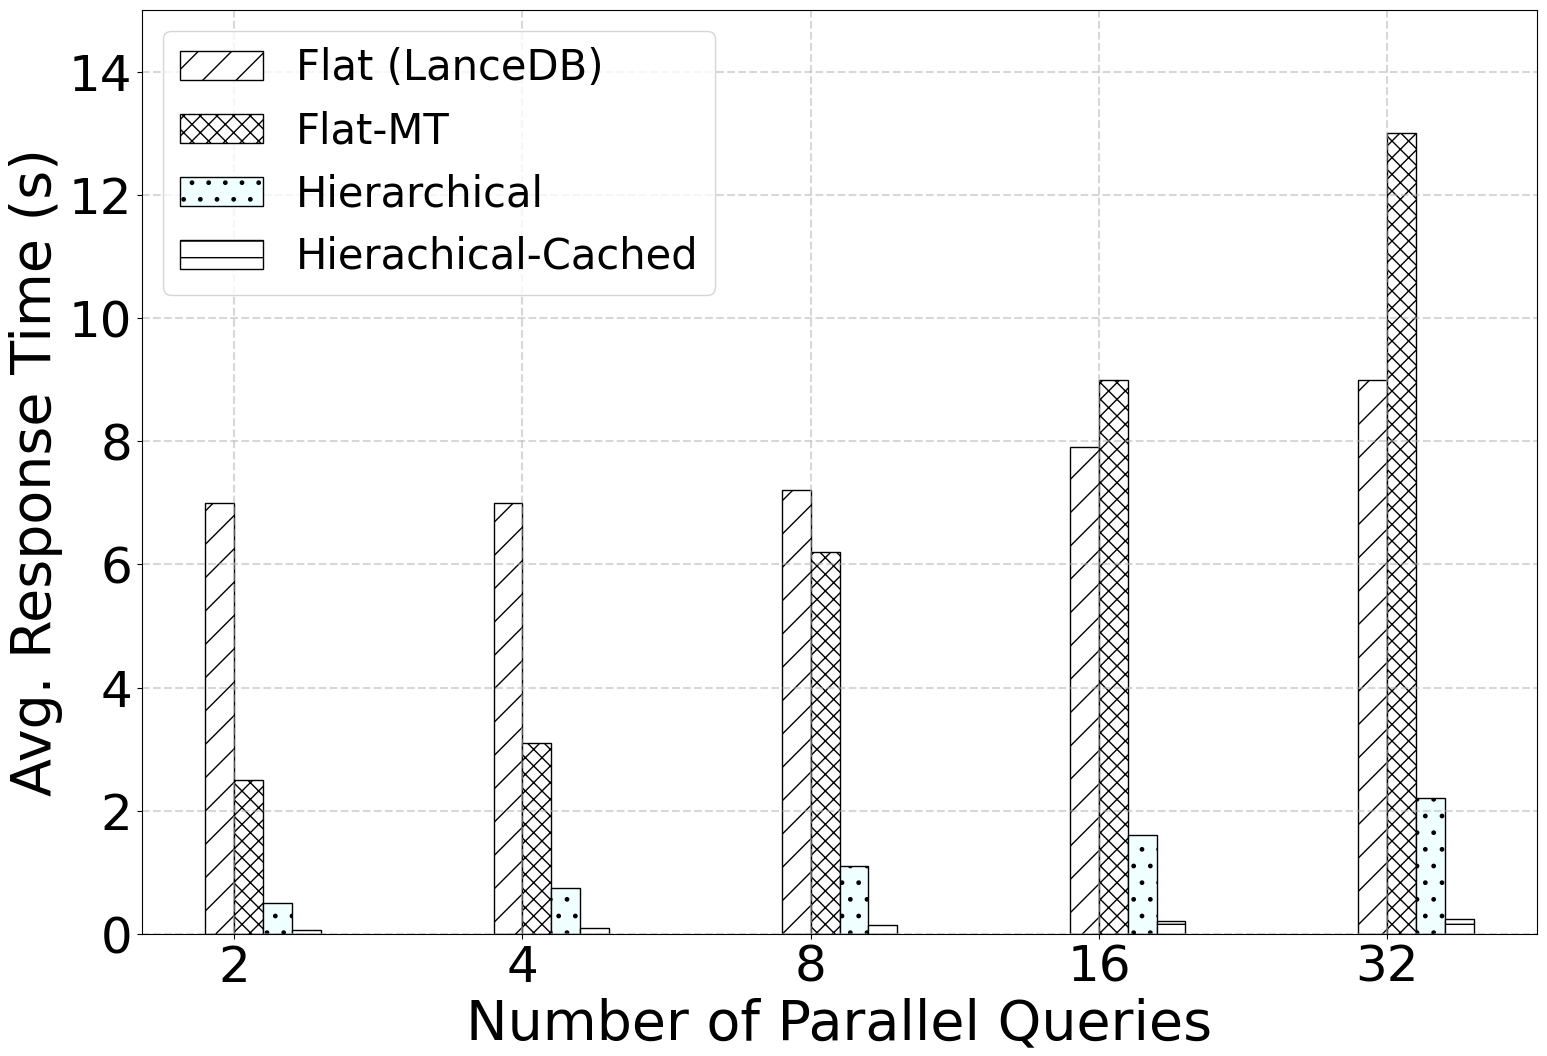
Figure 5. 세로축은 초이며 평균 응답 시간이다. Hierarchical과 Hierarchical-Cached를 구분한다. 출처: Deshpande & Sundararaman (2026), v1, p. 9, Fig. 5 — 연구·학습 목적 인용.
Figure 5 캡션은 Hierarchical이 코어 포화 전까지 단일 요청 지연에 가깝다고 설명한다. 그러나 cold Hierarchical 막대는 요청 수가 많아지면 1초를 넘고 32개 동시 요청에서 대략 2초 이상이다. 숫자 라벨이 없어 이를 정밀 측정값으로 전사하지는 않는다. 적어도 이 그림은 ‘모든 lexical 질의가 1초 미만이라는 hard guarantee’를 부하와 무관하게 적용할 근거가 아니다.
평균도 tail bound가 아니다. P95·P99·최대 지연, 측정 반복과 분포, 요청 도착 과정이 없으므로 약 300ms 단일 요청 결과를 부하 조건 전체의 deadline 보장으로 해석할 수 없다.
7.4 32QPS는 warmed cache의 다른 조건이다
저자 보고에 따르면 32개 병렬 요청에서 cold Hierarchical은 약 10.9QPS, warmed Hierarchical-Cached는 약 25–32QPS 수준이다. flat 계열은 3QPS 미만이다(Figure 6, §5.3). warmed 결과는 앞선 트래픽으로 캐시가 채워진 steady state이며 단일 요청 cold 수치와 같은 조건이 아니다.
일반적인 처리량 비교에서 큐잉·배치 완료 시간·요청별 평균 응답 시간은 다르다. 이 논문의 동시 요청 그림 둘을 임의로 동시 요청 수/평균 지연으로 맞춰 원시 값을 복원하지 않는다. 더불어 flat에 대해서도 같은 warming 정책을 적용한 대조가 제시되어 있지 않아 warmed 배율에는 구조와 캐시 상태의 영향이 함께 들어갈 수 있다.
8. 0.92의 점수 비율이 92퍼센트 재현율은 아니다
8.1 품질 실험은 50만 문서다
품질 평가는 N=500,000, K=500에서 수행했다. 방문 비율 1–10%, 결과 깊이 top-10~top-80을 바꾼다. 주요 지표는 다음 비율이다.
\mathrm{ScoreRatio}@k=
\frac{\sum_{d\in\mathrm{TopK}_{\mathrm{hier}}}S(d,Q)}
{\sum_{d\in\mathrm{TopK}_{\mathrm{flat}}}S(d,Q)}.
가까운 점수의 다른 문서로 대체돼도 이 비율은 높게 남을 수 있다. 따라서 같은 문서를 몇 개 되찾았는지, 사람이 관련 있다고 평가한 문서를 얼마나 찾았는지와 다르다. 1.0이라도 점수 동률 문서의 ID가 같다는 보장은 없다.
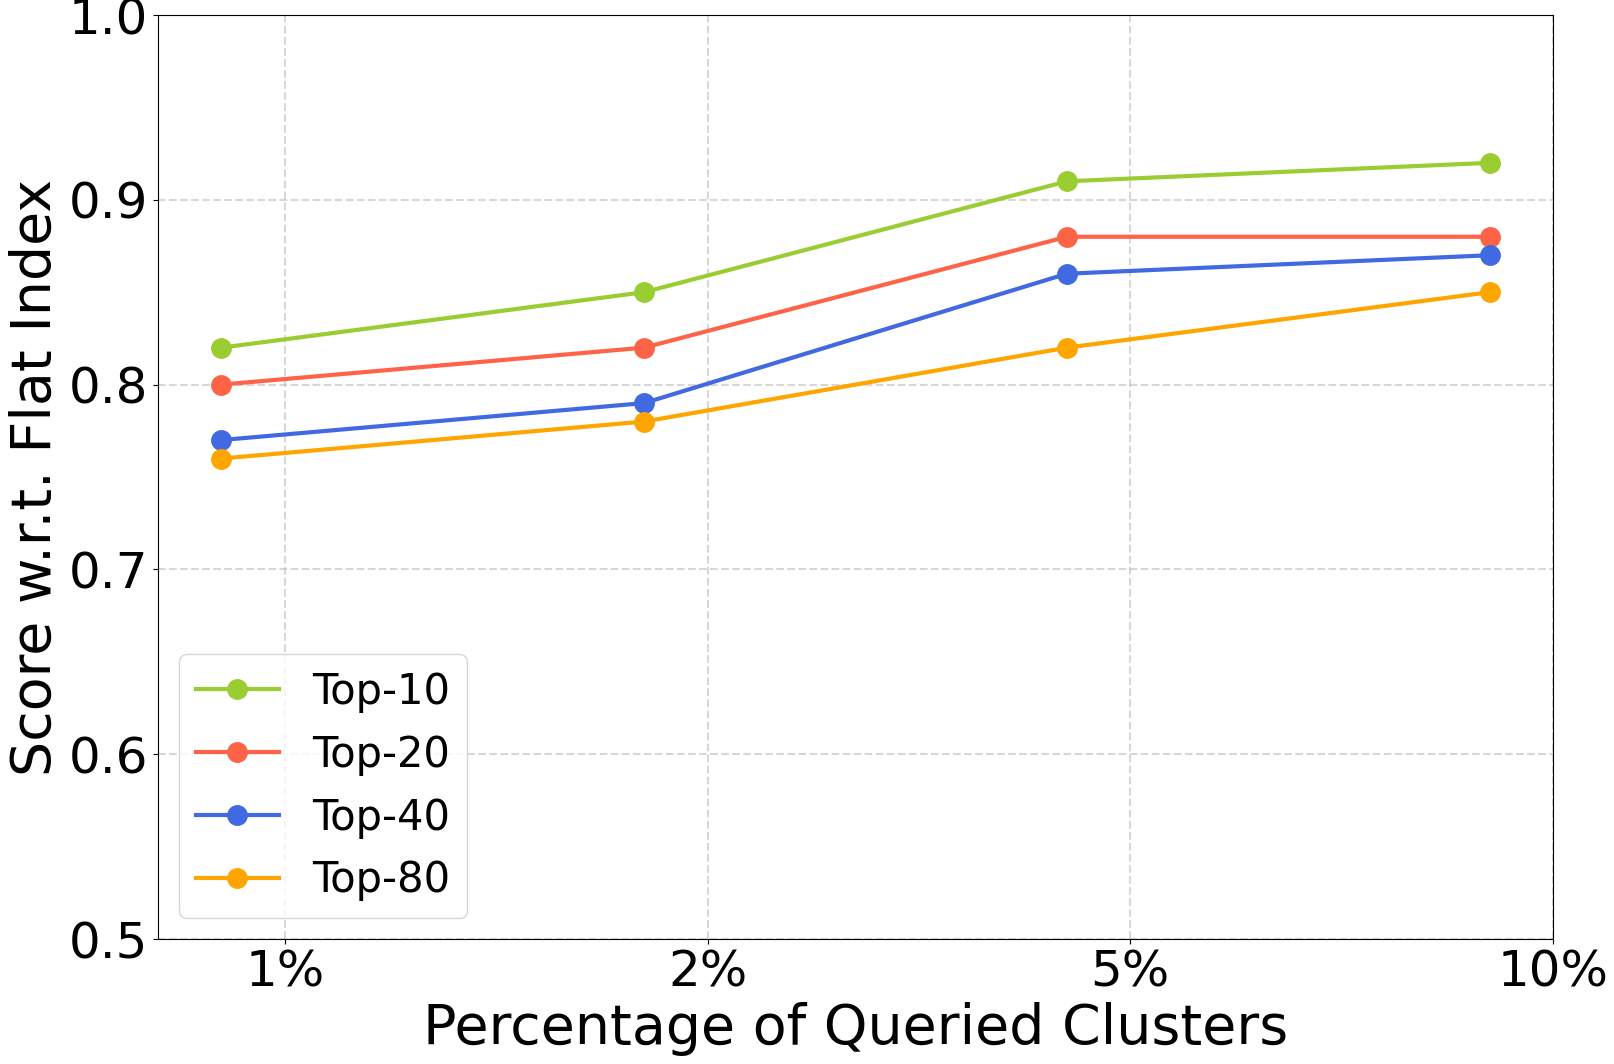
Figure 7. 세로축은 전수 검색 대비 BM25 점수 합 비율이다. top-10·20·40·80을 비교하며, 문서 ID 일치율이 아니다. 출처: Deshpande & Sundararaman (2026), v1, p. 9, Fig. 7 — 연구·학습 목적 인용.
| 방문 비율 | 원문이 보고한 점수 비율 범위 |
|---|---|
| 1% | 0.76–0.83 |
| 5% | 0.83–0.91 |
| 10% | 0.85–0.92 |
10% 방문에서 top-10은 0.92, top-80은 0.85다. 깊은 리스트의 중간 점수 문서는 더 많은 클러스터에 퍼져 있을 수 있다는 해석과 맞는다. 그러나 사람이 매긴 relevance의 nDCG는 어느 규모에서도 측정하지 않았다.
50만에서 10억으로 N은 2,000배지만 K는 500→약 1,000으로 두 배뿐이다. 평균 클러스터 크기는 1,000→100만 문서로 약 1,000배가 된다. 방문 비율 4%가 작은 실험 곡선의 1–5% 구간에 있다는 사실만으로 큰 규모의 품질이 같아진다고 추정할 수는 없다.
8.2 Figure 8의 recall 기준은 설명이 더 필요하다
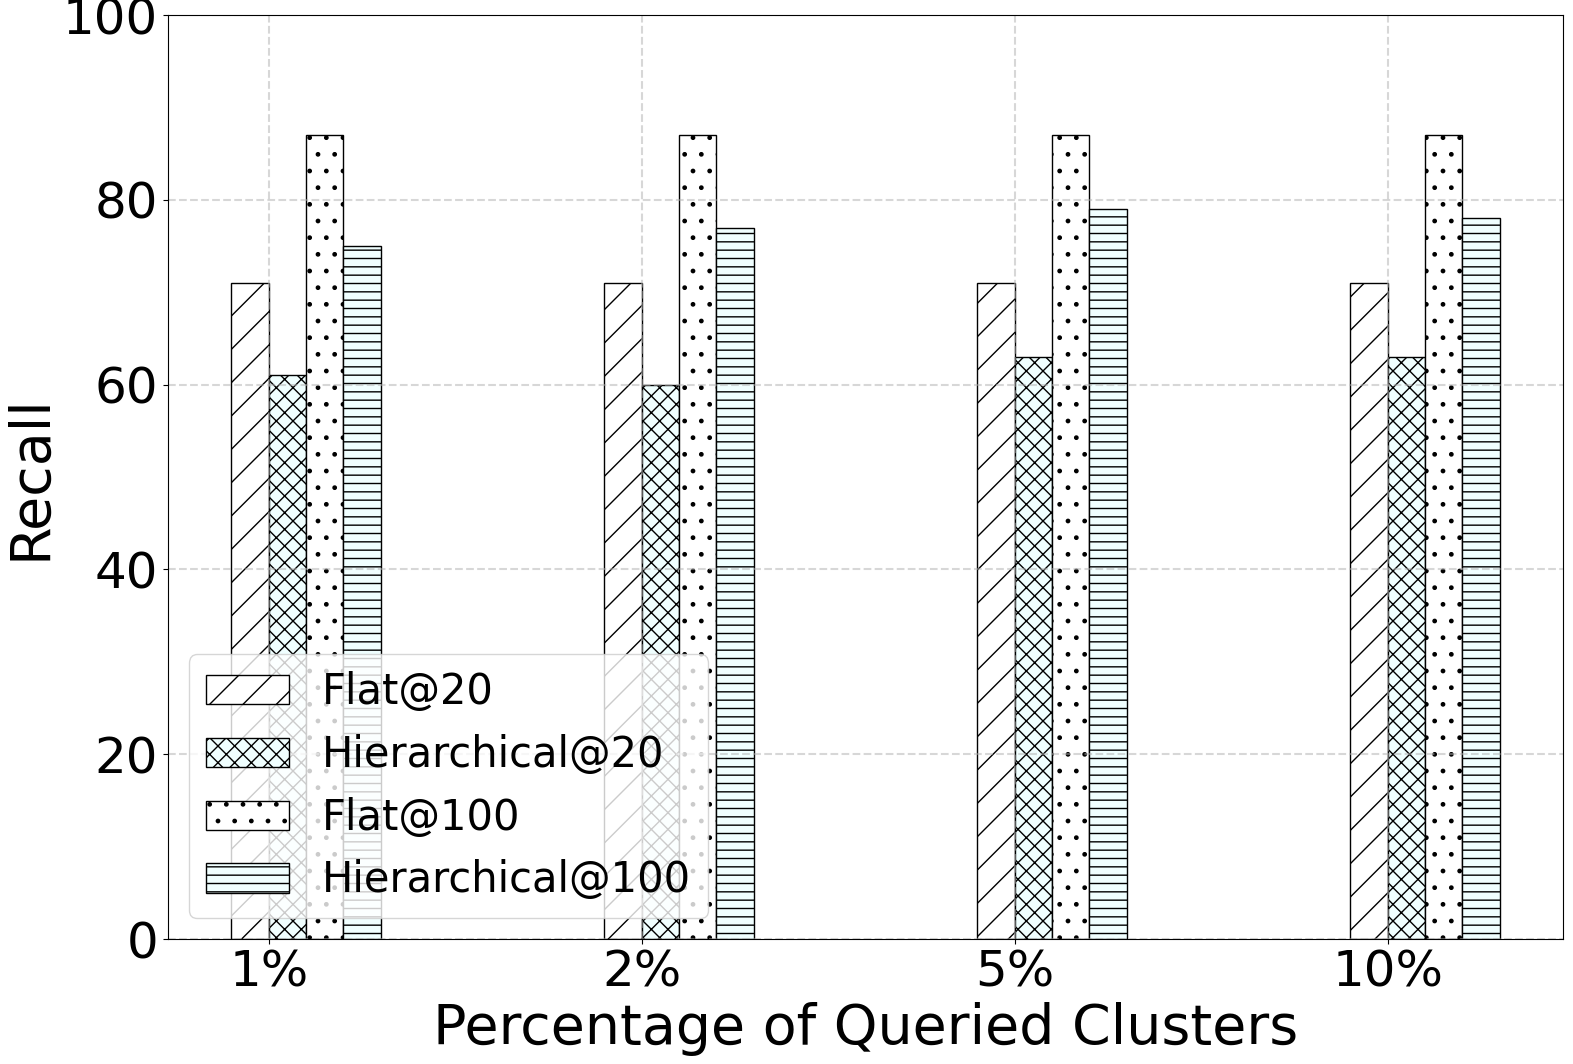
Figure 8. Flat@20과 Flat@100 막대도 100%보다 낮다. 이는 본문의 ‘flat 결과 리스트 자체에 대한 recall’ 설명과 바로 맞지 않는다. 정확한 분모·기준 집합이 없어 이 도표를 top-k 문서 일치율로 재해석하지 않는다. 출처: Deshpande & Sundararaman (2026), v1, p. 10, Fig. 8 — 연구·학습 목적 인용.
§5.4는 두 번째 지표를 깊이 20·100에서 flat 자신의 결과 리스트에 대한 recall이라고 설명한다. 그 정의를 같은 깊이의 자기 자신에게 적용하면 flat은 100%여야 한다. 그런데 도표의 flat 막대는 대략 70%대와 80%대다. 더 큰 참조 집합이나 별도의 정답 집합을 사용했다면 가능한 모양이지만, 그런 분모는 명시되지 않는다.
따라서 ‘flat의 recall에 가까워진다’는 도표의 상대 비교와 ‘flat top-k를 거의 모두 복원한다’는 주장은 분리해야 한다. 잘못된 데이터라고 단정할 수는 없지만, 지표 정의를 확인하기 전에는 이 그림으로 정확한 Recall@k나 품질 보장을 말하기 어렵다.
8.3 두 신호를 제안했지만 품질 곡선은 주로 A를 측정한다
저자들은 시험 질의에 T_M 단어가 적어 B가 거의 작동하지 않았고, Figure 7–8은 사실상 집계 신호 A의 선택을 평가한다고 밝힌다(p. 10). 따라서 좋은 공출현 라우팅을 설계했다는 설명과 그것이 재현율을 올렸다는 실증은 구분해야 한다. B의 별도 추가 이득은 아직 없다.
9. 논문이 인정한 한계와 추가 검토
9.1 저자가 명시한 한계
- 10억 문서 품질은 측정하지 않았고 작은 규모에서 외삽한다.
- 자연 어휘와 자연 질의 분포의 평가는 남아 있다.
- B의 독립 효과와 M·관련 가중치 sweep은 수행하지 않았다.
- 사람 relevance에 대한 nDCG는 보고하지 않았다.
- 재정렬한 BMW·MaxScore 및 기존 shard selector와의 직접 비교가 없다.
- N이 커지면 고정 K의 클러스터가 커지고, K를 늘리면 Level-1 상주량이 늘어난다.
- 분할은 전체 재클러스터링을 미룰 뿐 없애지 않는다.
- 질의 확장·dense 검색과의 end-to-end 조합은 측정하지 않았다.
이 중 대부분은 §4.3–4.4와 §6에서 저자들이 직접 적는다. 리뷰가 새로 발견한 비판인 것처럼 제시하지 않는다.
9.2 해설자 관점: 강한 보장 문구와 실제 증거의 간격
| 표현·주장 | 확인 가능한 범위 |
|---|---|
| 코퍼스 크기와 무관한 4.4GB | §6은 특정 운영점으로 제한한다. K·df·라우팅 색인 성장에 대한 전체 메모리 회계가 필요하다. |
| 모든 질의 1초 미만 | 단일 요청 측정은 이에 들어가지만 cold 동시 요청 평균은 1초를 넘는다. 최악·tail 지연은 미제시다. |
| 긴 질의에서도 비용 고정 | 방문 클러스터 개수는 고정이다. A는 qK, B는 질의 추적 단어들의 df 합에 의존한다. |
| 4.7–5.6배 | 32단어의 347/387ms 불일치를 먼저 해결해야 한다. |
| flat 결과 리스트 recall | Figure 8의 flat 자체 막대가 100%가 아니므로 기준 집합 확인이 필요하다. |
이 간격은 방법이 쓸모없다는 뜻이 아니다. 실험이 지지하는 운영점에서의 비용 절감과, 아직 입증하지 않은 자원·시간 상한을 분리하자는 뜻이다.
9.3 재현에 필요한 정보
코퍼스 출처·문서 생성 및 길이 분포, 정확한 질의 수·seed·단어 샘플링, 클러스터별 분포, BM25 설정·토큰화, 코드 버전, cold cache 초기화 절차, 동시 요청 생성 방식과 원시 지연 로그가 더 필요하다. 논문은 하드웨어·규모·질의 길이·대략적 색인 크기는 제공하지만 이 세부를 완전히 재현할 수준으로 제시하지 않는다.
어휘 20,680개에서 약 100KB의 전역 df 표가 가능하다는 점도 자연 코퍼스로 그대로 옮길 수 없다. 전역 표는 어휘 크기에, B의 색인은 추적 단어의 df에 영향을 받는다. 또한 index build·LDA·증분 분할의 전체 비용이 query latency 표에 포함되는 것은 아니다.
10. 빠른 근사 검색을 평가하는 데 필요한 비교
Hierarchical BM25는 정확성의 경계를 명료하게 나누는 설계다. 방문할 곳은 근사적으로 고르고, 방문한 문서의 점수는 전역 BM25 기준으로 계산한다. 저장과 I/O 예산이 제한된 큰 코퍼스에서는 유용한 운영 선택지가 될 수 있다.
H+ Embedding이 전체 코퍼스 검색과 후보 안 재순위화를 구분해야 했듯, 여기서는 정확한 부분집합 채점과 정확한 전역 검색을 구분해야 한다. 후보 공간을 줄이면 속도는 빨라지지만 무엇을 잃는지 같은 규모·질의 분포에서 측정해야 한다.
현재 근거는 제한된 어휘의 10억 문서에서 디스크 기반 전수 검색보다 빠르다는 점에 강하고, 최신 정확 검색보다 낫다거나 자연 질의의 최종 품질을 유지한다는 점에는 약하다. 다음 판단에 필요한 것은 같은 코퍼스의 품질–지연–메모리 곡선, B를 켜고 끈 대조, 재정렬 BMW·MaxScore, 그리고 캐시와 동시성 조건을 맞춘 실험이다. 그 전까지 4.4GB·300ms는 매력적인 측정 운영점이지 무조건적인 보장이 아니다.
References
Blei, D. M., Ng, A. Y., & Jordan, M. I. (2003). Latent Dirichlet allocation. Journal of Machine Learning Research, 3, 993–1022.
Deshpande, U., & Sundararaman, S. (2026). Hierarchical BM25: Lexical search at billion-document scale [Preprint]. arXiv. https://arxiv.org/abs/2608.00229v1
Dhulipala, L., Kabiljo, I., Karrer, B., Ottaviano, G., Pupyrev, S., & Shalita, A. (2016). Compressing graphs and indexes with recursive graph bisection. In Proceedings of the ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (pp. 1535–1544).
Ding, S., & Suel, T. (2011). Faster top-k document retrieval using block-max indexes. In Proceedings of the International ACM SIGIR Conference on Research and Development in Information Retrieval (pp. 993–1002).
Kulkarni, A., & Callan, J. (2015). Selective search: Efficient and effective search of large textual collections. ACM Transactions on Information Systems, 33(4), Article 17.
Robertson, S., & Zaragoza, H. (2009). The probabilistic relevance framework: BM25 and beyond. Foundations and Trends in Information Retrieval, 3(4), 333–389.
문헌 확인 범위: 선행 방법의 설명·서지는 대상 논문의 참고문헌과 관련 연구 절을 기준으로 정리했으며, 모든 선행 논문과 구현을 별도로 재검증한 것은 아니다.