GraphCert: Bootstrap Agentic Graph Reasoning with Certified Evidence Rubrics
작은 모델이 그래프 추론을 배울 때, 답뿐 아니라 근거도 검사한다 — GraphCert 쉽게 읽기
GraphCert는 작은 모델이 그래프 질의와 답을 만들게 한 뒤, 실행 결과를 다시 확인하고 남은 의미 오류를 심사해 Solver를 학습한다. 다섯 도메인의 F1은 모두 최고였지만, 인증은 무오류 증명이 아니며 비교와 보상 절제도 함께 살펴야 한다.
Paper: Weiqi Jiang; Yuchen Ying; Rui Wang; Kaixuan Chen; Bingde Hu; Shunyu Liu; Yu Wang; Tongya Zheng (2026). GraphCert: Bootstrap Agentic Graph Reasoning with Certified Evidence Rubrics. arXiv:2609.38798v1 · PDF. 2026년 9월 30일 공개된 v1을 기준으로 한다.
이 글은 논문의 아이디어와 주요 결과를 쉽게 설명한다. 인증 절차, 보상 함수, 표별 비교 조건과 추가 비판은 상세 읽기에서 확인할 수 있다. 결과는 논문이 보고한 수치이며, 모델 학습이나 추론을 다시 실행한 것은 아니다.
요점은 이렇다. 작은 모델이 그래프에서 질문과 답을 직접 만들더라도 그 답을 바로 학습에 쓰지 말자. GraphCert는 질문을 만들 때 실제로 실행한 그래프 질의와 결과를 기록하고, 이를 다시 실행해 맞는지 검사한다. 통과한 근거만 다른 Solver의 학습 신호로 쓰되 Solver에게 정답 근거 자체는 보여 주지 않는다. 이 방식으로 다섯 도메인의 F1은 각 도메인의 비교 방법 중 가장 높았다고 보고한다. 다만 “인증”은 모든 오류가 없음을 수학적으로 증명한다는 뜻은 아니다.
1. 그래프를 푸는 모델은 답만으로 충분할까
그래프 질문에 답하려면 관련 개체를 찾고, 관계의 방향을 확인하고, 필요하면 여러 번 질의를 실행해야 한다. 정답만 주는 학습자료는 모델이 어떤 경로를 탐색해야 하는지 알려 주지 않는다. 질문·답·탐색 과정을 사람이 모두 만들면 비용이 크고, 강력한 외부 언어 모델에 맡기면 데이터가 외부 서비스로 전달될 수 있다는 우려도 있다.
GraphCert는 작은 공개 모델을 두 역할로 쓴다. Quizzer는 그래프를 탐색해 질문과 답을 만들고, 답을 뒷받침한 질의 결과를 표시한다. Solver는 이와 별도로 질문을 풀도록 학습된다. 두 역할은 같은 초기 모델에서 출발하지만, Solver에게 Quizzer의 답 근거는 숨긴다.
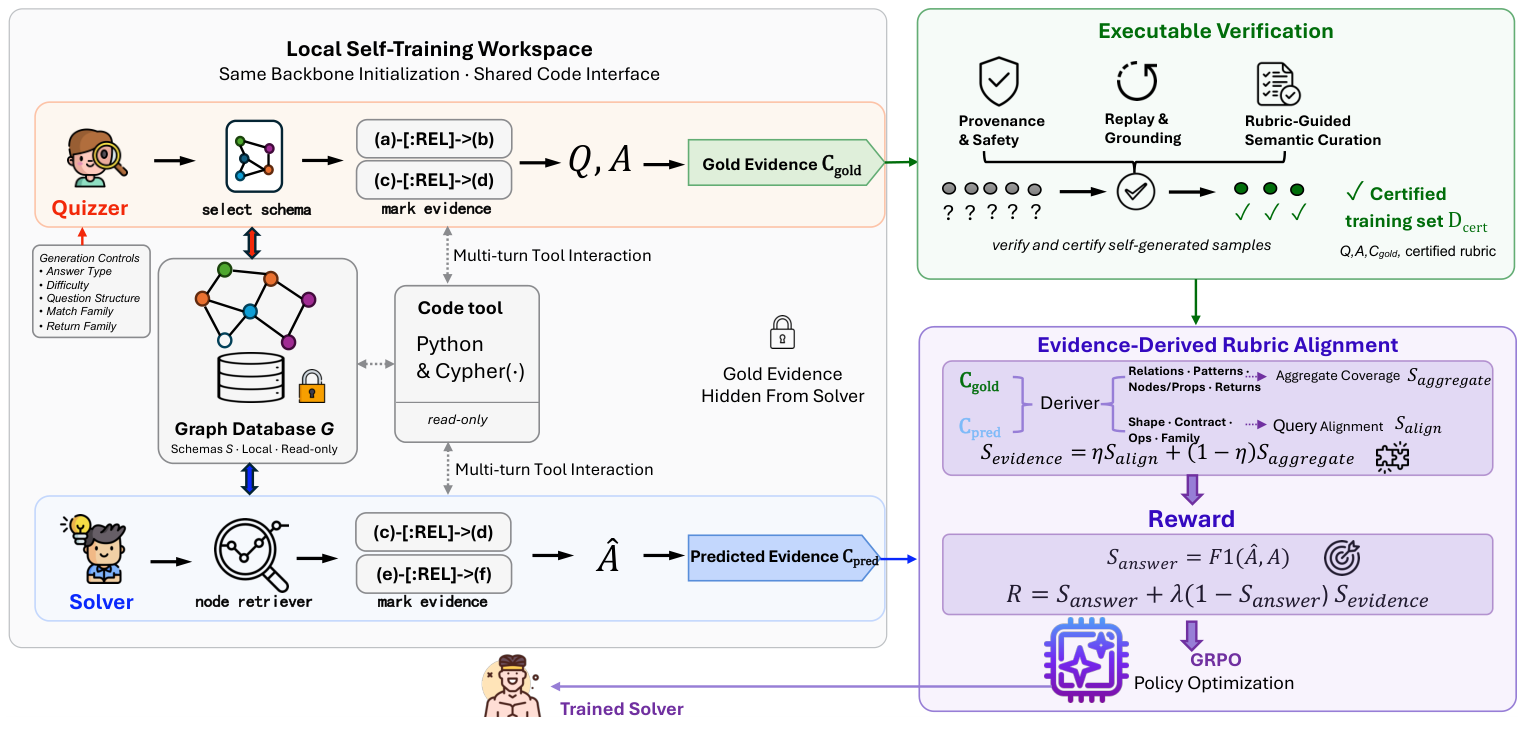
Figure 1. Quizzer가 질문·답과 실행 근거를 만들고, 검증 뒤 근거 구조를 학습 신호로 바꾼다. Solver는 독립적으로 그래프를 탐색하며, Quizzer의 근거는 직접 받지 않는다. Jiang et al. (2026), arXiv v1, p. 3, Figure 1.
2. 답이 맞는지, 근거가 그 답을 뒷받침하는지 나눠 검사한다
Quizzer가 “A와 연결된 항목은 무엇인가?”라고 만들었다면, 답만 확인하는 대신 어떤 그래프 질의를 실제 실행했는지도 기록한다. 검증기는 질의가 읽기 전용인지, 그래프 스키마와 관계 방향에 맞는지 살핀 뒤 같은 질의를 다시 실행한다. 저장된 실행 결과와 다시 얻은 결과가 맞는지, 답이 그 결과에서 계산되는지도 확인한다.
재실행이 성공해도 의미까지 자동으로 보증되지는 않는다. 코드가 같은 결과를 되돌려 줘도 애초에 질문과 다른 관계를 조회했을 수 있다. 그래서 필수 실행 검사를 통과한 후보는 로컬 언어 모델의 별도 의미 심사를 거친다. 최종 학습 자료는 실행 검증과 의미 심사를 모두 통과한 후보다.
이 절차는 잘못된 질의나 답을 줄이는 장치이지, 형식적으로 증명된 인증서는 아니다. 의미 심사에는 모델이 쓰이고, 코드와 전체 데이터 manifest는 이 판본에서 공개되지 않았다. 저자들도 이 인증이 오류 없는 판정기나 미래의 다른 그래프에서도 유효하다는 증명은 아니라고 선을 긋는다.
3. Solver에게 근거의 모양을 보상한다
학습 때 Solver는 정답 근거를 받지 않고 직접 질의해 답을 찾는다. 그럼에도 Solver가 찾은 근거와 인증된 근거를 비교할 수 있도록, 시스템은 질의 문자열을 그대로 대조하지 않고 관계·방향·반환값·사용 연산 같은 구조로 바꾼다. 변수 이름이나 질의 순서가 다르더라도 구조가 비슷하면 점수를 받을 수 있다.
최종 보상은 답의 F1을 우선으로 하고, 정답에 도달하지 못한 나머지 점수 일부를 근거 일치도에 따라 채운다. 논문에서 근거 항의 최대 가중치는 0.1이다. 여기에는 중요한 경계가 있다. 답이 완전히 맞으면 근거가 달라도 보상은 1이어서, 완전 정답인 답들 사이의 근거 품질 차이를 추가 보상으로 구분하지 않는다. 그리고 이 보상은 모든 정답에 인증된 탐색 경로가 존재한다는 보증도 아니다.
4. 다섯 도메인에서 F1이 높았지만 비교 조건을 함께 봐야 한다
GRBENCH의 다섯 도메인에서 GraphCert의 F1은 비교한 방법들 중 모두 가장 높았다. 저자들은 각 도메인의 가장 강한 기준선과 비교한 상대 개선율을 평균해 8.2%라고 보고한다. 표의 값을 다시 계산하면 평균 상대 개선은 약 8.17%, 절대 F1 차이의 평균은 4.64%포인트다. 8.2%는 8.2%포인트 상승이나 전체 질문을 한데 합친 가중 평균이 아니다.
다른 지표에서는 예외가 있다. Qwen-Max가 답을 판정한 QwenScore는 다섯 도메인 중 네 곳에서 가장 높았고, Academic에서는 GraphCounselor가 0.657로 GraphCert의 0.651보다 높았다. 일부 비교는 논문 저자들이 같은 환경에서 다시 실행한 것이 아니라 선행 연구에서 가져온 값이다.
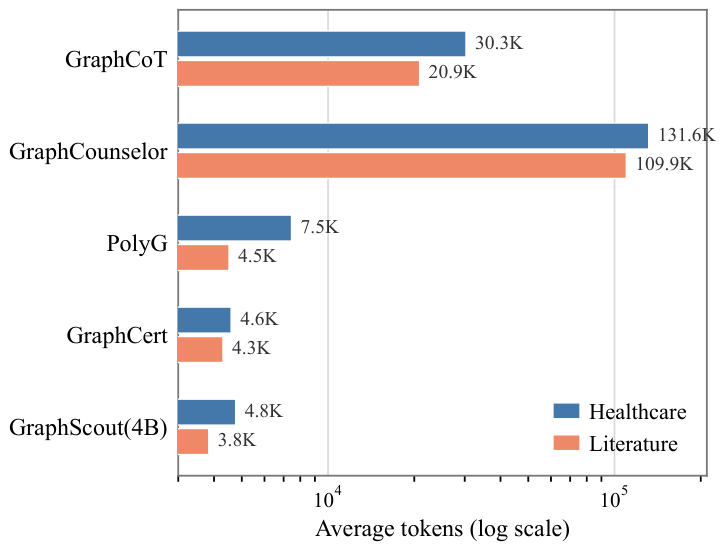
Figure 2. Healthcare(파랑)와 Literature(주황)의 평균 토큰 수. GraphCert는 각각 4.6K·4.3K로 GraphScout(4B)의 4.8K·3.8K와 비슷한 규모다. 세로축이 아니라 가로축이 로그 척도다. 이는 질의 추론 토큰 비교이며, 자료 생성·검증·학습 전체 비용은 아니다. Jiang et al. (2026), arXiv v1, p. 14, Figure 2.
이 수치는 작은 모델이 더 강한 Quizzer로부터 자료를 받지 않고도 경쟁력 있는 결과를 낼 가능성을 보여 준다. 하지만 평균 토큰 수만으로 실제 비용이 낮다고 결론낼 수는 없다. 자료를 만들고 인증하는 과정과 학습에 든 GPU 시간·전력·금전 비용은 별도 비교가 필요하다.
5. 인증이 학습자료를 줄이고, 절제 비교에는 혼합 요인이 있다
Healthcare와 Literature에서 후보로 생성된 자료 중 최종적으로 받아들여진 것은 각각 2,000개다. 후보의 약 36%는 제외됐다. 이 제외에는 코드 실행·스키마·답과 근거의 불일치뿐 아니라 의미 심사도 들어 있으므로, 전부 실행 오류라고 보면 안 된다. 받아들여진 자료 중에는 정적 구조 확인 일부를 보류한 partial도 상당 비중 포함된다. 이는 자료의 범위를 넓히는 대신 완전한 정적 근거 확인은 줄이는 절충이다.
인증을 없앤 절제에서는 F1이 낮아졌지만, 그 실험은 인증만 제거한 것이 아니다. 질문 생성 지침과 실행 검증, 의미 심사를 함께 없애고 원시 Quizzer 출력을 썼다. 따라서 점수 차이를 재실행 검사 하나의 효과로 나누어 말할 수 없다. 근거 보상을 뺀 별도 실험도 두 도메인만 평가했다. 연구는 근거 검사가 유망하다는 신호를 주지만 어떤 구성요소가 개선을 얼마나 만들었는지는 더 분리된 비교가 필요하다.
6. 결론: 실행 가능한 근거는 신뢰의 시작이지 보증서가 아니다
GraphCert의 설계에서 배울 점은 생성한 자료를 바로 믿지 않는 것이다. 실제 실행 기록을 남기고 다시 확인한 뒤, 근거를 별도의 구조화된 학습 신호로 사용한다. 다섯 도메인의 F1과 도메인 간 전이 결과는 이 조합이 유망하다는 증거다.
동시에 해석 범위는 분명히 해야 한다. 실행 검증 뒤에도 의미 판단은 모델 심사에 의존하고, partial 자료가 최종 학습에 포함된다. 제거 실험은 여러 구성을 한꺼번에 바꾸며, 결과표의 모든 비교가 완전히 같은 조건으로 재실행된 것도 아니다. 그러므로 이 논문은 “작은 모델이 그래프 추론을 오류 없이 인증한다”기보다, 실행 가능한 근거를 수집하고 일부를 걸러 학습에 활용하는 자기 학습 설계가 성능을 높일 수 있다고 보여 준다.
같이 읽기: Microsoft GraphRAG · Deep GraphRAG · Concept-Grounded Attention
References
Jiang, W., Ying, Y., Wang, R., Chen, K., Hu, B., Liu, S., Wang, Y., & Zheng, T. (2026). GraphCert: Bootstrap agentic graph reasoning with certified evidence rubrics [Preprint]. arXiv. https://arxiv.org/abs/2609.38798v1