GraphCert: Bootstrap Agentic Graph Reasoning with Certified Evidence Rubrics
GraphCert는 작은 모델이 그래프 질의와 답을 만들게 한 뒤, 실행 결과를 다시 확인하고 남은 의미 오류를 심사해 Solver를 학습한다. 다섯 도메인의 F1은 모두 최고였지만, 인증은 무오류 증명이 아니며 비교와 보상 절제도 함께 살펴야 한다.
Paper: Weiqi Jiang; Yuchen Ying; Rui Wang; Kaixuan Chen; Bingde Hu; Shunyu Liu; Yu Wang; Tongya Zheng (2026). GraphCert: Bootstrap Agentic Graph Reasoning with Certified Evidence Rubrics. arXiv:2609.38798v1. PDF · 서지 정보. 15쪽의 v1을 기준으로 읽는다. 저자 소속은 Zhejiang University, Nanyang Technological University, Hangzhou City University이며, 별도의 학회 게재는 확인하지 않았다.
Abstract: 그래프를 탐색하는 에이전트를 학습시키려면 질문·정답뿐 아니라 어떤 질의를 실행해 근거를 얻는지도 가르쳐야 한다. GraphCert는 4B 모델이 직접 만든 질문·정답·실행 근거를 검증하고, 통과한 근거를 정규화된 채점 기준으로 바꾸어 같은 초기 모델의 Solver를 강화학습한다. 핵심은 생성물을 믿는 대신 재실행·출처·스키마 검사를 거치고, 자연어 의미의 정합성은 별도의 로컬 모델 호출로 심사한다는 점이다. GRBENCH 다섯 도메인에서 F1은 비교군 중 가장 높지만, 이 결과를 오류 없는 인증이나 모든 평가 지표의 우위로 읽으면 안 된다. 이 글은 strict·partial 인증의 차이, 정답 보상에 최대 0.1만 더하는 근거 보상, 생성 제어까지 함께 제거한 절제 실험, 외부 모델이 남아 있는 평가 경로, 그리고 벤치마크 자체의 관계 방향 문제를 구분한다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 연구 질문 | 외부 대형 교사 없이 작은 모델이 그래프에서 학습 자료를 만들고, 그 자료의 실행 근거를 검사해 유용한 탐색 정책을 학습할 수 있는가? |
| 학습 구조 | Qwen3-4B-Instruct-2507 Quizzer → 실행 인증·로컬 의미 심사 → 도메인별 2,000개 자료 → 같은 체크포인트로 초기화한 Solver의 GRPO 학습. |
| 인증 범위 | strict도 실행·정적 근거 확인과 모델 의미 심사의 결합이다. partial은 재실행과 필수 검사는 통과했지만 일부 의존관계를 정적으로 입증하지 못한 사례다. |
| 보상 | 정답 F1에 남은 점수의 최대 10%를 근거 정합성으로 보충한다. 완전 정답이면 근거 점수와 무관하게 보상 1이다. |
| 성능 | Table 1의 F1은 5/5 도메인 최고, QwenScore는 4/5 최고. 도메인별 최강 기준선 대비 F1 상대 개선의 단순 평균은 약 8.2%다. |
| 데이터 품질 | Healthcare·Literature 후보의 약 36%를 제외한다. 별도 모델 심사에서 엄격한 grounding 통과율은 36.7%→71.0%이며, 인증이 무오류라는 뜻은 아니다. |
| 추가 검토 | 인증 제거 실험은 생성 지침도 없앤다. 8B가 Healthcare에서 4B보다 낮고, 전이 점수에도 출발 도메인별 차이가 크다. |
읽기 안내: 성능과 실험 결과는 저자 보고다. 이 리뷰의 수치 확인은 표와 수식의 재계산이며 모델 학습·추론을 재실행한 것이 아니다. 정확도 차이의 ‘점’은 퍼센트포인트, 상대 개선은 별도로 표시한다.
목차
- 질문을 스스로 만들되 정답으로 바로 믿지 않는다
- 같은 그래프를 탐색하되 정답 근거는 숨긴다
- 실행 인증과 의미 심사는 다른 일을 한다
- 근거를 문자열이 아닌 구조로 비교한다
- 정답을 우선한다는 보상은 무엇을 보장하는가
- 다섯 도메인의 최고 F1과 비교 조건
- 걸러낸 자료와 근거 보상은 각각 무엇을 더하는가
- 전이와 모델 크기와 추론 비용
- 인증이 보장하지 않는 것과 벤치마크의 한계
- 실행 가능한 자기 학습의 가치와 적용 조건
1. 질문을 스스로 만들되 정답으로 바로 믿지 않는다
그래프 에이전트는 한 번 검색해 받은 문장을 요약하는 모델이 아니다. 개체를 찾고, 관계 방향을 확인하고, 질의를 실행한 뒤 필요하면 다른 조건으로 다시 묻는다. 이 상호작용을 훈련하려면 그래프에 맞는 질문과 정답이 필요하다. 사람이 만들면 비싸고, 외부 대형 모델에 맡기면 그래프 데이터가 외부 서비스로 전달될 수 있다.
GraphCert는 작은 로컬 모델이 자료를 만들되, 생성한 정답을 학습 라벨로 바로 쓰지 않는다. 질문·정답과 함께 실제로 실행한 질의의 결과물을 제출하게 하고, 이를 후보 인증서(candidate certificate)로 취급한다. 다시 실행했을 때 같은 결과가 나오는지, 스키마와 관계 방향이 맞는지, 그 근거가 자연어 질문의 의미까지 뒷받침하는지를 분리해서 검사한다.
가까운 선행 방법은 GraphScout다. GraphScout 역시 Quizzer가 그래프를 탐색해 학습 자료를 만들지만, 이 논문은 작은 Quizzer가 만드는 오류를 통제하고 근거 구조까지 보상으로 활용하는 데 초점을 둔다. 이 차이를 평가하려고 Qwen3-4B Quizzer를 사용하는 GraphScout도 재현했다.
Concept-Grounded Attention이 그래프를 모델의 주의 계산 안에 넣었다면, GraphCert는 그래프 도구 사용 정책의 학습 신호를 바꾼다. 그래프를 쓴다는 공통점만으로 같은 방법 계열로 묶기보다, 무엇을 학습하는지를 먼저 구분해야 한다.
2. 같은 그래프를 탐색하되 정답 근거는 숨긴다
2.1 생성 제어는 인증된 라벨이 아니다
Quizzer는 임의의 시작 노드와 1-hop 이웃에서 출발한다. 다섯 축을 조합해 생성할 문제의 방향을 정한다.
| 축 | 예시 | 역할 |
|---|---|---|
| 답 유형 | entity, boolean, number, set | 최종 응답 형태 |
| 질문 패턴 | 머리 개체·관계·꼬리 개체 중 알려진 슬롯과 탐색할 슬롯, hybrid | 추상적인 질문 구조 |
| 난도 | simple, medium, hard | 허용하는 접근·반환 계열의 범위 |
| match family | 한 홉, 다중 홉, 교집합, 비교, optional match, shortest path | 그래프 접근 구조 |
| return family | 속성, distinct 집합, 집계, 순위, Boolean | 실행 결과의 형태 |
원문 pp. 3, 9–10, Table 8. 목표는 soft control이며 완성된 문제의 난도·계열을 검증한 정답 라벨이 아니다.
예컨대 집합 답을 요구하면서 Boolean 반환을 선택하지 않도록 답 유형과 난도에 따른 허용 집합의 교집합에서 return family를 고른다. 하지만 프롬프트에 ‘다중 홉’이라고 썼다고 실제 문제가 다중 홉이 되는 것은 아니다. 최종 근거에서 구조를 다시 유도한다.
2.2 도구와 기록의 경계
Quizzer의 select_schema는 관계 방향·속성·끝점 제약을 보여 준다. code는 지속되는 Python 실행 환경과 읽기 전용 cypher()를 제공한다. 실행 결과는 질의·매개변수·결과 해시·행 수·정렬·잘림 여부와 연결된 TracedResult다. mark_evidence()에는 이런 직접 실행 결과만 넘길 수 있고, 임의로 만든 Python 목록을 근거처럼 제출할 수 없다.
후보 질문과 답을 정한 뒤 마지막 코드 블록에서 답을 다시 계산하고 그 계산에 쓴 결과를 표시한다. 부록에는 생성 단계의 제한된 repair 심사를 한 번 수행하고 필요한 경우 QA를 최소 수정한 뒤 근거를 재생성한다는 절차도 있다(p. 10). 일반적인 코드 재시도와 이 repair 단계를 구분한다.
Solver는 자연어 질문과 도메인 스키마·도구 사용 규칙을 받는다. 개체 언급을 node_retriever로 노드 ID에 연결한 뒤 같은 Python/Cypher 인터페이스로 독립 탐색한다. 검색기가 돌려준 후보 노드 자체나 가공한 Python 값은 근거가 아니다. Solver도 직접 질의 결과를 표시한 뒤 최종 답을 제출한다.
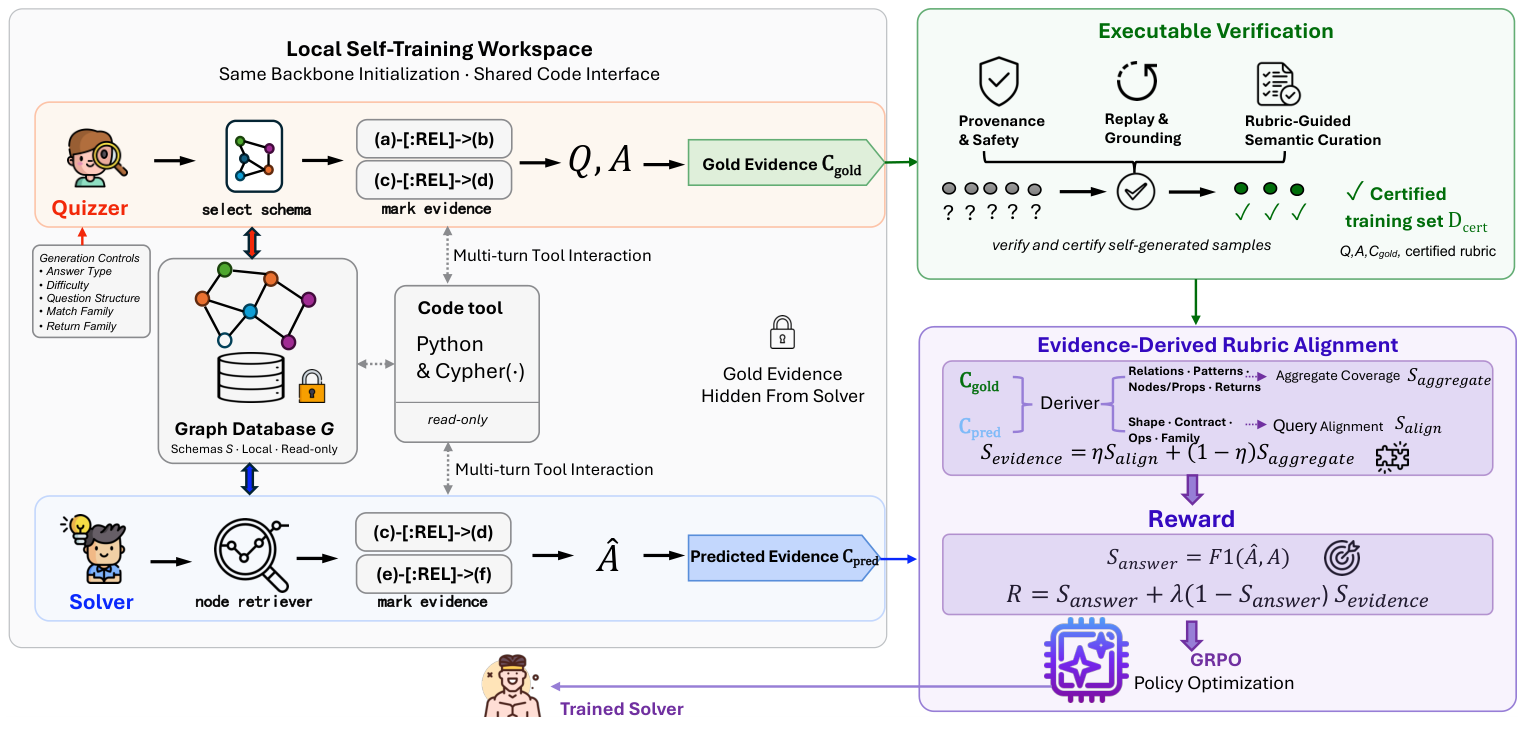
Figure 1. Quizzer의 정답 근거는 Solver 입력에서 숨기고, 보상 계산에서만 Solver의 근거와 비교한다. 같은 초기 백본과 도구 인터페이스를 사용한다. 출처: Jiang et al. (2026), v1, p. 3, Fig. 1 — 연구·학습 목적 인용.
여기서 ‘같은 모델’은 Quizzer의 정답 근거를 Solver에게 그대로 보여 준다는 뜻이 아니다. 같은 체크포인트를 사용하되 역할과 입력을 분리한다. 보고된 실험은 인증 자료를 만든 뒤 Solver를 학습하는 과정이며, 개선된 Solver를 Quizzer로 반복 환류하는 장기 자기진화 루프의 성능을 보고하지는 않는다.
3. 실행 인증과 의미 심사는 다른 일을 한다
3.1 재실행으로 확인하는 것
실행 인증은 네 가지 검사를 결합한다(pp. 11–12).
- 형식·출처·안전: 근거 ID, 질의, 결과의 대응이 같아야 한다. 쓰기 연산과
CALL, APOC 등을 거부한다. - 스키마와 정적 분석: 라벨·관계·끝점·속성·방향·반환 연산을 검사한다. 방향은 관계명만이 아니라 출발 라벨–관계–도착 라벨의 조합으로 확인한다.
- 독립 재실행: 같은 매개변수로 질의를 다시 실행해 정규화한 결과 해시와 잘림 상태를 비교한다. 정렬을 명시한 질의는 순서를 보존하고, 나머지는 순서 없는 결과로 비교한다.
- 답의 근거와 완전성: 지원 프로그램이 계산한 답과 제출 답을 유형별 정규화 후 비교하고, 표시된 근거가 계산에 충분한지 확인한다.
질의 결과는 최대 200행을 보존하고 한 행을 더 요청해 잘림을 감지한다. 잘린 결과는 부분 관측으로는 쓸 수 있지만 전체 집합·정확한 개수·집합 동등성을 인증하는 데 쓸 수 없다. 그래프 스냅샷이 바뀌어 재실행 결과가 달라져도 hard failure이므로, 모든 탈락이 모델 오류만을 뜻하는 것은 아니다.
3.2 strict와 partial은 난도 구분이 아니다
| 상태 | 확인된 것 | 남은 것 | 학습 자료에 바로 들어가는가? |
|---|---|---|---|
| judgeable strict | 필수 검사, 재실행, 답 일치, 직접 grounding와 근거 완전성 | 자연어 의미의 지지 여부 | 아니오 |
| judgeable partial | 모든 필수 검사, 재실행과 기본 grounding | 허용 목록에 있는 정적 의존관계의 미확정 | 아니오 |
| hard failure | 필수 검사 중 하나 이상 실패 | 의미 심사로 넘기지 않음 | 아니오 |
복잡한 다중 질의 Python 조합, conjunction·공유 변수의 보수적 모호성, distinct·filter의 정적 지원 부족 등이 partial에 해당할 수 있다. 어려운 다중 홉 집계라도 직접 검증 가능하면 strict이고, 간단한 질문이라도 방향이 틀리면 hard failure다. partial은 경미한 실패를 통과시킨다는 뜻이 아니라, 일부 정적 판정을 유보한다는 뜻이다.
3.3 의미는 여전히 모델이 심사한다
재실행이 성공해도 질문과 다른 조건을 질의했다면 정답 근거가 아니다. Quizzer와 같은 로컬 모델을 Judge로 호출해 두 단계 의미 심사를 수행한다. 입력에는 QA·지원 프로그램·제한된 결과 preview·정규화된 질의 구조가 들어가지만, 전체 탐색 대화·자유 서술 추론·Solver 궤적·샘플링한 계열은 숨긴다.
첫 단계는 개체·수식어·관계 경로·양화사·답 범위·근거 완전성과 하드코딩 여부를 검토한다. 두 번째는 주장별 근거와 구체성 등을 다시 감사한다. accept만 자료에 들어가며 uncertain은 입학과 의미적 거부 집계 모두에서 제외한다.
최종 데이터는 프로그램 strict 또는 partial이면서 의미 심사 accept인 자료다. 저자들은 이것이 오류 없는 Judge, 형식적으로 증명된 인과 계보, 유일한 질의 해법, 미래 그래프 스냅샷에서도의 유효성을 주장하지 않는다고 명시한다(p. 12). 따라서 제목의 Certified를 형식 증명과 동의어로 읽으면 안 된다.
4. 근거를 문자열이 아닌 구조로 비교한다
4.1 변수 이름을 바꿔도 같은 구조는 같은 점수를 받는다
Quizzer와 Solver가 같은 답을 얻더라도 변수명·별칭·질의 순서가 다를 수 있다. 공유 Cypher deriver가 이러한 표면 차이를 제거하고 구조 특징을 추출한다.
S_{\mathrm{pair}}=0.55S_{\mathrm{shape}}+0.25S_{\mathrm{contract}}+0.15S_{\mathrm{ops}}+0.05S_{\mathrm{family}}.| 비교 | 내용 |
|---|---|
| shape | 타입과 방향이 붙은 패턴 80%, 참여 노드 20% |
| contract | 반환식 45%, 결과 형태 20%, 속성 15%, 중복 제거 10%, 정렬 10% |
| ops | filter·aggregation·count·order·limit·distinct·optional 등의 활성 연산 |
| family | match 계열과 return 계열의 일치 |
원문 p. 13, 식 13–14. 계수는 학습·평가 중 고정한다.
구조와 연산의 비교는 중복을 유지하는 multiset F1을 사용한다. 같은 특징이 여러 번 쓰인 경우를 집합 하나로 뭉개지 않는다. 실패하거나 비어 있는 정적 유도는 pair score 0이다.
4.2 질의 하나씩의 일치와 전체 특징의 포괄성을 함께 본다
정답 질의가 m개, 예측 질의가 n개라면 최대 가중치 일대일 매칭으로 점수를 모은다.
S_{\mathrm{align}}=\frac{\sum_{(i,j)\in M^*}S_{\mathrm{pair}}(i,j)}{\max(m,n,1)}.큰 쪽의 개수로 나누므로 정답 질의를 빠뜨리거나 불필요한 질의를 많이 표시하면 불리하다. 다만 하나의 질의를 두 개로 분해하는 올바른 풀이도 이 점수만으로는 손해를 볼 수 있다.
그래서 질의 경계를 지우고 관계 유형·방향 패턴·노드와 속성·반환 조건을 모아 비교한 S_{\mathrm{aggregate}}를 함께 쓴다.
S_{\mathrm{evidence}}=0.70S_{\mathrm{align}}+0.30S_{\mathrm{aggregate}}.pooling이 모든 의미적 동치 해법에 불변인 것은 아니다. 중복 특징과 반환 요건이 달라지면 같은 정답을 만드는 다른 분해도 점수가 달라질 수 있다. 이 장치는 다양한 분해를 일부 인정하는 구조적 유사도이지, 두 프로그램의 의미적 동치 판정기가 아니다. 표시하지 않은 탐색 질의는 점수에서 제외하므로 전체 탐색 과정의 모든 단계에 대한 검증도 아니다.
5. 정답을 우선한다는 보상은 무엇을 보장하는가
최종 답의 token F1을 a, 근거 점수를 e라고 쓰면 보상은 다음과 같다.
R=a+0.10(1-a)e,\qquad a,e\in[0,1].이 식에서 직접 계산되는 성질은 다음과 같다. 아래 예시는 논문의 실험 수치가 아니라 수식을 설명하기 위한 재계산이다.
답 F1 a |
근거 e |
보상 R |
의미 |
|---|---|---|---|
| 0 | 1 | 0.10 | 답이 틀려도 근거로 최대 0.1을 받음 |
| 0.5 | 1 | 0.55 | 정답까지 남은 0.5의 10%를 보충 |
| 1 | 0 | 1 | 완전 정답이면 근거가 없어도 만점 |
| 1 | 1 | 1 | 완전 정답에서 근거를 더 맞춰도 추가 보상 없음 |
R\in[0,1]은 식으로 보장되지만, 근거가 좋은 궤적보다 답 점수가 조금 높은 궤적을 언제나 우선한다는 보장은 없다. 예를 들어 a=0.50,e=1의 보상 0.55는 a=0.54,e=0의 0.54보다 높다. ‘answer-primary’는 주된 점수와 보충량의 설계를 가리키며 엄격한 사전식 우선순위는 아니다.
완전 정답인 rollout은 근거 정합성과 무관하게 보상 1을 받는다. 따라서 보상 함수는 완전 정답 궤적들 사이의 근거 품질을 구별하는 추가 학습 신호를 주지 않는다. 이는 근거 비교 자체를 생략한다는 뜻은 아니며, ‘모든 정답이 인증된 추론 과정을 거쳐 생성된다’는 보장도 아니다. 최종 답을 파싱하지 못하면 보상은 0이고, 표시된 질의 집합 중 한쪽이 비면 근거 점수는 0이다.
GRPO는 질문당 여덟 궤적의 보상을 그룹 안에서 정규화하고, 궤적 단위 advantage를 유효 응답 토큰에 배분한다. 별도 KL 정규화도 사용한다. 도메인별 자료 2,000개로 400 step, rollout temperature 1.0, 학습률 10^{-6}, clip 0.20, 초기 KL 계수 10^{-4}다. 근거 보상은 궤적 전체를 채점하므로 행동마다 의미적 정답을 주는 세밀한 단계 보상과도 구분해야 한다.
6. 다섯 도메인의 최고 F1과 비교 조건
6.1 주 결과는 도메인별로 학습한 모델이다
GRBENCH는 다섯 도메인, 열 개 그래프, 영어 질문 1,740개로 구성된다. 그래프 규모는 Healthcare 약 47K 노드부터 Legal 약 84M 노드까지다. 본문의 주 결과는 도메인별 학습 모델의 해당 도메인 평가이며, 하나의 통합 모델이 다섯 도메인을 모두 푼 결과가 아니다. F1은 정규화 token overlap, QwenScore는 Qwen-Max가 정답으로 판정한 비율이다.
| 방법 | Healthcare | Literature | Academic | E-Commerce | Legal |
|---|---|---|---|---|---|
| GraphCoT, DeepSeek-V3.2 | 0.443 | 0.466 | 0.546 | 0.418 | 0.559 |
| GraphCounselor, DeepSeek-V3.2 | 0.452 | 0.578 | 0.659 | 0.489 | 0.286 |
| GraphScout(4B) | 0.689 | 0.618 | 0.579 | 0.481 | 0.621 |
| GraphCert, 학습 전 | 0.300 | 0.301 | 0.231 | 0.212 | 0.209 |
| GraphCert | 0.722 | 0.681 | 0.674 | 0.583 | 0.648 |
저자 보고 F1, Table 1 일부, p. 6. GPT-4o 및 다른 검색·질의 기준선은 이 축약표에서 생략했지만 최강 기준선 계산에는 Table 1 전체를 비교한다.
GraphCert는 F1 다섯 도메인 모두 최고다. QwenScore는 Healthcare 0.744, Literature 0.656, Academic 0.651, E-Commerce 0.566, Legal 0.636으로 네 도메인 최고다. Academic에서는 DeepSeek-V3.2 GraphCounselor가 0.657로 0.006 높다. 따라서 ‘모든 지표에서 큰 모델을 이긴다’는 해석은 맞지 않는다.
6.2 8.2%는 상대 개선의 도메인 평균이다
Table 1에서 도메인별 최고 기준선 F1은 0.689, 0.618, 0.659, 0.489, 0.621이다. 기준선이 같은 방법으로 고정된 것이 아니다.
| 도메인 | 최강 기준선 | GraphCert−기준선 | 상대 개선 |
|---|---|---|---|
| Healthcare | 0.689 | +0.033 | 약 4.79% |
| Literature | 0.618 | +0.063 | 약 10.19% |
| Academic | 0.659 | +0.015 | 약 2.28% |
| E-Commerce | 0.489 | +0.094 | 약 19.22% |
| Legal | 0.621 | +0.027 | 약 4.35% |
리뷰의 Table 1 표시값 재계산. 상대 개선은 (F1_{\mathrm{GraphCert}}/F1_{\mathrm{baseline}}-1)\times100이다.
다섯 상대 개선의 단순 평균은 약 8.17%로 원문의 8.2%와 일치한다. F1의 절대 차이 평균은 0.0464, 즉 4.64점이다. 8.2점 상승이나 전체 1,740문항을 합친 가중 평균의 상대 개선으로 바꾸면 안 된다.
6.3 어떤 비교가 재실행됐는가
GPT-4o·DeepSeek-V3.2 prompting 행은 GraphScout의 공개 결과를 인용했고 GraphScout(4B)는 저자들이 재현했다. Table 5의 강한 Quizzer GraphScout(DS)도 기존 발표값이다. 따라서 이들은 동일 환경에서 모든 호출·예산을 다시 맞춘 비교는 아니다.
또 이 논문의 ‘GraphRAG’ 기준선은 질문 개체의 2-hop 이웃을 찾아 텍스트로 펼치는 방식이며 Ye et al.의 연구를 인용한다(p. 14). 기존 블로그의 MS GraphRAG 커뮤니티 요약 파이프라인과 같은 구현이라고 보면 안 된다.
7. 걸러낸 자료와 근거 보상은 각각 무엇을 더하는가
7.1 자료의 약 3분의 1을 제거한다
| 상태 | Healthcare | Literature |
|---|---|---|
| 후보 수 | 3,126 | 3,096 |
| accepted strict | 34.87% | 29.40% |
| accepted partial | 29.10% | 35.20% |
| 제외 | 36.03% | 35.40% |
| 최종 인증 자료 | 2,000 | 2,000 |
저자 보고, Table 2, p. 6. strict와 partial 모두 의미 심사를 통과한 뒤의 비율이다.
실행 단계 hard failure는 Healthcare 662건(21.2%), Literature 446건(14.4%)이다. 네 원인의 개수는 실행 실패 8/12, 스키마 방향 오류 348/66, 답–근거 불일치 118/314, 불완전 근거 188/54다. 합계는 각각 662와 446으로 맞는다. 전체 제외율에는 의미 심사도 포함되므로 36%를 전부 실행 오류라고 부를 수 없다.
accepted partial은 최종 학습 자료 중 대략 Healthcare 45%, Literature 54%에 해당한다. 즉 partial은 작은 예외가 아니라 자료의 상당 부분이다. 다만 Table 2의 백분율을 정확한 정수 건수로 모두 복원하기는 어렵다. Healthcare strict 34.87%는 1,090/3,126≈34.8688%와 맞는다. 같은 후보 풀에서 strict+partial 합계가 2,000건이라면 partial 910건과 제외 1,126건은 각각 29.11%와 36.02%로 반올림되어, 표의 29.10%·36.03%와 0.01점씩 다르다. 원시 집계와 표기 규칙 없이 원인을 확정하지 않는다.
7.2 별도 Judge가 본 QA 품질
| 품질 기준 | Plain Quizzer | GraphCert |
|---|---|---|
| 답 지지 | 38.7% | 82.7% |
| 근거 충분성 | 38.7% | 72.7% |
| 질의 일관성 | 45.3% | 77.3% |
| strict grounding | 36.7% | 71.0% |
저자 보고, Table 3, p. 6. 각각 300개 QA를 블라인드 DeepSeek-V4-Flash가 동일 프롬프트로 판정했다.
개선은 각각 44.0, 34.0, 32.0, 34.3점이다. 논문은 이 Judge를 보정된 참값 판정기로 쓰지 않고 상대 비교에 사용한다고 명시한다. 따라서 GraphCert의 29%가 확정적 오답이라는 뜻도, 71%가 사람 검증 정확도라는 뜻도 아니다. 다만 로컬 입학 심사의 통과가 외부 의미 감사에서도 무조건 통과한다는 보장은 없다는 점은 분명하다.
7.3 ‘인증 제거’는 인증 하나만 뺀 실험이 아니다
| 변형 | Healthcare F1 | Literature F1 |
|---|---|---|
| GraphCert | 0.722 | 0.681 |
| w/o Certification | 0.612 | 0.624 |
| w/o evidence reward | 0.566 | 0.654 |
저자 보고, Table 4, pp. 6–7. 자료 수와 최적화 예산은 같게 유지했다.
인증 제거의 차이는 −0.110/−0.057, 근거 보상 제거는 −0.156/−0.027이다. Healthcare에서는 근거 보상의 차이가 특히 크다. 하지만 w/o Certification은 질문 계열 생성 지침, 실행 검증, 의미 심사를 함께 제거하고 원시 Quizzer 출력을 사용한다. 따라서 이 차이를 실행 재검사만의 인과 효과로 배정할 수 없다. 자료 생성과 선별 묶음 전체의 효과다.
근거 보상 제거는 자료를 그대로 두므로 보상항의 추가 가치를 더 직접적으로 비교한다. 그렇더라도 두 도메인만의 결과이고, 반복 실행 분산이나 신뢰구간 없이 Healthcare의 큰 차이를 모든 도메인의 안정적 효과로 일반화할 수는 없다.
8. 전이와 모델 크기와 추론 비용
8.1 작은 Quizzer가 강한 교사를 대체한 범위
| 방법 | Literature F1 | E-Commerce F1 |
|---|---|---|
| GraphScout, DeepSeek-V3.2 Quizzer | 0.646 | 0.562 |
| GraphScout, 4B Quizzer | 0.618 | 0.481 |
| GraphCert, 4B Quizzer | 0.681 | 0.583 |
저자 보고, Table 5, p. 7.
GraphCert는 강한 Quizzer를 쓴 기존 결과보다 0.035/0.021 높다. 작은 모델이 만든 자료라도 검사와 보상 설계가 중요하다는 근거다. 다만 이 비교는 두 도메인이고, 방법과 Quizzer 크기가 함께 달라지므로 GraphCert 내부에서 Quizzer만 교체한 크기 절제는 아니다.
8.2 전이는 관찰되지만 도메인 차이는 남는다
| 학습 도메인 ↓ / 시험 → | Health. | Lit. | Acad. | E-Com. | Legal |
|---|---|---|---|---|---|
| Healthcare | 0.722 | 0.544 | 0.500 | 0.496 | 0.637 |
| Literature | 0.672 | 0.681 | 0.537 | 0.602 | 0.644 |
| Academic | 0.561 | 0.587 | 0.674 | 0.571 | 0.655 |
| E-Commerce | 0.614 | 0.656 | 0.488 | 0.583 | 0.624 |
| Legal | 0.643 | 0.691 | 0.648 | 0.571 | 0.648 |
저자 보고 F1, Table 6, p. 7. 행마다 별도로 학습한 Solver다.
모든 비대각선 값이 해당 시험 도메인의 학습 전 GraphCert보다 높다. Legal 학습 모델의 Literature 0.691은 Literature 학습 모델의 0.681보다 높고, Literature→E-Commerce 0.602도 대각선 0.583보다 높다. 도메인 간에 옮겨 쓰는 탐색 행동이 있다는 근거다.
반면 E-Commerce→Academic은 0.488로 Academic 자체 학습 0.674보다 0.186 낮다. ‘robust transfer’는 어디서 학습해도 같은 성능이라는 뜻이 아니다. 평가 시 대상 도메인의 스키마·도구·개체 검색기를 받으므로, 새로운 스키마를 아무 도움 없이 추론하거나 새로운 도구 API로 전이한 실험도 아니다. 전이 관측은 단일 그래프 암기만으로 설명하기 어려운 결과지만 사전학습 지식·공통 도구 숙련·답 형식 학습의 기여까지 분리하지는 않는다.
8.3 8B는 Healthcare에서 더 낮다
| 백본 | Healthcare QwenScore/F1 | Literature QwenScore/F1 |
|---|---|---|
| Qwen3-4B-Instruct-2507 | 0.744 / 0.722 | 0.656 / 0.681 |
| Qwen3-8B | 0.609 / 0.601 | 0.663 / 0.687 |
저자 보고, Table 7, p. 7.
Literature F1은 0.006 높지만 Healthcare는 0.121 낮다. 저자들은 GraphScout에서도 비슷한 현상이 있었고 Qwen3-8B의 hybrid reasoning 설정과 관련될 수 있다는 가설을 인용한다. 실제 원인을 분리한 실험은 아니다. 백본 구성과 하드웨어도 달라 크기 하나의 효과로 해석하지 않는다.
8.4 토큰 수는 적지만 전체 비용은 따로다
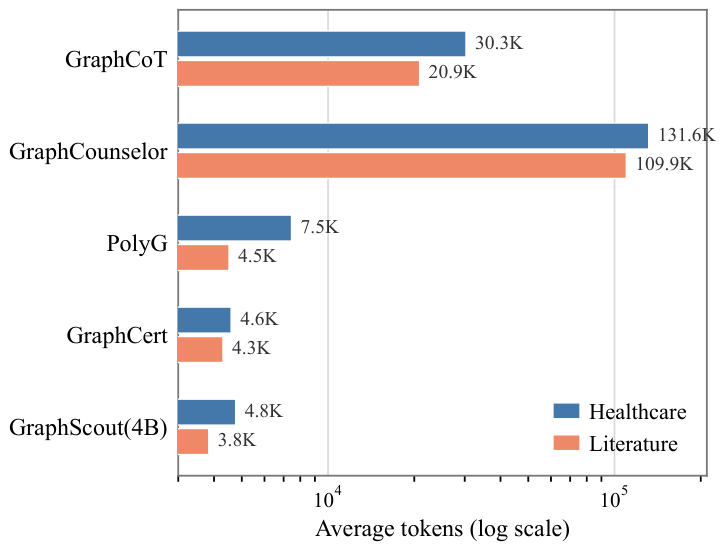
Figure 2. 파랑은 Healthcare, 주황은 Literature다. 가로축은 로그 척도이며 K는 천 토큰이다. 출처: Jiang et al. (2026), v1, p. 14, Fig. 2 — 연구·학습 목적 인용.
GraphCert는 평균 4.6K/4.3K 토큰, GraphScout(4B)는 4.8K/3.8K다. 즉 GraphScout와 비슷한 규모이며 Literature에서는 오히려 더 쓴다. GraphCounselor 131.6K/109.9K보다 훨씬 짧지만, 이 숫자는 QA 생성·재실행·로컬 의미 심사·GRPO까지 포함한 총비용이 아니다.
4B 실험은 A40 네 장과 RAM 1TB, 8B는 A800-SXM4-80GB 네 장과 RAM 1TB 환경에서 수행됐다(Table 10). 로컬 배포 가능성과 작은 모델이라는 설명을 저사양 개인 장비에서 전체 학습이 쉽다는 주장으로 바꾸면 안 된다. wall-clock·전력·총 GPU 시간과 실제 금전 비용의 직접 비교는 제공되지 않는다.
9. 인증이 보장하지 않는 것과 벤치마크의 한계
9.1 논문이 직접 밝힌 경계
- accepted strict·partial 어느 쪽도 무오류 Judge나 형식적으로 증명된 인과 계보를 뜻하지 않는다(p. 12).
- 별도 QA 품질 Judge는 상대 비교 도구이지 보정된 참값 oracle이 아니다(Table 3).
- partial의 커버리지 분석은 한 biomedical 실행의 자료이며, Python 조합의 계보를 정적으로 증명한 것이 아니다(p. 15).
- 8B의 이득은 도메인에 따라 다르고 Healthcare에서는 하락한다(Table 7).
- Healthcare에는 Hard 문항이 없다. Literature의 Hard는 추천·외부 지식 성격이 강하고 비교한 모든 방법이 0점이어서 Figure 3에서 그리지 않았다(p. 14). Easy·Medium 그래프만 보고 모든 난도에 강하다고 하면 안 된다.
- Healthcare 270문항 중 56개가 관계 방향 역전 또는 집합 포함을 동등성으로 다루는 문제로 표시됐다(p. 15). 공식 결과에서는 그대로 유지했다. 제외한 214문항의 GraphCert 점수는 0.835/0.802지만 기준선을 재평가하지 않았으므로 순위에 사용하지 않았다.
마지막 처리가 중요하다. 비교군에 유리한 문제라고 주장하며 자기 점수만 수정해 새 순위를 만들지 않았다. 다만 이 56개는 저자들의 schema-grounded 검토 결과이지 별도 독립 심사로 확정된 벤치마크 오류 목록은 아니다.
9.2 해설자 관점: 외부 교사 없음과 외부 모델 없음은 다르다
학습 자료 입학 심사는 Quizzer와 같은 로컬 모델을 사용한다. 평가에서는 Qwen-Max로 QwenScore를 계산하고 DeepSeek-V4-Flash로 생성 QA 품질을 감사한다. ‘외부 교사 없이 학습한다’는 주장과 별개로 평가에는 다른 모델이 쓰인다. 다만 두 평가 모델의 실행 위치와 입력 데이터 전송 경로는 명시되지 않아, 실제로 그래프 정보가 외부 서비스에 전달됐는지 또는 평가까지 로컬에서 이루어졌는지는 판단할 수 없다.
생성자와 의미 심사자가 같은 모델이라 공유된 오해를 함께 통과시킬 수 있다. 전체 탐색 대화를 숨기고 실행 검사를 더하는 장치는 이 위험을 줄이는 설계지만 의미 오류의 독립성을 보장하지 않는다.
9.3 자료 누출 방어와 재현성
부록 p. 9는 생성 QA의 질문·답·표시 근거에 grounding된 개체 중 하나라도 공식 시험 질문에 나오면 후보를 버린다고 적는다. 명시적인 개체 중복 방어이며, 시험 답이나 템플릿을 Quizzer 프롬프트에 넣지 않는다고도 설명한다. 이를 누출 방어가 없다고 비판하는 것은 부정확하다.
동시에 시험 질문의 개체 목록을 쓰는 필터와 시험 집합과 무관한 자료 구성은 다르다. 개체 동명이인·별칭 매칭, 탈락 수, 간접적인 관계 패턴 중복까지 어떻게 다루는지는 더 확인해야 한다. 알려진 벤치마크에서의 개체 격리가 새로운 비공개 시험 집합으로의 일반화를 증명하지도 않는다.
논문은 코드가 공개될 예정이라고만 적는다. v1에서 실행 가능한 공식 코드 링크와 전체 데이터 manifest를 확인하지 못했으므로, 정적 deriver·sandbox·semantic Judge의 정확한 구현을 재현했다고 할 수 없다. 프롬프트 프로토콜과 하이퍼파라미터는 상세하지만 seed별 결과, 신뢰구간·유의성 검정, 전체 end-to-end 비용은 보고하지 않는다. 순위와 표시 점수는 확인할 수 있어도 작은 차이가 반복 실행에서 얼마나 안정적인지는 별도 문제다.
9.4 partial은 품질과 커버리지의 교환이다
한 biomedical 실행에서 partial을 더하면 계열 쌍 커버리지가 18→39로 늘고, one-hop 비중은 80.8%→60.1%, hybrid 질문 비중은 15.0%→27.4%가 된다(Figures 4–5). 저자들은 자료 수를 맞추거나 목표 계열에 맞는 사례만 비교해도 확장이 남는다고 설명한다. 그러나 그 세부 수치와 strict-only Solver의 성능은 제시하지 않는다.
따라서 partial이 다양한 구조를 보존한다는 근거와 partial이 최종 성능을 높인다는 근거를 구분해야 한다. 표면적으로 가장 검증하기 쉬운 one-hop 문제만 남기면 학습 범위가 좁아진다는 설계 문제는 설득력 있지만, 다양성과 의미적 오류 위험의 최적 교환점을 이 논문이 확정한 것은 아니다.
10. 실행 가능한 자기 학습의 가치와 적용 조건
GraphCert의 장점은 작은 모델이 만든 답을 자기 확신만으로 다시 학습하지 않는 데 있다. 실제 질의 결과를 출처가 있는 객체로 기록하고, 재실행·스키마·완전성 검사를 거친 뒤, 남은 의미 문제를 분리해서 심사한다. Solver에게는 정답 근거를 숨기면서 그 구조를 학습 신호로 사용한다.
관측된 성능 이득은 크고, 도메인 밖 평가에서도 학습 전보다 높은 점수가 남는다. 그러나 성공의 단위는 ‘완전 자동 형식 인증’이 아니라 실행 검사, 모델 의미 심사, 부분 인증의 수용, 구조 보상의 조합이다. 인증 제거 절제도 그 묶음의 여러 부분을 동시에 바꾼다.
후속 평가에서 중요한 비교는 명확하다. 같은 생성 제어를 유지한 실행 인증·의미 심사의 분리 절제, strict-only와 strict+partial의 동일 예산 학습, 동치 질의 분해에 대한 보상 민감도, 같은 환경에서 재실행한 기준선과 전체 비용이다. 이 조건들이 갖춰져야 ‘작은 모델의 실행 기반 자기 학습’이 어느 정도의 신뢰성과 비용으로 재사용되는지를 더 정확히 판단할 수 있다.
References
Feng, Y., Papicchio, S., & Rahman, S. (2025). CypherBench: Towards precise retrieval over full-scale modern knowledge graphs in the LLM era. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 8934–8958). Association for Computational Linguistics.
Jiang, W., Ying, Y., Wang, R., Chen, K., Hu, B., Liu, S., Wang, Y., & Zheng, T. (2026). GraphCert: Bootstrap agentic graph reasoning with certified evidence rubrics [Preprint]. arXiv. https://arxiv.org/abs/2609.38798v1
Jin, B., Xie, C., Zhang, J., Roy, K. K., Zhang, Y., Li, Z., Li, R., Tang, X., Wang, S., Meng, Y., & Han, J. (2024). Graph chain-of-thought: Augmenting large language models by reasoning on graphs [Preprint]. arXiv. https://arxiv.org/abs/2404.07103
Ying, Y., Jiang, W., Zheng, T., Wang, Y., Liu, S., Chen, K., & Song, M. (2026). GraphScout: Empowering large language models with intrinsic exploration ability for agentic graph reasoning [Preprint]. arXiv. https://arxiv.org/abs/2603.01410
관련 연구의 확인 범위: GraphScout·GraphCoT는 arXiv 서지 정보도 확인했다. GraphCounselor(ACL 2025)와 이 논문의 GraphRAG 기준선이 인용하는 Language Is All a Graph Needs(Findings of EACL 2024)는 원문 참고문헌 pp. 8–9와 기준선 설명 pp. 13–14에 따라 소개했다. 이 리뷰에서 해당 선행 논문 전체를 별도로 재검증한 것은 아니다.