Concept-Grounded Attention: A Controlled Evaluation of Graph-Injected Attention, Temporal Versioning, and Epistemic Status
그래프를 주의에 넣으면 정말 그래프를 쓸까 — Concept-Grounded Attention 쉽게 읽기
Concept-Grounded Attention은 개념 그래프를 트랜스포머 계산에 넣지만, 대조 실험에서 주의 편향은 원래 모델에도 있었고 추가 학습 이득 대부분은 엇갈린 개념으로도 나타났다. 날짜와 확인 상태를 입력에 명시한 결과는 더 분명했지만, 평가 범위는 제한적이다.
Paper: Sachin Dev Duggal; Pradyumna Swarnalatha Ramanna; Alexandros Vassiliades (2026). “Concept-Grounded Attention: A Controlled Evaluation of Graph-Injected Attention, Temporal Versioning, and Epistemic Status.” arXiv:2609.38684v1 · PDF. 이 글은 2026년 9월 30일 공개된 v1을 기준으로 한다.
이 글은 논문의 질문과 결과를 수식 없이 설명한다. 실험표의 조건, 수치의 분모, 저자 주장과 별도 해석의 구분은 상세 읽기에서 다룬다. 논문 실험을 독립 재현한 것은 아니다.
요점부터 말하면, 개념 그래프를 모델의 주의 계산에 넣었다고 해서 모델이 그 그래프를 실제로 활용한다고 볼 수는 없다. 저자들이 장치를 끈 대조군과 질문에 맞지 않는 개념을 넣은 대조군을 함께 시험하자, 눈에 띄던 주의 패턴은 원래 모델에도 있었고 학습 모듈의 이득 대부분은 엇갈린 개념으로도 나타났다. 반면 날짜나 확인 상태를 입력에 명시하는 방식은 일부 평가에서 도움이 됐다. 이는 주의 구조의 성공이라기보다 정보를 표현하는 방식의 효과다.
1. 그래프를 모델 안으로 가져오려는 이유
GraphRAG는 보통 지식 그래프를 검색에 이용한 뒤, 찾아낸 내용을 문장으로 바꾸어 언어 모델에 전달한다. 이 논문은 그 다음 단계를 바꾸려 한다. 개념 사이의 관계, 시간에 따른 변경, 근거가 확인됐는지 여부를 모델이 계산하는 과정에 직접 넣으면 답변이 나아질까?
저자들은 두 방법을 제안한다. 하나는 그래프 관계에 따라 토큰 사이의 주의 점수를 조정하는 방식(Form A)이고, 다른 하나는 검색된 개념 노드를 별도 주의 경로로 읽게 하는 방식(Form B)이다. 이와 함께 개념을 고정된 문서 조각이 아니라 지속 ID, 시간 버전, 출처와 확인 상태를 가진 대상으로 표현하는 Concept Lifecycle Model(CLM)을 정의한다.
아이디어는 그럴듯하지만, 검증에는 까다로운 대조군이 필요하다. 모델이 정답 근거에 해당하는 단어를 더 많이 보더라도 그게 새 모듈 때문인지, 사전학습 때부터 그 단어들이 서로 가깝거나 중요한 위치에 있었기 때문인지는 별개의 질문이다.
2. 눈에 띄는 주의 패턴은 모듈 없이도 나타났다
저자들은 MuSiQue와 HotpotQA에서 고른 200개 질문을 사용하고, 검색 결과를 고정한 채 작은 생성 모델(flan-t5-small, 77M)에 주의 모듈을 붙였다. 먼저 Form A를 켠 조건에서 모델은 정답 개념 토큰 쌍에 방해 개념 쌍보다 평균 2.758배의 주의를 보냈다. 이 수치만 보면 그래프 모듈이 정답 개념을 강조한 듯하다.
하지만 같은 입력에서 Form A를 끄자 비율은 2.759였다. 두 조건의 차이는 사실상 없었다. 학습된 그래프 편향은 모델의 주의 점수에 비해 매우 작았고, 200개 질문 가운데 답을 바꾼 사례도 없었다. 편향을 크게 키우자 일부 답은 달라졌지만 전체 점수는 오히려 나빠졌다.
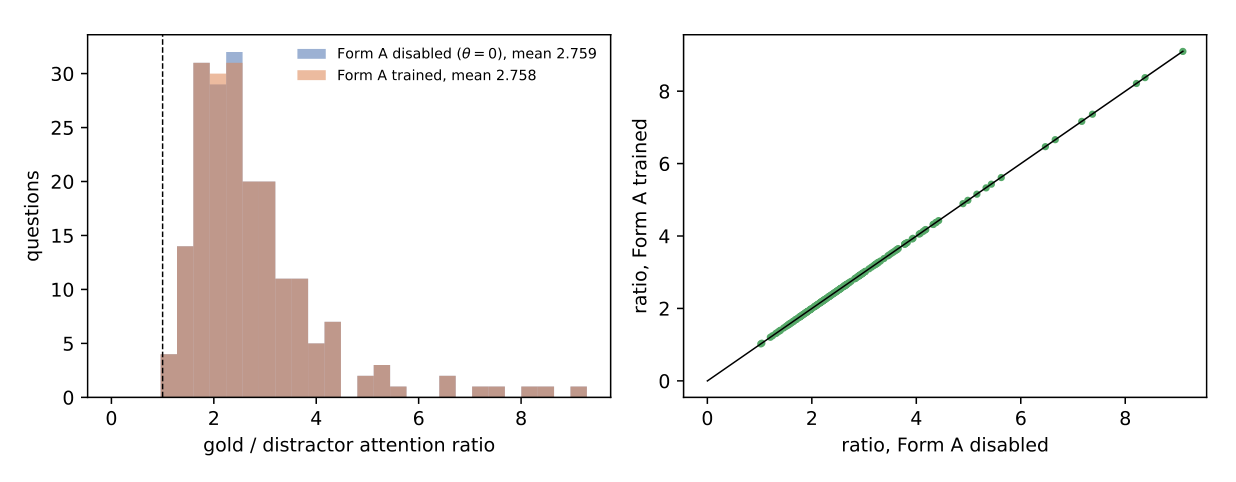
Figure 1. 왼쪽은 Form A를 끈 조건(평균 2.759)과 학습한 조건(2.758)의 질문별 정답/방해 주의 비율 분포다. 오른쪽에서는 두 조건의 값이 대각선에 거의 겹친다. 따라서 정답 쪽 주의 편향은 이 실험에서 Form A가 새로 만든 효과라고 보기 어렵다. Duggal et al. (2026), arXiv v1, p. 28, Figure 1을 인용했다.
이 결과는 “주의는 아무 의미가 없다”는 증명이 아니다. 이 논문이 보여 주는 더 좁고 중요한 점은, 주의 패턴을 제시할 때 모듈을 끈 기준선과 비교하지 않으면 모듈의 기여를 판별하기 어렵다는 것이다.
3. 학습 이득은 개념을 바꿔도 상당 부분 남았다
Form B는 검색한 개념 노드를 추가 주의 경로로 읽는다. 첫 구현은 생성 성능이 거의 무너졌지만, 저자들은 원인을 개념 정보가 아니라 사전학습 모델의 잔차 표현을 바꾸는 추가 정규화에서 찾았다. 정규화를 빼고 원래 계산을 보존하는 수정판에서는 기준 모델의 F1 0.188이 3 epoch 학습 뒤 0.221로 올랐다.
그 숫자만으로 개념 노드가 도움이 됐다고 결론내릴 수는 없다. 그래서 저자들은 질문에 맞는 개념 대신 다른 질문의 개념을 넣었다. 이 엇갈린 대조군도 F1 0.213을 기록했다. 실제 개념을 쓴 조건과 차이는 통계적으로 유의하지 않았다. 더 큰 flan-t5-base 모델에서는 실제 개념과 엇갈린 개념의 결과가 같았다.
따라서 모듈을 추가해 점수가 올랐다는 사실과, 모듈이 올바른 지식 정보를 사용했다는 주장은 구분해야 한다. 이 평가에서는 추가 용량이나 학습 효과로 설명할 수 있는 개선이 상당했고, 개념에 맞는 정보의 독립적인 기여는 확인되지 않았다.
4. 더 분명한 효과는 정보를 입력에 적어 준 데서 나왔다
논문은 시간 정보와 확인 상태도 시험한다. LongMemEval의 211개 질문에서는 같은 대화 기록에 날짜를 붙여 시간순으로 제시했을 때, 날짜가 없는 조건보다 판정 정확도가 생성 모델에 따라 12.8~25.1%포인트 높았다. 그러나 저자들이 제안한 단순화된 CLM 버전 해소는 날짜를 붙인 방식보다 일관되게 낫지 않았다. 개념이 서로 다른 표현으로 나타날 때 같은 대상을 안정적으로 알아보지 못한 점도 한계로 보고됐다.
확인 상태 실험에서는 가상 기업과 가상 매체를 사용했다. 여러 매체가 보도해도 소유 관계가 같다면 독립된 확인으로 세지 않는 규칙을 적용하고, 그 계산 결과를 모델 입력에 명시했다. 합성 과제의 소형 모델에서는 근거 없는 단정률이 원문·등록부를 그대로 준 조건의 28.1%에서, 상태를 명시한 조건의 0.1%로 낮아졌다.
다만 이 수치를 실제 뉴스나 실제 지식 그래프에서 같은 효과가 난다고 일반화할 수는 없다. 데이터는 합성이며, 평가 범주 자체가 그 확인 규칙에 맞춰 구성됐다. 또 상태를 명시하는 입력은 주의 메커니즘 실험과 별개다. 여기서 얻는 교훈은 모델이 출처 독립성을 항상 잘 추론한다는 것이 아니라, 확인 절차의 결과를 명시적으로 전달하면 이 통제된 과제에서 출력이 달라졌다는 것이다.
5. 어디까지 말할 수 있나
이 논문의 강점은 새 주의 구조의 성공을 주장하기보다, 구조가 실제로 기여했는지 확인할 대조군을 둔 데 있다. 읽을 때는 세 가지를 구분하면 된다.
- 정답 개념을 더 보는 현상은 모듈이 꺼진 상태에서도 나타났다.
- Form B의 개선은 질문과 무관한 개념을 넣은 대조군에서도 대부분 남았다.
- 날짜와 확인 상태를 입력에 표현한 결과는 긍정적이지만, 시간 버전 해소와 실제 자료의 출처 판정은 충분히 검증되지 않았다.
실험은 작은 생성 모델의 200개 다중 홉 질문, LongMemEval의 oracle 세션, 합성 확인 상태 과제에 제한된다. 대형 모델에서 그래프 주의 모듈을 직접 시험한 것도 아니다. 그러므로 이 연구를 “그래프를 주의에 넣으면 성능이 오른다”는 증거로 읽기는 어렵다. 더 타당한 결론은 시간과 근거 상태를 분명히 표현하는 일은 유망하지만, 그래프 구조를 주의 계산에 주입하는 효과는 이 평가에서 입증되지 않았다는 것이다.
같이 읽기: Microsoft GraphRAG · Declarative Attention
References
Duggal, S. D., Swarnalatha Ramanna, P., & Vassiliades, A. (2026). Concept-grounded attention: A controlled evaluation of graph-injected attention, temporal versioning, and epistemic status [Preprint]. arXiv. https://arxiv.org/abs/2609.38684v1