Concept-Grounded Attention: A Controlled Evaluation of Graph-Injected Attention, Temporal Versioning, and Epistemic Status
Concept-Grounded Attention은 개념 그래프를 트랜스포머 계산에 넣지만, 대조 실험에서 주의 편향은 원래 모델에도 있었고 추가 학습 이득 대부분은 엇갈린 개념으로도 나타났다. 날짜와 확인 상태를 입력에 명시한 결과는 더 분명했지만, 평가 범위는 제한적이다.
Paper: Sachin Dev Duggal; Pradyumna Swarnalatha Ramanna; Alexandros Vassiliades (2026). "Concept-Grounded Attention: A Controlled Evaluation of Graph-Injected Attention, Temporal Versioning, and Epistemic Status". SeKondBrain AI Labs. arXiv:2609.38684v1. PDF · 서지 정보. 42쪽의 v1을 기준으로 읽는다. 1쪽의 게재 표기는 Research Article (2026), xx:xx –라는 빈 템플릿이며 게재처는 확인되지 않는다.
Abstract: GraphRAG 계열은 그래프로 검색한 뒤 결과를 텍스트로 풀어 모델에 넣는다. 이 논문은 개념을 시간 버전·출처·확인 상태를 가진 지속 객체로 보는 Concept Lifecycle Model(CLM)을 정의하고, 개념 그래프를 주의 계산 안에 직접 넣는 Concept-Grounded Attention(CGA)의 두 형태를 제안한다. 평가의 중심은 제안 기법의 성능 자랑이 아니라 메커니즘을 끈 같은 조건의 대조군이다. 그 대조군 앞에서 그래프 편향 주의(Form A)의 '정답 개념 쪽 주의 2.76배'는 사전학습 모델에 원래 있던 성질로 드러났고, 개념 교차주의(Form B)의 F1 이득은 대부분 다른 질문의 개념을 넣어도 재현됐다. 긍정적 결과는 주의 메커니즘이 아니라 입력 표현 쪽에 있다. 날짜를 붙이면 LongMemEval 정확도가 생성기에 따라 12.8–25.1점 오르고, 프로토콜로 계산한 확인 상태를 주면 합성 과제의 근거 없는 단정이 거의 사라진다. 이 글은 무엇이 지지되고 무엇이 지지되지 않았는지를 나누고, 표제 수치의 분모·판정자·과제 구성이 결과의 해석 범위를 어떻게 좁히는지 살핀다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 질문 | 개념 그래프의 구조·시간·확인 상태를 주의 계산 안에 넣으면 모델의 출력이 달라지는가, 아니면 내부 주의 분포만 달라지는가? |
| 제안 | CLM(지속 ID·이중 시간 버전·4단계 확인 상태를 가진 개념 그래프)과 CGA(Form A: 주의 로짓에 그래프 편향 가산, Form B: 개념 노드에 대한 게이트 교차주의). |
| 평가 설계 | 다중 홉 QA는 검색 결과를 고정하고 동결한 flan-t5-small(77M)에 모듈만 붙인다. 모든 주의 진단을 메커니즘을 끈 조건과 짝지어 잰다. |
| Form A | 정답/방해 개념 주의 비율 2.758(켬) vs 2.759(끔). 학습된 편향은 로짓 표준편차의 4.6×10⁻⁴배이고 200문항 중 바뀐 답은 0개. 키우면 성능이 떨어진다. |
| Form B | 첫 구현은 사전학습 계산을 보존하지 않는 정규화 때문에 F1 0.006으로 붕괴. 수정판 3 epoch는 0.188→0.221이지만 다른 질문의 개념으로도 0.213. 교차 인코더 사전분포의 경계선 이득(+0.010, p=0.050)은 flan-t5-base에서 재현되지 않았다. |
| 시간 | LongMemEval 211문항에서 날짜를 붙이면 LLM 판정 정확도가 +12.8(flan-t5-large)~+25.1점(gpt-oss-120b). 이 판정에서는 CLM 해소와 날짜 직렬화의 전체 정확도 차이가 유의하지 않지만, flan-t5-large의 포함 기준에서는 CLM이 더 낮다. |
| 확인 상태 | 소형 모델은 원문 28.1%·상태 없는 그래프 23.6%에서 상태 입력 0.1%로, 대형 모델은 원문 19–54%·상태 없는 그래프 66–68%에서 상태 입력 0–5%로 변했다. 분모는 전체 500건이 아닌 오류 가능 세 범주 300건과 정합적이다(§8.3). |
| 남는 교훈 | 주의 진단에는 메커니즘을 끈 대조군이, 학습형 지식 모듈에는 지식을 엇갈려 넣은 대조군이 필요하다. 시간과 확인 상태는 주의 메커니즘보다 입력 표현으로 넣을 때 효과가 관찰됐다. |
읽기 안내: 모든 성능 수치는 저자 보고다. 모델 실험은 다시 돌리지 않았고, 표 사이의 산술과 분모만 다시 계산했다.
목차
- 그래프를 주의 안에 넣으면 모델이 그래프를 쓰게 될까
- 개념을 시간과 확인 상태를 가진 객체로 만든다
- 그래프를 주의에 넣는 두 가지 방법
- 무엇을 고정하고 무엇을 끄고 비교했는가
- 경로는 찾지만 근거 재현율은 오르지 않는다
- Form A: 끄고 재도 같은 주의 비율
- Form B: 붕괴의 원인과 추가 용량 대조
- 시간과 확인 상태는 입력 표현으로 효과가 있었다
- 논문이 밝힌 한계와 더 확인할 것
- 주의 진단은 대조군과 함께 읽는다
1. 그래프를 주의 안에 넣으면 모델이 그래프를 쓰게 될까
MS GraphRAG, HippoRAG, LightRAG는 그래프를 색인·검색 단계에서 쓰고, 생성 모델이 받는 것은 결국 텍스트다. 저자들은 이 변환 과정에서 그래프 위상과 시간 유효성, 근거의 질이 모델 내부 계산에 직접 닿지 못한다고 본다. 그래서 그래프를 Graphormer식 주의 편향과 개념 노드 교차주의로 계산 안에 넣자고 제안한다.
이 제안에는 바로 검증 문제가 따른다. 주의를 바꾸는 모듈은 정의상 주의를 바꾼다. 정답 근거와 연결된 토큰에 주의가 더 몰렸다는 관찰은 모듈이 작동한다는 증거처럼 보이지만, 사전학습 모델이 원래 그런 토큰을 더 본다면 모듈 없이도 같은 그림이 나온다. 주의 가중치를 설명으로 읽을 때의 오래된 논쟁(Jain & Wallace, 2019; Serrano & Smith, 2019; Wiegreffe & Pinter, 2019)이 그대로 적용된다.
논문의 실질적 기여는 이 지점에 있다. 저자들은 모든 내부 진단을 같은 입력에서 메커니즘을 끈 측정과 짝짓고, 학습형 모듈의 이득은 다른 질문의 개념을 넣은 대조와 비교했다. 제목은 새 주의 구조를 앞세우지만, 결과 대부분은 그 구조가 기대한 일을 하지 않았다는 통제된 음성 결과다. 저자들도 결론에서 이를 숨기지 않는다.
2. 개념을 시간과 확인 상태를 가진 객체로 만든다
2.1 개념 튜플과 이중 시간
CLM에서 개념은 문서 조각이 아니라 지속 ID를 가진 객체다.
C_i=(id_i,\ \mathbf z_i,\ \mathcal N_i,\ b_i,\ \mathcal V_i,\ \Pi_i,\ s_i)| 요소 | 뜻 |
|---|---|
id_i |
생애 내내 바뀌지 않는 식별자 |
\mathbf z_i |
근거 문장 임베딩의 중심(기본형) |
\mathcal N_i |
유형·가중치가 붙은 관계 |
b_i |
생성 방식·시점·최초 근거를 담은 불변 출생 기록 |
\mathcal V_i |
버전 이력. 각 버전은 valid time과 transaction time을 따로 가진다 |
\Pi_i |
관계·주장별 출처와 확인 상태 |
s_i |
active / archived / invalidated / pruned |
valid time은 그 상태가 도메인에서 참인 기간이고, transaction time은 시스템이 기록한 시점이다. 이 둘을 나누면 늦게 도착한 근거나 소급 정정을 표현할 수 있다. 시점 t_q의 질의는 t_q 이전에 유효해진 버전 중 가장 늦은 것으로 해소한다.
\mathrm{Resolve}(C_i,t_q)=\arg\max_{v\in\mathcal V_i}\{t_{\text{valid}}(v)\mid t_{\text{valid}}(v)\le t_q\}개념의 출생(임베딩 밀도·추출 반복·계층 분할·그래프 예측), 점진적 변화와 불연속 변화의 구분, 보관과 가지치기 규칙도 수식으로 정의한다(pp. 9–11).
2.2 확인 상태는 모델 확신도가 아니라 절차에서 나온다
관계마다 hypothesised / validated / promoted / invalidated 중 하나의 상태가 붙는다. 상태를 정하는 것은 추출 모델의 점수가 아니라 확인 규칙이다. 기본 규칙은 서로 독립인 출처 계열(source family)이 n_{\text{indep}}개 이상이거나, 사람의 확인 또는 신뢰된 구조화 출처의 확인이 있으면 검증된 것으로 본다(부록 A.1, 식 A.4). 같은 소유주의 매체, 재게재 사슬, 근사 중복은 한 계열로 묶는다.
상태는 주의 계수로 이어진다. validated·promoted는 1, hypothesised는 0<h_{ij}<1, invalidated는 현재 시점 질의에서 0이다(식 3.18).
2.3 정의된 것과 평가된 것은 다르다
프레임워크는 넓게 정의되지만 실험은 일부만 다룬다. 저자들도 이를 본문(p. 8)과 부록 A 제목("Formal Specification of Unevaluated Components")에서 밝힌다.
| 구성요소 | 평가 여부 |
|---|---|
| Form A·Form B | 다중 홉 QA, 검색 고정 조건에서 평가 |
| 개념 그래프 검색(Path A+B) | 경로·재현율 평가. 고정된 출력만 사용 |
| 시점 해소(Path C, Resolve) | 임베딩 유사도 기반 단순화판만 LongMemEval에서 평가 |
| 확인 규칙 | n_{\text{indep}}=2 규칙을 합성 그래프에서 평가 |
| 판정기(adjudicator), 경로 라우팅 | 평가하지 않음 |
| 시간·확인 상태·라우팅 학습 목적함수 | 실험에 쓰지 않음(p. 21) |
| 개념 출생·표류·분할의 생애 동역학, 대규모 그래프 | 평가하지 않음 |
다중 홉 실험에는 시간 앵커나 확인 상태 구분이 없어 모든 관계를 \alpha=1로 두고, 편향도 간선 강도와 경로 거리 두 항만 쓴다(p. 24). 따라서 주의 안의 시간·확인 상태 항은 어떤 실험에서도 시험되지 않았다. 시간과 확인 상태의 긍정적 결과(§8)는 모두 텍스트 입력 형식의 비교에서 나온다.
3. 그래프를 주의에 넣는 두 가지 방법
3.1 Form A: 주의 로짓에 그래프 편향을 더한다
토큰 i,j가 각각 개념 C_a,C_b에 연결되면 두 토큰 사이 로짓에 편향을 더한다.
B_G[i,j]=\mu_i\mu_j\big(\theta_1\tilde w_{ab}+\theta_2\phi_{\text{path}}+\theta_3\phi_{\text{central}}+\theta_4\phi_{\text{time}}\big),\qquad
H_A=\mathrm{softmax}\!\Big(\tfrac{QK^\top}{\sqrt{d_h}}+B_G\Big)V\mu는 토큰-개념 연결의 확신도이고, 연결되지 않은 토큰 쌍의 편향은 0이다. \theta는 0 근처에서 시작해 학습한다. 구조는 Graphormer(Ying et al., 2021)의 공간 편향과 같은 계열이다.
3.2 Form B: 개념 노드에 대한 게이트 교차주의
검색된 개념마다 의미 임베딩·구조 부호·시간 상태·확인 상태·질의 관련도를 합친 벡터를 만들고, 토큰 표현이 이 노드들을 교차주의로 읽는다. 노드별 게이트 g_j=r_j\cdot a_j\cdot\alpha_j를 로그 사전분포로 더한다.
S_B=\frac{Q_AK_c^\top}{\sqrt{d_h}}+\mathbf 1_n\log(\mathbf g+\epsilon)^\top,\qquad
H_{\text{CGA}}=H_A+\boldsymbol\eta\odot H_B,\qquad
\tilde H^{(\ell)}=H^{(\ell)}+H_{\text{CGA}}
Form A가 이미 입력에 있는 개념 사이의 관계를 강조한다면, Form B는 입력 텍스트에 없는 그래프 정보를 공급하도록 설계됐다.
3.3 정규화를 덧붙이지 말라는 조건은 실패에서 나왔다
§3.4.4는 사전정규화(pre-LN) 트랜스포머의 잔차 흐름에 정규화를 추가하지 말고, 게이트를 거의 닫힌 상태(b_\eta\ll0)로 시작하라고 명시한다. 이는 삽입 직후 계산을 사전학습 모델에 가깝게 유지하는 조건이다. 유한한 sigmoid 게이트는 정확한 0이 아니므로 수학적으로 완전히 같은 계산을 보장하지는 않는다. 저자들은 이 조건을 Form B 붕괴 진단과 연결하며 "Section 5.4 shows that violating this condition was sufficient to collapse generation"이라고 적는다. 연구 과정에서 이론과 진단 중 무엇이 먼저였는지는 단정하지 않는다.
4. 무엇을 고정하고 무엇을 끄고 비교했는가
4.1 세 실험의 설정
| 실험 | 데이터 | 생성기 | 비교 |
|---|---|---|---|
| 다중 홉 구조 | MuSiQue·HotpotQA 시험 200문항(2/3-hop, bridge, comparison 각 50) | flan-t5-small 동결, 384토큰, 탐욕 디코딩, M1 Max CPU | closed book, dense RAG, hybrid 그래프 검색, 직렬화 그래프, Form A/B/A+B |
| 시간 | LongMemEval oracle 세션의 knowledge-update 78 + temporal-reasoning 133 | flan-t5-large, 이후 qwen2.5-72b·gpt-oss-120b·qwen35-122b | 날짜 없음 / 날짜 붙임 / 최신 세션만 / CLM 해소 |
| 확인 상태 | 가상 기업·가상 매체의 합성 그래프, 시험 500(범주당 100) | flan-t5-small 3 epoch 미세조정, 대형 모델은 규칙을 지시문으로 제공 | 원문 보도+소유 등록부 / 출처 붙은 주장 / 프로토콜 상태 붙은 주장 |
저자 보고, §4.2–4.8.
다중 홉 시험 그래프는 spaCy 개체·명사구·핵심어를 개념으로, 공출현과 임베딩 유사도를 관계로 삼아 분할별로 만든다(MuSiQue 21,497개, HotpotQA 20,105개 개념). 정답 지지 문장은 평가용 정답 경로와 정답/방해 개념 라벨을 만드는 데만 쓴다.
4.2 대조군의 목록
이 논문을 읽을 가치는 대조군 설계에 있다.
- Form A를 끈 측정(
\theta=0): 모든 Form A 진단을 같은 입력에서 반복한다. - 편향 증폭: 학습된 계수를 10배부터 10⁴배까지 키운다.
- 손상 편향: 편향 행렬의 토큰 위치를 섞거나(random graph) 토큰-개념 연결을 뒤섞는다(shuffled links).
- Form B 게이트 0 강제: 개념 신호 없이 모듈의 구조적 영향만 본다.
- 엇갈린 개념: 각 질문에 다른 질문의 개념 노드·관련도·정답 라벨을 학습과 시험 모두에서 넣는다.
- 특징 섞기: 질의 조건부 Form A의 토큰별 특징을 무작위로 섞는다.
통계는 문항 단위다. 시드 3개(13, 42, 77)는 문항 안에서 평균한 뒤 10,000회 부트스트랩 95% CI와 양측 Wilcoxon 부호순위 검정을 쓴다. Form A는 동결 모델 위에서 결정론적 스칼라 둘만 학습하므로 세 시드가 같은 계수를 내고, 591개 문항-시드 관측을 197개 독립 문항으로 센다고 밝힌다(p. 27). 표본을 부풀리지 않는 처리다.
5. 경로는 찾지만 근거 재현율은 오르지 않는다
| 시스템 | EM | F1 | Passage R@5 |
|---|---|---|---|
| Closed book | 0.100 | 0.145 | – |
| Dense RAG | 0.110 | 0.164 | 0.687 |
| Hybrid 그래프 검색 | 0.130 | 0.188 | 0.662 |
| 직렬화 개념 그래프 | 0.135 | 0.178 | 0.662 |
| CGA-Form A | 0.130 | 0.188 | 0.662 |
| CGA-Form B (초기) | 0.000 | 0.006 | 0.662 |
| CGA-Form A+B (초기) | 0.000 | 0.006 | 0.662 |
저자 보고, Table 1, p. 27. flan-t5-small, 200문항.
그래프 검색은 dense 검색이 표현할 수 없는 명시적 개념 경로를 돌려준다. soft path recall 0.244, exact path recall 0.015이고, 홉이 늘면 soft 재현율이 떨어진다(MuSiQue 2-hop 0.310, 3-hop 0.112). 그러나 지지 문단의 Recall@5는 hybrid 0.662로 dense 0.687보다 낮다. 그래프 탐색이 dense가 놓친 문단을 찾아온 문항은 200개 중 6개이고, 지지하지 않는 문단을 하나 이상 끌어들인 문항은 170개다(p. 27).
그런데 F1은 hybrid가 0.188로 dense 0.164보다 높다. 저자들은 이 이득을 "지지 문단 재현율 향상으로 돌릴 수 없다"고만 쓰고 원인을 더 분해하지 않는다. 문단 순서, 같은 문단의 중복 제거, 384토큰 예산 안에서 잘리는 양이 달라졌을 가능성이 남는다. 경로를 텍스트로 붙인 직렬화는 F1이 0.178로 오히려 낮다. 저자들의 정리는 담백하다. 이 설정에서 그래프의 분명한 가치는 정확도가 아니라 검사 가능성과 출처 추적이다(§6.5).
절대 점수가 낮다는 점도 함께 봐야 한다. F1 0.19 수준에서는 메커니즘의 효과가 바닥 효과에 묻힐 수 있고, 저자들도 이를 한계로 적는다(§9.1).
6. Form A: 끄고 재도 같은 주의 비율
6.1 켠 조건만 보면 그래프가 주의를 이끈 것처럼 보인다
Form A를 켠 상태에서 정답 개념끼리의 토큰 쌍은 평균 주의 질량 0.008125, 방해 개념 쌍은 0.002959를 받았다. 비율 평균은 2.758(중앙값 2.46)이고, 두 유형의 쌍이 모두 있는 197문항 전부에서 1을 넘는다. 이 숫자만 보고하면 "그래프 편향이 주의를 정답 개념 쪽으로 이끈다"는 결론이 자연스럽다.
6.2 끈 조건이 같은 숫자를 낸다
\theta=0으로 끄고 다른 입력을 모두 같게 두면 평균 비율은 2.759다. 문항별 차이의 절댓값은 0.011을 넘지 않았고, 평균 차이는 −0.0012(95% CI [−0.0014, −0.0010])였다. 켰을 때 오히려 아주 약간 낮다.
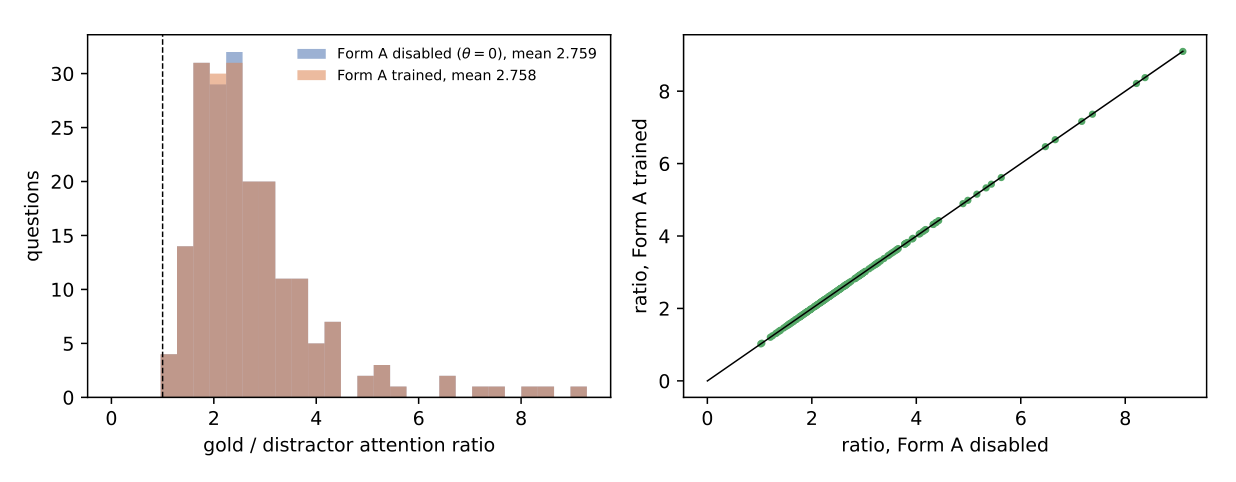
Figure 1. 왼쪽은 197문항의 정답/방해 주의 비율 분포(파랑: 끔, 주황: 켬), 오른쪽은 문항별 비교로 점들이 대각선에 거의 겹친다. 정확히 같은 값이라는 뜻은 아니며, 본문은 작은 음의 차이를 보고한다. 왼쪽 점선은 비율 1. 출처: Duggal et al. (2026), v1, p. 28, Fig. 1 — 연구·학습 목적 인용.
정답 개념 쪽 선호는 사전학습 encoder에 이미 있었다. 일부는 위치 효과다. 같은 개념 내부의 토큰 쌍을 빼면 비율이 2.29로, 방해 쌍을 정답 쌍과 같은 위치 거리 범위로 제한하면 2.03으로 내려간다. 정답 근거는 지지 문장 안에서 가까이 붙어 나오기 쉽기 때문이다.
6.3 편향이 너무 작고, 키우면 해롭다
매핑된 토큰 쌍의 평균 편향 절댓값은 0.0020이고, 수정된 층의 사전 softmax 로짓 표준편차는 4.30이다. 비율은 4.6×10⁻⁴다. 출력에서는 decoder 로짓의 최대 변화 중앙값이 0.006인데, 기준 답 상위 두 토큰 사이의 최소 여유 중앙값은 0.93이다. 변화가 여유를 넘은 문항은 200개 중 1개였고 탐욕 디코딩의 결정은 하나도 바뀌지 않았다.
정답 쌍의 편향(0.0025)이 방해 쌍(0.0018)보다 크긴 하다. 저자들은 이것도 학습이 아니라 그래프 구조 때문이라고 본다. 정답 개념은 지지 문장에서 함께 나오므로 공출현 간선이 더 강하다.
| 배율 | 평균 \lvert B_G\rvert |
바뀐 답 | F1 | 비율 |
|---|---|---|---|---|
| 0 | 0 | – | 0.188 | 2.759 |
| 1 | 0.002 | 0 | 0.188 | 2.758 |
| 10 | 0.020 | 2 | 0.188 | 2.748 |
| 100 | 0.196 | 9 | 0.190 | 2.648 |
| 1,000 | 1.957 | 122 | 0.157 | 2.257 |
| 10,000 | 19.57 | 136 | 0.111 | 2.445 |
저자 보고, Table 2, p. 28. 바뀐 답은 \theta=0 대비.
편향이 로짓과 비슷한 크기가 되는 10³배부터 답이 대량으로 바뀌고 F1이 떨어진다(10⁴배는 p=0.003). 정답/방해 주의 비율은 어느 배율에서도 오르지 않았다. 공출현 그래프에서는 방해 개념끼리도 연결돼 있어 편향이 비슷하게 돌아가기 때문이다. 저자들은 이 형태의 가산 편향이 학습된 크기에서는 너무 약하고, 큰 크기에서는 선택성이 부족하다고 정리한다.
6.4 질의 조건부 편향도 섞은 대조와 같다
진단을 반영해 질문과 관련된 개념 토큰 쪽으로 키 편향을 더하는 질의 조건부 Form A를 만들었다. 학습 결과 척도 \lambda가 −0.26~−0.52의 음수가 되어 모든 개념 토큰의 주의를 거의 균일하게 줄였다(정답 −0.176, 방해 −0.174). F1 +0.010은 특징을 섞은 대조에서 똑같이 나왔다. 관련도 특징 자체가 약했다. 정답 개념 토큰을 고르는 AUC가 임베딩 유사도 0.62, 그래프 근접도 0.54였고, 교차 인코더 점수(AUC 0.71)를 더해도 섞은 대조와의 차이는 −0.001(p=0.65)이었다.
저자들의 해석은 병목이 "구조가 주의에 들어가는 방식"보다 "질문에 어떤 개념이 중요한지 정하는 일"에 있다는 것이다(§6.1). 다만 이 결론은 77M 생성기, 공출현 기반 개념 그래프, 384토큰이라는 조건 위의 것이다.
6.5 몇 자릿수인가
초록과 결론은 학습된 편향이 로짓보다 "about four orders of magnitude" 작다고 쓴다. 본문 값 4.6×10⁻⁴의 상용로그는 −3.34이므로 세 자릿수 남짓이다. 결론을 바꾸는 차이는 아니지만 표현은 실제 비율보다 크다.
7. Form B: 붕괴의 원인과 추가 용량 대조
7.1 붕괴는 개념 신호가 아니라 정규화 때문이었다
초기 Form B는 encoder 은닉 상태와 게이트된 개념 신호의 합에 새로 초기화한 LayerNorm을 걸었다. flan-t5는 pre-LN 구조라 잔차 흐름은 정규화되지 않은 값을 나르는데, 이 정규화가 뒤의 모든 층이 받는 표현의 크기를 바꿨다.
| 변형 | 학습 문항 | F1 | ΔF1 | \rho |
게이트 | 정답/방해(개념당) |
|---|---|---|---|---|---|---|
| Form B 없음 | – | 0.188 | – | – | – | – |
| 초기 | 0 | 0.003 | −0.185 | 0.968 | 0.50 | 1.15 |
초기, \eta=0 |
0 | 0.003 | −0.185 | 0.968 | 0.00 | 1.15 |
| 초기 | 60 | 0.005 | −0.183 | 0.968 | 0.62 | 2.47 |
| 항등 보존 | 0 | 0.188 | 0.000 | 0.000 | 0.02 | 1.19 |
| 항등 보존 | 60 | 0.188 | 0.000 | 0.000 | 0.34 | 2.53 |
| 항등 보존 | 500 | 0.195 | +0.008 | 0.0003 | 0.53 | 3.51 |
+ top-8, \lambda_B=1 |
500 | 0.194 | +0.006 | 0.0002 | 0.53 | 3.60 |
저자 보고, Table 3, p. 29. \rho: Form B 층 은닉 상태의 상대 변화. 세 시드 평균.
학습 전에 이미 은닉 상태가 노름의 97% 바뀌었고 빈 답이 41개 나왔다. 게이트를 0으로 강제해도 결과가 같다는 행이 결정적이다. 개념 신호가 0이어도 붕괴하므로 원인은 정규화다. 정규화를 빼고 H+\eta\odot H_B를 계산하며 게이트를 닫아 시작한(bias −4) 항등 보존판은 학습 전 기준 답을 그대로 재현했다.
진단은 두 번째 오해도 바로잡는다. 정답 개념은 검색된 개념의 24%뿐이어서 전체 주의 질량은 방해 개념에 더 많이 간다. 개념 하나당으로 보면 학습된 모듈은 정답 개념을 2.5–3.5배 더 본다. 붕괴는 관련도 학습의 실패가 아니라 구조의 실패였다.
Table 1의 초기 Form B F1 0.006과 Table 3의 0.003·0.005는 끝자리가 다르다. Table 1이 어느 시드·학습 조건의 값인지 본문에 명시되지 않는다. 결론을 바꾸지는 않지만 같은 모듈의 두 표 값이 바로 이어지지 않는다.
7.2 이득의 대부분은 다른 질문의 개념으로도 나온다
동결 모델에 학습 가능한 모듈을 붙이면 개념 정보와 무관하게 용량만으로 점수가 오를 수 있다. 저자들은 각 질문에 다른 질문의 개념 노드·관련도·정답 라벨을 학습과 시험 모두에서 넣는 대조를 만들었다.
| 구성 | F1 | Δ | 95% CI |
|---|---|---|---|
| Form B, 실제 개념, 1 epoch | 0.195 | +0.008 | [−0.002, 0.021] |
| Form B, 엇갈린 개념, 1 epoch | 0.195 | +0.008 | [−0.002, 0.021] |
| Form B, 실제 개념, 3 epoch | 0.221 | +0.033 | [0.007, 0.062] |
| Form B, 엇갈린 개념, 3 epoch | 0.213 | +0.025 | [−0.003, 0.056] |
| Form B, 교차 인코더 사전분포, 3 epoch | 0.221 | +0.033 | [0.008, 0.061] |
| 같은 조건, 엇갈린 개념 | 0.211 | +0.023 | [−0.004, 0.051] |
| flan-t5-base 기준(Form B 없음 0.276) | |||
| Form B, 교차 인코더 사전분포, 3 epoch | 0.281 | +0.005 | [−0.001, 0.013] |
| 같은 조건, 엇갈린 개념 | 0.281 | +0.005 | [−0.001, 0.013] |
저자 보고, Table 4 일부, p. 30. Δ는 같은 모델에서 메커니즘이 없을 때 대비 paired F1 차이.
epoch에서는 엇갈린 개념이 실제 개념의 이득을 정확히 재현했다(200문항 중 198문항의 답이 같음). 3 epoch에서 실제 개념의 +0.033은 유의하지만(p=0.024), 엇갈린 개념도 +0.025를 낸다. 실제−엇갈림 차이는 +0.008(CI [0.000, 0.020], p=0.09)로 유의하지 않다. 표시된 개선량을 나누면 엇갈린 조건의 이득은 실제 조건의 약 76%다. 이는 개선을 구성요소별로 인과 분해한 비율이 아니라, 질문에 맞는 개념 없이도 상당한 개선이 남는다는 대조다. 테스트 집합 평균의 개념별 주의도 실제와 엇갈린 조건에서 같았다. 저자들은 선택성이 질문보다 개념 특징 자체에 의존한다고 해석한다.
교차 인코더 관련도를 사전분포로 쓰자 처음으로 개념 고유 차이가 나왔다. 0.221 대 0.211, +0.010(95% CI [−0.000, 0.024], Wilcoxon p=0.050)이다. 저자들은 이 차이가 8문항(7개 개선, 1개 악화)에서만 나왔고, 이 절의 비교 수를 보정하면 유의하지 않다고 스스로 적는다. flan-t5-base로 반복하자 실제와 엇갈린 개념이 모두 0.281이었다(차이 −0.0003, p=0.66, 198/200 동일). 저자들의 결론은 "우리 실험에서 두 주의 메커니즘 모두 개념 정보를 측정 가능하게 쓰지 않았다"이다.
7.3 같은 상대 깊이라는 설명은 층 수와 맞지 않는다
flan-t5-base 실험은 Form B를 encoder 8·9층에 두고 이것이 flan-t5-small의 4·5층과 "같은 상대 깊이"라고 쓴다(p. 30). 논문이 지정한 revision의 공개 설정에서 small 0fc9ddf의 num_layers는 8, base 7bcac57는 12다. 첫 삽입 위치만 보아도 1부터 세면 4/8=0.50과 8/12≈0.67, 0부터 세면 5/8=0.625와 9/12=0.75로 다르다. 층 번호 기준과 실제 코드가 없어 오기인지 다른 의미의 깊이인지는 확정할 수 없다. 이는 외부 설정을 이용한 확인이며, base에서 실제·엇갈린 개념의 점수가 같다는 관측 자체를 뒤집지는 않는다.
7.4 비용은 있고 이득은 없다
Form A는 hybrid 대비 질의당 평균 21.4ms(16.0%)를 더하고 P99에서는 293.6→451.0ms로 늘린다(Table 5). 피크 메모리는 약 2.21GB로 변화가 관측되지 않았다. 답을 하나도 바꾸지 않으므로 저자들 표현대로 이 비용은 출력 품질을 사지 않는다. CPU float32·소형 모델 측정이라 GPU 대형 모델의 비용 비율로 옮길 수는 없다.
8. 시간과 확인 상태는 입력 표현으로 효과가 있었다
8.1 날짜를 붙이는 것만으로 크게 오른다
LongMemEval의 oracle 세션에서 같은 사용자 발화 4개를 먼저 검색한 뒤 시간 표현을 바꿨다. 단, recency-only는 이 중 최신 세션의 발화만 남겨 실제 입력 근거가 줄어든다. 날짜 직렬화는 날짜뿐 아니라 시간순 정렬도 제공한다. CLM 해소는 임베딩 유사도 0.5 이상인 발화를 한 개념의 버전으로 묶고, valid time 순으로 최신을 current, 나머지를 superseded로 표시한다.
| 생성기 | 날짜 없음 | 날짜 붙임 | 최신 세션만 | CLM 해소 |
|---|---|---|---|---|
| flan-t5-large (780M) | 0.251 | 0.379 | 0.370 | 0.365 |
| qwen2.5-72b | 0.422 | 0.592 | 0.436 | 0.607 |
| gpt-oss-120b | 0.408 | 0.659 | 0.445 | 0.678 |
| qwen35-122b | 0.408 | 0.611 | 0.408 | 0.597 |
저자 보고, Table 8, p. 32. 211문항, gpt-oss-120b가 판정한 정확도.
이하 차이는 원문 본문 보고값을 유지한다. 표의 반올림된 값끼리 빼면 qwen2.5-72b의 날짜 이득은 17.0점, qwen35-122b는 20.3점, qwen2.5-72b의 CLM−날짜 차이는 1.5점이다. 원문 본문의 17.1·20.4·1.4점과의 차이는 211문항 정수 정답 수를 먼저 나눈 뒤 반올림하는 순서로 설명할 수 있다.
날짜를 붙이면 +12.8, +17.1, +25.1, +20.4점이다(모두 p<10⁻⁵). CLM 해소와 날짜 직렬화의 차이는 +1.4, +1.9, −1.4(대형), −1.4(flan-t5-large)로 어느 것도 유의하지 않다. knowledge-update 문항에서 qwen2.5-72b만 CLM이 +5.1점(p=0.046) 앞섰다. 포함 여부로 채점한 Table 6(flan-t5-large)에서는 CLM 0.379가 날짜 직렬화 0.403보다 유의하게 낮다(−0.024, p=0.025).
정확한 결론은 "시간을 표시하는 것이 효과적이고, 단순화한 CLM 해소의 추가 가치는 확인되지 않았다"이다. 초록의 "explicit temporal representation improves answer accuracy by 13 to 25 points"는 이 중 앞부분이다. 13–25는 Table 8의 날짜 붙임−날짜 없음이며, CLM 해소가 아니라 날짜 직렬화의 이득이다. 하한 13도 12.8의 반올림이다. 같은 생성기의 포함 기준 이득은 0.403−0.284=11.9점이고, §6.3은 이를 "roughly ten points"라고 쓴다. 한 논문 안에서 같은 효과가 판정 방식에 따라 10, 12.8, 13으로 서로 다르게 요약된다.
결론의 "most strongly for the largest models"는 대형 모델군이 소형보다 큰 이득을 보였다는 뜻으로 읽을 수 있다. 다만 파라미터 수에 따른 단조 증가를 뜻하지는 않는다. 가장 큰 이득은 120B의 25.1이고, 122B는 20.4다. 서로 다른 모델 계열의 비교여서 크기만의 인과 효과도 분리되지 않는다.
8.2 CLM 해소의 약점은 개념 동일성이다
dense 검색은 knowledge-update 문항의 19%에서 낡은 답을 맨 앞에 놓았다. 저자들은 이어 유사도 규칙이 최신 답 발화를 current 버전으로 표시한 비율을 23%라고 보고한다(p. 31). 여기의 "these questions"가 knowledge-update 전체인지 앞의 19% 부분집합인지 분모가 명료하지 않아 두 비율을 곱하거나 조건부 성공률로 확정하지 않는다. 같은 속성에 대한 말이 세션마다 다르게 표현되면 한 개념의 두 버전으로 인식되지 않는다는 것이 저자들의 진단이다. 주어-속성-값 단위로 동일성을 세운 뒤 대체를 적용하는 것을 후속 과제로 든다.
이는 HippoRAG 2를 읽을 때 남는 질문과 같은 자리다. 지속 기억을 말하려면 시간 충돌과 대체를 다뤄야 하고, 대체를 다루려면 무엇이 같은 대상인지부터 정해야 한다.
판정자 문제도 있다. Table 8의 판정자 gpt-oss-120b는 평가 대상 생성기 중 하나다. 저자들은 이를 한계로 적고, 포함 기준이 같은 질적 그림을 준다고 덧붙인다(§6.6). 포함 기준은 flan-t5-large에 대해서만 표로 제시된다(Table 6). 대형 모델의 포함 기준 수치는 본문에 없다.
8.3 확인 상태: 독립성 판정을 대신 해 주면 단정이 사라진다
합성 과제에서는 가상 기업의 관계를 네 출판 계열의 매체가 보도한다. 같은 계열의 매체는 이름이 서로 관련 없고, 계열 소속은 소유 등록부에만 적혀 있다. n_{\text{indep}}=2 규칙이 상태를 정한다. 범주는 validated, 같은 계열 두 매체만 보도한 hypothesised(기대 출력 "unconfirmed: 개체"), 경쟁 가설이 있는 validated, 철회된 주장("unknown"), 나중에 확인된 promoted의 다섯이다.
| 형식 | 정확도 | hypothesised 정확도 | 근거 없는 단정률 |
|---|---|---|---|
| 원문 보도 + 소유 등록부 | 0.802 | 0.157 | 0.281 |
| 출처 붙은 주장, 상태 없음 | 0.809 | 0.293 | 0.236 |
| 프로토콜 상태 붙은 주장 | 0.999 | 1.000 | 0.001 |
저자 보고, Table 7, p. 31. flan-t5-small, 2,000건 미세조정, 시험 500건, 세 시드 평균.
| 모델 | 지표 | 원문 | 상태 없음 | 상태 있음 |
|---|---|---|---|---|
| qwen2.5-72b | 정확도 | 0.798 | 0.566 | 0.986 |
| 근거 없는 단정 | 0.320 | 0.677 | 0.000 | |
| gpt-oss-120b | 정확도 | 0.770 | 0.566 | 0.864 |
| 근거 없는 단정 | 0.190 | 0.657 | 0.003 | |
| qwen35-122b | 정확도 | 0.586 | 0.590 | 0.920 |
| 근거 없는 단정 | 0.537 | 0.670 | 0.050 |
저자 보고, Table 9, p. 32. 미세조정 없음, 모든 형식 앞에 확인 규칙을 지시문으로 제공.
모델들은 같은 계열 두 매체의 보도를 독립 확인으로 취급했다. 규칙을 지시문으로 들은 72–122B 모델도 마찬가지였다. 상태 없음 형식에서는 철회된 주장에 기대는 경우도 거의 모든 invalidated 문항에서 나왔다(p. 32). gpt-oss-120b는 상태를 받고도 hypothesised에 "unconfirmed" 대신 "unknown"으로 답하는 경향이 있어 정확도가 0.864에 그쳤다. 이런 응답은 근거 없는 단정으로 세지 않지만, 전체 단정률은 0이 아닌 0.003이다.
비율의 분모. 표의 근거 없는 단정률은 시험 500건 전체가 아니라 세 범주(hypothesised·competing·invalidated) 300건 기준이라는 해석과 맞는다.
해석의 범위. 저자들이 직접 말하듯 이 실험의 범주는 CLM 규칙이 계산하는 바로 그 성질로 정의된다(§6.4). 상태 입력은 그 판정 속성을 명시해 과제를 단순화하고, 철회된 주장은 그 형식에서 제외한다. 따라서 상태 표시와 철회 주장 제거의 효과가 함께 들어 있다. 다만 출력은 확인 상태뿐 아니라 개체 선택도 채점하므로 단순한 전사 과제라고 할 수는 없다. 결과는 이 합성 과제에서 프로토콜의 계산 결과를 명시하는 것이 유효함을 보여 준다. 실제 코퍼스에서 공통 출처가 숨겨져 있고 등록부가 불완전할 때 독립성을 올바르게 판정한다는 증거는 아니며, 저자들도 이를 명시한다.
상태 없음 형식에 등록부가 있었는가. §4.6은 원문 형식을 "raw reports with the ownership registry", 그래프 형식을 "serialised claims with their sources but no status"로 설명한다. §5.8은 원문 시스템이 "every report and the ownership registry"를, 그래프 시스템이 "every claim with its sources"를 봤다고 쓴다. 같은 단락이 세 형식이 "the same information"을 담는다고 하지만, 그래프 형식 설명에서는 등록부가 언급되지 않는다. 등록부가 없었다면 그 형식의 모델은 계열 소속을 알 방법이 없어 hypothesised 실패가 판정 실패가 아니라 정보 부재가 된다. 대형 모델에서 상태 없음 형식의 단정률(66–68%)이 원문 형식(19–54%)보다 일관되게 높은 것은 이 해석과 어울리지만, 본문만으로는 확정할 수 없다.
9. 논문이 밝힌 한계와 더 확인할 것
9.1 논문이 밝힌 한계
§6.6과 본문 곳곳에서 저자들이 스스로 적은 한계는 다음과 같다.
- 다중 홉 실험의 생성기는 77M·250M이고 입력 예산은 384토큰이다. 절대 점수가 낮고, 큰 reader가 있어야 나타나는 효과는 보이지 않을 수 있다.
- 시험 200문항은 Form B 개선 같은 작은 차이를 잡기에 검정력이 부족하다.
- 시간 평가는 한 벤치마크의 oracle 세션이며, LLM 판정자 gpt-oss-120b가 평가 대상이기도 하다.
- CLM 해소 규칙은 생애 모델의 단순화판이다.
- 대형 모델은 추론 endpoint로만 접근해 층 내부를 고쳐야 하는 Form A·B를 그 규모에서 시험할 수 없었다.
- 확인 상태 평가는 합성이고, 범주가 CLM이 적용하는 규칙으로 정의된다.
- 판정기, 개념 출생·표류·분할의 생애 동역학, 대규모 그래프는 평가하지 않았다.
- 교차 인코더 사전분포의 +0.010은 8문항에서 나왔고 다중 비교 보정 후 유의하지 않다.
9.2 해설자 관점: 추가로 짚을 점
표현의 효과와 주의 주입의 효과를 구분한다. 지지된 긍정적 결과는 날짜와 확인 상태를 텍스트로 넣는 입력 표현에서 나온다. 다중 홉 실험에는 시간·확인 상태 차등 신호가 없으므로 주의 안에서 이들을 구분하는 효과는 검증되지 않았다. 이는 저자들의 결론("support the representational premises of the CLM ... more than ... the proposed mechanisms")과도 일치한다. CLM 표현의 유용성을 CGA 주의 구조의 성공으로 옮겨 읽지 않는 것이 중요하다.
대조군이 설계의 핵심인데 재현 자료는 요청 시 제공이다. 데이터 manifest와 문항별 출력은 "available from the authors on reasonable request"다(p. 26). 1쪽 링크는 ORCID 둘과 arXiv뿐이며, 검토한 v1에서 코드 저장소 링크는 확인하지 못했다. 이 논문의 가치가 대조 실험의 세부에 있으므로, 공개 여부는 다른 논문보다 더 중요하다. 대형 모델 식별자는 "as served by the endpoint"로만 적혀 있어 정확한 체크포인트를 특정하기도 어렵다.
표기·요약 수치의 해석 조건. 정상적인 반올림, 서로 다른 채점 기준, 추가 설명이 필요한 불일치를 구분해야 한다.
| 위치 | 원문 표현 | 표·산술 |
|---|---|---|
| 초록·§5.10·결론 | 편향이 로짓보다 "about four orders of magnitude" 작다 | 4.6×10⁻⁴ → 약 3.3자릿수 |
| 초록·결론 | 시간 표현이 "13 to 25 points" 향상 | Table 8 날짜 붙임 이득 12.8–25.1. CLM 해소가 아닌 날짜 직렬화의 이득 |
| §6.3 | flan-t5-large에서 "roughly ten points" | 판정 기준 12.8, 포함 기준 11.9 |
| 결론 | "most strongly for the largest models" | 대형 모델군의 이득은 크지만 크기별 단조 증가나 인과 효과는 아님 |
| §5.5 | base 8·9층이 small 4·5층과 "same relative depth" | encoder 층 수 8 vs 12 기준 0.50 vs 0.67(논문 밖 정보) |
| Table 1 vs 3 | 초기 Form B F1 0.006 | Table 3은 0.003(학습 전)·0.005(60문항) |
| Table 7·9 캡션 | 근거 없는 단정률 | 해당 세 범주 300건 분모와 정합적이나 캡션에 명시되지 않음 |
hybrid의 F1 이득은 설명되지 않은 채 남는다. 재현율은 낮은데 F1은 높다. 이 차이가 Form A·B의 주된 비교 기준선(hybrid)을 정하므로, 순서·중복·토큰 절단 중 무엇 때문인지 분해했다면 기준선의 의미가 더 분명해졌을 것이다.
하이퍼파라미터 탐색의 구별력이 제한됐다. Form A의 설정은 검증 데이터의 단계적 탐색으로 골랐는데 "all candidates tied"였다(p. 26). 보고된 검증 결과만으로는 선택한 후보가 다른 후보보다 낫다고 판단할 수 없다.
CLM 해소의 임계값. 유사도 0.5라는 동일성 기준의 선택 근거나 민감도 분석은 없다. 23%라는 낮은 동일성 성공률이 임계값의 문제인지 임베딩 방식의 문제인지는 이 실험에서 나눌 수 없다.
10. 주의 진단은 대조군과 함께 읽는다
이 논문은 새 구조를 제안하고, 그 구조가 기대한 일을 하지 않았다는 증거를 스스로 모았다. 그 과정에서 남는 교훈은 셋이고, 저자들이 결론에서 직접 정리한 것과 같다.
- 주의 진단은 메커니즘을 끈 측정과 짝지어야 한다. 지식 출처가 모델이 원래 보던 곳과 상관되면, 지식과 연결된 토큰에 주의가 몰리는 그림은 메커니즘 유무와 관계없이 나온다.
- 사전학습 모델에 넣는 모듈은 초기화 시점에 원래 계산을 보존해야 한다. 정규화 한 줄이 게이트 0에서도 생성을 무너뜨렸다.
- 학습형 지식 모듈의 이득은 엇갈린 지식을 넣은 같은 모듈과 비교해야 한다. 그렇지 않으면 추가 용량을 지식 활용으로 잘못 읽는다.
긍정적 결과는 더 소박하다. 시간 정보는 날짜만 붙여도 대형 모델에서 17–25점을 올렸고, 출처 독립성 판정은 모델에게 맡기기보다 명시적 절차로 계산해 넘기는 쪽이 이 과제에서 확실했다. 둘 다 그래프를 주의에 넣지 않고 텍스트로 넣었을 때의 결과다. 함께 읽을 만한 When to Use Graphs in RAG가 그래프가 도움이 되는 조건을 벤치마크로 재듯, 이 논문은 그래프를 계산 안에 넣는 접근이 어떤 대조 앞에서 살아남아야 하는지를 보여 준다. 모델이 무엇을 볼지 다루는 Declarative Attention과도 주의를 바꾸는 것과 출력을 바꾸는 것의 차이라는 같은 질문을 공유한다.
남은 질문은 저자들이 든 방향과 겹친다. 개념 노드가 문맥 밖의 정보를 실제로 담는 조건에서 Form B를 다시 재는 일, 속성 단위의 개념 동일성 위에서 버전 해소를 시험하는 일, 실제 코퍼스에서 출처 독립성을 판정하는 일이다. 그때도 메커니즘을 끈 측정과 엇갈린 지식 대조가 함께 보고되어야 결과를 해석할 수 있다.
References
Duggal, S. D., Swarnalatha Ramanna, P., & Vassiliades, A. (2026). Concept-grounded attention: A controlled evaluation of graph-injected attention, temporal versioning, and epistemic status [Preprint]. arXiv. https://arxiv.org/abs/2609.38684v1
Edge, D., Trinh, H., Cheng, N., Bradley, J., Chao, A., Mody, A., Truitt, S., Metropolitansky, D., Ness, R. O., & Larson, J. (2024). From local to global: A graph RAG approach to query-focused summarization [Preprint]. arXiv. https://arxiv.org/abs/2404.16130
Jain, S., & Wallace, B. C. (2019). Attention is not explanation. In Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (pp. 3543–3556). Association for Computational Linguistics. https://doi.org/10.18653/v1/N19-1357
Jiménez Gutiérrez, B., Shu, Y., Gu, Y., Yasunaga, M., & Su, Y. (2024). HippoRAG: Neurobiologically inspired long-term memory for large language models. In Advances in Neural Information Processing Systems (Vol. 37, pp. 59532–59569). Curran Associates.
Jiménez Gutiérrez, B., Shu, Y., Qi, W., Zhou, S., & Su, Y. (2025). From RAG to memory: Non-parametric continual learning for large language models. In Proceedings of the 42nd International Conference on Machine Learning (Vol. 267, pp. 21497–21515). PMLR.
Serrano, S., & Smith, N. A. (2019). Is attention interpretable? In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics (pp. 2931–2951). Association for Computational Linguistics. https://doi.org/10.18653/v1/P19-1282
Wiegreffe, S., & Pinter, Y. (2019). Attention is not not explanation. In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (pp. 11–20). Association for Computational Linguistics. https://doi.org/10.18653/v1/D19-1002
Wu, D., Wang, H., Yu, W., Zhang, Y., Chang, K.-W., & Yu, D. (2025). LongMemEval: Benchmarking chat assistants on long-term interactive memory. In The Thirteenth International Conference on Learning Representations.
Ying, C., Cai, T., Luo, S., Zheng, S., Ke, G., He, D., Shen, Y., & Liu, T.-Y. (2021). Do transformers really perform bad for graph representation? In Advances in Neural Information Processing Systems (Vol. 34, pp. 28877–28888). Curran Associates.