Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
명령을 실행하기 전, 후보를 한 번 더 고른다: Mid-Harness 쉽게 읽기
터미널 에이전트는 실행할 행동을 고르는 순간 이후의 환경도 바꿉니다. Mid-Harness가 같은 이력에서 후보를 비교하는 방법과, 성공률·교사 일치도·토큰 비용이 각각 말해 주는 범위를 살펴봅니다.
Paper: Minki Kang; Ryo Hachiuma; Shaokun Zhang; Subhashree Radhakrishnan; Yonggan Fu; Jindong Jiang; Mingjie Liu; Ehsan Hosseini-Asl; Yi Dong; Yu-Chiang Frank Wang; Byung-Kwan Lee (2026). "Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents". NVIDIA·KAIST. arXiv:2609.39982v1, 44쪽. PDF · 서지 정보 · 프로젝트.
터미널 에이전트가 명령을 실행하면 코드와 환경 상태가 달라지고, 다음 판단은 그 결과를 이어받습니다. 설명용 예로, 테스트 실패 뒤 설정을 확인하거나 테스트를 다시 실행하는 행동 후보가 있을 수 있습니다. 이는 방법을 보여 주기 위한 예이지 논문의 별도 실험은 아닙니다.
Mid-Harness는 같은 작업 기록에서 여러 행동을 만든 다음, 실행 전에 검증기로 하나를 골라 실행기에 전달합니다. 논문은 행동 생성 모델을 유지한 채 그 선택이 성공률에 미치는 영향을 시험합니다. 이 글은 성공률과 교사 일치도, token 비용이 각각 무엇을 말해 주는지 구분합니다.
핵심 요약
| 항목 | 설명 |
|---|---|
| 개입 위치 | 행동 후보를 실행하기 전, 모델과 harness(도구 실행기) 사이에서 하나를 고릅니다. |
| 평가 분모 | TerminalBench-Lite의 98개 과제를 세 번씩 실행합니다. Pass@1은 294회, Pass@3는 98개 과제를 분모로 삼습니다. |
| 증류 결과 | N=8 distilled pairwise Pass@1은 57.14%입니다. Base 50.00%보다 +7.14%p, 상대 약 14.3%입니다. |
| Frontier 결과 | GPT-5.6 Sol verifier의 68.03%는 학생 verifier의 결과도 행동 정답 오라클도 아닙니다. |
| 비교 횟수 | ring(후보를 원형으로 배열해 이웃끼리 비교) 뒤, 최대 네 pivot(후속 비교의 기준 후보)을 둡니다. 유효는 형식을 해석할 수 있다는 뜻이지 안전하다는 뜻은 아닙니다. 8개이면 22–25회 비교합니다. |
| 남은 한계 | 교사와의 일치는 정답이 아니며 POT·참고가격은 wall-clock·전체 운영비가 아닙니다. 안전 권한도 대신하지 않습니다. |
1. 행동 하나가 다음 판단을 바꿉니다
터미널 에이전트는 답만 말하는 대신 명령을 실행하고 결과를 읽어 다음 행동을 정합니다. 파일을 바꾸거나 패키지를 설치하면 환경도 바뀝니다. 같은 작업에서 가능한 다음 행동을 하나만 뽑을 때와 여러 개를 비교한 뒤 고를 때가 다를 수 있습니다.
2. 선택은 실행 직전에 일어납니다
TMAX-9B 생성기는 현재 작업 기록에서 후보를 만들고 verifier는 그 후보를 비교합니다. harness는 선택된 행동만 실행하고 관측 결과를 다시 기록합니다. 후보를 모두 실행해 보고 고르는 구조는 아닙니다. 생성기 가중치와 기본 실행 흐름은 유지하지만 후보 생성·선택을 넣는 wrapper는 바뀝니다.
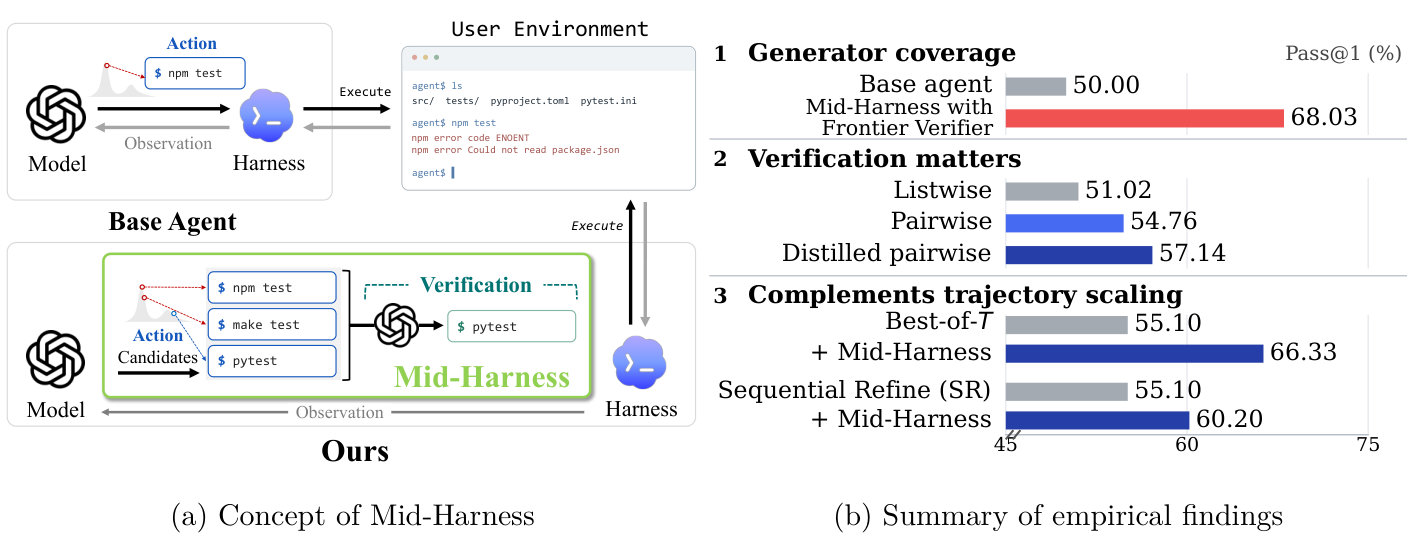
그림 1. Kang et al. (2026), Figure 1, arXiv v1 PDF 1쪽에서 추출한 원도판입니다. 기본 에이전트와 실행 전 후보를 고르는 구조를 비교합니다. 오른쪽의 68.03%는 TMAX-9B·TerminalBench-Lite·N=8에서 GPT-5.6 Sol verifier를 쓴 결과이며 학생 verifier나 행동 정답의 상한이 아닙니다.
3. 여덟 후보를 전부 맞대지는 않습니다
논문은 후보 전체를 한 번에 고르는 listwise, 하나씩 점수화하는 pointwise, 둘씩 비교하는 pairwise를 봅니다. Pairwise는 후보를 원형으로 배치해(ring) 이웃끼리 비교하고, 점수가 높은 최대 네 후보를 후속 비교의 기준(pivot)으로 삼습니다. 여덟 개가 모두 고유하고 parser가 형식을 해석할 수 있으면 22–25회 비교합니다. 여기서 유효란 형식이 해석 가능하다는 뜻이지, 행동이 안전하거나 적절하다는 승인은 아닙니다. 전수 28회와 다르며 두 단계가 순차적입니다. 중복·잘못된 형식으로 후보가 줄면 비교 수도 달라집니다.
4. 성공률의 분모를 확인합니다
TerminalBench-Lite는 원래 100개 과제지만 sandbox 서비스 오류로 두 개를 제외해 98개를 씁니다. 과제마다 세 번 실행하므로 Pass@1 분모는 294회입니다. Pass@3는 세 번 중 한 번 이상 성공한 과제 수를 98개로 나눕니다. N=8은 한 행동 단계의 후보 수이지 여덟 개 궤적을 뜻하지 않습니다.
| TMAX-9B 설정 | N | Pass@1 | Pass@3 |
|---|---|---|---|
| Base | 1 | 50.00% | 69.39% |
| Zero-shot listwise | 8 | 51.02% | 67.35% |
| Zero-shot pointwise | 8 | 52.38% | 67.35% |
| Zero-shot pairwise | 8 | 54.76% | 71.43% |
| Distilled pairwise | 8 | 57.14% | 75.51% |
| GPT-5.6 Sol frontier listwise | 8 | 68.03% | 80.61% |
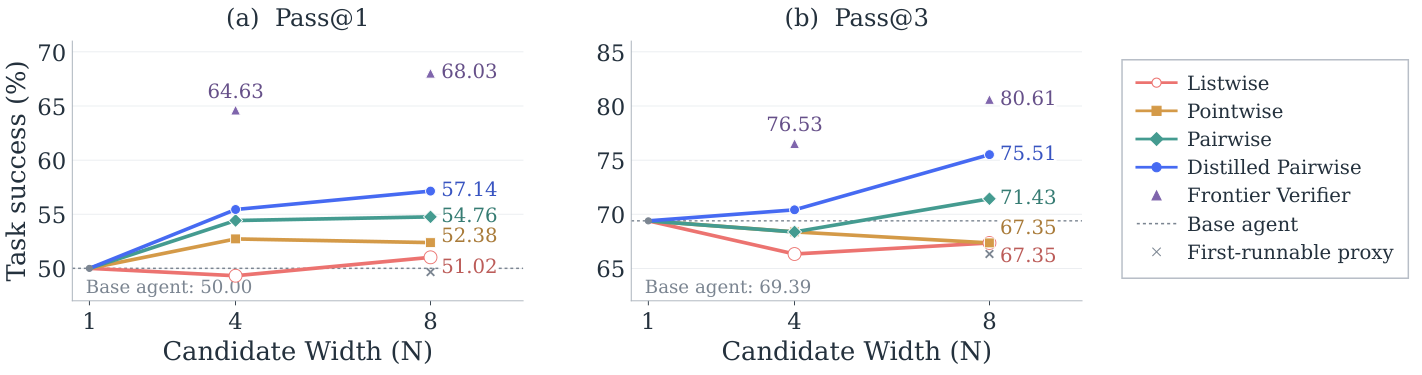
그림 2. Kang et al. (2026), Figure 2, arXiv v1 PDF 6쪽에서 추출한 원도판입니다. N은 행동 후보 수이며 Pass@1은 294회, Pass@3는 98개 과제 기준입니다. 검증 방식과 모델이 다르므로 frontier와 distilled 결과를 같은 verifier의 점수로 보면 안 됩니다.
증류된 verifier의 57.14%는 base보다 7.14%포인트 높습니다. 상대 개선은 기준 50.00% 대비 약 14.3%입니다. 68.03%는 강한 GPT-5.6 Sol frontier 조건의 결과라 학생 모델 점수가 아닙니다. 행동별 정답 label이 없으므로 frontier를 oracle이라고 할 수도 없습니다.
5. 증류하는 것은 행동 생성기가 아니라 verifier입니다
244개 학습 과제의 732개 TMAX-9B 궤적에서 중간 행동 쌍을 만들고, GPT-5.6 Sol 비교 응답 117,631개를 수집했습니다. 저자들은 이 자료로 작은 모델의 verifier를 LoRA 학습하고, adapter는 후보 선택 때만 적용합니다. 행동을 만드는 TMAX-9B의 가중치는 바꾸지 않습니다.
별도의 21개 과제는 최종 offline 분석에 사용하고 verifier 학습·checkpoint 선택에서는 분리했다고 보고합니다. 이는 이 분석 자료와 학습 자료의 구분입니다. 생성기의 사전 학습이나 모든 benchmark와의 중복을 전수 배제했다는 뜻은 아닙니다.
6. 교사와 일치해도 행동이 정답인 것은 아닙니다
| Offline 지표 | Zero-shot 9B | Distilled 9B |
|---|---|---|
| 교사 점수와의 MAE(평균 절대차이) | 2.59 | 1.05 |
| 쌍별 선호 일치 | 59.01% | 74.58% |
| 최상위 후보 선택 일치 | 38.52% | 57.79% |
MAE는 교사 점수와 예측 점수 차이의 평균 절댓값이며, 낮을수록 점수 예측이 교사에 가깝습니다. 증류 verifier는 GPT-5.6 Sol의 평가와 더 자주 일치하지만, teacher 선호 자체는 검증된 행동 정답이 아닙니다. 최상위 후보 선택 일치 57.79%는 모든 비교 응답이 양쪽 모델에서 유효한 1,355/1,624개 상태(83.4%)에 조건부입니다. Offline 승수 집계도 실제 online의 margin 가중 ring-pivot 선택 절차와 다릅니다. 따라서 이 표를 배포 중 명령 정확도로 읽어서는 안 됩니다.
7. token 비용과 안전성은 따로 따져야 합니다
Best-of-T는 여러 완료 궤적 가운데 하나를 고르고, Mid-Harness는 한 궤적 안에서 다음 행동을 선택합니다. Base Pass@1은 98개 과제에서 과제당 세 번 실행한 294회 결과의 평균입니다. 반면 이 Best-of-T 비교의 Pass@1은 과제마다 T개 실행 중 하나를 반환한 98개 결과를 분모로 합니다. 저자 보고에서 T=3 Best-of-T Pass@1은 55.10%, Mid-Harness와 결합한 값은 66.33%입니다. 환경 실행 횟수는 같아도 후보 생성·검증 호출까지 같은 계산량은 아닙니다.
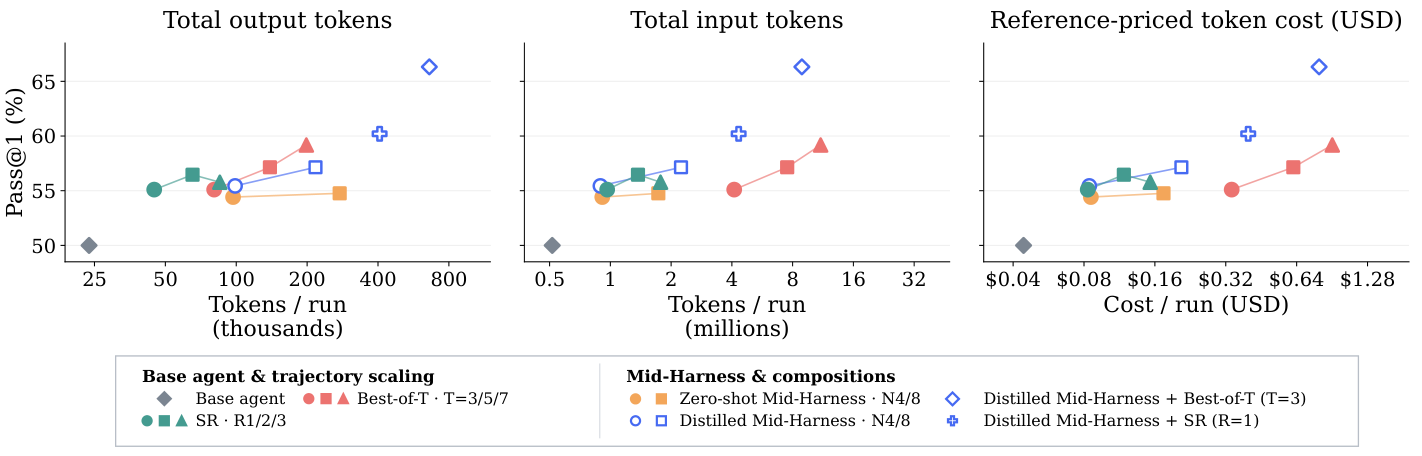
그림 5. Kang et al. (2026), Figure 5, arXiv v1 PDF 9쪽에서 추출한 원도판입니다. TMAX-9B·TerminalBench-Lite에서 Pass@1, run당 입출력 token, 가정한 단가의 참고가격을 확장 방식별로 비교합니다. 가격은 실측 비용이나 wall-clock 시간이 아닙니다.
Token(토큰)은 모델이 텍스트를 처리하는 짧은 단위로, 단어 하나와 항상 일치하지는 않습니다. POT(Parallel Output Tokens, 병렬 출력 토큰)는 한 단계에서 병렬 응답 중 가장 긴 출력 토큰 수를 세고 순차 단계의 가장 긴 출력을 더하는 이상화한 병렬 출력 길이 지표입니다. 실제 처리 시간이나 Mid-Harness의 base 대비 속도 향상을 재서 얻은 값은 아닙니다. 참고 달러 비용도 가정한 token 단가의 계산이며 학습·실행 환경을 포함한 총 운영비가 아닙니다.
검증기가 명령을 골랐다고 안전한 것은 아닙니다. 권한 제한, 격리된 실행 환경, 위험하거나 되돌리기 어려운 행동에 대한 사람 승인은 계속 필요합니다. 행동 검증이 이 안전장치들을 대신하지 않습니다.
References
Kang, M., Hachiuma, R., Zhang, S., Radhakrishnan, S., Fu, Y., Jiang, J., Liu, M., Hosseini-Asl, E., Dong, Y., Wang, Y.-C. F., & Lee, B.-K. (2026). Mid-harness: Scaling actions between model and harness for terminal agents [Preprint]. arXiv. https://arxiv.org/abs/2609.39982v1