Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
명령을 실행하기 전, 후보를 한 번 더 고른다: Mid-Harness
터미널 에이전트는 실행할 행동을 고르는 순간 이후의 환경도 바꿉니다. Mid-Harness가 같은 이력에서 후보를 비교하는 방법과, 성공률·교사 일치도·토큰 비용이 각각 말해 주는 범위를 살펴봅니다.
Paper: Minki Kang; Ryo Hachiuma; Shaokun Zhang; Subhashree Radhakrishnan; Yonggan Fu; Jindong Jiang; Mingjie Liu; Ehsan Hosseini-Asl; Yi Dong; Yu-Chiang Frank Wang; Byung-Kwan Lee (2026). "Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents". NVIDIA·KAIST. Minki Kang의 별표는 인턴십 중 수행, Byung-Kwan Lee의 표시는 project lead를 뜻한다. PDF · 서지 정보 · 프로젝트. arXiv:2609.39982v1의 44쪽을 검토한다. arXiv 헤더는 2026-09-30, 표제부 날짜는 2026-10-1이다.
터미널 에이전트가 명령을 실행하면 코드와 환경 상태가 달라지고, 다음 판단은 그 결과를 이어받는다. 실행 전의 선택은 이후 궤적 전체에 영향을 줄 수 있다. 여기서 harness는 모델이 낸 도구 행동을 실행하고 그 결과를 기록에 돌려주는 실행부다.
설명용 예로, 테스트 실패 뒤 에이전트가 설정을 살펴보거나 테스트를 다시 실행하는 후보를 만들 수 있다. 이는 작동 방식을 보여 주기 위한 예이지 논문의 별도 실험은 아니다. Mid-Harness는 같은 이력에서 여러 행동 후보를 만든 뒤, 실행 전에 검증기로 하나를 골라 harness에 전달한다. 선택되지 않은 후보는 실행하지 않는다.
논문은 TMAX-9B 생성기를 TerminalBench-Lite에서 평가한다. 같은 9B 검증기를 증류한 설정의 Pass@1은 50.00%에서 57.14%로, 즉 +7.14%p(기준값 대비 약 14.3%)로 보고된다. 강한 GPT-5.6 Sol 검증기를 쓴 별도 frontier 설정은 68.03%다. 마지막 수치는 증류된 학생 검증기의 결과가 아니며, 어떤 후보가 정답 행동인지를 표시한 oracle도 아니다.
핵심 요약
| 항목 | 설명 |
|---|---|
| 개입 위치 | 모델 응답과 실행 harness 사이. 후보를 먼저 비교하고 선택된 행동만 실행한다. |
| 유지되는 것 | 생성기 가중치·기본 실행 loop. 모델 호출 wrapper는 바뀌며 검증기만 LoRA로 학습할 수 있다. |
| 주 평가 | TerminalBench-Lite의 98과제×3회. Pass@1은 294회 평균, Pass@3은 98과제 중 한 번 이상 성공한 비율. |
| N=8 결과 | Base 50.00%, listwise 51.02%, pointwise 52.38%, pairwise 54.76%, distilled pairwise 57.14%(+7.14%p, 상대 약 14.3%), GPT-5.6 Sol frontier 68.03%. |
| 실제 pairwise 비용 | 8개 유효·고유 후보에서는 ring+4 pivots로 22–25회 비교, 두 순차 stage. 전수 28회와 다르다. |
| 증류의 범위 | 244 training task의 117,631개 교사 비교 응답. 생성기에는 adapter를 적용하지 않는다. |
| 통계적 유보 | Base 대비 여섯 bootstrap 구간 중 distilled 9B·27B만 0보다 높다. 나머지는 0을 포함한다. |
| 비용의 의미 | POT는 이상적 병렬 출력 길이, USD는 참고 token 단가. 실측 wall-clock·전체 운영비가 아니다. |
목차
- 좋은 후보를 만들고도 나쁜 행동을 실행할 수 있다
- 바뀌지 않는 harness와 바뀌는 행동 선택 정책
- Pairwise는 여덟 후보를 어떻게 비교하는가
- 후보 수보다 검증 능력이 중요하다는 증거
- 생성기가 아니라 검증기를 증류한다
- 교사와의 일치가 행동의 정답을 뜻하지는 않는다
- 병렬 출력 길이와 총 토큰 비용은 다르다
- 한 토큰 판정은 더 싸지만 언제나 더 좋지는 않다
- 행동 확장과 전체 실행 확장을 함께 쓴다
- 성공률 개선과 실행 안전성 사이에 남은 거리
1. 좋은 후보를 만들고도 나쁜 행동을 실행할 수 있다
실패한 테스트를 고칠 때 필요한 행동은 패키지 설치일 수도, 설정 파일 확인일 수도, 앞선 잘못된 편집을 되돌리는 일일 수도 있다. 모델이 그중 적절한 행동을 생성할 능력이 있어도 한 번의 sampling이 다른 행동을 내놓으면 환경은 그 선택을 따라 바뀐다.
Mid-Harness는 완성된 답이 아니라 실행 직전의 다음 행동을 고른다. 선택은 다음 상태와 이후 후보 분포까지 바꾸므로, 저장된 후보들의 정답률만으로 전체 궤적의 성공을 계산할 수 없다.
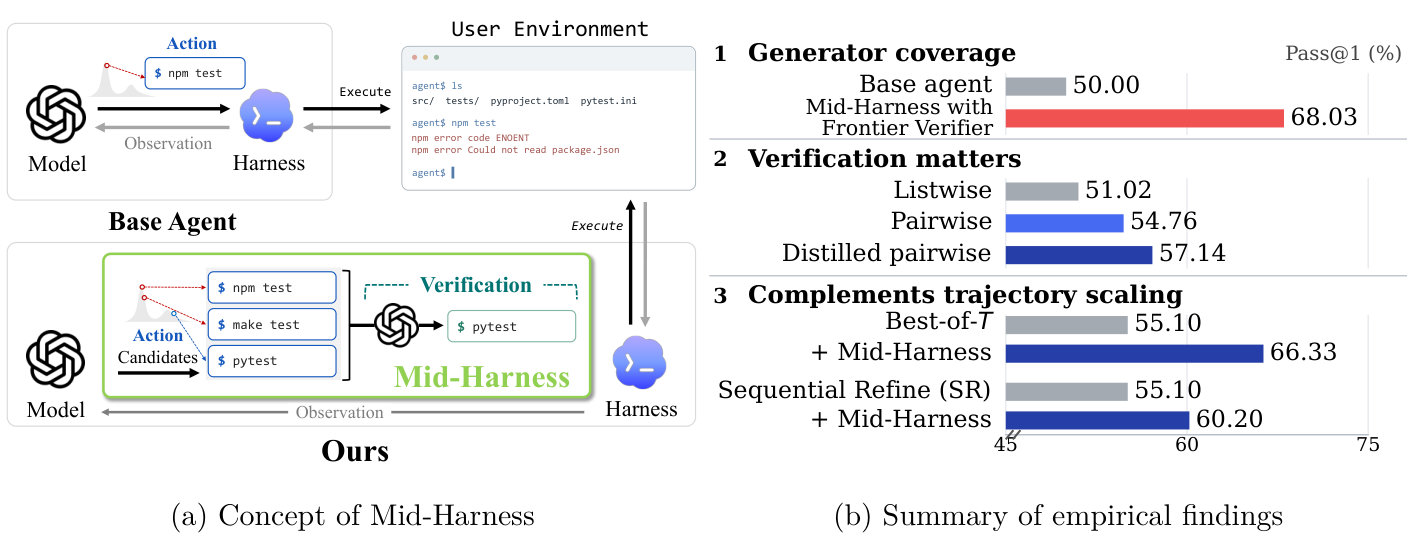
그림 1. Kang et al. (2026), Figure 1, arXiv v1 PDF 1쪽에서 추출한 원도판이다. 왼쪽은 행동 하나를 곧바로 실행하는 기본 에이전트, 아래쪽은 같은 환경에서 후보를 검증해 하나만 실행하는 Mid-Harness를 보여 준다. 오른쪽의 68.03%는 TMAX-9B 생성기와 TerminalBench-Lite에서 GPT-5.6 Sol 검증기를 쓴 결과다. 학생 검증기 성능이나 행동 정답의 오라클 상한이 아니다.
논문의 질문은 단순히 ‘모델을 여러 번 부르면 좋아지는가’가 아니다. 동일 생성기에서 나온 대안 중 유용한 것을 검증기가 알아볼 수 있는지, 그 과정에 얼마의 compute를 쓰는 것이 좋은지를 묻는다. 모든 후보를 sandbox에 실행해 본 뒤 결과로 고르는 방식은 아니다.
2. 바뀌지 않는 harness와 바뀌는 행동 선택 정책
이력 hₜ에서 생성기 π가 N개 후보를 만들고 검증기 ψ가 그중 하나를 반환한다.
a_t^i\sim\pi(\cdot\mid h_t),\quad
\mathcal A_t=(a_t^1,\ldots,a_t^N),\quad
 a_t^\star=\operatorname{Verify}_{\psi}(h_t,\mathcal A_t)\in\mathcal A_t.
선택된 행동만 실행해 관측 oₜ를 얻고, 새 이력에서 다음 후보 집합을 다시 만든다. 후보들을 서로 다른 환경 branch로 끝까지 실행하지 않으므로 action scaling 자체는 한 environment instance를 사용한다.
고정의 정확한 범위
원문의 pseudocode는 harness loop를 유지하고 model.generate wrapper에 sampling과 verification을 넣는다. 즉 도구 실행 인터페이스·기본 생성기를 유지한다는 의미다. 전체 소프트웨어와 호출 수, 선택 정책까지 아무것도 바뀌지 않는다는 뜻은 아니다. 증류한 LoRA도 검증기에만 활성화한다.
생성기는 각 후보 앞에 reasoning을 만들지만, 검증기는 그 후보의 생성 reasoning을 받지 않고 task·관측 이력·후보 행동을 본다. 반면 기본 검증 응답은 rationale·점수·선호를 생성한다. 설정표의 verifier thinking off와 ‘응답에 rationale이 전혀 없다’는 것은 같지 않다.
부록의 listwise prompt는 DISPLAY ONLY 표시로 후보 표현이 일부 생략될 수 있다고 설명한다. 실행될 명령과 검증기에 보이는 문자열이 완전히 같다고 가정할 수 없는 관측 경계다. 생략된 부분 때문에 무조건 기각하지 말라는 prompt만으로 그 부분의 의미나 안전성을 확인할 수는 없다.
주 생성기는 Qwen3.5-9B에서 terminal RL로 학습한 TMAX-9B이며 Vanillux2를 사용한다. Temperature 0.8, 최대 64 step, context 65,536, step당 output limit 16,384다. 기본 pairwise 검증기는 temperature 0, context 61,440, output limit 2,048이다. 부록은 zero-shot N=4와 Terminal-Bench 2.1의 지정 설정에 8,000-character history 제한도 명시한다. Token 한도와 실제로 보이는 이력 범위를 같은 것으로 읽지 않는다.
3. Pairwise는 여덟 후보를 어떻게 비교하는가
| 방식 | 판정 단위 | 비용·해석상 주의 |
|---|---|---|
| Listwise | 전체 후보를 한 prompt에서 선택 | 1회 호출. 후보 수가 늘면 한 응답에서 모두 비교해야 함 |
| Pointwise | 후보별 독립 점수 | N회 호출. 목적이 다른 행동들의 점수를 같은 scale로 비교해야 함 |
| Pairwise | 같은 이력의 두 후보를 비교 | 공통 상대가 생기지만 호출 수와 집계 정책이 추가됨 |
N=4는 네 후보가 모두 유효·고유하면 여섯 unordered pair를 한 병렬 stage에서 비교한다. N=8의 기본 실험은 전수 28쌍이 아니다.
- Tool name·argument가 같은 후보를 중복 제거하고 parsing 가능한 후보를 남긴다. 여기서 유효하다는 것은 형식을 해석할 수 있다는 뜻이지, 행동이 안전하거나 적절하다는 승인이 아니다.
- Seeded shuffle로 후보를 원형으로 배치해(ring) 이웃끼리 병렬 비교한다.
- Ring score 상위 최대 4개를 후속 비교의 기준 후보(pivot)로 고른다.
- Pivot–non-pivot와 pivot끼리의 쌍을 비교하되 ring에서 이미 본 쌍은 다시 호출하지 않는다.
여덟 후보·네 pivot이면 pivot 관련 쌍은 4×4+6=22개다. 여기에 ring에만 있는 non-pivot 이웃 쌍이 0–3개 붙어 22–25회가 된다. Ring을 끝내야 pivot을 정할 수 있으므로 두 stage는 순차적이다. 후보가 deduplication·parsing으로 줄어들면 호출 수도 달라진다.
점수 차이로 승리의 가중치를 조절한다
기본 응답은 1–10점 두 개와 A/B/TIE 선호다. 비교 e의 가중치와 후보 i의 최종 점수는
w_e=\max\left(\frac{|s_{A,e}-s_{B,e}|}{9},0.1\right),\qquad
q_i=\frac{\sum_{e\in E_i}w_ep_{i,e}}{\sum_{e\in E_i}w_e},
이며 승리·패배·동률의 p는 1·0·1/2다. 6점 대 6점이라도 winner B라고 응답하면 B가 weight 0.1의 승리를 얻는다. 점수가 다른데 선호가 반대면 invalid다. 따라서 점수 숫자만으로 선호를 모두 복원하는 것도 아니다.
Invalid 판단은 tie가 아니라 분자·분모에서 제외한다. 어떤 후보라도 valid ring 비교가 전혀 없으면 첫 retained 후보로 돌아간다. 유효 후보가 없으면 첫 sampled 후보, 하나뿐이면 그것을 반환한다. 이런 fallback은 실행 지속 규칙이지 안전한 행동의 인증이 아니다. 후보 중 가장 높은 점수를 골라도 절대적인 성공 확률이나 위험 기준을 통과했다는 뜻은 아니다.
4. 후보 수보다 검증 능력이 중요하다는 증거
TerminalBench-Lite는 원래 100과제지만 sandbox service 오류로 두 과제를 제외해 98개를 평가한다. 과제당 세 번 실행하며 실패는 분모에 남고 fractional reward는 성공으로 세지 않는다.
\mathrm{Pass@1}=\frac1{3M}\sum_i\sum_{j=1}^3z_{ij},\qquad
\mathrm{Pass@3}=\frac1M\sum_i\max_j z_{ij}.
N=8은 한 step의 행동 후보 수이지 여덟 trajectory의 Pass@8이 아니다. Pass@3는 세 실행 중 하나라도 성공한 task 비율로, 실제 선택기가 그 성공 실행을 찾아 반환했음을 뜻하지 않는다.
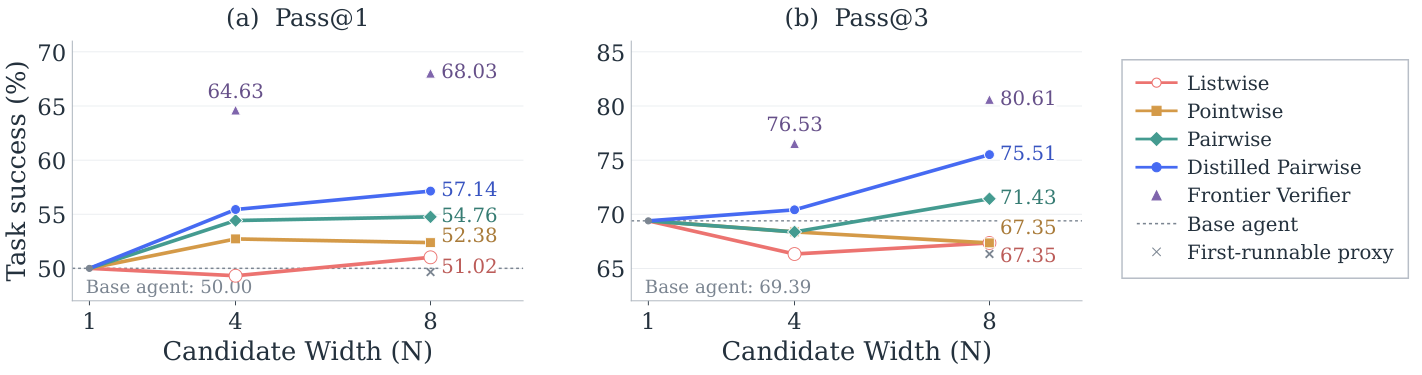
그림 2. Kang et al. (2026), Figure 2, arXiv v1 PDF 6쪽에서 추출한 원도판이다. 가로축 N은 한 step에서 비교할 행동 후보 수이며, Pass@1과 Pass@3는 서로 다른 분모를 쓴다. GPT-5.6 Sol frontier는 distilled pairwise와 다른 검증기다. 도판은 98개 과제, TMAX-9B, TerminalBench-Lite 조건의 저자 보고 결과를 그린다.
| TMAX-9B 설정 | N | Pass@1 | Pass@3 |
|---|---|---|---|
| Base | 1 | 50.00% | 69.39% |
| First-runnable proxy | 8 | 49.66% | 66.33% |
| Zero-shot listwise | 8 | 51.02% | 67.35% |
| Zero-shot pointwise | 8 | 52.38% | 67.35% |
| Zero-shot pairwise | 8 | 54.76% | 71.43% |
| Distilled pairwise | 8 | 57.14% | 75.51% |
| GPT-5.6 Sol listwise | 8 | 68.03% | 80.61% |
Table 6, p.34. First-runnable은 parsing을 통과한 첫 후보를 선택할 뿐, 실제 실행 성공을 먼저 시험하지 않는다.
Distilled pairwise의 57.14%는 base 50.00%보다 +7.14%p이며, 기준값 대비 상대 개선은 약 14.3%다. base와 frontier 구성의 50.00→68.03은 +18.03%p(상대 약 36.1%)다. 68.03%는 GPT-5.6 Sol frontier 검증기의 결과이지 distilled 9B 학생 검증기의 결과가 아니다. 294회 분모에 대응하는 총 성공은 147→200회지만, 이를 ‘같은 실패 53개를 정확히 구제했다’는 paired 분석으로 바꾸지 않는다. 선택이 달라지면 이후의 상태와 행동도 달라진다.
이 결과는 생성기에 활용 가능한 대안이 있었다는 간접 증거다. 행동별 gold label이 없으므로 정확한 candidate coverage, 완벽한 검증기의 상한, GPT-5.6 Sol의 행동 판정 정확도를 측정한 것은 아니다. Frontier를 oracle이라 부르지 않는다.
또 후보를 넓히면 항상 좋아지는 것도 아니다. Zero-shot pointwise는 N=4→8에서 Pass@1이 52.72→52.38로 낮아진다. Pairwise의 우위 역시 더 많은 호출·다른 집계를 포함하며, 동일 token 예산에서 비교 형식만 바꾼 통제 결과는 아니다.
5. 생성기가 아니라 검증기를 증류한다
244개 어려운 TMAX-15k task에서 TMAX-9B trajectory 732개를 얻고, 중간 상태의 두 행동을 GPT-5.6 Sol이 비교한다. 최종 training corpus는 117,631개로, A 56,274개·B 56,274개·TIE 5,083개다. Majority downsampling으로 A/B 표시 위치를 균형 있게 만들고 TIE는 유지한다.
LoRA rank/alpha=64/128, dropout 0.05, learning rate 10⁻⁴, 2 epochs, H200 4대, per-device batch 8이다. Teacher의 rationale·두 점수·선호를 생성하도록 학습하며 adapter는 검증기 역할에서만 켠다. 4B와 27B 검증기도 같은 corpus를 사용한다.
분리된 21개 task의 10,543개 입력은 최종 offline analysis에만 사용하며 checkpoint 선택·훈련 설정에 쓰지 않았다고 명시한다. 이것은 검증기 training과 analysis의 task 분리다. 생성기의 모든 선행 학습이나 온라인 benchmark와의 중복까지 전수 배제했다는 증거로 확대하지 않는다.
N=8의 증류 전후 Pass@1은 54.76→57.14, Pass@3는 71.43→75.51이다. 생성기의 가중치를 바꾸지 않고도 행동 선택 정책의 개선으로 trajectory 결과가 좋아질 수 있다는 관찰이다. 다만 frontier의 68.03과의 차이는 남고, frontier listwise와 distilled pairwise는 검증 모델뿐 아니라 메커니즘도 다르다.
6. 교사와의 일치가 행동의 정답을 뜻하지는 않는다
| Offline 지표 | Zero-shot | Distilled |
|---|---|---|
| 교사 점수와의 평균 절대차이(MAE) | 2.59 | 1.05 |
| Pairwise preference agreement | 59.01% | 74.58% |
| 같은 최상위 후보 선택 | 38.52% | 57.79% |
Table 1, p.8. GPT-5.6 Sol과의 일치이며 행동 gold label과의 일치가 아니다. MAE는 교사 점수와 예측 점수 차이의 절댓값 평균으로, 낮을수록 점수가 교사에 가깝다.
유효 응답 조건과 온라인 집계가 다르다
Score 분포는 10,197개 common valid pair, 즉 후보 score 20,394개를 사용한다. 최상위 후보 일치도 57.79%는 상태 안의 모든 비교가 양쪽 모델에서 유효한 **1,355/1,624개 상태(83.4%)**에 조건부다. 이 남은 상태들에는 8,702개 비교가 있고, 나머지 269개 상태는 적어도 하나의 invalid 응답 때문에 제외된다.
더 중요하게 offline 선택은 저장된 ring의 단순 win count로 계산한다. TIE는 어느 쪽에도 win을 주지 않고 동률이면 원래 후보 순서의 앞쪽을 고른다. 온라인의 margin-weighted win rate·ring–pivot 집계와 같지 않다. 따라서 57.79%를 배포 controller 전체가 teacher와 같은 행동을 고를 확률이라고 바로 읽지 않는다.
후반 turn에서 일치가 낮다는 관찰도 상태들을 pooled한 분석이다. 마지막 33+ bin은 8개 task만 포함하고 앞의 네 bin은 각각 21개다. 같은 task 모집단에서 시간 경과 하나만의 효과를 분리한 실험은 아니다.
실패 1,810건의 분모
GPT-5.6 Terra가 teacher와의 불일치를 다시 보고, teacher 선호가 명확하며 근거 있다고 판단한 경우만 ‘clear verifier failure’로 분류한다. Zero-shot 3,328건, distilled 1,810건이며, 후자의 command semantics 706건과 execution feasibility 514건이 합쳐 **1,220/1,810≈67.4%**다.
이는 모든 명령의 67.4%가 틀렸다는 뜻도, 실제 실패 trajectory의 67.4%가 그 원인이라는 뜻도 아니다. Teacher reference와 별도 모델 annotator에 의존하는 선별된 판정 사례다. AgentWorld의 사후 기여 추적과 마찬가지로, 모델 간 일치와 실행 의미의 독립 검증을 분리해야 한다.
7. 병렬 출력 길이와 총 토큰 비용은 다르다
병렬 출력 토큰(POT)은 이상화된 경로다
Token(토큰)은 모델이 텍스트를 처리하는 짧은 단위로, 단어 하나와 항상 일치하지는 않는다. POT(Parallel Output Tokens)는 한 단계에서 병렬 응답 중 가장 긴 출력 토큰 수를 세고, 순차 단계의 가장 긴 출력을 더하는 이상화한 병렬 출력 길이 지표다.
Candidate output 길이를 c, verifier의 sequential stage별 output을 v라 하면 원문의 POT는
\mathrm{POT}=\sum_t\left[\max_i c_{t,i}+\sum_s\max_jv_{t,s,j}\right].병렬 호출은 가장 긴 출력만 세고, 순차 stage는 더한다. 예컨대 생성 최대 6, ring 최대 4, pivot 최대 3이면 POT는 13이지 10이 아니다. 설명용 수치이며 실제 로그를 뜻하지 않는다.
N=8 zero-shot pairwise는 검증 응답만 약 26.6k POT를 추가하지만 listwise·pointwise는 최대 약 1.3k다. 총 verifier output은 listwise 0.6k, pointwise 7.0k, pairwise 125.7k다. 같은 ‘token 수’라도 POT와 총량의 분모가 다르다.
POT는 input prefill, queue, batching 효율, 서버 용량, command 실행 시간 등을 실제로 잰 wall-clock이 아니다. 많은 요청을 완전히 병렬 처리할 수 있다는 가정에 기대며, 두 stage와 긴 rationale의 비용도 남는다.
실측 시간이 전혀 없는 논문은 아니다. Figure 7은 N=1 base의 task별 세 run 평균 시간을 집계해 Lite의 중앙값/p90 7.2/13.3분, Terminal-Bench 2.1의 10.5/20.0분을 보고한다. 환경 setup·최종 채점은 제외하고 timeout의 관측 시간은 남긴다. 이는 Mid-Harness와 base의 wall-clock 가속 비교가 아니다.
USD는 참고가격 회계다
9B는 입력 I·출력 O token에 대해
C_{\mathrm{ref}}=\frac{0.08I+0.13O}{10^6}\;\mathrm{USD}를 적용한다. 같은 step의 후보 생성은 공통 prompt의 prefill을 공유한다고 가정해 입력을 한 번 세고 모든 후보 output은 합한다. 서로 다른 step·trajectory는 공유하지 않고, verifier input은 비교 호출마다 센다. 4B는 9B 단가의 4/9, 27B는 입력/출력 백만 token당 0.30/2.00달러다.
이 회계는 pipeline에 쓰인 token의 proxy이지 실제 로컬 GPU 청구액이 아니다. 증류 데이터 생성·LoRA 학습·Docker 환경·도구 실행·장치 점유 비용까지 포함한 총비용도 아니다. 원문도 일부 usage 누락과 별도 live run이 decision-only 비교의 정확한 해석을 제한한다고 인정한다. 누락 규모가 정리되지 않은 상태에서 비용 자료가 완전하다고 주장하지 않는다.
8. 한 토큰 판정은 더 싸지만 언제나 더 좋지는 않다
Decision-only는 비교마다 A/B 한 token을 출력하고 첫 위치의 A/B log-probability를 두 token에 대해 정규화한다. 후보별 평균 선호 확률로 순위를 만들며 margin weighting은 쓰지 않는다. 별도 A/B-only teacher corpus를 사용하고 TIE는 제외한다.
따라서 rationale 문자열만 삭제한 절제가 아니다. 응답 형식·집계·training target이 함께 바뀐다. 기본 verifier의 명시적 rationale과 내부 reasoning 능력 전체를 같은 개념으로 취급할 수도 없다.
| N=8 설정 | Pass@1, rationale→decision-only | Pass@3, rationale→decision-only |
|---|---|---|
| 9B zero-shot | 54.76→56.12 | 71.43→73.47 |
| 9B distilled | 57.14→59.18 | 75.51→73.47 |
| 4B distilled | 43.88→41.50 | 58.16→57.14 |
| 27B distilled | 76.19→74.15 | 86.73→83.67 |
Table 8, p.35. 비용은 Table 9의 참고가격 기준이다.
9B N=8의 참고가격 비용은 zero-shot 0.174→0.138달러, distilled 0.207→0.157달러이며 저자 보고 절감률은 20.9%·24.1%다. 표시 dollar의 마지막 자리 반올림 때문에 이를 직접 나눈 값과 약간 다를 수 있다. 반면 4B·27B는 비용이 줄면서 Pass@1도 낮아지고, 9B도 N=4에서는 rationale 방식보다 Pass@1이 낮다.
‘검증에는 추론이 필요 없다’는 보편 결론보다, 특정 모델·폭에서 짧은 판정이 더 좋은 비용–성공 절충을 보였다고 읽어야 한다. Table 10에서도 비교당 다섯 응답은 verifier output을 4.99배 쓰면서 Pass@1을 57.14→53.40으로 낮춘다. 추가 계산량 자체가 좋은 판단을 보장하지 않는다.
9. 행동 확장과 전체 실행 확장을 함께 쓴다
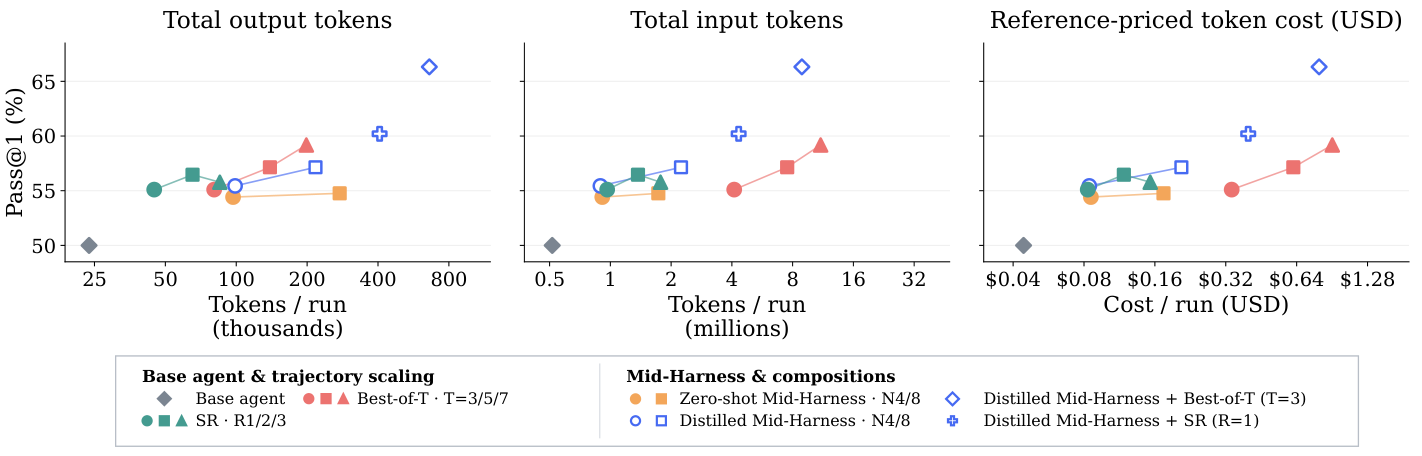
그림 5. Kang et al. (2026), Figure 5, arXiv v1 PDF 9쪽에서 추출한 원도판이다. TMAX-9B·TerminalBench-Lite에서 action 후보 선택과 Best-of-T·Sequential Refine 조합의 Pass@1, run당 총 input/output token, 가정한 token 단가의 참고가격을 함께 그린다. 달러 값은 token 가격을 적용한 추정치이며 실측 wall-clock이나 전체 운영비가 아니다.
전체 실행을 더 만들 것인가, 각 실행을 개선할 것인가
| TMAX-9B 구성 | Pass@1 | 반환 output당 environment 실행 |
|---|---|---|
| Base | 50.00% | 1 |
| Best-of-T, T=3 | 55.10% | 3 |
| Best-of-T, T=7 | 59.18% | 7 |
| Distilled Mid-Harness | 57.14% | 1 |
| Mid-Harness + Best-of-T, T=3 | 66.33% | 3 |
| SR, R=1 | 55.10% | 2 |
| Mid-Harness + SR, R=1 | 60.20% | 2 |
Tables 2·7. Mid-Harness는 N=8 distilled pairwise. Environment 수는 반복 평가를 합친 총량이 아니라 한 output을 만드는 pipeline의 수다.
Base Pass@1은 98개 과제에서 과제당 세 번 실행한 294회 실행의 평균이다. Best-of-T는 각 과제에서 완료된 T개 실행 중 하나를 반환하므로 이 비교의 Pass@1은 98개 반환 결과를 분모로 한다. 두 지표의 성공률을 같은 분모로 읽으면 안 된다. 원문은 Best-of-T의 Pass@3를 정의하지 않는다. SR은 이전 실행을 요약해 새 환경에서 다시 시작하며, R=1이면 source와 refinement 두 실행이다. Mid-Harness를 합치면 source와 refinement 모두에서 후보를 검증한다.
Best-of-3의 55.10→66.33은 표시값 기준 +11.23%p이며 환경 실행 수는 3으로 같다. 그러나 후보 생성·검증 호출까지 같은 compute라는 뜻은 아니다. 저자는 Mid-Harness+SR이 Best-of-7보다 높은 성공률을 절반 미만의 참고가격 token 비용으로 얻는다고 보고한다. 이는 Figure 5의 회계 조건 아래의 비교이지 실측 latency 우위가 아니다.
전이 결과와 반례를 함께 본다
Table 3은 Terminal-Bench 2.1의 89과제, SWE-bench Verified의 Mini 50과제, FeatureBench-Mini의 CPU-only 23과제도 평가한다. 전체 SWE-bench Verified나 GPU feature task 결과로 확대하지 않는다.
TMAX-9B의 Terminal-Bench 2.1 Pass@1은 base 21.72→zero-shot 27.34→distilled 26.59다. 증류가 zero-shot을 항상 이기지 않는다. FeatureBench-Mini 9B는 Pass@1이 1.45→5.80→7.25로 오르지만 Pass@3는 4.35→17.39→13.04여서 마지막 단계에서 낮아진다. 69회 분모라면 Pass@1은 각각 1·4·5회 성공에 해당하는 작은 표본이다.
Bootstrap은 보고돼 있지만 모든 개선을 확정하지 않는다
저자는 98개 task별 세 실행을 한 block으로 유지해 paired task bootstrap 100,000회를 수행한다. 294개 run을 독립 task처럼 처리하지 않았다.
| Base 대비 Pass@1 차이 | 점추정 | 95% CI, %p |
|---|---|---|
| 4B zero-shot | +2.72 | [−3.06, +8.84] |
| 4B distilled | +5.10 | [−0.68, +10.88] |
| 9B zero-shot | +4.76 | [−0.68, +10.20] |
| 9B distilled | +7.14 | [+1.36, +12.93] |
| 27B zero-shot | +2.04 | [−3.74, +7.48] |
| 27B distilled | +5.10 | [+0.34, +9.86] |
Table 11, p.37, 저자 bootstrap 결과. 여섯 비교의 동시 신뢰구간은 아니다.
네 구간이 0을 포함한다고 효과가 없다고 증명된 것도 아니고, 모든 점추정이 양수라고 전부 유의한 것도 아니다. 또한 이 구간은 각 방법 대 base다. Distilled 대 zero-shot, frontier 대 student, trajectory 결합의 차이에 그대로 적용하거나 구간을 빼서 새 유의성을 만들지 않는다.
10. 성공률 개선과 실행 안전성 사이에 남은 거리
저자가 명시한 한계
Gold action label이 없어 행동 검증의 정확성이나 완벽한 선택기의 상한을 직접 측정하지 못한다. 바뀐 행동은 후속 상태를 바꾸므로 고정 trajectory의 offline 판정을 바꾸는 것만으로 새 정책의 online 성능을 알 수 없다. Branching에는 환경 복제·복원이 필요하다.
또한 생성기의 reasoning 설정을 고정했으며, 후보 하나를 더 오래 생각하게 하는 방식과 같은 비용으로 비교하지 않았다. 모든 action step에서 검증하므로 어느 단계에서 후보 수·비교 수를 줄여도 되는지는 남은 과제다. Terminal agent 외 computer use·robotics로의 확장도 이 논문의 직접 결과는 아니다.
Ethics statement도 성공적인 과제 완료가 명령의 safety/security를 입증하지 않는다고 명시한다. 제한된 권한·환경 격리·민감하거나 비가역적인 행동의 사람 승인을 유지하고, 행동 검증은 이를 대체하지 않아야 한다는 것이 저자의 설명이다.
References
Kang, M., Hachiuma, R., Zhang, S., Radhakrishnan, S., Fu, Y., Jiang, J., Liu, M., Hosseini-Asl, E., Dong, Y., Wang, Y.-C. F., & Lee, B.-K. (2026). Mid-harness: Scaling actions between model and harness for terminal agents [Preprint]. arXiv. https://arxiv.org/abs/2609.39982v1