LLM Inference in a Flash!
저장 장치와 계산 장치는 다르다: LLM Inference in a Flash! 쉽게 읽기
모델을 SSD에 넣는 것과 저장된 곳에서 계산하는 것은 다르다. 정수 추론과 사전 기반 KV 표현을 살펴보고, 동적 KV 읽기 15배 절감과 디코드 시간 4.4배 개선 추정이 각각 무엇을 뜻하는지 분석한다.
Paper: Sebastian Zhao; Minseo Kim; Coleman Hooper; Luca Manolache; Michael W. Mahoney; Yakun Sophia Shao; Kurt Keutzer; Amir Gholami (2026). "LLM Inference in a Flash!" UC Berkeley, ICSI, LBNL. 앞의 세 저자는 공동 기여자로 표시됩니다. arXiv:2609.16161v1, 2026-09-14. 검토 PDF · arXiv:2609.16161v1. 20쪽 v1을 기준으로 설명합니다. 제목이 비슷한 Alizadeh et al. (2024)의 "LLM in a flash: Efficient large language model inference with limited memory"와는 다른 연구입니다.
언어 모델은 다음 토큰 하나를 만들 때 모델 가중치와 앞서 나온 토큰의 Key·Value(KV)를 다시 읽습니다. SSD는 모델을 보관할 공간을 제공할 수 있지만, 데이터를 연산기로 옮기는 경로까지 빨라진 것은 아닙니다. 저장 용량을 늘리는 것과 데이터를 계산하는 것은 다른 문제입니다.
이 논문은 정수 연산과 고정된 수치 벡터 사전으로 이런 이동을 줄이려 합니다. 다만 15배는 특정 조건의 동적 KV 읽기량이고, 4.4배는 실제 장치 실험이 아닌 분석 모형의 디코드 시간 추정입니다. 두 수치가 각각 무엇을 재는지 나누어 보겠습니다.
1. 일반 SSD에 소프트웨어를 얹는 연구가 아닙니다
일반적인 시스템은 SSD에서 데이터를 읽어 GPU나 다른 연산기로 옮긴 다음 계산합니다. 큰 모델이 SSD에 들어간다는 사실만으로 이 왕복이 빨라지지는 않습니다. 논문이 다루는 Compute-in-Flash는 Flash 메모리 안이나 가까이에서 계산하도록 설계된 특수 하드웨어를 전제로 합니다. Flash cell의 program/erase 횟수에는 한계가 있어 자주 바뀌는 KV를 계속 기록하면 내구성에 부담을 줍니다. 일반 SSD에 프로그램을 설치하는 것만으로는 이런 연산 기능이 생기지 않습니다.
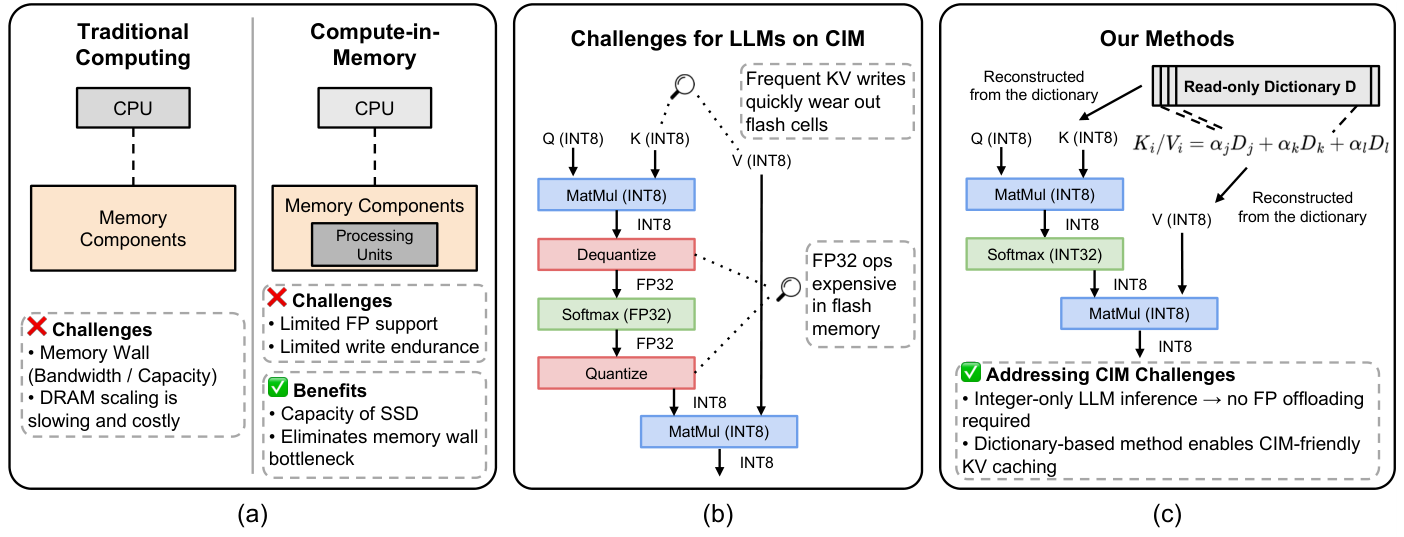
Figure 1. 부동소수점 계산과 매번 바뀌는 KV 문제에 정수 연산과 사전 기반 표현을 대응시킨 개념도입니다. 일반 SSD가 아닌 Compute-in-Flash 장치가 전제입니다. 출처: Zhao et al. (2026), arXiv v1, p. 2, Fig. 1.
2. 정수 추론이라고 모든 연산이 INT8인 것은 아닙니다
모델의 선형 층은 가중치와 입력을 주로 INT8로 표현합니다. 입력의 크기에 따라 묶음별 단위를 맞추는 양자화도 사용합니다. 하지만 Softmax나 RMSNorm처럼 여러 값을 모으거나 SiLU처럼 비선형인 연산은 행렬곱과 다릅니다. 이 논문은 특히 Softmax·RMSNorm 입력을 token-wise 단일 scale의 INT16으로 재양자화하고, INT32 누산과 고정소수점 연산을 이어 정수 경로를 구성합니다. 그러므로 “전부 INT8”이라고 요약하면 틀립니다.
이 단계 구분은 품질 표에서도 중요합니다. 논문 Table 1은 비선형 정수 근사만 더한 중간 단계에서 NaN(Not a Number), 즉 유효한 숫자 결과가 아닌 값을 보고합니다. INT16 재양자화를 더한 최종 구성의 perplexity(PPL)는 7.5803으로, FP16 기준선 7.5454보다 상대 약 0.46% 높습니다. PPL은 모델이 다음 토큰을 예측할 때의 어려움을 나타내며 낮을수록 좋습니다. 이 변화는 PPL이지 정답률 하락이 아닙니다. INT16 재양자화는 NaN이 나온 경로를 유한한 출력으로 되돌리는 핵심 단계입니다.
3. KV를 고정된 사전과 작은 가변 코드로 나눕니다
KV는 앞선 토큰에서 만든 Key와 Value를 다음 토큰 계산에 다시 쓰기 위해 보관한 정보입니다. 저자들은 각 층의 K와 V를 학습된 수치 벡터들의 사전으로 근사합니다. 여기서 “사전”은 단어 뜻을 모은 목록이 아니라, 벡터의 조합에 쓸 기본 숫자 배열입니다.
사전은 Flash에 고정해 두고, 토큰마다 달라지는 정보는 어떤 벡터를 고를지 나타내는 작은 index와 각 벡터를 얼마나 더할지 나타내는 계수로 기록합니다. 최근 창은 목표 크기 W=128로 두고, 그 안의 토큰은 이 근사 사전에 넣지 않고 비압축으로 유지합니다. 동적으로 변하는 전체 KV를 매번 Flash에 다시 기록하는 방식은 아닙니다.
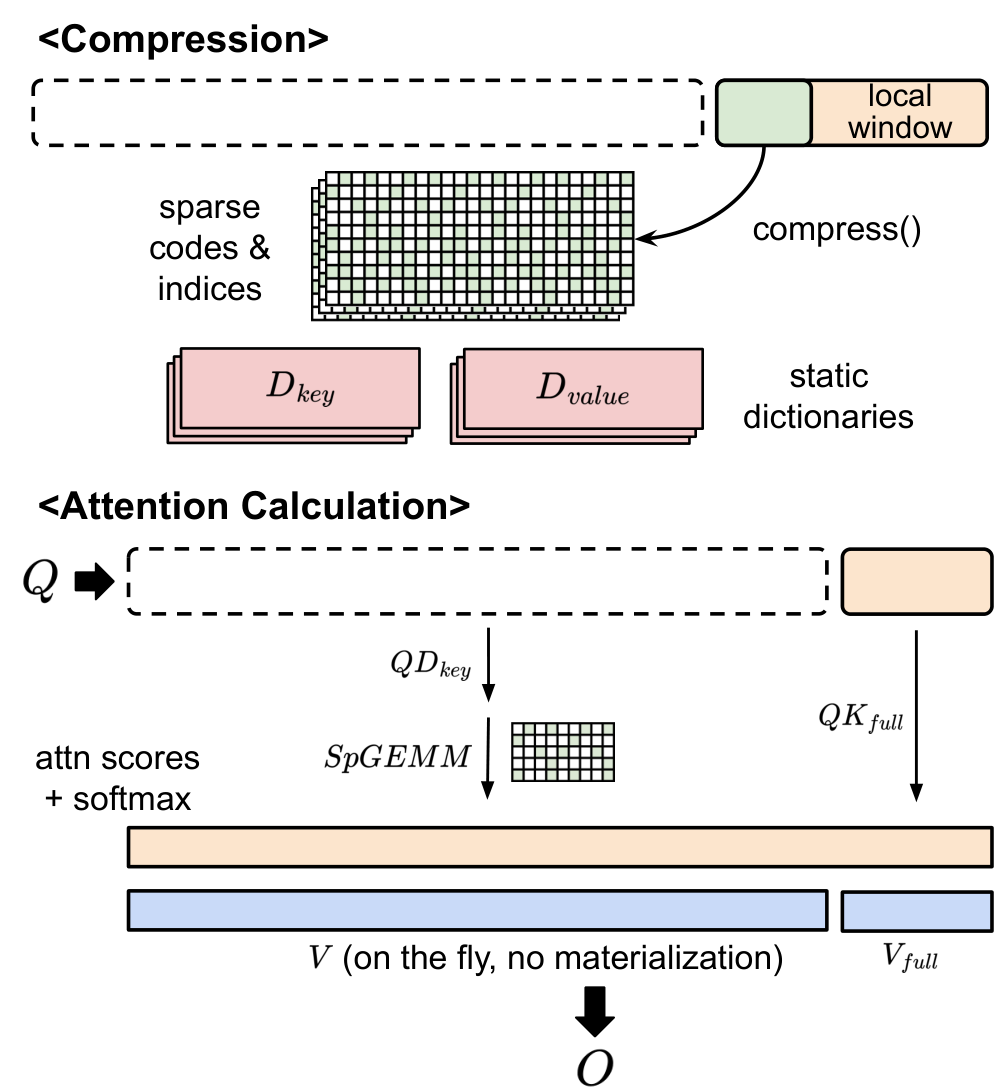
Figure 3. 과거 문맥은 사전과 token별 코드로 표현하고, 최근 창(목표 크기 W=128)은 비압축으로 유지합니다. 출처: Zhao et al. (2026), arXiv v1, p. 7, Fig. 3.
4. 15배는 전체 저장량이나 속도의 배율이 아닙니다
모든 과거 토큰을 똑같은 정밀도로 읽는 대신, 먼저 각 토큰을 사전 벡터 3개로 거칠게 살펴봅니다. 이 점수에서 상위 10%에 든 토큰만 벡터 16개로 더 자세히 처리합니다. 나머지 토큰을 버리는 방식은 아닙니다. 모든 과거 토큰을 남기되 일부만 더 세밀하게 보는 전략입니다.
논문의 약 15배는 디코드 단계에서 읽는 동적 KV 데이터량을 비교한 값이며, 정적 사전 footprint는 이 읽기량 비교에 포함하지 않습니다. 그러므로 전체 메모리 사용량이나 Flash에 기록되는 양이 15분의 1이라는 뜻이 아닙니다. Flash 수명이 15배 늘었다거나 토큰 생성이 15배 빨라졌다는 결과도 아닙니다. 이는 읽기량에 대한 주장입니다.
5. 평균 점수는 비슷하지만 모든 과제가 보존되지는 않습니다
저자들은 LongBench 다섯 과제의 평균을 보고합니다. Llama-3.1-8B는 기준 구성 44.07에서 결합 방법 43.65로, Qwen-2.5-7B는 44.44에서 44.23으로 바뀝니다. 평균만 보면 차이가 작습니다. 하지만 다섯 과제의 점수는 서로 다른 평가 지표를 포함하므로, 이 평균을 모든 과제의 정답률로 바꾸어 읽을 수 없습니다.
특히 Qwen의 코드 완성 과제 lcc는 66.68에서 59.48로 7.20점 낮아집니다. 다른 과제의 상승이 이 손실을 평균에서 가릴 수 있습니다. 따라서 “평균이 비슷하다”는 보고가 모든 과제에서 정확도가 99% 유지된다는 보장은 아닙니다.
6. 4.4배는 분석 모형의 디코드 추정입니다
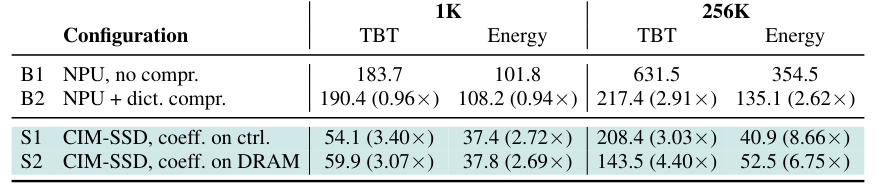
Table 4. Batch 1 Llama-3.1-8B의 분석 모형 결과입니다. 토큰 간 시간(TBT)은 밀리초(ms), 에너지는 토큰당 줄(J/token) 단위이며, S2는 B1보다 1K에서 3.07배, 256K에서 4.40배 빠른 것으로 추정됩니다. 실측 칩·GPU 성능 향상이 아닙니다. 출처: Zhao et al. (2026), arXiv v1, p. 13, Table 4.
4.4배는 batch 1의 Llama-3.1-8B에 대해, 256K 문맥의 S2와 B1을 비교한 저자의 시스템 모형 결과입니다. 256K에서 B1의 631.5ms를 S2의 143.5ms로 나누면 631.5ms ÷ 143.5ms ≈ 4.40입니다. 1K에서는 같은 비교가 3.07배입니다. B1은 FP16 가중치와 전체 FP16 KV를 DRAM에 두는 기준 구성이고, S2는 INT8 가중치와 사전을 CIM Flash에 두고, 동적 코드는 DRAM에 저장합니다. query와 사전 벡터를 대조하고 Value를 조합하는 계산은 CIM에 남습니다. 동적 코드를 다루는 부분만 PCIe로 동기화해 host CPU 쪽에서 처리합니다. 두 시스템은 계산 위치, 자료 표현과 이동 경로가 함께 다르므로, 이 비율을 특정 한 기법만의 이득으로 볼 수 없습니다.
표의 값은 실제 Compute-in-Flash 칩을 제작해 측정한 결과나 최신 GPU와의 실험 승리가 아닙니다. 생성 전 입력을 처리하는 prefill도 포함하지 않습니다. 특히 S2는 모든 일을 Flash에 맡기지 않고 host CPU와 DRAM 경로를 사용합니다. 따라서 논문이 제시한 것은 조건을 둔 디코드 시간 추정이며, 전체 서비스 지연이나 다중 사용자 처리량 측정이 아닙니다.
7. 핵심은 데이터의 위치와 결과의 범위를 함께 보는 것입니다
이 연구는 추론 연산을 정수 경로에 맞추고, KV를 고정 사전과 작은 가변 코드로 나누어 특수한 Flash 연산 구조에 맞추려는 공동 설계입니다. GQA가 K/V head 수를 줄이는 모델 구조를 다룬다면, 이 방법은 만들어진 KV의 표현과 계산 위치를 바꿉니다. Declarative Attention은 읽을 문맥을 선택하고, Context Language Models은 다음 입력 문맥을 편집한다는 점에서 다른 문제를 풉니다.
결과를 적용할 때는 읽기량·모델 품질·시스템 시간 추정을 별개의 증거로 보아야 합니다. 특히 사전 자체의 크기, 실제 장치의 이동 경로와 처리량, 긴 문맥에서의 과제별 품질은 별도로 확인해야 합니다. 상세 읽기에는 정수 경로, 표의 조건, 시스템 모형과 논문 부록의 불일치를 더 자세히 정리했습니다.
References
Zhao, S., Kim, M., Hooper, C., Manolache, L., Mahoney, M. W., Shao, Y. S., Keutzer, K., & Gholami, A. (2026). LLM inference in a flash! [Preprint]. arXiv. https://arxiv.org/abs/2609.16161v1