LLM Inference in a Flash!
데이터를 옮기지 말고 그곳에서 계산한다: LLM Inference in a Flash!
모델을 SSD에 넣는 것과 저장된 곳에서 계산하는 것은 다르다. 정수 추론과 사전 기반 KV 표현을 살펴보고, 동적 KV 읽기 15배 절감과 디코드 시간 4.4배 개선 추정이 각각 무엇을 뜻하는지 분석한다.
Paper: Sebastian Zhao; Minseo Kim; Coleman Hooper; Luca Manolache; Michael W. Mahoney; Yakun Sophia Shao; Kurt Keutzer; Amir Gholami (2026). "LLM Inference in a Flash!" UC Berkeley, ICSI, LBNL. arXiv:2609.16161v1, 2026-09-14. 검토 PDF · 서지 정보. 20쪽의 v1을 기준으로 한다. 원논문이 인용한 2024년 LLM in a flash: Efficient large language model inference with limited memory와는 다른 연구다.
모델이 SSD에 들어간다고 해서 빠르게 답하는 것은 아니다. 다음 토큰을 하나 만들 때마다 가중치와 앞선 문맥의 정보를 연산기로 옮겨야 한다면, 계산보다 이동이 더 오래 걸릴 수 있다. 저장 공간을 늘리는 문제와 저장된 데이터를 빠르게 쓰는 문제는 다르다.
이 논문은 계산을 데이터가 있는 Flash 가까이로 옮기는 Compute-in-Flash를 다룬다. 하지만 일반적인 부동소수점 계산을 그대로 옮기기 어렵고, 자주 바뀌는 KV 캐시를 Flash에 계속 쓰면 내구성이 문제가 된다. 저자들은 계산을 정수 경로로 바꾸고, KV를 고정된 사전과 작은 가변 코드로 나누는 두 가지 방법을 함께 제안한다.
Llama-3.1-8B와 Qwen-2.5-7B의 다섯 LongBench 과제에서는 평균 점수가 비교적 가깝고, 동적 KV 읽기 요구량은 약 15배 줄었다고 보고한다. 그러나 4.4배라는 디코드 시간 개선은 실제 장치 측정이 아니라 분석 모형의 예측이다.
핵심 요약
| 항목 | 설명 |
|---|---|
| 연구 질문 | Flash의 큰 정적 용량과 내부 계산을 활용하면서 FP 연산과 동적 KV 쓰기를 줄일 수 있는가? |
| 정수 추론 | W8A8 선형 연산, group-wise quantization, INT16 재양자화, INT32 기반 비선형·축약 연산. 전부 INT8이라는 뜻은 아니다. |
| KV 표현 | 층별 K/V 정적 사전과 token별 atom index·계수. 최근 창은 비압축으로 남긴다. |
| 읽기 전략 | 모든 token은 3개 atom으로 거칠게 보고, 상위 10%만 16개로 정교화한다. |
| 품질 | 다섯 과제 평균 Llama 44.07→43.65, Qwen 44.44→44.23. Qwen 코드 완성은 66.68→59.48로 하락한다. |
| 15배의 분모 | 사전 footprint를 제외한 decode step의 동적 KV 읽기 요구량. 전체 저장량·쓰기량·속도 15배가 아니다. |
| 시스템 결과 | S2의 B1 대비 TBT 비율: 1K에서 3.07배, 256K에서 4.40배 개선 추정. Batch 1·Llama-3.1-8B 분석 모형이다. |
| 남은 경계 | Prefill 제외, V 사전 두 벌 가정, SRAM·호스트 경로·부록 집계의 불명확성, 실제 장치 검증 부재. |
목차
- Flash에 저장하는 것과 Flash에서 계산하는 것은 다르다
- 정수 추론의 어려움은 행렬곱 밖에도 있다
- NaN을 복구한 절제를 정확히 읽는다
- 동적 KV를 정적 사전과 sparse code로 나눈다
- KV 전체를 복원하지 않고 attention을 계산한다
- 15배 압축은 무엇을 줄인 비율인가
- 평균 품질 보존과 개별 과제 손실을 함께 본다
- 네 시스템 구성은 서로 다른 계산 위치를 갖는다
- 속도와 에너지는 조건부 모형의 결과다
- 유망한 공동 설계와 아직 남은 시스템 검증
1. Flash에 저장하는 것과 Flash에서 계산하는 것은 다르다
한 토큰씩 답을 이어 만드는 autoregressive decoding에서는 새 token 하나를 만들 때마다 가중치와 누적 KV를 읽는다. KV 캐시는 이전 토큰에서 계산한 Key와 Value를 저장해 다음 토큰이 다시 참고하게 하는 공간이다. 큰 모델·긴 문맥·작은 batch에서는 연산기보다 데이터를 옮기는 경로가 먼저 병목이 될 수 있다. Flash의 큰 용량만 이용해 모델을 저장해도, 매번 좁은 외부 버스로 가져온다면 이 문제가 없어지지 않는다.
Compute-in-Flash는 가중치나 사전을 Flash에 고정하고 메모리 배열 가까이에서 계산하려는 접근이다. 메모리 내부·근처의 연산을 활용하는 compute-in-memory(CIM)의 한 형태다. 대신 고정밀 부동소수점(FP) 연산 지원이 제한되고, Flash cell의 program/erase 횟수에도 한계가 있다. 새 token마다 갱신하는 KV를 그대로 Flash에 쌓는 방식은 쓰기 내구성에 불리하다. 일반 SSD에 소프트웨어만 설치하면 이 연산 기능이 생긴다는 뜻은 아니다.
Declarative Attention이 필요한 맥락만 골라 읽는다면, 이 연구는 읽을 표현과 계산 위치 자체를 바꾼다. Context Language Models의 live context 편집과도 다르다. 여기서는 오래된 token을 의미적으로 지우는 대신 그 KV를 근사 표현한다. 어느 방법도 저장량·읽기량·전체 지연을 같은 비율로 줄인다고 가정할 수 없다.
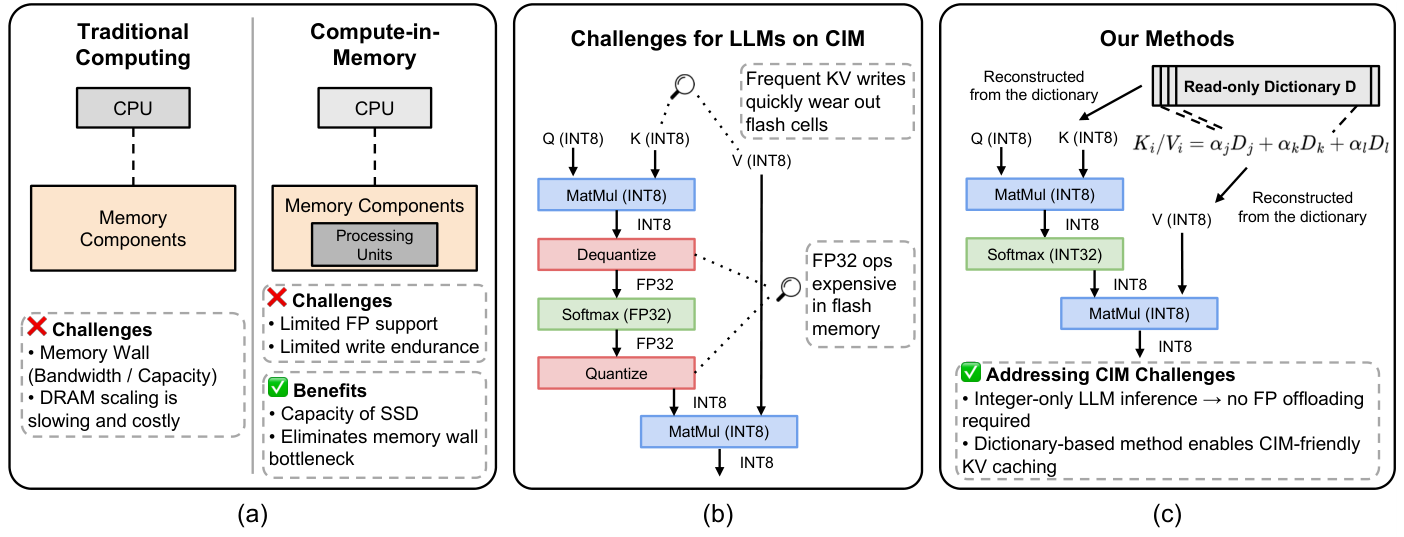
Figure 1. FP 연산과 동적 KV 쓰기 문제에 정수 추론·정적 사전 표현을 대응시킨다. 출처: Zhao et al. (2026), v1, p.2, Fig.1 — 연구·학습 목적 인용.
2. 정수 추론의 어려움은 행렬곱 밖에도 있다
2.1 묶음마다 다른 scale을 쓰면 합산도 달라진다
선형 연산의 weight와 activation을 INT8로 양자화한다. SmoothQuant식 activation smoothing과 hidden dimension의 group-wise scale을 사용하며, 실험 group size는 128이다. Outlier가 큰 activation을 하나의 scale로 표현하는 손실을 줄이는 방식이다.
그러나 서로 다른 scale의 정수를 그냥 더하면 원래 실수 합이 되지 않는다. 예를 들어 같은 정수 10이라도 단위가 0.1인 묶음에서는 1.0, 단위가 0.01인 묶음에서는 0.1을 나타낸다. 단위를 맞추지 않고 10과 10만 더할 수는 없다. 이는 원리를 설명하는 예이며 논문의 실측 입력이 아니다.
Softmax의 합·RMSNorm의 제곱합처럼 여러 원소를 모으는 연산에서는 이 scale을 맞춰야 한다. 따라서 단순히 행렬곱(GEMM)을 INT8로 바꾸는 것만으로 FP 경로를 없앨 수 없다.
2.2 INT16 입력과 INT32 연산을 연결한다
논문은 Softmax·RMSNorm 입력을 token-wise 단일 scale의 INT16으로 재양자화한다. 그런 다음 이차 다항식 기반 지수 근사, 정수 제곱근, fixed-point reciprocal와 multiply-and-shift를 사용한다. SiLU도 지수 근사를 통해 정수 경로로 구현해 SwiGLU를 지원한다.
INT16 입력 자체가 표현 범위 안에 있어도, 이차 다항식의 계수 연산이나 제곱합처럼 중간값을 키우는 계산에서는 INT32 overflow가 생길 수 있다. 논문은 입력 크기에 맞춰 shift하는 방식을 사용한다. 이는 범위를 조절하는 구현 장치이며 bit shift·재양자화가 FP 계산과 무손실로 동등하다는 뜻은 아니다. 근사 다항식과 rounding·saturation·중간 폭이 함께 품질을 결정한다.
따라서 integer-only의 정확한 의미는 추론의 주요 연산을 정수·고정소수점 경로로 연결한다는 것이다. 사전 학습과 calibration까지 모두 INT8로 수행했다거나, host CPU가 전혀 필요 없다거나, 모든 데이터가 8비트라는 뜻은 아니다.
3. NaN을 복구한 절제를 정확히 읽는다
Table 1은 Llama-3.1-8B의 WikiText-2 perplexity를 누적 구성으로 비교한다.
| 구성 | PPL, 낮을수록 좋음 |
|---|---|
| FP16 | 7.5454 |
| Per-tensor W8A8 추가 | 7.6525 |
| SmoothQuant·group quantization(g=128) 추가 | 7.5511 |
| Integer nonlinear approximation 추가 | NaN |
| INT16 requantization 추가 | 7.5803 |
최종 차이는 +0.0349, 상대 약 +0.46%다. 이 값은 perplexity의 변화이지 정답률 0.46%p 감소가 아니다. 또한 SmoothQuant와 group quantization은 한 행에 함께 있어 각각의 독립 기여를 표에서 분리할 수 없다.
중요한 것은 비선형 정수화 직후의 NaN이다. 본문은 이를 ‘modest perplexity increase’라고 설명하지만 표에서는 activation divergence가 발생했다고 적는다. 표와 각주는 중간 구성에서 activation divergence를 보고한다. INT16 재양자화는 이 보고에서 부가적 미세 조정이 아니라 유한한 출력으로 복구하는 핵심 단계다.
Calibration은 Pile validation을 사용한다. 평가 모델·자료가 제한돼 있으므로 이 결과만으로 임의 context 길이·모델·연산 조합의 수치 안전성을 보장할 수 없다. 특히 256K 시스템 비용 모형과 그 길이에서의 정확도 검증은 별개다.
4. 동적 KV를 정적 사전과 sparse code로 나눈다
K와 V의 벡터 x를 사전 D에 저장한 소수의 기본 벡터, 즉 atom의 조합으로 표현한다. 긴 벡터 전체 대신 ‘사전의 어느 벡터를 얼마씩 더할지’를 기록하는 방식이다. 여기서 사전은 단어 뜻을 모은 사전이 아니라 학습한 수치 벡터들의 집합이다.
x\approx D\gamma,\qquad \|\gamma\|_0\le K.사전은 Flash에 정적으로 저장하고, 새 token마다 바꾸는 것은 선택된 index와 coefficient다. 장기 KV state는 여전히 생성되지만 Flash 자체에 전체 KV를 매번 다시 쓰지 않도록 배치한다.
수식의 K는 사용할 atom 수의 예산이며 Key 벡터나 KV head 수가 아니다. Index는 선택한 atom의 위치, coefficient는 그 atom을 더할 때 곱하는 계수다. 이렇게 필요한 항목만 남긴 희소 코드(sparse code)가 동적으로 갱신되는 부분이다.
4.1 사전도 데이터로 학습한다
Pile calibration sequence에서 층별 K/V activation을 추출하고 시간 상관을 줄이도록 섞은 pool로 학습한다. 각 층·K/V stream별로 32,768개 atom의 overcomplete dictionary를 두고 reconstruction MSE를 최소화한다. Encoder를 별도 신경망으로 같이 학습하는 대신 아래의 비모수 sparse coding으로 code를 만들고 decoder, 즉 사전만 최적화한다. 이후 사전을 per-tensor INT8로 양자화한다.
따라서 ‘정적 사전’은 학습 없이 주어진 공용 압축표라는 뜻이 아니다. 배포 중 갱신하지 않는다는 뜻이다. 다른 모델·분포에서도 그대로 통하는지, 학습 비용과 데이터 양이 얼마인지도 별도 문제다.
4.2 OMP와 달리 선택된 계수를 다시 풀지 않는다
Algorithm 1은 column-normalized atom을 가정한다. Residual r=x에서 시작해 다음을 K번 반복한다.
c=D^\top r,\quad j^\star=\arg\max_{j\notin I}|c_j|,\quad
\gamma_{j^\star}=c_{j^\star},\quad
r\leftarrow r-c_{j^\star}d_{j^\star}.
이미 고른 atom은 다시 고르지 않는다. OMP는 support를 늘린 뒤 선택된 계수들을 least-squares로 재추정하지만, 이 방법은 그 refit을 없앤다. 상관 계산과 residual update가 중심이라 CIM의 행렬–벡터 연산에 맞추기 쉽다.
그렇다고 OMP와 같은 해나 최적 sparse reconstruction을 보장하지 않는다. 서로 상관된 atom에서는 나중의 residual update가 앞선 선택 방향에 다시 성분을 만들 수 있다. 얻는 것은 회귀 풀이를 없앤 하드웨어 친화성이고, 추가 projection과 순차 K회 반복의 비용은 남는다.
5. KV 전체를 복원하지 않고 attention을 계산한다
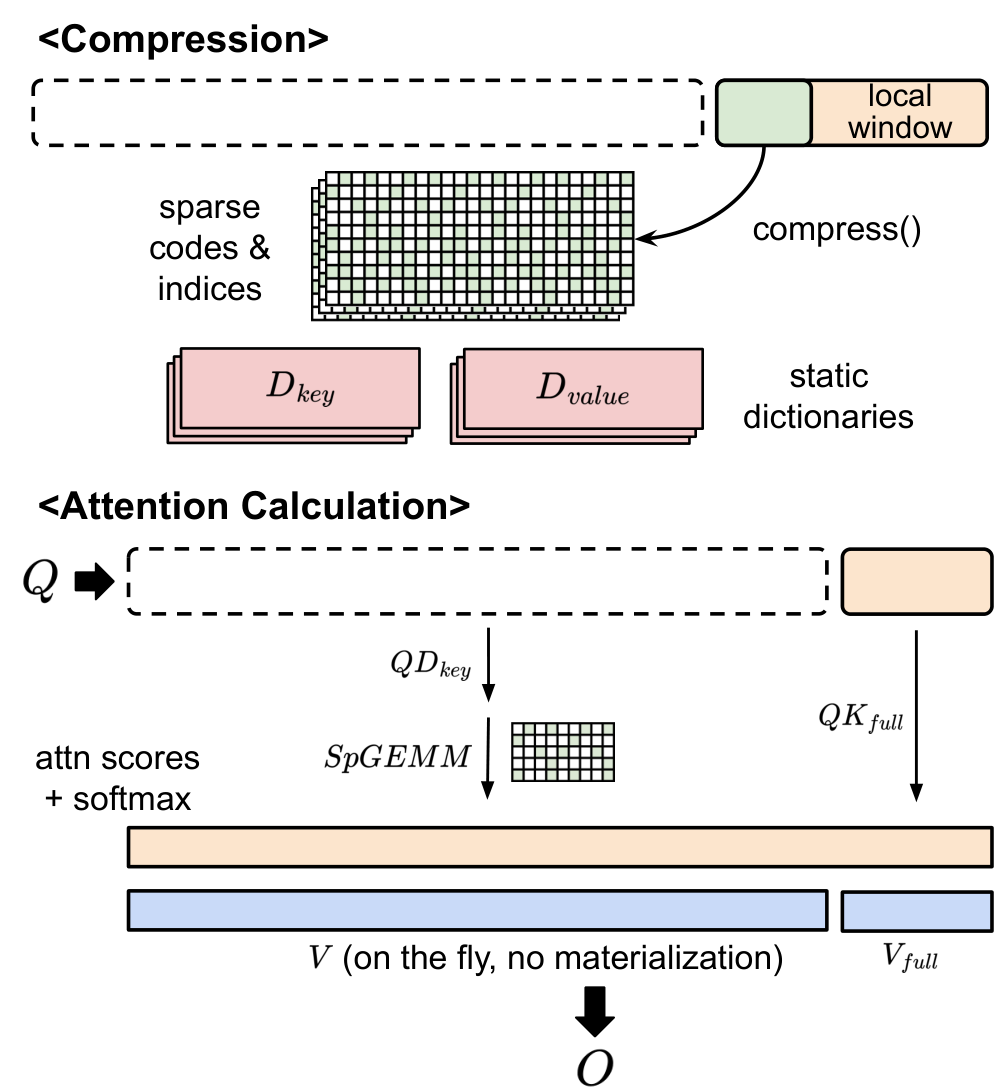
Figure 3. 오래된 문맥의 sparse code와 최근 local window를 결합한다. 출처: Zhao et al. (2026), v1, p.7, Fig.3 — 연구·학습 목적 인용.
최근 창 W=128에 새 KV를 추가하고, 경계에 이르면 오래된 U=32 token을 batch-compress한다. 오래된 KV는 code로, 최근 부분은 비압축 buffer로 유지한다.
원리상 K_{\mathrm{hist}}\approx D_K\Gamma_K, V_{\mathrm{hist}}\approx D_V\Gamma_V라 두면 query q의 score는
q^\top K_{\mathrm{hist}}\approx(q^\top D_K)\Gamma_K로 계산할 수 있다. Value의 합도 D_V(\Gamma_Vp_{\mathrm{hist}})로 처리한다. 여기서 p는 attention 확률이다. 설명상 attention scale을 생략했으며, 실제로는 최근 창과 압축 문맥의 logit을 하나의 softmax로 정규화해야 한다. 두 구역을 따로 정규화한 출력을 단순히 더하는 방법이 아니다.
이 결합 법칙은 dense KV 전체를 메모리에 복원하지 않고 사전 projection과 sparse code를 이용할 수 있게 한다. 다만 큰 사전을 반복해서 읽는 GPU에서는 이 추가 비용이 이득을 상쇄할 수 있다. Flash CIM은 사전을 제자리에 두고 계산한다는 가정 때문에 유리하다.
정밀도 설명에는 주의가 필요하다. §3은 최근 창을 ‘full precision’이라고 부르지만 §4의 시스템 모형은 최근 KV를 INT8 SRAM에 둔다. 두 절의 공통 설명은 ‘비압축 최근 창’이며, 정확도 실험과 시스템 모형의 자료형 대응은 명시되어 있지 않다.
6. 15배 압축은 무엇을 줄인 비율인가
전체 문맥을 모두 높은 K로 읽지 않기 위해, 먼저 각 token의 첫 Klow=3개 atom으로 proxy score를 만든다. 그 score의 상위 10%만 Khigh=16개로 정교화하고 나머지는 낮은 해상도로 둔다. Token을 전부 버리는 eviction과 다르다. 다만 coarse score가 중요한 token을 낮게 평가할 수 있으며, 이 선택은 정확한 top attention을 보장하는 상한 기반 pruning이 아니다.
평균 읽는 atom 수와 저장한 atom 수
상위 10%가 16개, 나머지가 3개라면 최종 표현의 평균 활성 atom 수는
\bar K=0.1\times16+0.9\times3=4.3.Table 2의 K=16에서 4배라는 dynamic compression을 같은 atom당 비용으로 외삽하면
4\times\frac{16}{4.3}\approx14.88로 약 15배와 맞는 규모다. 이 계산은 표의 비율을 설명하며, index·계수 bit packing과 모든 buffer를 포함한 byte-level 저장량은 아니다. Coarse pass의 데이터 재사용, 최근 창, dictionary 읽기 등도 실제 traffic에 영향을 준다.
Table 2·3의 캡션은 비율을 ‘각 decoding step에서 읽어야 하는 dynamic memory, dictionary footprint 제외’라고 정의한다. 향후 query에 따라 어떤 token이 정교화될지 바뀌므로, 읽을 때 3개만 사용하는 token도 저장 단계에서 나머지 code가 필요할 수 있다. 따라서 15배를 전체 code 저장량이나 새 KV 쓰기량의 감소율로 쓰면 안 된다.
Static dictionary와 weight는 Flash에 두고 동적 code를 SRAM 또는 DRAM에 두는 배치가 endurance 문제를 피하는 핵심이다. ‘Flash 수명 15배’나 ‘모든 저장장치 쓰기 15배 감소’를 측정한 결과는 아니다. 참고문헌의 다른 SSD 연구에서 인용한 TBW·수명 추정도 이 시스템을 직접 시험한 값이 아니다.
7. 평균 품질 보존과 개별 과제 손실을 함께 본다
원문 §5.3은 LongBench 전체 평균처럼 설명하지만 Table 2·3에 실제 제시된 항목은 다섯 과제다. 표시 평균도 그 다섯 값의 산술평균과 맞는다. 이를 LongBench 모든 과제의 결과로 확대하지 않는다.
| 모델·구성 | multifieldqa-en | 2wikimqa | gov_report | trec | lcc | 평균 |
|---|---|---|---|---|---|---|
| Llama FP16 full KV | 32.79 | 13.99 | 30.20 | 73.00 | 70.35 | 44.07 |
| Llama 결합 방법 | 31.17 | 13.95 | 30.41 | 73.00 | 69.71 | 43.65 |
| Qwen FP16 full KV | 35.36 | 15.98 | 32.20 | 72.00 | 66.68 | 44.44 |
| Qwen 결합 방법 | 40.01 | 19.52 | 29.64 | 72.50 | 59.48 | 44.23 |
Table 3, p.12. 서로 다른 과제 지표의 점수이며 전부 같은 정답률 단위는 아니다.
평균 차이는 Llama −0.42점, Qwen −0.21점이다. 표시 평균의 baseline 대비 비율은 약 99.05%·99.53%다. 원문의 ‘99% 유지’는 평균 수준의 요약이지 각 과제에서 99%를 보장한다는 뜻은 아니다.
Qwen은 multifieldqa-en +4.65, 2wikimqa +3.54가 gov_report −2.56, lcc −7.20을 상쇄한다. Code completion이 주 용도라면 평균 −0.21만 보고 무손실에 가깝다고 판단하기 어렵다. 신뢰구간·반복 seed·문항별 결과 없이 상승한 QA 점수도 통계적으로 확정된 개선으로 부르지 않는다.
KV 단독 Table 2에서는 full 44.07, sparse coding 44.61, hierarchical 44.56을 보고한다. 그러나 본문이 설명하는 OMP→projection pursuit→dictionary INT8→hierarchical 네 단계에 대응하는 별도 행은 모두 없다. 세 행만으로 OMP refit 제거와 dictionary quantization의 각각의 품질 효과를 완전히 분리할 수는 없다.
8. 네 시스템 구성은 서로 다른 계산 위치를 갖는다
시스템 평가는 Python 분석 모형이다. 공통 workload는 Llama-3.1-8B, batch 1의 autoregressive decoding이며 GQA의 32층·query head 32·KV head 8·head dimension 128을 구분한다.
GQA가 query head 사이에서 K/V를 공유하도록 모델 구조를 바꾼다면, 이 방법은 그 모델이 만든 KV를 사전과 코드로 표현한다. GQA를 대체하는 방법이 아니라 GQA 모델 위에서 KV의 표현과 처리 위치를 바꾸는 방법이다. 여기의 32 query·8 KV는 시스템 모형의 Llama 설정이며, 앞선 GQA 리뷰가 다룬 T5 실험 설정과 혼동하지 않는다.
| 구성 | Weight·dictionary | 동적 KV/code와 실행 |
|---|---|---|
| B1 | NPU+DRAM, FP16 weight | 전체 FP16 KV를 DRAM에 기록·읽음 |
| B2 | NPU+DRAM, dictionary도 DRAM | Dictionary compression 사용, 별도의 dictionary 이동 비용 발생 |
| S1 | INT8 weight·dictionary는 CIM Flash | 최근 창·code·임시 상태 모두 controller SRAM, no overflow 가정 |
| S2 | INT8 weight·dictionary는 CIM Flash | Code는 DRAM, attention의 code 처리는 CPU 쪽으로 보내고 PCIe로 동기화 |
헤드라인은 **B1을 기준으로 한 S2의 개선 비율(B1/S2)**이다. S2는 controller 자원이 부족한 긴 문맥에서 host CPU를 활용하는 구성이다. 정수 비선형 연산으로 FP offloading을 줄였다는 주장과 host·DRAM·PCIe가 사라졌다는 주장은 다르다.
비용 모형에 들어간 가정
DDR5 bandwidth 76.8GB/s, PCIe Gen4×4 8GB/s, 내부 버스 16GB/s, DRAM 64GB, Flash 512GB, controller SRAM 192MB를 둔다. Compute·transfer의 overlap은
\operatorname{overlap}(t_1,t_2)=\max(t_1,t_2)+(1-\rho)\min(t_1,t_2)이고 NPU는 ρ=0.8, CIM은 0.9다. 서로 의존하는 pursuit iteration은 순차적으로 계산한다. 엔진 처리량·memory energy는 선행 하드웨어 자료와 보정값에 기반한다. Flash 내부 peak 1TB/s라는 대역폭 표기를 일반 TOPS와 무조건 같은 단위로 읽지 않는다.
B1 대 S1/S2는 FP16→INT8, weight 이동 제거, dictionary 압축, 계산 위치, overlap 가정이 함께 달라진다. 한 모듈만의 독립 효과가 아니라 공동 설계의 비교다. 동일 정밀도·동일 하드웨어 자원의 최신 GPU baseline에 대한 실측 승리도 아니다.
보고의 빈칸
B2 pursuit 위치는 §4에서 NPU, §5.5에서 CPU라고 적혀 있어 비용 모형을 재현하려면 확인해야 한다. Appendix A는 512GB·32GB/die·6MB SRAM/die로 설명하면서 SRAM 192MB를 쓴다. 단순 계산은 16die×6MB=96MB이므로 추가 die·집계 방식이 설명돼야 한다. 이 글은 192MB를 임의로 고쳐 넣지 않는다.
Compute energy도 Appendix A 본문은 I8 MAC 0.1pJ, Table A.1의 SSD-CIM 행은 0.01pJ로 서로 다르다. 어떤 값을 실제 모형에 사용했는지 확인해야 한다. 개별 연산 계수의 10배 차이가 전체 에너지 추정의 10배 오류라는 뜻은 아니다.
S1은 긴 context에서도 code가 SRAM에 모두 들어간 no-overflow 경로다. 표의 256K 결과를 실제 192MB에서 그 배치가 검증된 것으로 보지 않는다. 저장된 code의 총량과 index·계수 형식, dictionary 공유 범위가 있어야 용량을 독립 계산할 수 있다.
9. 속도와 에너지는 조건부 모형의 결과다
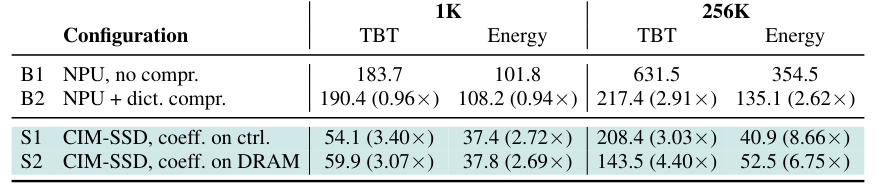
Table 4. 실제 장치 벤치마크가 아닌 Llama-3.1-8B·batch 1의 modeled decode TBT/energy. 출처: Zhao et al. (2026), v1, p.13, Table 4 — 연구·학습 목적 인용.
| Context | B1 TBT / energy | S2 TBT / energy | B1/S2 시간 배율 | B1/S2 에너지 배율 |
|---|---|---|---|---|
| 1K | 183.7ms / 101.8J | 59.9ms / 37.8J | 3.07× | 2.69× |
| 64K | 294.3ms / 164.2J | 80.6ms / 41.4J | 3.65× | 3.97× |
| 256K | 631.5ms / 354.5J | 143.5ms / 52.5J | 4.40× | 6.75× |
1K·256K는 Table 4, 64K는 Table C.1. 배율은 표시된 절대값으로 계산했다. 64K energy의 원표 괄호는 3.96×로 적혀 있어 마지막 자리의 반올림 차이를 보존한다.
헤드라인 3.1/2.7배와 4.4/6.8배는 S2의 반올림 요약이다. Time-between-tokens와 token당 energy이지 prefill·전체 응답·다중 사용자 throughput을 모두 포함한 수치는 아니다.
압축이 항상 빨라지는 것은 아니다
1K에서 B2는 190.4ms·108.2J로 B1의 183.7ms·101.8J보다 오히려 나쁘다. 짧은 문맥에서는 줄이는 KV보다 dictionary를 옮기고 code를 만드는 고정 비용이 크다. 256K에서는 B2도 217.4ms·135.1J로 개선된다. 압축 방식의 가치는 context와 memory hierarchy에 의존한다.
S1은 256K에서 208.4ms·40.9J, S2는 143.5ms·52.5J다. S2는 약 1.45배 빠르지만 약 28.4% 많은 energy를 사용한다. Controller의 제한된 처리량 대신 CPU를 쓰는 효과와 DRAM 이동 비용의 trade-off다. Code를 밖으로 보낸다고 무조건 느려지는 것도, 빨라진다고 에너지까지 줄어드는 것도 아니다.
비선형 연산만의 개선은 별도 표다
Appendix B.2는 nonlinear offloading 대비 controller integer 경로가 1K에서 54.86→54.53ms, 256K에서 283.99→224.33ms라고 보고한다. 이는 약 1.01·1.27배이며 전체 B1→S2의 3.07·4.40배와 다르다. 정수 Softmax 하나가 전체 가속을 만들었다고 설명하지 않는다.
부록 간 연결도 완전히 명확하지 않다. B.1의 256K SiLU latency 669.412ms는 B.2의 전체 integer TBT 224.33ms보다 크다. B.1은 nonlinear layer forward pass, B.2는 system decode로 표시되므로 같은 token·layer·workload 집계라고 가정해 더하면 안 된다. 또한 B.2의 224.33ms와 본문 S1 208.4ms도 동일한 값은 아니다. 숨은 집계·구성 차이를 임의로 만들어 맞추지 않고 모형 코드와 산정 범위가 필요한 지점으로 남긴다.
10. 유망한 공동 설계와 아직 남은 시스템 검증
저자가 명시한 한계
연구는 generation/decode에 초점을 맞춘다. Compute-bound prefill까지 효율적으로 CIM에 매핑하는 것은 향후 과제다. 또 V dictionary는 pursuit에서 transpose 방향, 출력 합성에서 non-transpose 방향으로 접근하므로 두 벌을 Flash에 저장한다고 가정한다. Static 저장 비용이 사라지는 것이 아니라 Flash 용량과 내부 계산을 활용하는 것이다.
References
Zhao, S., Kim, M., Hooper, C., Manolache, L., Mahoney, M. W., Shao, Y. S., Keutzer, K., & Gholami, A. (2026). LLM inference in a flash! [Preprint]. arXiv. https://arxiv.org/abs/2609.16161v1