DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
큰 모델의 용량은 남기고, 한 번의 계산은 줄일 수 있을까? — DeepSeek-V2 쉽게 읽기
DeepSeek-V2는 236B 전체 용량에서 token당 21B만 활성화하고, MLA로 K/V 저장을 바꾼다. 다만 93.3% 캐시 절감과 42.5% 학습 비용, 5.76배 생성 처리량은 서로 다른 조건의 수치다.
Paper: DeepSeek-AI (2024). "DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model". arXiv:2405.04434v5. 검토 PDF · arXiv:2405.04434v5. 2024년 6월 19일 공개된 v5, 52쪽을 기준으로 설명합니다.
언어 모델은 문장을 작은 단위인 token(텍스트 처리 단위)으로 나누어 하나씩 생성합니다. 생성할 때는 앞서 나온 토큰의 정보를 다시 참고합니다. 이 정보를 Key와 Value(KV)로 보관하는 공간이 KV 캐시입니다. 문맥이 길어지면 캐시가 커지고, 매 token마다 모델이 수행할 계산도 남습니다.
DeepSeek-V2는 전체 236B(2,360억; B는 십억 단위) 가운데 token당 21B만 활성화합니다. MLA(Multi-head Latent Attention)는 과거 K/V 저장 표현을 바꾸고, MoE(Mixture-of-Experts)는 계산에 참여할 expert를 고릅니다. 저자들은 효율 개선을 보고하지만, 93.3%, 42.5%, 5.76배는 서로 다른 조건의 수치입니다.
기존 GQA 리뷰는 K/V head를 그룹으로 공유하는 방법과 비교할 때 도움이 됩니다. LLM Inference in a Flash! 리뷰는 분석 모형의 예측과 장치에서 측정한 성능을 구분합니다. 상세 읽기에서는 논문의 식과 비교 조건을 더 자세히 확인합니다.
1. 236B 모델에서 token당 21B만 계산합니다
각 층에는 FFN(토큰별 정보를 변환하는 신경망 블록)이 있습니다. 일반적인 Dense 모델은 한 token을 처리할 때 많은 층에서 대부분의 신경망 가중치를 사용합니다. MoE는 여러 전문 신경망, 즉 expert를 준비하고 token에 따라 일부만 활성화합니다. 따라서 전체 모델이 가진 파라미터 수와 한 token을 계산할 때 참여하는 파라미터 수가 달라집니다.
DeepSeek-V2는 총 236B 파라미터 중 token당 21B를 활성화합니다. 21B는 모델이 실제로 보관해야 하는 전체 가중치 수가 아닙니다. 활성화하지 않은 expert의 가중치도 모델 용량에 포함됩니다. 그러므로 21B만 계산한다는 말이 21B 모델과 같은 저장 메모리나 전체 비용을 뜻하지 않습니다. Attention과 expert 간 통신 비용도 남습니다.
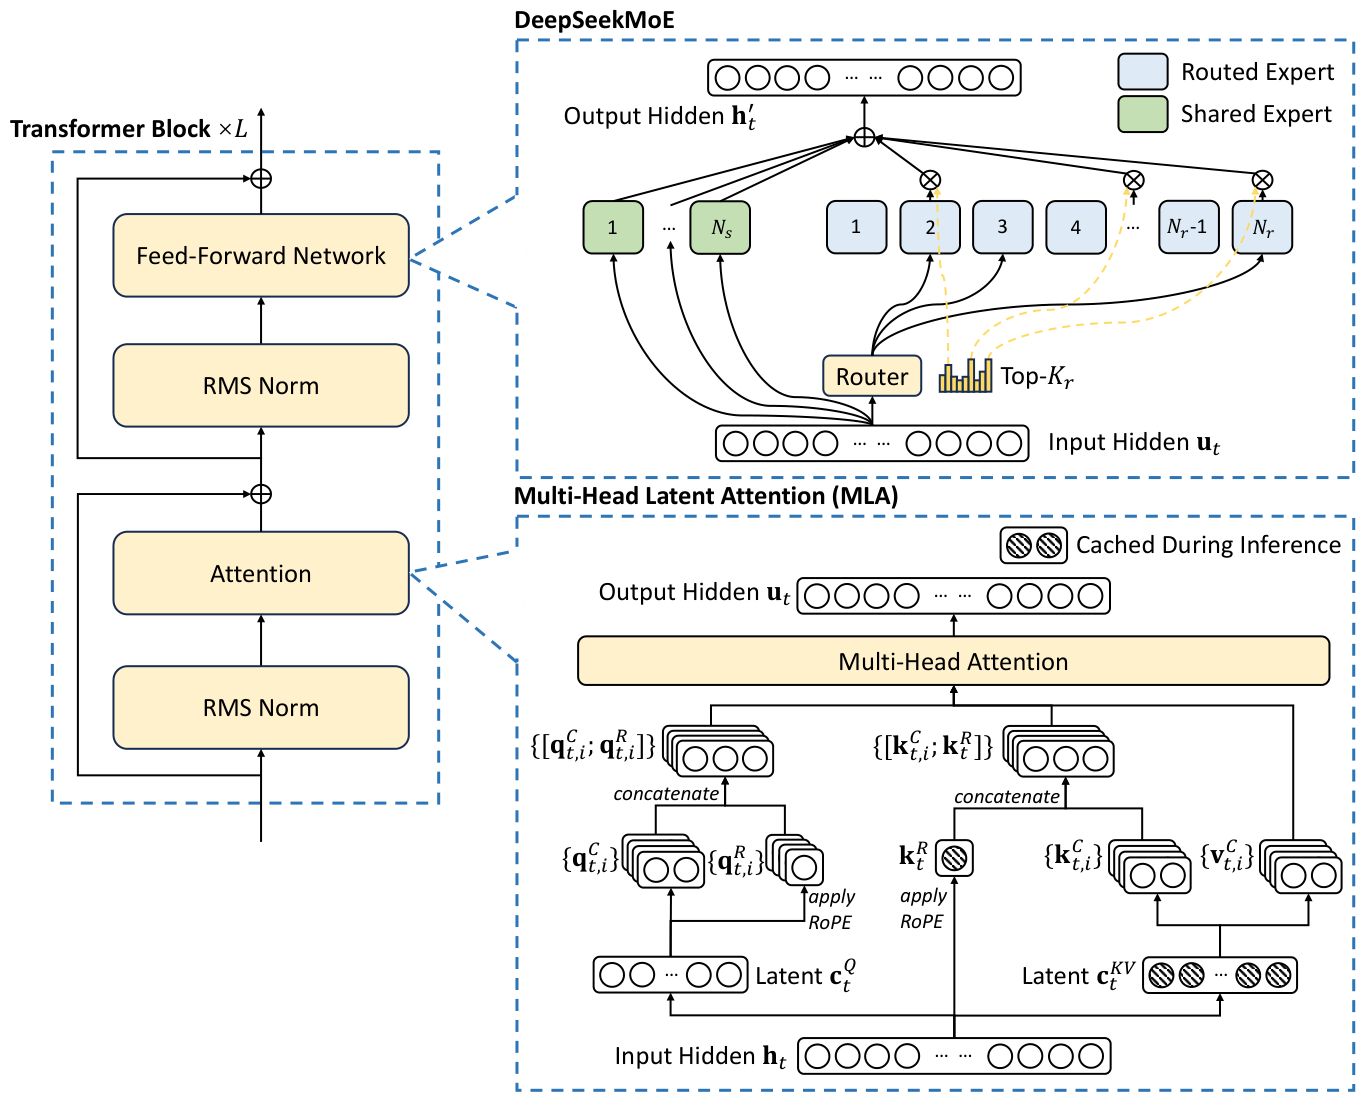
Figure 2. Attention과 FFN이 각각 캐시 표현과 활성 계산을 바꿉니다. 출처: DeepSeek-AI (2024), v5, p. 5, Fig. 2. 도식은 배포 메모리나 처리량을 측정한 결과가 아닙니다.
2. MLA는 K와 V를 공동 저차원 표현으로 저장합니다
KV 캐시는 다음 토큰이 이전 토큰의 정보를 다시 볼 수 있도록 K와 V를 저장합니다. 기존 MHA나 GQA에서는 여러 K/V 표현을 보관합니다. MLA는 토큰마다 K와 V를 따로 저장하는 대신, 둘을 만들 때 함께 쓰는 512차원 latent(여러 head의 정보를 묶는 공동 저차원 표현) 하나를 저장합니다. 각 attention head는 이 latent를 이용해 자기 K/V 표현을 계산하므로, head가 하나로 합쳐지는 것은 아닙니다.
다만 latent만 저장하면 설명이 끝나지 않습니다. DeepSeek-V2는 위치 정보를 위한 64차원 RoPE key도 별도로 저장합니다. 실제 cache 표현은 512차원 공동 latent와 64차원 위치 key입니다. 512차원만으로 전체 cache를 셌다고 하면 위치 성분을 빠뜨립니다. Query를 압축하는 별도 경로도 있지만, 이는 과거 토큰 cache를 줄이는 항은 아닙니다.
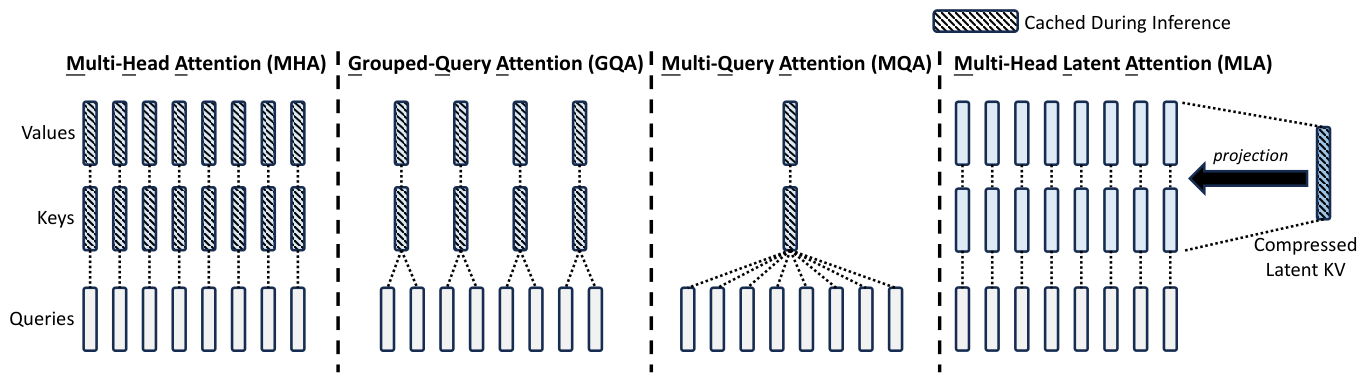
Figure 3. MLA는 여러 head의 K/V 표현을 공동 latent에서 만듭니다. 출처: DeepSeek-AI (2024), v5, p. 7, Fig. 3. 위치 key가 생략된 개념도이므로 이것만으로 실제 cache 용량을 판단하지 않습니다.
3. RoPE는 분리하고, 행렬 계산은 학습된 MLA 안에서 재배치합니다
RoPE는 토큰 위치에 따라 Query와 Key를 회전시켜 순서 정보를 반영합니다. 이 회전을 content K에 바로 적용하면 위치별 변환이 K를 만드는 행렬과 섞입니다. 그러면 K projection(선형 변환)을 Query 쪽으로 미리 옮기기 어려워집니다. DeepSeek-V2는 content 표현과 위치 표현을 나누고, 각 head의 점수에 두 경로의 결과를 더합니다. 그래서 content 계산은 latent 안에서 처리하고, 위치 key는 따로 보관합니다.
논문이 말하는 행렬 흡수는 이미 학습된 MLA 안에서 같은 latent와 head별 projection을 이용해 계산 순서를 바꾸는 것입니다. 과거 토큰마다 큰 K/V를 다시 펼쳐 저장하지 않으면서 같은 attention 계산을 할 수 있습니다. 그러나 이것은 임의의 기존 MHA를 압축된 MLA로 바꿔도 원래 함수를 완벽히 보존한다는 뜻이 아닙니다. 양자화와 수치 정밀도 차이가 전혀 없다는 주장도 아닙니다.
4. 93.3% 캐시 절감에는 비교 기준과 정밀도가 필요합니다
캐시 크기를 비교할 때는 layer 수, K/V head 수, 각 head의 차원, 숫자를 저장하는 bit 수를 함께 봐야 합니다. 원소 수만 같아도 더 낮은 정밀도로 저장하면 byte 수가 줄어듭니다. DeepSeek-V2의 headline인 93.3%는 MLA 구조 하나만의 효과로 곧바로 읽을 수 없습니다.
논문이 비교한 DeepSeek 67B의 공개 config(pinned revision)는 고정 설정 파일 기준으로 95층, KV head 8개, head dimension 128입니다. V2는 60층이고 각 층에서 512차원 공동 latent 하나와 64차원 위치 key를 저장합니다. baseline KV를 16bit, V2 KV를 평균 6bit로 가정하고 metadata와 padding을 빼면 token당 약 389,120 bytes와 25,920 bytes가 됩니다. 이 가정에서는 V2 cache가 약 93.34% 작습니다.
두 모델의 KV를 모두 16bit로 놓으면 V2는 69,120 bytes가 되고, 절감률은 약 82.24%입니다. 이 계산은 비교 조건을 맞춰 보는 재구성입니다. 공개 config의 bfloat16은 기본 가중치 dtype이지 baseline 서비스 KV가 실제 16bit였다는 기록은 아닙니다. 따라서 93.3%를 재현된 동일 정밀도 결과나 확정된 baseline KV dtype으로 설명하지 않습니다.
5. 8.1T(T는 조 단위) token 사전학습 뒤 128K 정보 회수를 따로 평가합니다
DeepSeek-V2는 8.1T token으로 사전학습했고, 이때 최대 sequence length는 4K였습니다. 긴 문맥은 별도 단계입니다. YaRN 설정을 사용해 32K 길이로 1,000 step 추가 학습한 뒤 최대 128K 문맥에서 Needle In A Haystack(NIAH), 즉 긴 입력에 숨긴 정보를 찾아 답하는 시험을 했습니다.
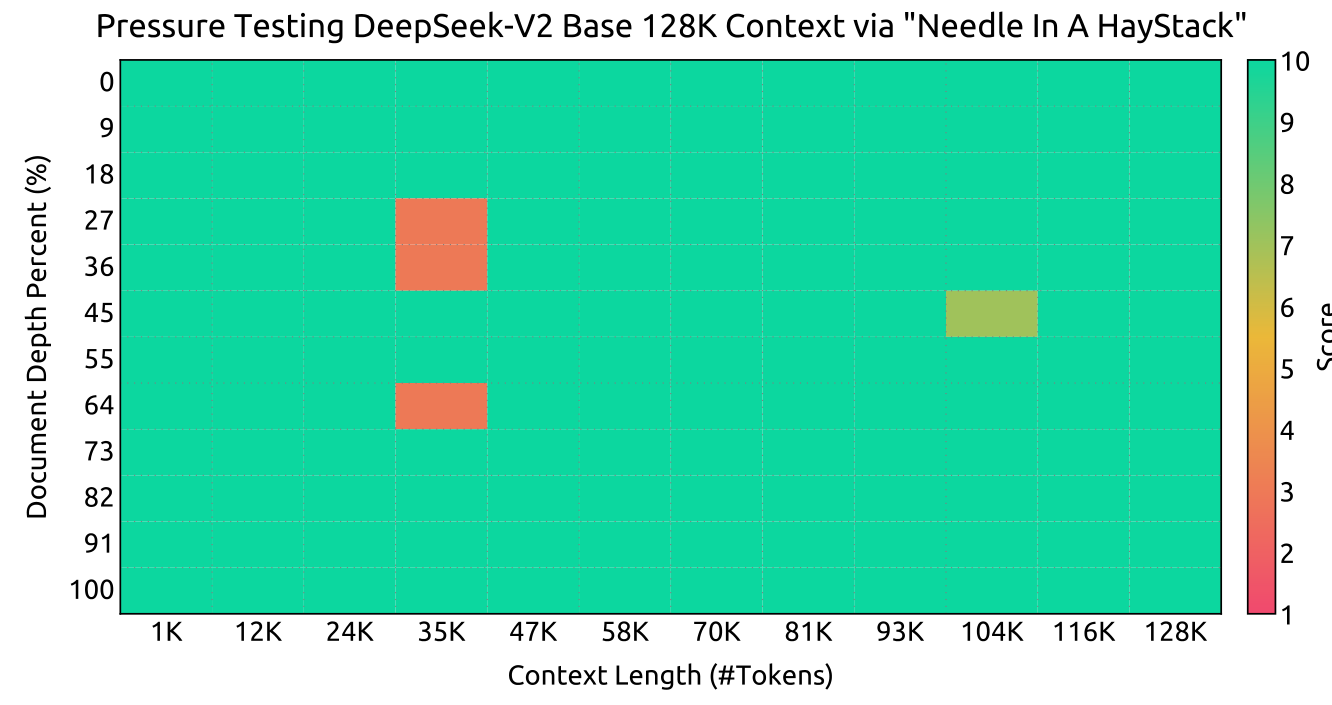
Figure 4. 여러 위치의 정보를 회수하는 NIAH 결과입니다. 출처: DeepSeek-AI (2024), v5, p. 13, Fig. 4. 이 시험은 긴 추론이나 모든 128K 입력에서의 완벽한 기억을 보장하지 않습니다.
따라서 8.1T·4K 사전학습, 32K 추가 학습, 128K retrieval 평가를 하나의 훈련 조건으로 섞으면 안 됩니다. NIAH는 지정한 정보를 찾는 과제이지, 여러 문서의 모순을 해결하거나 긴 코드 전체를 이해하는 능력의 종합 시험은 아닙니다. MLA cache도 문맥이 길어질수록 늘어납니다.
6. 작은 활성 계산에는 expert routing과 품질 trade-off가 따릅니다
첫 번째 FFN 층을 제외하면 MoE 층마다 공통 경로인 shared expert 2개와 선택형 routed expert 160개가 있습니다. token마다 routed expert 6개를 사용합니다. expert는 8개 장치에 나뉘고, 논문은 한 token이 도달하는 장치를 최대 3개로 제한합니다. 이것은 160개 expert 중 제한 없이 top-6을 고르는 방식과 다릅니다. 부하 균형 손실은 쏠림을 줄이도록 유도하지만, 모든 장치의 계산량이 매 순간 같음을 보장하지 않습니다.
평가표에서도 V2가 모든 항목에서 가장 높지는 않습니다. 예를 들어 base MMLU는 V2 78.5, LLaMA 3 70B 78.9이고, HellaSwag는 각각 84.2와 87.9입니다. MATH에서는 V2가 43.6으로 비교 모델보다 높지만, 중국어 C-Eval에서는 별도 Qwen1.5 72B의 83.7보다 V2의 81.7이 낮습니다. 데이터와 평가 조건이 다르므로 차이를 MLA나 MoE 한 요소의 효과로 단정하지 않습니다.
7. 효율 수치는 서로 다른 질문에 답합니다
사전학습 뒤에는 helpfulness와 safety 예시 1.5M개로 supervised fine-tuning(SFT)을 하고, Group Relative Policy Optimization(GRPO)으로 reasoning과 사람 선호에 맞춘 추가 학습을 합니다. GRPO는 별도 critic/value model(현재 상태에서 기대되는 보상을 추정해 정책의 기준을 제공하는 모델) 없이 같은 질문의 여러 응답을 비교합니다. 이에 비해 reward model(응답에 보상 점수를 매기는 모델)은 응답별 점수를 제공합니다. 논문은 첫 단계에서 code·math reward model을 쓰고, 다음에는 helpfulness·safety·rule reward를 조합합니다.
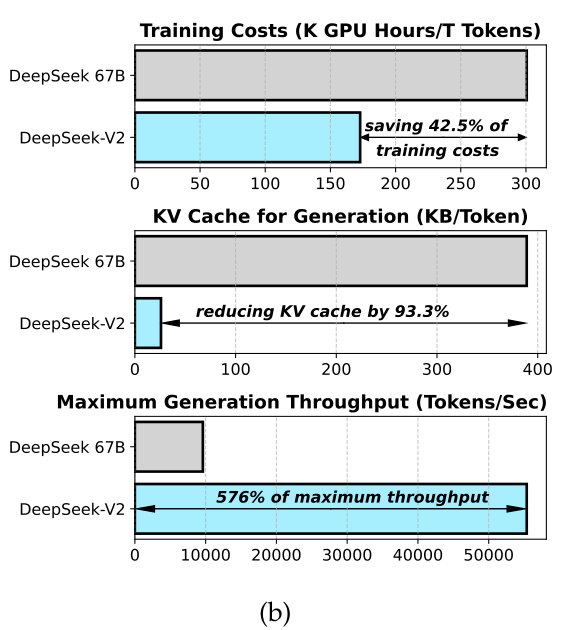
Figure 1(b). 학습 비용, cache 용량, 생성 처리량의 비교 기준이 서로 다릅니다. 출처: DeepSeek-AI (2024), v5, p. 1, Fig. 1(b). 최대 처리량은 batch-1 응답 지연을 나타내지 않습니다.
저자들이 보고한 42.5%는 H800에서 1T token을 학습하는 GPU-hours 비교입니다. GPU-hours는 각 GPU의 사용 시간을 합산한 값입니다. 모든 GPU를 같은 시간 사용했다면 GPU 수에 그 시간을 곱합니다. 따라서 전체 사전학습 프로젝트의 GPU-hours가 42.5% 줄었다는 뜻도, 실제 금액이나 경과 시간이 그만큼 감소했다는 뜻도 아닙니다. 5.76배는 H800 GPU 8개를 묶은 한 노드에서 여러 요청을 합친 최대 생성 처리량을 DeepSeek 67B와 비교한 값입니다. prompt 처리량과 생성 처리량은 따로 보고되며, batch-1 latency나 사용자 한 명의 응답이 5.76배 빨라졌다는 뜻이 아닙니다.
정렬 뒤에는 코드·수학과 일부 사람 선호 점수가 오르는 한편 MMLU나 C-Eval 등 일부 지표가 내려갑니다. 저자들은 이런 변화를 alignment tax로 설명합니다. 하나의 점수가 올랐다고 모든 능력이 좋아졌다거나, GRPO가 정확성과 안전성을 자동으로 보장한다고 볼 수 없습니다. DeepSeek-V2의 기여를 읽을 때는 MLA의 cache 표현, MoE의 활성 계산, 시스템의 학습·서빙 수치를 분리해야 합니다. 각 수치는 논문이 명시한 조건 안에서만 의미가 있습니다.
References
DeepSeek-AI. (2024). DeepSeek-V2: A strong, economical, and efficient mixture-of-experts language model [Preprint]. arXiv. https://arxiv.org/abs/2405.04434v5
DeepSeek-AI. (n.d.). deepseek-llm-67b-base: config.json [Model configuration, revision c3f813a1121c95488a20132d3a4da89f4a46452f]. Hugging Face. https://huggingface.co/deepseek-ai/deepseek-llm-67b-base/resolve/c3f813a1121c95488a20132d3a4da89f4a46452f/config.json