DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
큰 모델의 용량은 남기고, 한 번의 계산은 줄일 수 있을까?
DeepSeek-V2는 236B 전체 용량에서 token당 21B만 활성화하고, MLA로 K/V 저장을 바꾼다. 다만 93.3% 캐시 절감과 42.5% 학습 비용, 5.76배 생성 처리량은 서로 다른 조건의 수치다.
Paper: DeepSeek-AI (2024). "DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model". arXiv:2405.04434v5. 검토 PDF · arXiv:2405.04434v5 · 공식 저장소. 최초 공개 2024-05-07, 검토 판본은 v5, 2024-06-19, 52쪽이다. 이후 DeepSeek-V3·R1의 방법과 성과를 이 판본에 소급하지 않는다.
다음 토큰을 만들 때 모델은 이전 문맥의 Key와 Value를 다시 참고한다. 문맥이 길어질수록 이 정보를 보관하는 KV 캐시가 커지고, 매 token마다 계산할 FFN도 남는다. 모델 전체를 작게 만들면 계산은 줄 수 있지만 표현 용량도 함께 줄 수 있다. DeepSeek-V2는 이 문제를 한 가지 기술로 해결하는 대신, 캐시에 저장하는 표현과 token마다 활성화하는 expert, 장치 간 계산 배치를 따로 설계한다.
이 논문은 전체 236B 파라미터 중 token당 21B를 활성화하는 MoE 모델을 보고한다. MLA는 각 head의 K/V를 그대로 저장하는 대신 공동 latent와 별도 위치 key를 저장한다. 저자들은 캐시·학습·생성 효율의 개선을 제시하지만, 각 숫자의 비교 조건은 다르다.
핵심 요약
| 항목 | 핵심 |
|---|---|
| 모델 | 60층, hidden 5,120, 총 236B·활성 21B. 활성 파라미터는 전체 가중치 저장량이 아니다. |
| MLA | Head별 K/V를 저장하는 대신 512차원 공동 latent와 64차원 RoPE key를 저장한다. |
| 행렬 흡수 | 선형 up-projection을 query/output 쪽으로 합성해 매번 전체 K/V를 복원하지 않는다. |
| MoE | 첫 FFN을 제외하고 shared 2개+routed 160개 중 6개를 활성화. Token의 expert 목적지는 최대 3개 장치. |
| 장문 | 4K 사전학습 후 YaRN과 32K 추가 학습, 128K NIAH 평가. 일반적인 128K 추론 능력 보증은 아니다. |
| 품질 | 당시 비교 모델들과 경쟁력 있지만 모든 영어·중국어·수학 과제에서 최고는 아니다. |
| 정렬 | SFT 1.5M, 이후 reasoning→human preference RL. GRPO는 critic을 없애지만 reward model은 사용한다. |
| 효율 경계 | 42.5%는 1T token당 GPU-hours, 5.76배는 8 H800 한 node의 최대 생성 처리량. |
목차
- 큰 저장 용량과 적은 활성 계산을 분리한다
- MLA는 K와 V를 하나의 latent에서 복원한다
- RoPE를 분리해야 행렬 흡수를 유지할 수 있다
- 93.3퍼센트 캐시 절감의 분모를 복원한다
- Fine-grained MoE의 이득에는 통신 설계가 필요하다
- 8.1T 사전학습과 128K 문맥은 다른 단계다
- MLA의 품질 우위는 어디까지 확인됐는가
- SFT와 GRPO는 성능을 올리면서 일부 점수를 내린다
- 학습 비용과 최대 처리량은 같은 속도 지표가 아니다
- 구조적 기여와 남은 검증 범위
1. 큰 저장 용량과 적은 활성 계산을 분리한다
Dense 모델은 대체로 매 token에서 거의 모든 FFN 파라미터를 사용한다. MoE는 token에 따라 일부 expert만 계산한다. 따라서 전체 파라미터가 표현하는 용량과 한 token의 활성 연산량을 다르게 늘릴 수 있다.
DeepSeek-V2의 21B/236B는 약 8.9%다. 이것은 활성 파라미터 비율이지 총 FLOPs·장치 메모리·대기 시간이 모두 8.9%라는 뜻은 아니다. Attention, routing, 통신과 항상 쓰는 부분이 남고, 활성화하지 않은 expert의 가중치도 모델의 저장 용량에 포함된다. 236B 모델을 ‘21B 모델과 같은 메모리로 배포한다’고 읽으면 안 된다.
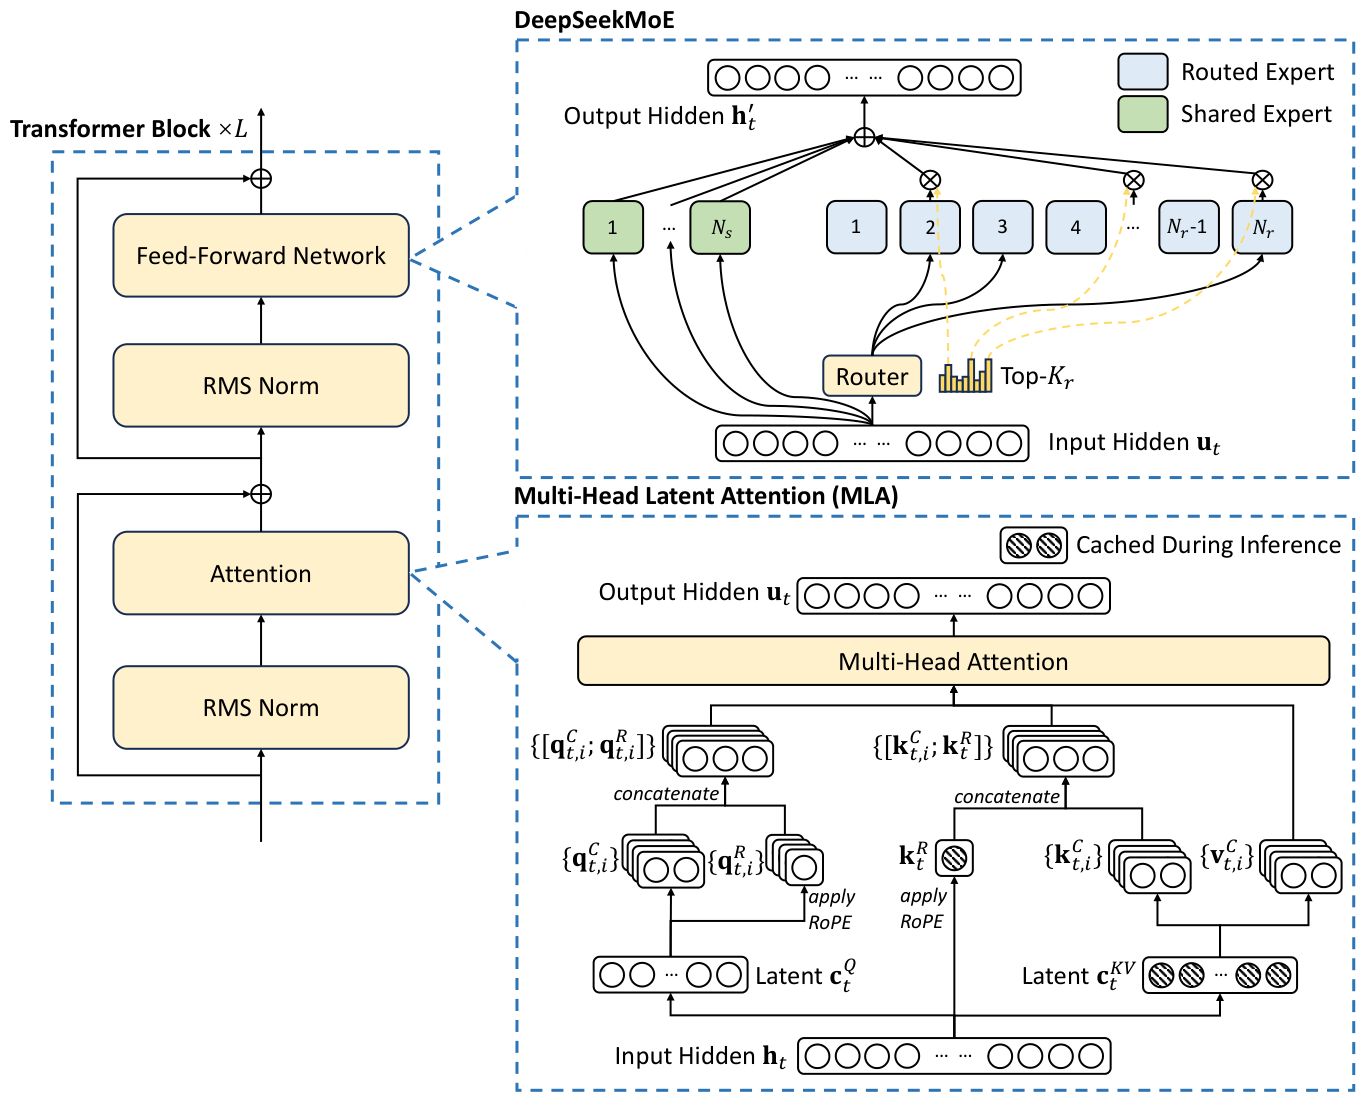
Figure 2. Attention의 캐시와 FFN의 활성 계산을 별도로 설계한다. 출처: DeepSeek-AI (2024), v5, p. 5, Fig. 2. 이 도식은 특정 serving 속도나 메모리 사용량을 측정한 결과가 아니다.
기존 GQA 리뷰는 query head를 유지하면서 K/V head를 그룹별로 공유하는 방법을 설명했다. MLA는 다른 경로를 택한다. 여러 head의 K/V를 만드는 공동 저차원 표현을 저장하고, head별 attention은 유지한다. 또한 GQA 논문의 MHA checkpoint 변환·uptraining과 달리, 이 보고서의 V2는 MLA·MoE 구조를 처음부터 사전학습한다.
2. MLA는 K와 V를 하나의 latent에서 복원한다
Token t의 attention 입력을 hₜ라 하면 논문의 기본 선형식은
c_t^{KV}=W^{DKV}h_t,\qquad
k_t^C=W^{UK}c_t^{KV},\qquad
v_t^C=W^{UV}c_t^{KV}.
512차원 latent 하나에서 각 head의 content key와 value를 만든다. K/V를 각각 독립적으로 압축해 두 벡터를 저장하는 식이 아니다. Query도 1,536차원 latent를 거치지만, query 압축은 training activation memory를 줄이려는 설계이며 과거 token의 KV cache를 추가로 줄이는 항은 아니다.
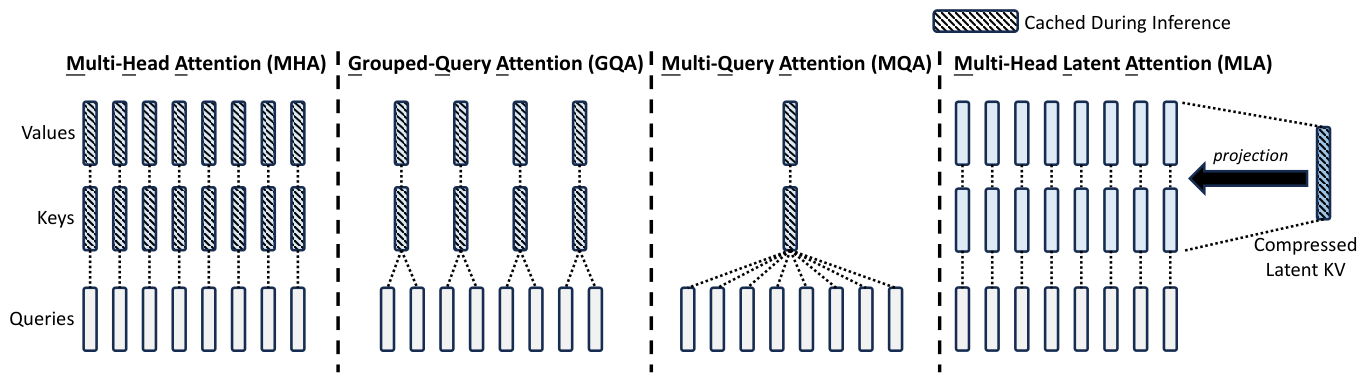
Figure 3. MLA는 head를 하나로 합치는 MQA가 아니다. 위치 성분을 생략한 개념도이므로 실제 cache에는 별도의 RoPE key도 필요하다. 출처: DeepSeek-AI (2024), v5, p. 7, Fig. 3. 도식만으로 cache 절감률이나 품질 우위를 주장하지 않는다.
매번 K/V를 복원하면 절감 효과가 약해진다
Head i의 key up-projection을 Uᵢᴷ라 하면 content score는
(q_{t,i}^{C})^T U_i^K c_j^{KV}
=\big((U_i^K)^Tq_{t,i}^{C}\big)^Tc_j^{KV}.
첫 등식은 (U_i^K)^Tq_{t,i}^{C}를 전치하면 (q_{t,i}^{C})^TU_i^K가 된다는 항등식이다. 따라서 key up-projection을 매 과거 token마다 적용하는 대신 query 쪽에 미리 합성할 수 있다. Value 쪽도 선형변환은 가중합 바깥으로 옮길 수 있다. Attention 확률 aᵢⱼ가 주어졌을 때
\sum_j a_{ij}U_i^V c_j^{KV}
=U_i^V\sum_j a_{ij}c_j^{KV}.
Output projection의 head별 block Oᵢ까지 합치면
u_t=\sum_i O_iU_i^V\left(\sum_j a_{ij}c_j^{KV}\right).이렇게 하면 과거 모든 token의 expanded K/V를 다시 만들어 저장할 필요가 없다. 그러나 head마다 aᵢⱼ는 다르다. Latent를 공유한다는 이유로 모든 head의 attention 확률이나 가중합을 하나로 합칠 수는 없다.
이 항등식은 학습된 MLA 안에서의 계산 재배치다. 임의의 기존 MHA를 저차원으로 줄여도 같은 함수를 보존한다는 정리가 아니다. 실제 모델은 compressed latent 뒤 RMSNorm과 width bottleneck의 scaling도 사용한다(p.12). 이들을 무시해 전체 h→latent 경로까지 하나의 선형행렬이라고 단정하지 않으며, 위 항등식은 같은 latent와 head별 projection을 사용하는 조건의 설명이다. 양자화·부동소수점 오차까지 없다는 뜻도 아니다.
3. RoPE를 분리해야 행렬 흡수를 유지할 수 있다
RoPE는 위치마다 query·key를 회전한다. Expanded content key에 그대로 적용하면 내적 안에 상대 위치에 따른 회전행렬이 들어가 고정된 key up-projection을 query 쪽으로 한 번 흡수하는 것이 일반적으로 어려워진다. 행렬은 임의로 교환할 수 없기 때문이다. 이는 RoPE와 모든 종류의 latent 표현이 원리적으로 양립 불가능하다는 주장은 아니다.
V2는 content와 position 경로를 나눈다.
- Head별 content query/key: 각각 128차원.
- RoPE query: head마다 64차원.
- RoPE key: token마다 64차원 하나를 head들이 공유.
Score는 두 내적을 더한 값이다.
\ell_{ij}=\frac{(q_{t,i}^{C})^Tk_{j,i}^{C}+(q_{t,i}^{R})^Tk_j^R}{\sqrt{128+64}},\qquad
 a_{ij}=\operatorname{softmax}_j(\ell_{ij}).
Content 항은 앞 절처럼 latent 공간으로 옮기고 위치 key는 따로 저장한다. 따라서 실제 저장 대상은 cⱼᴷⱽ와 kⱼᴿ다. Latent만 512개 저장한다는 설명은 64개 위치 성분을 빠뜨린다.
또 content 내적을 512차원 latent로 흡수해 계산하더라도, 원식과 동치로 만들려면 scaling은 **√(128+64)**를 유지해야 한다. 계산 표현의 차원이 바뀌었다고 √(512+64)로 바꾸면 softmax가 달라진다. 이는 기본 식 (18)의 재배치를 위한 설명이며, 장문 확장 시의 별도 entropy scaling과 구분한다.
4. 93.3퍼센트 캐시 절감의 분모를 복원한다
L층, head dimension dₕ, query head H, GQA group G일 때 token당 cache 원소 수는 다음과 같다.
| 구조 | 원소 수 |
|---|---|
| MHA | 2HdₕL |
| GQA | 2GdₕL |
| MQA | 2dₕL |
| MLA | (d꜀+dᴿₕ)L |
V2는 d꜀=512, dᴿₕ=64, L=60이므로 34,560개/token이다. 같은 dₕ=128·L을 쓰는 GQA와 양을 맞추면 G=2.25가 나온다. 이것은 cache 용량의 환산이지 실제로 2.25개 그룹을 배치한다는 뜻이 아니다.
세 비교를 혼동하지 않는다
- 같은 60층·128 query head·128차원 MHA를 가정하면 MLA의 원소 수 비율은 576/(2×128×128)≈1.76%다. 이 가상 비교가 headline 93.3%의 분모는 아니다.
- 실제 비교 대상 DeepSeek 67B는 GQA다. Pinned config는 95층·hidden 8,192·query 64개·KV 8개를 명시한다. Head dimension은 128이다.
- V2의 배포 설명은 가중치 FP8 변환과 KV 원소당 평균 6bit 양자화를 포함한다. 그러므로 배포 cache 수치는 MLA 구조만의 동일 정밀도 절감률이 아니다.
baseline KV를 16bit, V2를 평균 6bit로 두고 metadata·padding 등을 제외하는 조건부 계산에서는
B_{67B}=95\times2\times8\times128\times2=389{,}120\ \mathrm{bytes/token},B_{V2}=60\times(512+64)\times\frac68=25{,}920\ \mathrm{bytes/token}.즉 380 KiB(약 389 KB) 대 25.3125 KiB(약 26 KB)이고 절감률은 **93.34%**로 headline과 양립한다. 여기서 KB는 십진 단위이며 Figure 1(b)의 KB/token 축과 맞춘 표현이다. 반면 양쪽 모두 16bit라면 V2는 69,120bytes이고 절감률은 **82.24%**다.
이 계산은 조건부 재구성이다. Config의 torch_dtype=bfloat16은 기본 가중치 dtype이며 배포 KV의 실제 dtype 로그 자체가 아니다. 실제 배포 KV의 dtype 로그, allocator metadata, 양자화 부가정보와 실측 byte를 포함하지 않는 조건부 재구성이다. 중요한 결론은 비교 모델·층 수·head 수·정밀도까지 명시해야 93.3%의 의미를 읽을 수 있다는 것이다.
5. Fine-grained MoE의 이득에는 통신 설계가 필요하다
첫 층의 FFN을 제외한 MoE 층에는 shared expert 2개와 routed expert 160개가 있다. 각 expert의 intermediate dimension은 1,536이며 token마다 routed expert 6개를 선택한다. Shared expert는 공통 지식을 맡겨 routed expert 사이의 중복을 줄이려는 설계다. 실제로 지식이 그렇게 완벽히 분할됐음을 보장하는 의미적 label은 아니다.
원식 (20)–(22)는 residual·shared expert 출력·선택된 routed expert의 가중 출력을 더한다. Gate는 모든 routed expert에 대한 affinity softmax 뒤 선택되지 않은 항을 0으로 만든다. 본문 수식만 보고 top-6 내부에서 반드시 다시 합이 1이 되도록 정규화한다고 덧붙이지 않는다. 실제 scaling 세부와 논문의 간결한 기본식을 구분한다.
Expert를 잘게 나눌수록 통신 목적지도 늘 수 있다
Routed expert는 층마다 8개 장치에 분산한다. V2는 token의 목적지를 최대 3개 장치로 제한하고 그 안에서 expert를 고른다. 모든 160개에서 제약 없는 top-6을 고르는 것과 같지 않다. M≥3에서 성능이 unrestricted routing과 대체로 맞았다는 것은 저자의 경험적 관찰이다.
부하 제어는 세 수준이다.
- Expert balance: 일부 expert에만 token이 몰리는 routing collapse 완화.
- Device balance: 장치별 계산량 편중 완화.
- Communication balance: 받는 token의 통신 부하 편중 완화.
계수는 각각 0.003·0.05·0.02다. 이 보조 손실은 균형을 유도할 뿐 매 step의 엄밀한 동일 부하를 보장하지 않는다. 논문도 다음 절에서 이를 인정하고 device-level capacity factor 1.0을 목표로 낮은 affinity token의 expert 처리를 drop하는 전략을 추가한다.
Training sequence의 약 10%는 drop하지 않도록 보호하고, 평가에서는 token을 drop하지 않는다고 명시한다. 여기서 dropping은 원문 문장을 삭제하는 데이터 정제가 아니라 MoE의 계산 처리와 관련된 규칙이다. 이를 모든 환경에서 expert 계산을 하나도 누락하지 않는 구조로 설명하거나, 반대로 평가 때도 같은 drop을 썼다고 가정하지 않는다.
6. 8.1T 사전학습과 128K 문맥은 다른 단계다
사전학습 corpus는 8.1T token이며 최대 sequence length는 4K다. 중국어 token이 영어보다 약 12% 많다는 것은 ‘corpus의 12%가 중국어’라는 뜻이 아니다. 데이터 양·품질·중국어 비중도 DeepSeek 67B와 달라졌으므로 모델 간 품질 차이를 architecture 하나에 전부 귀속할 수 없다.
AdamW를 쓰고 최대 learning rate는 2.4×10⁻⁴, 첫 2K step warmup 뒤 token 진행률 약 60%와 90%에서 각각 0.316배 줄인다. Sequence batch는 초기 225B token 동안 2,304→9,216으로 늘린다. H800 cluster에서 16-way pipeline·8-way expert parallelism·ZeRO-1을 사용하고, 이 구성은 tensor parallelism 없이 학습할 수 있었다고 보고한다. 모든 MoE가 tensor parallelism을 필요로 하지 않는다는 일반 결론은 아니다.
장문 확장은 별도 학습이다
YaRN의 scale 40·target 160K를 설정하고, 32K sequence·batch 576으로 1,000 step 추가 학습한다. 평가·지원 문맥은 128K다. Target 160K 설정이나 32K training을 각각 160K 성능 검증·128K 길이 학습으로 바꾸지 않는다.
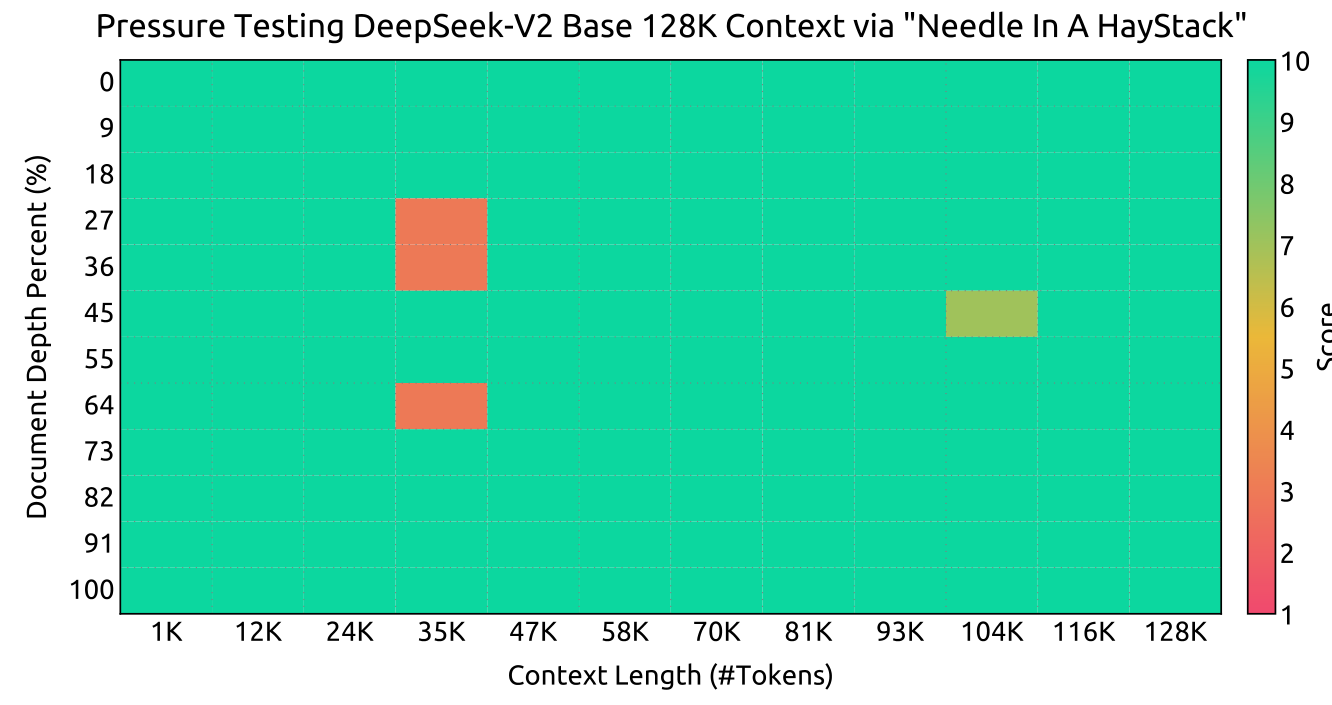
Figure 4. 대부분 위치에서 높은 점수를 보이지만 모든 칸이 완벽하지는 않다. 출처: DeepSeek-AI (2024), v5, p. 13, Fig. 4. NIAH 결과는 일반적인 장문 추론 능력을 입증하지 않는다.
NIAH는 긴 문맥에 넣은 정보를 회수하는 시험이다. 장문 추론·여러 문서의 모순 해결·긴 codebase 수정의 성공률이나 전 위치의 완벽한 기억을 증명하지 않는다. 또한 MLA도 과거 token의 정보를 저장하므로 cache는 문맥 길이에 따라 선형 증가한다. ‘상수 메모리 문맥’이 되는 것은 아니다.
7. MLA의 품질 우위는 어디까지 확인됐는가
완성 모델은 경쟁력이 있지만 전 항목 1위가 아니다
Table 2는 내부 evaluation framework에서 비교하며, 아래는 일부 지표를 발췌한 것이다.
| Base benchmark | DeepSeek 67B | Mixtral 8×22B | LLaMA3 70B | V2 |
|---|---|---|---|---|
| MMLU, 5-shot | 71.3 | 77.6 | 78.9 | 78.5 |
| HellaSwag, 10-shot | 86.3 | 86.6 | 87.9 | 84.2 |
| HumanEval Pass@1, 0-shot | 45.1 | 53.1 | 48.2 | 48.8 |
| GSM8K, 8-shot | 63.4 | 80.3 | 83.0 | 79.2 |
| MATH, 4-shot | 18.7 | 42.5 | 42.2 | 43.6 |
| C-Eval, 5-shot | 66.1 | 59.6 | 67.5 | 81.7 |
V2는 작은 활성 파라미터로 높은 성능을 얻지만 HellaSwag는 이전 67B보다도 낮다. 중국어 C-Eval도 별도 비교 모델 Qwen1.5 72B의 83.7보다 낮다. 같은 표의 0.3 미만 차이를 동급으로 처리하는 규칙은 표시·해석 규칙이지 반복 실험의 통계적 동등성 검정이 아니다.
Attention ablation은 전체 보고서와 구성이 다르다
Appendix D.1은 1.33T token을 학습한 약 7B dense 모델의 MHA/GQA/MQA를 비교한다. 전체 파라미터를 맞추기 위해 층 수를 조정했으므로 attention만 바꾸고 깊이까지 완전히 고정한 실험은 아니다. 이를 기존 GQA 논문의 T5 checkpoint uptraining 실험과 같은 조건으로 취급하지 않는다.
Appendix D.2의 MoE 비교도 따로 읽는다.
| 구분 | MHA | MLA |
|---|---|---|
| Small 총/활성 파라미터 | 15.8B / 2.5B | 15.7B / 2.4B |
| Small cache 원소/token | 110.6K | 15.6K |
| Small MMLU / C-Eval | 48.7 / 51.6 | 50.0 / 50.9 |
| Large 총/활성 파라미터 | 250.8B / 25.0B | 247.4B / 21.5B |
| Large cache 원소/token | 860.2K | 34.6K |
| Large MMLU / C-Eval | 57.5 / 57.9 | 59.0 / 59.2 |
Table 9, p.32. Small은 1.33T, large는 420B token 학습이다.
Cache가 각각 약 14%·4%로 줄면서 대부분 점수가 좋아진다. 다만 small C-Eval은 0.7점 하락한다. Large 실험의 247.4B/21.5B는 최종 236B/21B 모델과 같은 숫자가 아니며 8.1T full training도 아니다. 따라서 ‘MLA는 어떤 설정에서도 MHA보다 강하다’나 ‘같은 모든 자원 조건에서 우월함을 증명했다’고 확대하지 않는다.
8. SFT와 GRPO는 성능을 올리면서 일부 점수를 내린다
SFT는 helpfulness 1.2M+safety 0.3M의 1.5M instances, 2 epochs, learning rate 5×10⁻⁶다. 이어 DeepSeekMath의 GRPO를 사용해 reasoning alignment를 먼저 하고 human preference alignment를 수행한다.
GRPO는 같은 질문의 G개 응답 보상으로 상대 advantage를 만든다.
A_i=\frac{r_i-\operatorname{mean}(r_1,\ldots,r_G)}{\operatorname{std}(r_1,\ldots,r_G)}.Old policy 대비 비율 clipping과 reference policy에 대한 KL 항을 사용한다. 별도 critic/value model이 없다는 것과 reward model이 없다는 것은 다르다. 첫 단계는 code·math reward model, 다음 단계는 helpfulness·safety·rule reward의 가중합이다. Code의 compiler feedback과 math의 정답 label은 preference data를 만드는 근거이며, 모든 RL 보상을 직접 실행 test만으로 계산하는 설계라고 바꾸지 않는다.
수식의 동일 보상 group에서는 std=0이 될 수 있다. 이 식만으로 실제 구현의 수치 안정화·skip 규칙을 확정하지 않는다. 또한 비교 보고만으로 clipping·reward mixing·모든 RL hyperparameter와 원자료까지 완전히 재현됐다고 주장하지 않는다.
| 지표 | V2 Chat SFT | V2 Chat RL |
|---|---|---|
| HumanEval | 76.8 | 81.1 |
| LiveCodeBench | 28.7 | 32.5 |
| GSM8K | 90.8 | 92.2 |
| MATH | 52.7 | 53.9 |
| MMLU | 78.4 | 77.8 |
| BBH | 81.3 | 79.7 |
| IFEval | 64.1 | 63.8 |
| C-Eval | 80.9 | 78.0 |
| MT-Bench | 8.62 | 8.97 |
| AlpacaEval 2.0 LC win rate | 30.0 | 38.9 |
| AlignBench overall | 7.74 | 7.91 |
Tables 3–5. 서로 다른 척도이므로 이 열을 하나의 평균 정확도로 합치지 않는다.
코드·수학과 open-ended 평가가 좋아지는 한편 일반 benchmark 일부는 낮아진다. 저자가 말하는 alignment tax다. AlpacaEval 38.9는 length-controlled win rate이지 전체 질문 정답률이 아니다. AlignBench의 judge는 GPT-4-0613이며, V2 RL의 언어 subtotal 8.36은 GPT-4-1106-Preview의 8.29보다 높지만 overall 7.91은 8.01보다 낮다. 이 결과로 ‘GPT-4 전체 능력을 넘었다’고 결론내릴 수 없다.
LiveCodeBench는 2023-09-01~2024-04-01 문제 범위다. IFEval은 prompt-level loose accuracy다. TriviaQA·NaturalQuestions에서 일부 chat 모델이 few-shot 출력 형식을 지키지 않아 과소평가될 수 있다는 원문의 경고도 중요하다. 모든 차이를 순수한 지식·추론 능력 차이로 읽지 않는다.
9. 학습 비용과 최대 처리량은 같은 속도 지표가 아니다
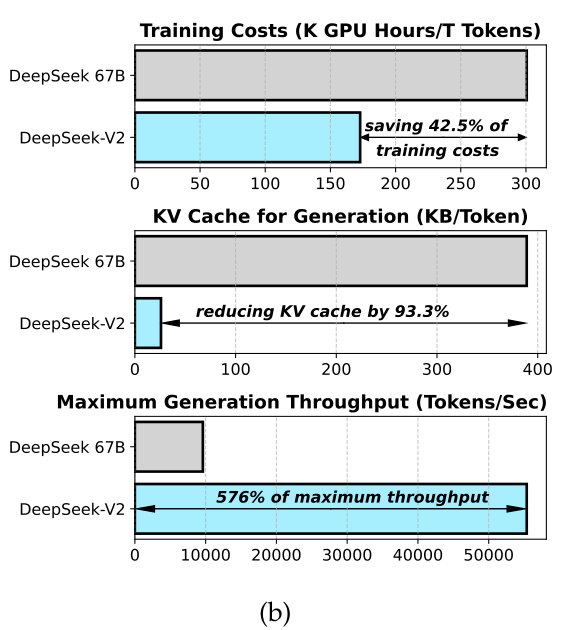
Figure 1(b). 세 지표의 분모가 서로 다르다. 출처: DeepSeek-AI (2024), v5, p. 1, Fig. 1(b). 이 그림은 5.76배 batch-1 지연 개선을 뜻하지 않는다.
42.5퍼센트는 같은 token 수의 학습 비용이다
H800에서 1T token당 DeepSeek 67B는 300.6K GPU-hours, V2는 172.8K GPU-hours를 쓴다고 보고한다.
1-\frac{172.8}{300.6}\approx42.51\%.전체 사전학습 corpus가 서로 다른 두 모델의 최종 프로젝트 비용을 42.5% 줄였다는 뜻이 아니다. V2의 8.1T에 단순 비례 적용하면 약 1.40M GPU-hours지만, 이는 보고된 단위 비용의 환산이며 SFT/RL·데이터·개발·실패 실험까지 포함한 예산이 아니다. GPU-hours는 합산 장치 시간으로 wall-clock이나 달러와도 다르다.
MoE의 적은 활성 연산만으로 이 수치가 자동으로 나오는 것도 아니다. Shared expert 계산과 all-to-all 통신 overlap, zero-bubble pipeline, 재계산, routing·통신·fused linear CUDA kernel 및 MLA용 attention 최적화가 포함된 시스템 결과다.
5.76배는 최대 총 생성 처리량이다
배포 파라미터는 FP8로 변환하고 KV는 평균 6bit로 양자화한다. 실제 DeepSeek 67B 서비스의 prompt·생성 길이 분포를 바탕으로, 8 H800 한 node에서 V2는 generation 50K token/s 초과, prompt input 100K token/s 초과를 보고한다. 전자는 67B 최대 generation throughput의 5.76배, 즉 배수 기준 576%이며 ‘576% 증가’와는 다르다.
MLA가 큰 batch를 가능하게 했다는 설명과 결합된 최대 처리량이다. 동일 batch·동일 정밀도에서 MLA만 바꾼 효과나 batch-1 token latency, time-to-first-token, 각 사용자 응답속도의 5.76배 가속은 아니다. Prompt 처리량과 generation 처리량을 더해 하나의 token/s로 쓰지도 않는다.
10. 구조적 기여와 남은 검증 범위
저자가 밝힌 한계
사전학습 이후 지식이 계속 갱신되지 않고, 사실과 다른 정보·환각을 생성할 수 있다. 데이터가 중국어·영어 중심이므로 다른 언어에서 주의가 필요하며 당시 V2는 text-only다. Human preference alignment의 tax와 online/offline alignment의 체계적인 추가 비교도 남아 있다. 이후 모델의 기능을 이 한계의 해결 증거로 소급하지 않는다.
References
DeepSeek-AI. (2024). DeepSeek-V2: A strong, economical, and efficient mixture-of-experts language model [Preprint]. arXiv. https://arxiv.org/abs/2405.04434v5
DeepSeek-AI. (n.d.). deepseek-llm-67b-base: config.json [Model configuration, revision c3f813a1121c95488a20132d3a4da89f4a46452f]. Hugging Face. https://huggingface.co/deepseek-ai/deepseek-llm-67b-base/resolve/c3f813a1121c95488a20132d3a4da89f4a46452f/config.json