VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks
결과물이 모두 다르면 무엇을 확인할까? VeriHarness 쉽게 읽기
VeriHarness는 완성된 rollout의 산출물을 같은 모델 계열로 검증합니다. resolver는 후보 간 불일치를 조사하고 challenger는 합의된 오류와 누락을 살핍니다. 다섯 benchmark의 native-score 평균, 선택과 수정, 스킬 진화에 쓰이는 개발 피드백을 구분합니다.
Paper: Caiqi Zhang; Rujun Han; Zifeng Wang; Zoey CuiZhu; Nigel Collier; Tomas Pfister; Chen-Yu Lee (2026). "VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks". arXiv:2610.00972v1 PDF · 서지 정보.
에이전트가 보고서나 스프레드시트를 만들면, 같은 일을 맡긴 여러 번의 실행이 서로 다른 결과를 낼 수 있습니다. 하나를 고르면 더 나은 후보를 찾을 수 있지만, 모든 결과가 같은 단위나 항목을 잘못 다뤘다면 서로 비교하는 일만으로는 오류가 보이지 않을 수 있습니다.
VeriHarness는 두 문제를 나누어 다룹니다. 후보 사이에 차이가 있으면 그 차이를 조사하고, 후보 모두가 같은 답을 냈으면 공유 오류나 빠진 내용을 찾아봅니다.
1. 행동을 고르는 시점과 결과물을 살피는 시점
Mid-Harness는 터미널 에이전트가 다음 명령을 실행하기 전에 여러 행동 후보 중 하나를 고릅니다. Self-Organizing Agent Teams는 여러 해법이 있을 때 좋은 해법이 있는지와 그중 좋은 것을 알아볼 수 있는지를 구분합니다. VeriHarness는 행동을 실행하는 순간이 아니라, 이미 완성된 여러 결과물 가운데 무엇을 선택하고 어떻게 다룰지를 연구합니다.
예를 들어 과제에서 표의 금액이 100m 또는 120m으로 다르게 나타나면 어느 값이 맞는지 출처를 살필 수 있습니다. 하지만 모든 결과물에 통화가 잘못 적혔다면 값 사이의 비교만으로는 그 공통 오류를 발견하기 어렵습니다. 논문은 후보 간 불일치 조사와 합의 오류 조사를 별도 역할로 나눕니다.
2. Rollout, 산출물, 실행 환경
**Rollout(실행 궤적)**은 에이전트가 도구를 사용하고 환경의 응답을 받은 한 번의 전체 작업 기록입니다. 그 기록에는 어떤 행동을 했는지와 마지막에 무엇을 만들었는지가 들어갑니다. **Artifact(산출물)**는 과제 결과로 전달되는 보고서, 스프레드시트, 코드 파일 같은 결과물입니다. **Harness(실행 환경)**는 에이전트의 도구 행동을 실제로 실행하고 그 결과를 다음 판단에 돌려주는 부분입니다.
VeriHarness는 각 후보의 완성된 산출물뿐 아니라 작업 기록과 원본 파일도 살펴볼 수 있습니다. 에이전트가 쓴 숫자만 보는 대신, 그 숫자가 어떤 파일·표·계산에서 나왔는지 연결하는 구조입니다.
3. 두 검증자가 서로 다른 질문을 맡습니다
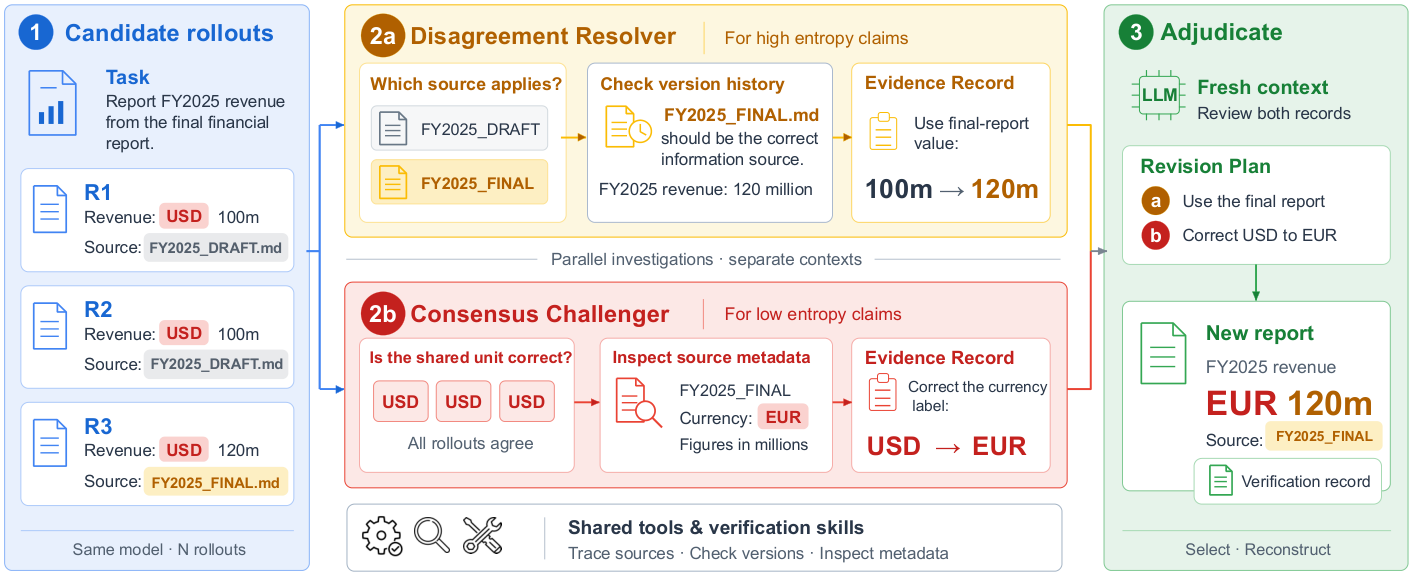
그림 3. Zhang et al. (2026), Figure 3, arXiv v1 PDF 4쪽. 예시에서 resolver는 파일 버전을 비교하고, challenger는 모든 후보가 공유한 통화 단위를 살핍니다.
**Resolver(불일치 해결기)**는 후보 사이에서 주장이 달라졌을 때 값의 출처나 계산을 살핍니다. **Challenger(합의 반박기)**는 모두가 같은 값을 냈더라도 단위, 부호, 연도, 출처 버전이 잘못됐는지 또는 요구된 항목이 빠졌는지 묻습니다. Resolver는 서로 다른 후보 중 무엇이 근거에 맞는지 조사하고, challenger는 후보가 놓친 문제를 새로 찾아보는 역할입니다.
두 역할은 서로의 기록을 읽지 않는 별도 문맥에서 조사하고, 뒤이어 새 문맥에서 결과를 판정합니다. 문맥을 나눈다고 판단이 완전히 독립되거나 모든 오류가 발견되는 것은 아닙니다.
여기서 **Skill(스킬)**은 조사할 때 자주 쓰는 절차를 정리한 짧은 안내문이며, 선택적으로 작은 script를 포함합니다. 도구가 파일을 읽게 하는 것과 어떤 오류를 의심하고 어떤 자료를 읽을지 안내하는 것은 서로 다른 기능입니다.
4. 고르기와 고친 뒤 전달하기
논문은 먼저 기존 후보 하나를 그대로 고르는 selection과, 근거에 따라 결과물을 고치거나 새로 만드는 revision을 구분합니다. Selection-only 조건에서는 이미 있는 산출물만 선택합니다. Revision을 포함한 전체 절차에서는 조사 결과에 따라 문서를 바꾸거나 필요하면 새 결과물을 만들 수 있습니다.
Selection oracle은 평가용 채점기가 고정 후보 중 가장 높은 점수를 받은 결과를 고른 경우입니다. 따라서 이 값은 그 후보 묶음 안에서 고를 수 있는 상한입니다. 후보에 없던 수정 결과가 얼마나 좋아질 수 있는지의 상한은 아닙니다.
검증 실행에서는 grader(채점기), 정답, rubric(채점 기준)을 제공하지 않습니다. 그러나 외부 평가에는 각 benchmark의 채점 절차가 따로 있습니다. 예를 들어 스프레드시트 평가는 workbook을 다시 계산한 뒤 기준값과 셀별로 비교하며, 일부 과제는 model judge를 사용합니다. “검증기가 정답을 보지 않는다”는 말과 “논문 평가에 채점 기준이 없다”는 말은 다릅니다.
5. 점수 평균은 무엇을 뜻할까요?
주요 평가는 APEX-Agents, Workspace-Bench Lite, WorkBuddy, SpreadsheetBench 2, JobBench 다섯 benchmark를 사용합니다. 각 모델은 과제마다 자신이 생성한 열 개 후보를 사용하고, 그 모델의 검증 방법들이 같은 고정 후보 묶음을 공유합니다. 표의 single rollout 점수도 첫 번째 실행 한 번의 결과가 아니라, 열 개 후보의 점수를 평균한 기준선입니다.
| 모델 | Single 기준 | 선택만 | 수정 포함 | 보고된 개선 |
|---|---|---|---|---|
| Gemini 3.5 Flash | 47.2 | 51.6 | 53.4 | +4.4 / +6.2점 |
| Claude Opus 4.8 | 49.6 | 53.7 | 56.1 | +4.1 / +6.4점 |
다섯 benchmark는 task success rate, rubric score, accuracy 등 서로 다른 원래 지표를 사용합니다. 논문은 각 지표를 따로 모은 뒤 다섯 점수를 같은 비중으로 평균합니다. 과제 수가 많은 benchmark에 더 무게를 둔 전체 pooled accuracy가 아닙니다.
Opus 표에 표시된 평균만 빼면 56.1−49.6=6.5점처럼 보입니다. 그러나 표의 다섯 benchmark 값을 각각 평균해 차이를 구하면 6.44점이며, 소수 첫째 자리로 반올림하면 +6.4점입니다. Flash의 해당 평균 차이는 6.16점이어서 +6.2점으로 표시됩니다.
Gemini 3.5 Flash와 Claude Opus 4.8은 각각 자신의 생성기와 같은 모델 가중치로 검증에 쓰입니다. 다만 verifier는 열 개 결과를 비교하고 추가 자료를 조사하며 도구를 호출하므로 계산량은 단일 후보 생성과 다릅니다.
6. 스킬도 달라지지만, 개발 단계에는 채점 피드백이 있습니다
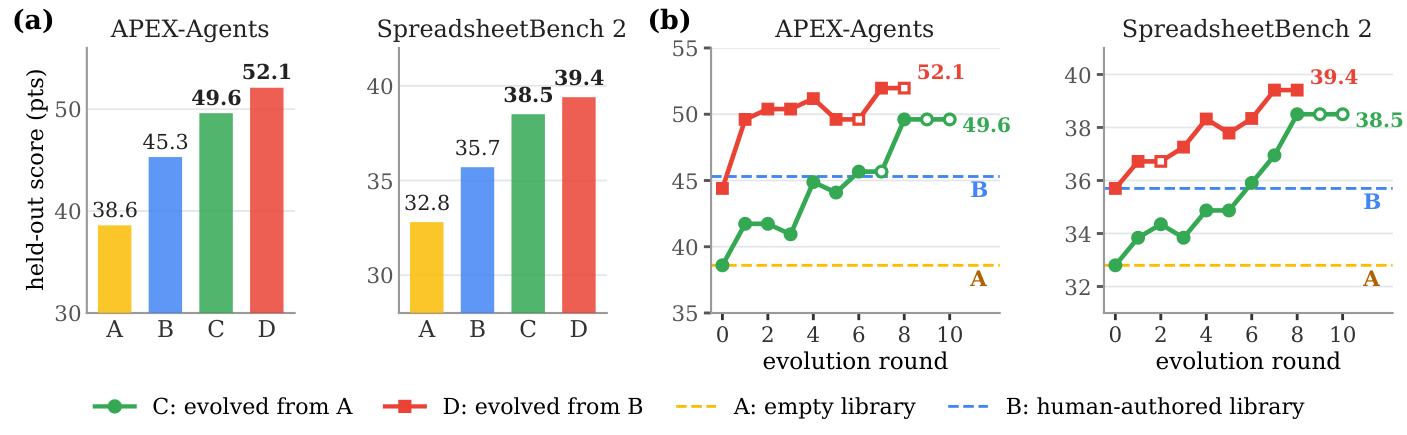
그림 4. Zhang et al. (2026), Figure 4, arXiv v1 PDF 9쪽. Opus의 APEX와 SpreadsheetBench 2에서 스킬 개발에 쓰지 않은 별도 평가 과제(held-out)의 점수이며, 빈 library 또는 human-authored library에서 출발한 조건입니다.
논문은 기존 스킬을 모은 library를 과제 경험에 따라 발전시키는 실험도 합니다. Figure 4에서 A는 빈 library, B는 사람이 작성한 library이고 C와 D는 각각 A와 B에서 시작해 진화한 library입니다. 비교 대상은 APEX의 일부 과제와 SpreadsheetBench 2의 template·financial-model 과제이며, Table 2의 전체 benchmark 점수와 분모가 다릅니다.
진화 실험에서 C는 A보다 APEX에서 11.0점, SpreadsheetBench 2에서 5.7점 높고, D는 B보다 각각 6.8점과 3.7점 높습니다. 이는 조사뿐 아니라 판정과 수정까지 포함하는 전체 절차의 결과입니다. 점수는 held-out 과제에서 보고됐지만, 저자는 통계적 유의성을 확립한 결과가 아니라 점추정(point estimate)이라고 설명합니다.
중요한 경계는 개발과 평가의 차이입니다. 개발 중에도 검증 실행에는 정답과 채점 기준을 주지 않지만, 개발 중 실패 사례를 모은 자료에는 grader의 항목별 판정이 포함됩니다. 스킬을 제안하는 모델은 이 피드백을 읽고 후보를 만들며, 개발 성능에 따라 후보를 고릅니다. 따라서 training-free는 가중치를 학습하지 않는다는 뜻이지, 개발 단계에서 정답 피드백을 전혀 쓰지 않는다는 뜻은 아닙니다.
7. 비용과 공개 자료는 같은 조건인지 살펴봅니다
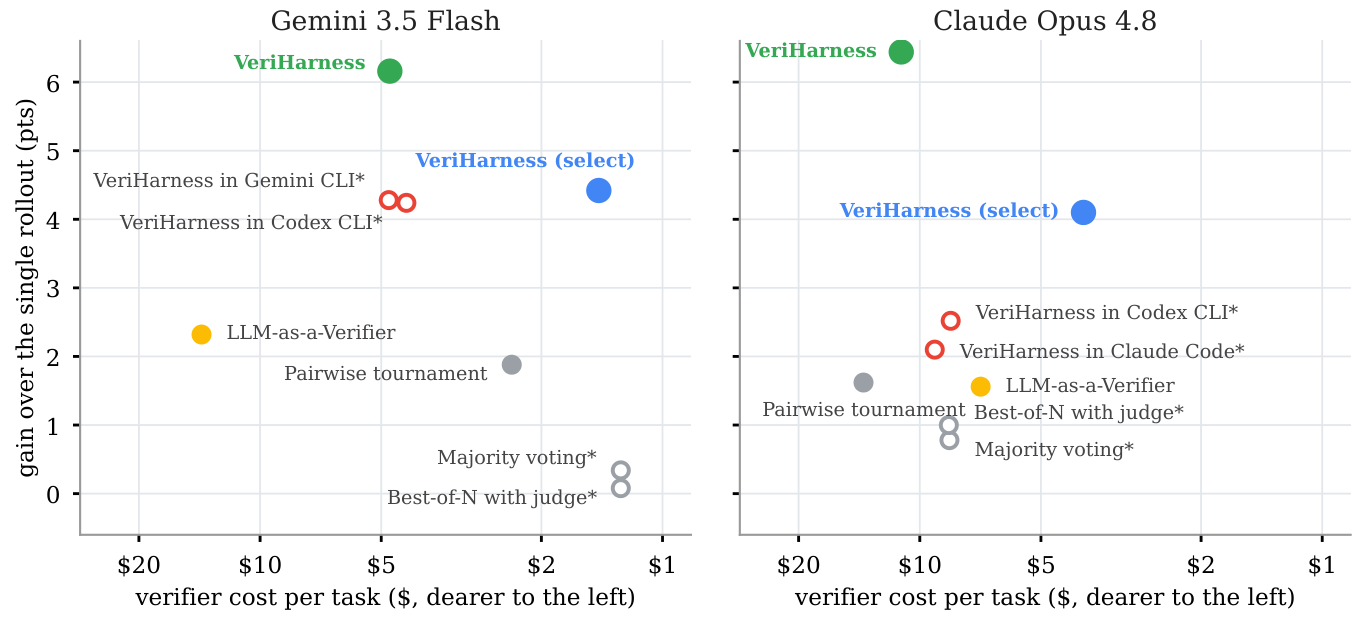
그림 8. Zhang et al. (2026), Figure 8, arXiv v1 PDF 28쪽. 가로축은 로그 스케일이며 오른쪽일수록 비용이 낮고, 세로축은 다섯 원래 지표의 평균 개선입니다. 빈 마커와 별표는 추정 비용입니다.
논문 Appendix K에서 선택만 할 때의 verifier 비용은 과제당 Flash 1.44, Opus3.92입니다. 입력 token의 86–91%를 cache에서 읽는 가격을 반영합니다. 이미 열 개 후보가 있을 때 추가되는 검증 비용이므로, 후보 열 개를 처음 생성하는 비용은 포함하지 않습니다. 수정까지 포함한 pipeline은 선택만 할 때보다 약 세 배 비용이 들지만 평균 개선도 더 큽니다.
공개 자료에는 논문 수치와 다른 분모가 있습니다. Table 1의 과제 수에 모델 두 개와 과제당 rollout 열 개를 곱하면 23,320개가 됩니다. 논문 초록과 고정 revision의 repository README는 약 26,000개라고 설명하고, dataset card revision 214c7081ebd2e3896e311e5f495cd4e81419950a의 표에서 rollout 수를 합하면 23,197개입니다. 논문 실험 pool과 공개 archive는 같은 수로 제시되지 않습니다.
Repository README는 일부 도구와 스킬이 논문 이후 benchmark 실패 분석을 거쳐 추가됐으며, 이 후속 library가 held-out 검증을 받은 것은 아니라고 설명합니다. 따라서 공개 저장소의 현재 skill과 논문 Figure 4의 실험 library를 같은 것으로 보지 않습니다. 공개 README와 dataset card는 각 revision에 고정된 자료 설명입니다.
References
Zhang, C., Han, R., Wang, Z., CuiZhu, Z., Collier, N., Pfister, T., & Lee, C.-Y. (2026). VeriHarness: Scaling agentic verification for long-horizon tasks [Preprint]. arXiv. https://arxiv.org/abs/2610.00972v1