VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks
후보가 모두 같은 값을 냈을 때, 검증은 어디를 볼까: VeriHarness
VeriHarness는 완성된 rollout의 산출물을 같은 모델 계열로 검증합니다. resolver는 후보 간 불일치를 조사하고 challenger는 합의된 오류와 누락을 살핍니다. 다섯 benchmark의 native-score 평균, 선택과 수정, 스킬 진화에 쓰이는 개발 피드백을 구분합니다.
Paper: Caiqi Zhang; Rujun Han; Zifeng Wang; Zoey CuiZhu; Nigel Collier; Tomas Pfister; Chen-Yu Lee (2026). "VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks". arXiv:2610.00972v1 PDF · arXiv 서지 정보.
에이전트에게 같은 과제를 여러 번 맡기면 완성된 보고서·스프레드시트·코드가 서로 다른 결과를 낼 수 있다. 그중 하나를 고르면 눈에 띄는 불일치는 해결할 수 있지만, 모든 결과가 같은 단위나 출처를 잘못 썼다면 합의만으로는 오류가 드러나지 않는다.
VeriHarness는 이 두 상황에 서로 다른 역할을 둔다. 후보 사이에서 달라진 주장을 조사하는 resolver와, 후보들이 함께 놓친 오류·누락을 찾는 challenger다. 논문은 Gemini 3.5 Flash와 Claude Opus 4.8을 각각 자신의 생성기와 같은 가중치로 검증기에 사용한다. 검증기는 여러 결과와 근거, 추가 도구 호출을 다루므로 입력 정보와 계산량은 단일 생성 rollout과 같지 않다.
핵심 요약
| 항목 | 핵심 |
|---|---|
| 대상 | 이미 완성된 rollout의 최종 산출물과 작업 기록을 검증한다. |
| 역할 | Resolver는 후보 간 불일치를 조사하고, challenger는 합의된 주장과 누락을 공격적으로 살핀다. |
| 평가 입력 | 방법 비교는 과제마다 공유하는 고정된 10개 rollout pool을 사용한다. ‘single rollout’ 점수는 첫 번째 후보가 아니라 그 pool 점수의 평균이다. |
| 결과 | 선택만으로 Flash +4.4점·Opus +4.1점, 수정 포함 시 +6.2점·+6.4점이다. 다섯 benchmark의 native score를 같은 비중으로 평균한 값이다. |
| 경계 | 선택은 기존 산출물을 그대로 반환하고, revision은 수정하거나 새 산출물을 만들 수 있다. Selection oracle은 고정 pool 안에서의 선택 상한이다. |
| 피드백 | 검증 실행 시 grader·정답·rubric은 주지 않지만, 스킬 진화 개발 단계에는 grader별 판정이 쓰인다. |
| 비용 | Selection verifier 비용은 과제당 Flash 1.44, Opus3.92다. Cache-read 가격이 적용되며 10개 rollout 생성 비용은 포함하지 않는다. |
목차
- 다음 행동의 선택과 완성된 결과물의 검증
- 후보 간 불일치와 정답은 다른 정보다
- Resolver와 challenger가 다른 질문을 맡는다
- 기존 산출물 선택과 산출물 수정
- 6.2점과 6.4점의 평균 기준
- 합의 오류와 역할별 절제 실험
- 스킬 진화와 개발 단계의 grader 피드백
- 검증 비용과 cache 회계
- 논문 pool과 공개 배포 자료의 차이
- 저자가 밝힌 연구 한계
1. 다음 행동의 선택과 완성된 결과물의 검증
Mid-Harness는 같은 작업 이력에서 가능한 여러 다음 행동을 만들고 하나를 실행 전에 선택한다. VeriHarness는 다음 행동 대신 여러 번의 완성된 rollout을 비교한다. Rollout은 에이전트가 도구를 쓰고 환경의 응답을 받은 한 번의 전체 실행 기록이다. 각 기록에는 행동 trace와 최종 artifact가 포함된다. Artifact는 보고서, 스프레드시트, 코드 파일처럼 과제의 결과로 전달되는 산출물이다. Harness는 에이전트의 도구 행동을 실행하고 관측 결과를 다음 단계에 전달하는 실행 환경이다.
Self-Organizing Agent Teams는 여러 해법 중 좋은 해법이 존재하는지와 그것을 선택할 수 있는지를 구분한다. VeriHarness는 완성된 결과물의 선택에 더해, 후보들이 공유하는 오류도 발견할 수 있는지를 다룬다. 예를 들어 100m과 120m 중 하나가 맞더라도 모든 산출물에서 통화 단위가 같게 잘못 쓰였다면, 값 선택만으로는 오류가 고쳐지지 않는다.
모델 가중치는 고정할 수 있어도 검증 단계에는 여러 산출물, 특정 주장, 환경 근거와 추가 도구 호출이 들어간다. 검증기의 정보와 계산량은 단일 생성 rollout과 같지 않다. 논문은 Gemini 3.5 Flash와 Claude Opus 4.8을 각각 자기 생성기의 검증기로 사용한다.
2. 후보 간 불일치와 정답은 다른 정보다
주장 p에 대해 N개 후보가 제시한 값의 빈도를 πₚ(v)라 하면 불일치 정도를 엔트로피로 나타낼 수 있다.
\pi_p(v)=\frac1N\sum_{i=1}^{N}\mathbf1[v_{i,p}=v],\qquad
H(\pi_p)=-\sum_v\pi_p(v)\log\pi_p(v).
같은 의미의 표현은 같은 값으로 묶고, 주장을 빠뜨린 경우는 absent라는 별도 값으로 둔다. H가 0이면 후보가 모두 같은 값을 냈다는 뜻이지, 그 값이 맞다는 뜻은 아니다. 모든 후보가 같은 오답을 쓰거나 같은 항목을 빠뜨려도 합의가 된다.
오프라인 분석과 실행 시점의 정보
논문 Figure 2와 Appendix A는 APEX-Agents의 Opus 10-rollout pool에서 434과제·1,692개 claim을 분석한다. 이 오프라인 분석에는 rubric이 사용됐다. Criterion 하나를 claim 하나로 삼고, Opus가 temperature 0에서 값을 추출·그룹화했다. 온라인 verifier의 입력 계약과는 별도 분석이다.
| 그룹 | 분모 | 논문이 보고한 관찰 |
|---|---|---|
| 합의 claim | 917 | 합의 값의 66%는 맞고 34%는 틀렸다고 판정됐다. |
| 불일치 claim | 775 | 적어도 한 rollout이 criterion을 통과한 경우는 74%다. |
| 불일치의 최빈값 | 같은 775 | 최빈값이 맞는 경우는 47%였고, 빈도 동률은 평균 처리했다. |
값의 correctness는 해당 값을 주장한 rollout 가운데 criterion을 통과한 것이 과반인지로 정의한다. 74%는 적어도 하나의 rollout이 criterion을 통과한 비율이고, 47%는 최빈값의 판정 비율이다. 이 두 비율은 해당 Opus APEX 오프라인 분석에서 각각 정의한 분율이다. Claim 추출과 rubric 판정의 영향을 받는 분석이며 독립적인 사실 판독 표본은 아니다.
Figure 5의 entropy별 task 분석은 154+139+108+15=416과제다. 이는 위의 434과제와 주 평가 APEX 480과제와도 분모가 다르다.
3. Resolver와 challenger가 다른 질문을 맡는다
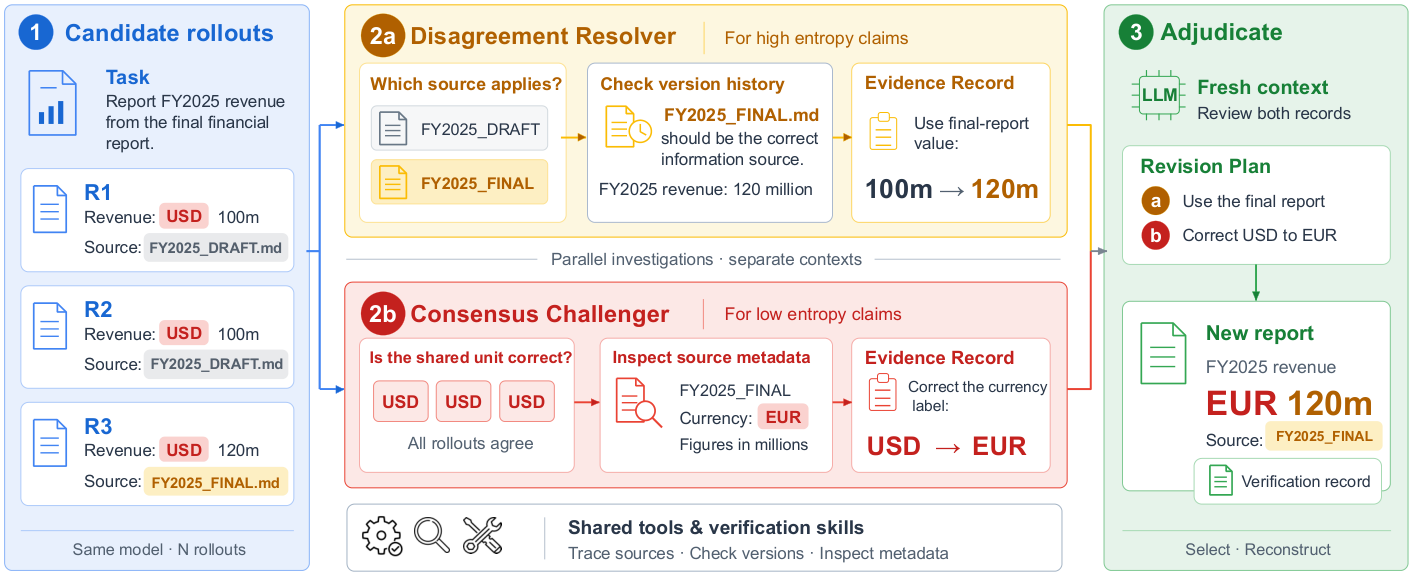
그림 3. Zhang et al. (2026), Figure 3, arXiv v1 PDF 4쪽. 예시에서 resolver는 원본과 최종 파일의 버전을 대조하고, challenger는 모든 후보가 공유한 통화 단위를 살핀다.
**Resolver(불일치 해결기)**는 후보마다 값이 다른 주장을 맡는다. 값의 출처·계산·해석을 확인하고, 후보가 가진 근거가 서로 다른 이유를 좁힌다. 논문은 확인할 항목을 현재 믿음의 엔트로피를 줄일 가능성에 따라 정성적으로 고른다고 설명한다. 수치 확률을 계산하는 Bayesian 정책은 아니다. 후보들의 빈도 πₚ와 근거를 반영한 믿음 bₚ도 구분된다. 모든 후보가 반박돼도 새 값을 뒷받침할 자료가 없으면 주장은 unresolved로 남는다.
**Challenger(합의 반박기)**는 후보들이 같은 값을 쓴 주장이나 빠진 항목을 살핀다. 단위, 부호, 대상 연도, source version, 요구된 항목의 누락 등이 조사 대상이다. 우선순위는 실패 가능성과 중요성에 대한 정성 판단이지 계산된 위험 확률은 아니다.
두 역할은 서로의 기록을 보지 않는 별도 model context에서 동시에 조사한다. 이후 fresh context가 두 evidence record, 과제와 rollout을 받아 판정한다. 문맥을 나누는 설계가 두 판단의 통계적 독립성이나 모든 오류의 발견을 보장하지는 않는다.
**Skill(스킬)**은 자주 쓸 조사 절차를 적은 짧은 문서이며 선택적으로 script를 포함한다. 도구가 파일을 읽게 하는 것과, 어떤 오류를 의심하고 어떤 파일을 확인할지 알려 주는 것은 다르다. 프로그램은 문맥과 파일 전달을 구성하고 모델은 조사 대상과 해석, 종료 시점을 정한다. 모든 claim을 빠짐없이 조사하는 완전한 coverage를 보장하지 않는다.
4. 기존 산출물 선택과 산출물 수정
Adjudication(판정)은 기존 후보 중 선택할지, revision plan에 따라 수정할지, unresolved 상태를 남길지 정한다. Full harness에서는 근거를 바탕으로 기존 artifact를 고치거나 새로 만들 수 있다. 반면 selection-only 조건에서는 pool의 artifact 하나를 그대로 반환한다.
Selection oracle은 benchmark grader가 과제마다 고정 pool에서 가장 높은 점수를 받은 artifact를 고르는 기준이다. 따라서 고정된 후보 안에서의 선택 상한이며, pool에 없는 수정 결과의 상한은 아니다.
Delivery(산출물 반영)는 adjudication과 같은 context에서 이어진다. 새 근거를 조사하는 별도 단계가 아니라 판정 계획에 맞춘 편집 단계다. Unresolved 주장은 기록에 남고, artifact 형식이 허용하면 대안 해석을 함께 적는다. 단일 값만 담을 수 있는 형식이면 adjudicator가 선호한 해석을 넣는다.
검증 실행과 외부 채점은 정보 접근이 다르다. 논문에서 verifier는 grader·정답·rubric을 받지 않지만, 외부 평가자는 각 benchmark의 grader를 쓴다. APEX와 JobBench는 Gemini 3 Flash judge, WSB는 Opus 4.8 judge다. WorkBuddy는 domain별 tests·rules·model judge를 섞고, SpreadsheetBench 2는 workbook 재계산 뒤 reference와 cell별로 비교한다.
Judge 모델이 채점하는 revision 평가에서는 base와 revised artifact를 같은 평가 round에서 채점한 차이를 archived base 점수에 더한다. 논문 이후 고정한 repository README revision 0f10db9818920f8d79641b23d9311c4877f67702도 이 계산을 다음처럼 설명한다.
S_{\mathrm{final}}=S_{\mathrm{archived\ base}}+
(S_{\mathrm{revised,current}}-S_{\mathrm{base,current}}).
이는 평가 round 사이의 judge drift를 줄이려는 차분 보정이다. 보고 점수는 수정본만 새로 채점한 절대 점수와 항상 같지는 않다.
5. 6.2점과 6.4점의 평균 기준
| Benchmark | 주 평가 과제 수 | 지표와 범위 |
|---|---|---|
| APEX-Agents v1.0 | 480 | Task success rate |
| Workspace-Bench Lite | 100 | Mean rubric score |
| WorkBuddy | 200 | Code 80·office 50·web 70 task-weighted score |
| SpreadsheetBench 2 | 321 | Headline accuracy |
| JobBench | 65 | Mean rubric score, 35개 직업 |
WorkBuddy security domain은 API safety alert 때문에 실행하지 않았다. 각 방법은 같은 모델과 고정된 10개 후보 pool을 공유한다. Single rollout 점수는 첫 rollout의 점수가 아니라 pool에 포함된 후보 점수의 평균이다. Verifier의 세 seed는 검증 반복이며 매번 후보 pool을 새로 생성했다는 뜻은 아니다.
| 모델·구성 | APEX | WSB | WorkBuddy | SB-2 | JobBench | 표시 Avg |
|---|---|---|---|---|---|---|
| Flash single | 48.1 | 56.5 | 73.2 | 27.3 | 30.9 | 47.2 |
| Flash select | 53.3 | 62.0 | 77.8 | 31.5 | 33.5 | 51.6 |
| Flash revision | 54.8 | 65.4 | 78.2 | 32.2 | 36.2 | 53.4 |
| Opus single | 35.8 | 60.5 | 79.0 | 30.1 | 42.8 | 49.6 |
| Opus select | 41.2 | 65.0 | 83.0 | 33.4 | 46.1 | 53.7 |
| Opus revision | 47.5 | 67.3 | 83.7 | 34.3 | 47.6 | 56.1 |
Table 2, 8쪽의 일부 점수. 원표는 verifier 세 seed의 표준편차도 제시한다.
Avg는 서로 다른 다섯 native metric의 비가중 산술 평균이다. 다섯 benchmark 과제를 합쳐 계산한 pooled accuracy가 아니다. 각 benchmark가 평균에서 같은 비중을 가지므로 480개 APEX 과제와 65개 JobBench 과제도 각각 같은 무게다.
표시된 Opus Avg만 빼면 56.1−49.6=6.5다. 반면 다섯 benchmark cell의 평균 차이는 56.08−49.64=6.44이고, 소수 첫째 자리로 반올림하면 +6.4다. Flash는 53.36−47.20=6.16이므로 +6.2다. 논문의 headline은 각 cell 산술 평균에 따른 값이다.
전용 VeriHarness selection은 논문의 주 selection baseline 집합에서 열 개 model–benchmark cell 모두 가장 높은 점수다. 별도 CLI 변형을 함께 놓으면 Flash WSB의 Codex 63.8은 전용 구현의 62.0보다 높고 JobBench도 35.6 대 33.5다. 이 CLI 결과는 논문의 주 selection baseline 집합과 별도로 보고된 비교 조건이다.
6. 합의 오류와 역할별 절제 실험
Table 4의 ablation은 revision을 포함한 full harness를 비교한다. Opus 다섯 benchmark 평균은 resolver-only 54.3, challenger-only 52.6, without skills 53.8, single context 55.3, full 56.1이다. Flash에서도 full 조건이 각 ablation보다 높다. 이 절제 실험은 역할·스킬·문맥 구성을 비교하며 추가 계산량과 역할 간 상호작용을 따로 고정하지 않는다.
합의 오류는 후보끼리 서로 다른 답을 고르는 selection만으로 고치기 어렵다. 논문은 challenger의 효과를 selection-only가 아니라 revision을 포함한 조건으로 살핀다. Full 결과에는 두 역할이 함께 작동하는 조건이 포함되며 개별 ablation 점수의 합과는 다르다.
Opus APEX 분석에서 selection 이득은 합의 pool 154개에서 +0.6점, 불일치 pool 262개에서 +6.1점이다. 불일치 그룹의 entropy low·medium·high는 각각 139·108·15과제이며 이득은 +4.5·+7.7·+9.4점이다. High 그룹은 15과제다. 이 값은 난도나 oracle gap을 통제한 entropy의 인과 효과가 아니다.
Challenger가 그대로 인정한 전원 오답 claim 중 논문은 70%에서 확인 대상이 올바른 중간값이었고 채점 오류가 downstream에 있었다고 보고한다. 14%는 정의·기간·version 불일치, 12%는 채점 대상 값의 오류, 4%는 누락·mapping noise였다. 분모는 해당 분석에서 살아남은 공유 오류다. 저자는 분석한 APEX 사례에서 전원 정답 claim을 challenger가 반박한 경우는 없었다고 보고한다. 이 표본 결과는 일반적 false-positive 0 보장을 뜻하지 않는다.
7. 스킬 진화와 개발 단계의 grader 피드백
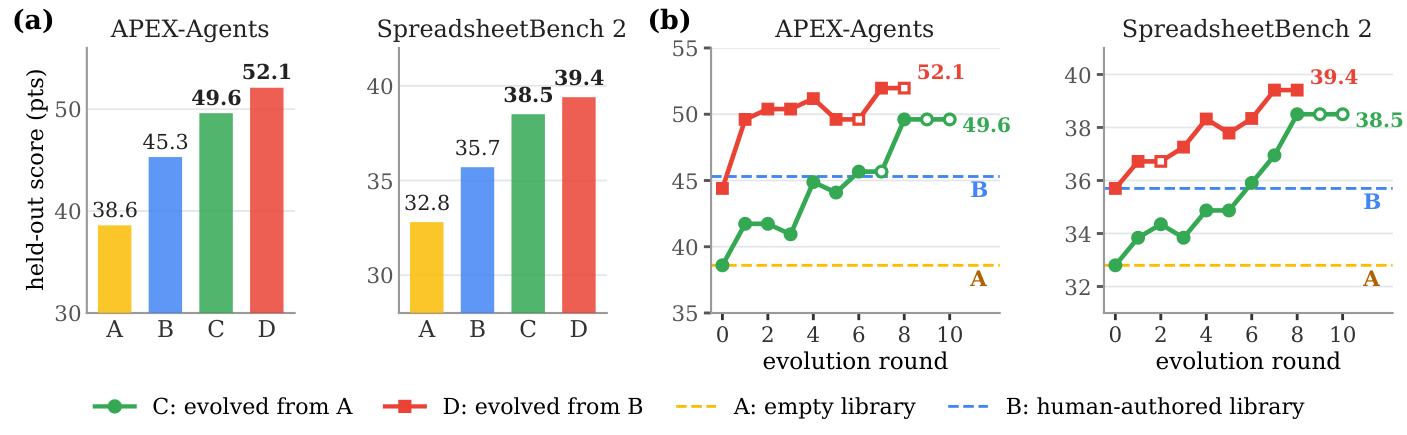
그림 4. Zhang et al. (2026), Figure 4, arXiv v1 PDF 9쪽. Opus full harness의 APEX와 SpreadsheetBench 2 held-out 점수이며, 빈 library 또는 human-authored library에서 시작한 조건을 비교한다.
진화 실험은 Opus와 두 benchmark subset을 사용한다. APEX에서는 file-deliverable 과제를 제외하고, SpreadsheetBench 2에서는 template·financial-model 과제를 쓴다. 이 부분집합에서 분리한 held-out 과제를 평가하므로 Table 2의 전체 benchmark 결과와 분모가 다르다. 평가에는 revision을 포함한 full harness를 사용한다.
| Library 조건 | APEX held-out | SB-2 held-out |
|---|---|---|
| A: 빈 library | 38.6 | 32.8 |
| B: human-authored | 45.3 | 35.7 |
| C: A에서 진화 | 49.6 | 38.5 |
| D: B에서 진화 | 52.1 | 39.4 |
C−A의 차이는 +11.0/+5.7점이고 D−B는 +6.8/+3.7점이다. 이 결과는 checking뿐 아니라 adjudication과 delivery를 포함한 최종 산출물에 대한 점수다.
데이터 분할은 과제의 열 rollout을 같은 partition에 두고, source workspace·문서·workbook template를 공유하는 과제도 묶어 약 75:25로 나눈다. Human library 작성자는 held-out artifact·trace·grade를 보지 않았으며 held-out 점수는 후보 수·prompt·stopping 결정에 돌려주지 않는 조건이다.
개발 단계의 failure package에는 grader의 per-item verdict가 포함된다. 스킬 library를 제안하는 모델은 이를 보고 처음에는 round당 세 개, 이후 다섯 개 후보 library를 만든다. Task ID·benchmark명·개발 filename·reference value가 든 후보는 자동 filter로 걸러진다. 후보는 개발 점수의 paired gain이 음수가 아닌 것 중 높은 순으로 선택한다. 개발 중에도 개별 검증 실행에는 정답·rubric을 제공하지 않으며, grader 피드백을 읽는 역할은 library 제안자다.
진화 schedule은 C에서 10 round, D에서 8 round로 고정하고 마지막 library를 사용한다. APEX에서 D는 C가 마지막에 얻은 49.6점에 round 1에서 도달하지만, SB-2에서는 round 7에야 C의 38.5점을 넘는다. 후보 수가 바뀌므로 round 수만으로 계산량·시간을 비교할 수 없다. 저자는 이 진화 결과를 point estimate로 보고하며 통계적 유의성을 확립하지 않는다.
따라서 training-free는 모델 가중치 학습이 없다는 뜻이다. 스킬 진화에는 개발용 grader feedback이 들어간다. Figure 4의 held-out task와 library는 현재 공개 저장소의 최신 skill 묶음과 동일한 것으로 전제하지 않는다.
8. 검증 비용과 cache 회계
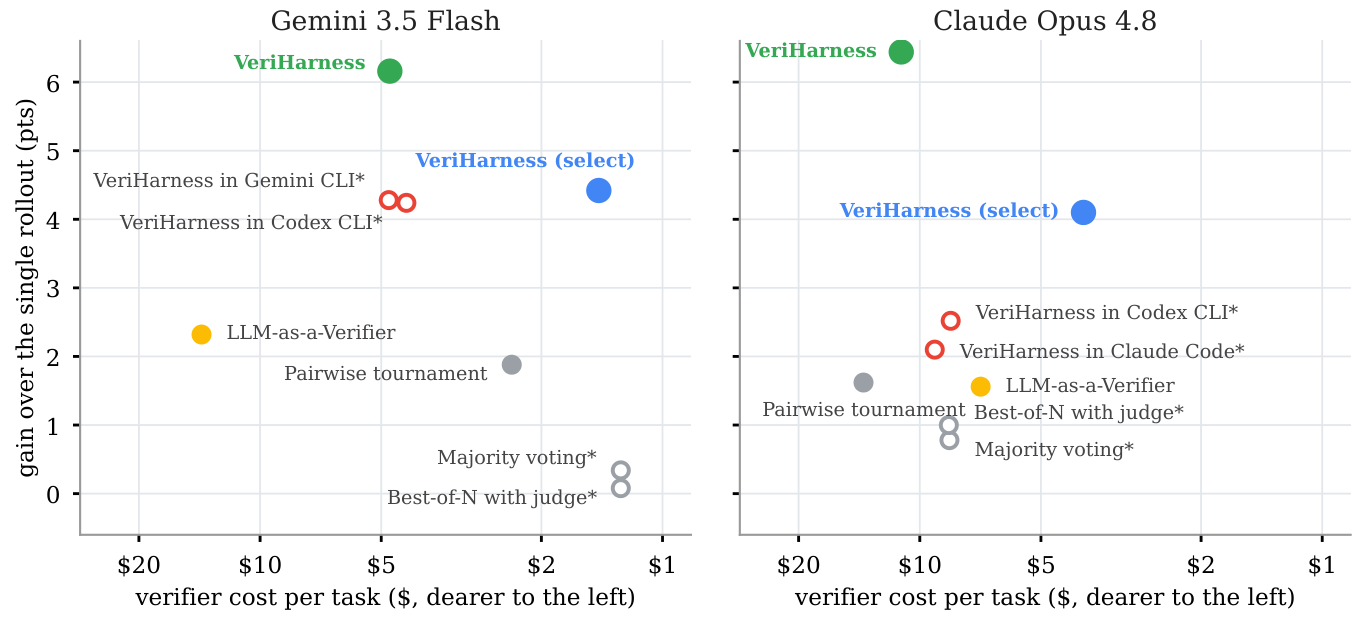
그림 8. Zhang et al. (2026), Figure 8, arXiv v1 PDF 28쪽. 가로축은 로그 스케일이며 오른쪽일수록 비용이 낮다. 세로축은 다섯 native score의 평균 개선이다. 빈 마커와 별표는 추정 비용을 표시한다.
Appendix K의 selection 비용은 Flash 1.44/task, Opus3.92/task다. Revision 포함 pipeline은 selection만 하는 조건보다 약 세 배 비용이 들고 평균 이득도 더 크다. 이 비용은 이미 만들어진 열 개 후보에 대한 추가 verifier 비용이며 후보 열 개를 생성하는 비용은 포함하지 않는다.
입력 token의 86–91%를 cache에서 읽고, token 수에 list price와 cache-read 요금을 적용한다. 모든 입력에 full-rate를 적용하면 selection 비용은 5.40/13.06이다. Cache hit 비율은 wall-clock 가속률이나 전체 비용 절감률이 아니다.
비교선의 비용 자료는 같은 방식으로 계측되지 않았다. Majority voting·best-of-N·CLI는 call count와 context size를 이용한 추정이고, aggregation은 별도 client 때문에 metering되지 않았다. LLM-as-a-Verifier는 비교마다 네 번 평가한 조건이다. 비용 그림은 서로 다른 조건의 측정값과 추정값을 함께 표시한다.
초록의 $100,000 초과는 rollout pool 제작 비용에 대한 저자 보고다. 개별 verifier 실행비나 전체 실험 프로젝트 예산과는 다른 수치다. 검증은 multi-turn 조사라 wall-clock이 늘 수 있으며 이 방법은 즉답보다 보고서·workbook·patch 같은 결과물 품질을 다룬다.
9. 논문 pool과 공개 배포 자료의 차이
논문 Table 1의 다섯 benchmark 과제 수 합계는 1,166이다. 과제마다 모델 둘과 rollout 열 개를 곱하면 nominal pool은 23,320개다. 논문 초록과 repository README revision 0f10db9818920f8d79641b23d9311c4877f67702는 약 26,000개라고 쓴다. 이 수치들은 각각의 보고 맥락을 유지한다.
Hugging Face dataset card revision 214c7081ebd2e3896e311e5f495cd4e81419950a의 표에서 rollout 수를 합하면 23,197개다. Card는 APEX Opus 478과제·4,658개, APEX Flash 480과제·4,754개, JobBench Flash 715개를 포함한 행별 수치를 제시하고 rollout ID를 r01–r11로 설명한다. 공개 card의 총계에는 논문 표의 exact ten-rollout pool과 공개 파일의 대응 관계가 기재되어 있지 않다.
Card는 JobBench Flash에서 actor가 rubric 파일을 읽은 다섯 rollout을 contamination으로 제외하고 index에 excluded=true로 남겼다고 설명한다. 또 trajectory 누락 66개와 provider error로 끝난 45개를 보고한다. 이는 card가 기술한 공개 archive 처리 정보이며 논문 Table 2의 점수 포함 여부나 verifier의 rubric 접근을 그 자체로 뜻하지 않는다.
공개 배포에는 원 benchmark의 task 입력·rubric·정답을 별도 포함하지 않고 upstream에서 복원하도록 한다. Trace에는 actor가 읽은 입력과 웹 내용이 들어갈 수 있으며 Card는 누락 파일 복원과 masking 방식을 설명한다. 따라서 benchmark 원자료와 공개 rollout archive는 구분되는 자료다.
Pinned README는 일부 resolve-*, evidence/repair 도구와 scanner가 논문 이후 같은 benchmark의 실패 분석에서 추가됐다고 명시한다. 또한 이 후속 library는 held-out 검증이 아니라고 설명한다. 공개 저장소의 최신 skill이 논문 Figure 4의 frozen library와 같은 artifact라는 뜻은 아니다.
실행 환경 설명도 두 문서가 다르다. 논문 21쪽은 sandbox의 network access가 없다고 기술한다. Pinned README는 network namespace가 없고 model endpoint가 접근 가능하며 native 환경도 host network를 쓴다고 설명한다. 이 문서 차이는 그 자체로 실제 유출이나 공격을 입증하지 않는다. README의 programmatic gate는 base filename을 보존하는 content-blind 검사로 설명되며, 파일 존재 확인과 claim의 의미적 진실 판정은 다른 기능이다.
10. 저자가 밝힌 연구 한계
저자는 rollout 열 개의 생성 비용이 필요하고 verification이 multi-turn이라 latency가 늘 수 있다고 설명한다. 강한 외부 verifier와의 비교는 연구 범위에 포함하지 않는다. Harness는 rollout마다 calibration된 scalar score를 만들지 않으며, 그 점수를 reward signal로 바꾸는 일은 후속 과제로 남긴다.
스킬의 다른 분포로의 전이와 개발 grader feedback 없이 스킬이 개선되는 조건은 입증하지 않는다. 진화 결과는 point estimate이며 통계적 유의성을 확립하지 않는다. 이 결과는 해당 benchmark·split·모델·library 조건에서 보고된 결과다.
References
Zhang, C., Han, R., Wang, Z., CuiZhu, Z., Collier, N., Pfister, T., & Lee, C.-Y. (2026). VeriHarness: Scaling agentic verification for long-horizon tasks [Preprint]. arXiv. https://arxiv.org/abs/2610.00972v1