AgentWorld: Benchmarking Long-Horizon Collaboration of Multi-agent LLMs
나무는 모았는데 지팡이는 없다: AgentWorld 쉽게 읽기
나무를 베는 AI와 지팡이를 만드는 AI는 언제 재료를 주고받아야 할까. AgentWorld의 공동 작업과 성공률 52%를 살펴보고, 성공에 기여한 행동을 추적하는 CCE가 보여 주는 것과 놓치는 것을 분석한다.
Paper: Raphael Shu; Yusen Zhang; Young Min Cho; Jin Mo Yang; Yuan Yuan; Wenliang Zheng; Sharath Chandra Guntuku; Lyle Ungar; Zhou Yu; Rui Zhang (2026). "AgentWorld: Benchmarking Long-Horizon Collaboration of Multi-agent LLMs". arXiv:2609.31590v1. OpenAgents, Columbia University, University of Pennsylvania, Seoul National University, Penn State University. 앞의 세 저자는 공동 기여자로 표시됩니다. PDF · 서지 정보 · 프로젝트 · 저장소. 2026-09-25 공개된 23쪽 v1을 기준으로 합니다.
논문이 만든 협업 벤치마크와 주요 결과를 설명합니다. CCE의 계산·판정과 비교 조건은 상세 읽기에 정리되어 있습니다. 아래 성공률은 논문 보고 수치입니다.
1. 나무는 있는데 지팡이는 왜 없을까요?
설명용 가상 장면입니다. 벌목꾼이 나무를 충분히 모으고 목공이 막대기를 만들 수 있어도, 재료가 벌목꾼의 가방에만 있으면 마법사는 지팡이를 만들지 못합니다. 각자 일을 많이 했다는 사실만으로 팀 목표가 완성되지는 않습니다. 다음 사람이 일할 수 있도록 필요한 자원과 진행 상황을 건네야 합니다.
AgentWorld는 이 차이를 게임 속 공동 과제로 시험합니다. 여러 에이전트가 역할과 능력, 보유 자원이 다른 상태에서 채집·제작·전투 등을 나누어 수행합니다. 논문의 주된 기여는 새 협업 알고리즘을 제시하는 것보다, 협업이 필요한 세계를 만들고 성공에 기여한 행동을 추적할 평가 방법을 제안한 데 있습니다.
2. 복잡한 게임을 정해진 도구로 평가합니다
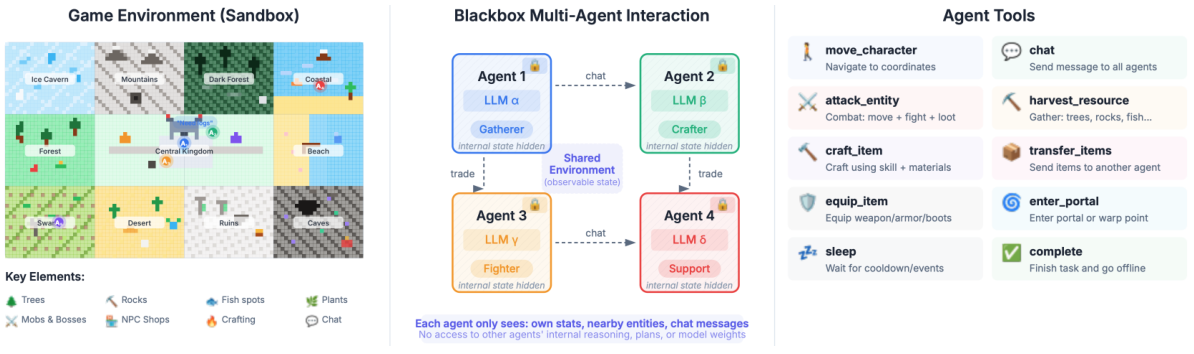
Figure 2. 세계, 에이전트 사이의 정보 경계, 고수준 도구의 예를 보여 줍니다. 도구는 전체 13개 중 10개가 표시됩니다. 출처: Shu et al. (2026), arXiv v1, p. 2, Fig. 2 — 연구·학습 목적 인용.
환경은 Kaetram 기반 MMORPG입니다. 팀은 과제별로 3–20개 에이전트로 구성되고, 각 역할은 서로 다른 자원이나 제작 지식을 가집니다. 과제별 최대 round 예산은 25–55라운드 범위이며 평균 예산은 38라운드입니다. 이는 예산이지 실제 실행이 그 길이에 도달했다는 뜻은 아닙니다. 이동과 전투를 묶은 attack_entity, 이동과 채집을 묶은 harvest_resource처럼 한 번의 고수준 도구 호출로 여러 게임 동작을 수행합니다. 논문이 보고하는 플랫폼의 최대 동시 에이전트 수 1,000은 이 벤치마크에서 한 과제를 푼 팀의 크기가 아닙니다.
평가는 순차 round-robin 방식입니다. 한 라운드에 에이전트가 차례로 관측하고 도구를 한 번 호출한 뒤, 다음 에이전트가 행동합니다. 앞선 행동으로 세계가 바뀌면 뒤 에이전트가 달라진 상황을 볼 수 있습니다. Blackbox란 다른 에이전트의 내부 상태나 행동 기록을 직접 열람하지 못한다는 뜻이지, 역할별 문서나 주변 환경 정보가 전혀 없다는 뜻은 아닙니다. 채팅도 행동 하나를 쓰므로, 의사소통이 길어지면 실제 작업 기회가 줄어들 수 있습니다.
3. 성공률 52%는 원본 과제의 최고값입니다
저자들은 사람이 만든 main 과제 100개와 Claude Opus 4.5가 만든 변형 과제 100개를 평가합니다. 변형은 목표량·시작 위치·초기 아이템 등을 바꾸며, 원본과 무관한 새 과제 100개가 아닙니다. 저자들은 변형 중 10개를 사람이 검토했으므로 전체 100개가 사람 손으로 전수 검증됐다고 말할 수 없습니다.
성공은 최종 상태와 경우에 따라 실행 기록을 확인하는 과제별 검증 함수로 판정합니다. 주요 모델의 main 성공률은 Gemini 3 Flash 52%, Claude Haiku 4.5 45%, GPT-5 Mini 36%, DeepSeek R1-70B 20%입니다. 즉 가장 높은 52%는 원본 과제에서의 결과입니다. 증강 과제에서는 Gemini가 24%, Claude가 26%로 순서가 바뀝니다. 두 결과를 합쳐 “Gemini가 모든 조건에서 가장 좋다”고 요약하면 안 됩니다.
PSR은 성공의 일부 체크포인트를 달성했는지 보는 별도 지표입니다. 예를 들어 Gemini의 main PSR은 71.5%지만 SR은 52%입니다. 이 차이를 그대로 “과제의 19.5%가 마지막 단계에서 실패했다”고 해석할 수는 없습니다. 체크포인트 달성 비율과 과제 전체 성공 여부는 서로 다른 질문을 답합니다.
4. CCE는 성공에서 행동의 연결을 거슬러 갑니다
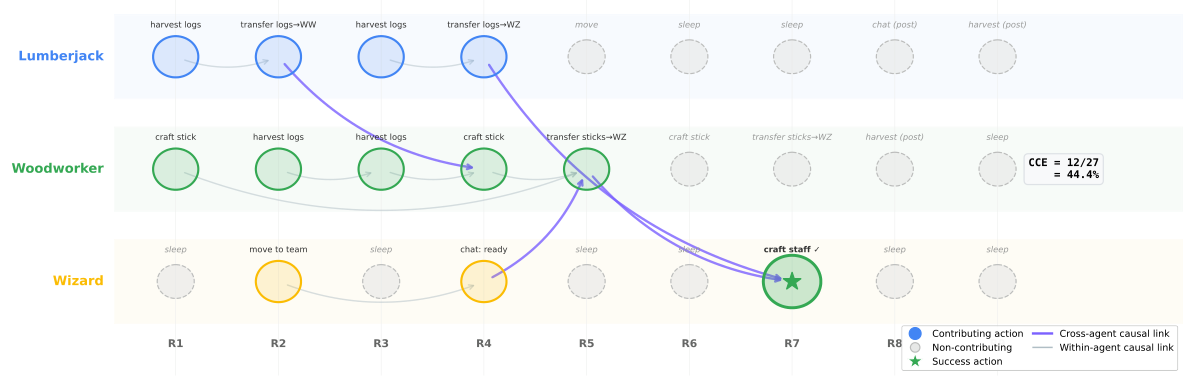
Figure 5. 세 에이전트가 9라운드 동안 한 27개 행동 중 기여 행동 12개를 표시해 44.4%를 계산합니다. 출처: Shu et al. (2026), arXiv v1, p. 6, Fig. 5 — 연구·학습 목적 인용.
CCE는 팀에 막연한 협업 점수를 매기기보다, 성공을 직접 만든 행동부터 그 선행 조건을 거꾸로 찾습니다. 지팡이 제작에 사용된 막대기가 필요했다면 막대기를 만든 행동을, 그 막대기에 나무가 필요했다면 나무를 전달하거나 모은 행동을 따라갑니다. CCE(Causal Collaboration Effectiveness, 협업 효과성)는 성공을 직접 만든 행동과 그 성공에 선행해 기여한 행동 수를 전체 행동 수로 나눈 비율입니다.
판정에는 GPT-4.1이 성공 행동과 기여 행동을 고르는 역할을 합니다. 따라서 분수 계산은 명확해도 어떤 행동을 시작점과 기여자로 넣을지는 모델의 판단에 영향을 받습니다. 여기서 ‘causal’은 관측된 기록에서 기여 관계를 역추적한다는 뜻입니다. 행동을 제거한 뒤 게임을 다시 실행해 결과 차이를 비교하는 인과 개입 실험은 아닙니다.
5. CCE 0.320을 ‘전체 행동의 32%’로 읽지 않습니다
논문 표는 실패 과제의 CCE를 0으로 놓고 과제별 비율을 평균합니다. 이는 모든 행동을 한데 모아 계산한 전체 행동 비율과 다릅니다. 따라서 Gemini의 평균 CCE 0.320은 “전체 행동의 정확히 32%가 성공에 유용했다”는 뜻이 아닙니다. 또한 실패 과제에 0점을 준 규칙은 지표의 집계 방식입니다. 실패한 실행 안에서 나무를 모으거나 다른 역할을 도운 행동이 실제로 모두 쓸모없었다는 증거는 아닙니다.
저자들은 사람과 judge가 행동 기여 여부를 판단한 84개 사례 중 69개에서 일치했다고 보고합니다(κ=0.64). 이는 한정된 표본에서의 라벨 일치 결과입니다. 성공 원인을 완전히 객관적으로 판정했다거나, 인과 관계를 정답과 대조해 인증했다는 뜻은 아닙니다. 그래서 성공률과 CCE를 함께 보되, 어느 쪽도 현실의 모든 팀 협업을 측정하는 단일 점수로 취급하지 않는 편이 적절합니다.
6. 통신과 기준선은 조건을 함께 봐야 합니다
Gemini의 기본 팀 성공률은 52%이고, Oracle communication에서는 한 에이전트가 모든 메시지를 보고 팀을 조정하며 성공률은 60%입니다. 이는 해당 구성에서 관찰된 차이이지 가능한 통신 방식의 수학적 상한은 아닙니다. 또 통신 없음·단일 에이전트 등 비교 설정은 제공되는 정보와 수행 기회가 다를 수 있습니다. 논문 표의 몇 성공률은 평가 과제 수와 분모가 충분히 설명되지 않아, main 100개 결과와 같은 조건의 직접 비교로 단정하지 않습니다. 단일 에이전트 조건도 한 역할을 그대로 혼자 맡기는 대신 역할과 아이템을 합칩니다.
채팅량 역시 협업 품질 그 자체는 아닙니다. GPT-5 Mini는 과제당 평균 채팅이 44.1회로 많지만 main 성공률은 36%였고, 다른 모델들도 성공률과 채팅량이 서로 다릅니다. 채팅이 행동 기회를 사용한다는 점을 고려하면, 중요한 질문은 메시지 수를 늘리는 것보다 필요한 정보가 적절한 시점에 전달되는지입니다. 다만 관찰된 상관만으로 통신량이 성공이나 실패를 일으킨 원인을 확정할 수는 없습니다.
References
Shu, R., Zhang, Y., Cho, Y. M., Yang, J. M., Yuan, Y., Zheng, W., Guntuku, S. C., Ungar, L., Yu, Z., & Zhang, R. (2026). AgentWorld: Benchmarking long-horizon collaboration of multi-agent LLMs [Preprint]. arXiv. https://arxiv.org/abs/2609.31590v1