Attention-based PCA
가우시안 토큰을 재구성하도록 학습한 단순 attention이 어떤 조건에서 첫 주성분을 찾는지 쉽게 설명합니다. 유한 프롬프트, 공유 spike, 증명상의 주의점도 함께 다룹니다.
한눈에 보기: 특정한 재구성 과제를 학습하는 작은 attention 모형에서, 최적의 출력이 데이터의 첫 주성분 투영과 일치한다는 이론 연구입니다. 여기서 중요한 말은 ‘특정한’, ‘학습한’, ‘조건 아래’입니다. 보통의 Transformer가 저절로 PCA를 한다거나, 성능과 속도가 좋아진다는 주장은 아닙니다.
논문: Rodrigo Maulen-Soto와 Claire Boyer의 Attention-based PCA, arXiv:2605.18315v2. 이 글은 2026년 6월 v2, 48쪽 판본을 바탕으로 합니다. 원문 v2 · 자세한 읽기
PCA는 데이터에서 무엇을 찾나요?
여러 숫자로 된 데이터를 생각해 보겠습니다. 사람의 키·몸무게처럼 값들이 함께 움직인다면, 데이터에는 변화가 가장 큰 방향이 있습니다. PCA는 그 방향을 첫 번째 주성분으로 찾습니다. 각 자료를 그 방향 위에만 남기면 정보 일부를 버리지만, 한 방향만 보존할 때 평균적으로 가장 적은 정보를 잃습니다.
논문은 이 익숙한 결과를 다른 질문으로 바꿉니다. “PCA 알고리즘을 실행하지 않고, attention이 토큰을 다시 만들어 내도록 학습하면 가장 중요한 방향을 배울 수 있을까요?” 저자들은 답이 ‘이 설정에서는 그렇다’고 보입니다. 모든 attention에 대한 성질이 아니라, 명확히 제한한 수학 모형의 결과입니다.
아주 단순한 attention을 학습합니다
모형에 들어오는 토큰은 평균이 0인 가우시안 분포에서 독립적으로 뽑힌다고 가정합니다. 분포의 공분산 행렬을 Σ라고 부르겠습니다. 공분산은 각 방향으로 데이터가 얼마나 퍼져 있는지 담습니다. 가장 큰 고윳값에 대응하는 고유벡터가 데이터가 가장 넓게 퍼진 방향, 즉 첫 주성분입니다.
이 attention에는 하나의 학습 벡터 μ가 있습니다. query와 key의 점수는 이 벡터로 만드는 rank-one 결합에 의해 정해지고, value는 입력 토큰을 바꾸지 않고 그대로 전달합니다(identity value). 모델은 입력 토큰 하나를 prompt 전체에서 가중 평균한 출력으로 재구성합니다. 여기서 prompt 전체에는 재구성 대상인 토큰 자신도 들어 있습니다. 여러 층, 여러 head, 언어 모델의 다음 토큰 예측을 분석한 것이 아닙니다.
가우시안에서는 softmax가 정확히 선형으로 바뀝니다
토큰 수 L을 매우 크게 하면, 표본마다 달라지는 softmax 가중 평균은 가우시안 분포에 대한 평균의 비율로 가까워집니다. 가우시안에는 유용한 성질이 있습니다. 입력에 지수 가중치를 주고 평균을 계산하면, 그 평균의 이동량을 공분산 Σ가 정확하게 정해 줍니다. 이 성질을 적용하면 무한 prompt에서 attention의 출력은 다음 형태가 됩니다.
T_\infty^\mu(x)=\lambda\Sigma\mu\mu^\top x.λ는 점수의 크기를 조절하는 양수입니다. 이 식은 softmax의 지수함수를 작게 보고 1차 테일러 근사한 결과가 아닙니다. 가우시안의 적분을 계산해 얻는 정확한 극한 항등식입니다. 입력 분포가 일반적인 비가우시안일 때도 똑같은 선형식이 나온다고 할 수는 없습니다.
이제 모델이 최소화하는 것이 평균 제곱 재구성 오차라고 합시다. Σ가 양의 정부호이고 고윳값들이 서로 다르다고 가정합니다. 가장 큰 고윳값을 σ₁, 그 방향의 단위 고유벡터를 u₁이라 하면, 최적 파라미터는 μ=±u₁/√(λσ₁)입니다. 이를 출력 식에 넣으면
T_\infty^{\mu}(x)=u_1u_1^\top x가 됩니다. 오른쪽은 x를 첫 주성분 방향으로 정사영한 값입니다. 따라서 PCA와의 정확한 연결은 ‘학습한 출력이 최적점에서 첫 주성분 투영이 된다’는 것입니다. μ의 방향만 맞으면 끝나는 것도 아닙니다. μ의 크기까지 σ₁과 λ에 맞춰져야 출력이 올바른 투영이 됩니다. 파라미터의 길이와 최종 출력의 효과를 구별해야 합니다.
최적해와 실제 학습은 같은 말이 아닙니다
앞의 수렴 분석도 고정된 양의 정부호 Σ의 고윳값이 서로 다르다는 조건을 둡니다. 최적해가 있다고 해서 어떤 초기값에서도 그곳에 도착하는 것은 아닙니다. 논문은 가능한 가우시안 prompt에 대한 평균 손실(population risk)을 연속적으로 줄이는 gradient flow가 ‘거의 모든’ 초기값에서 수렴한다고 분석합니다. 정확히 0인 초기값 같은 예외가 있으며, 이 이상화된 경로는 실제 SGD와 다릅니다.
그림은 길이 100의 prompt를 쓰는 SGD와 공분산을 알고 계산하는 무한 prompt GD를 비교합니다. 정렬의 예시이지 같은 정보·비용을 쓴 비교나 속도 벤치마크는 아닙니다.
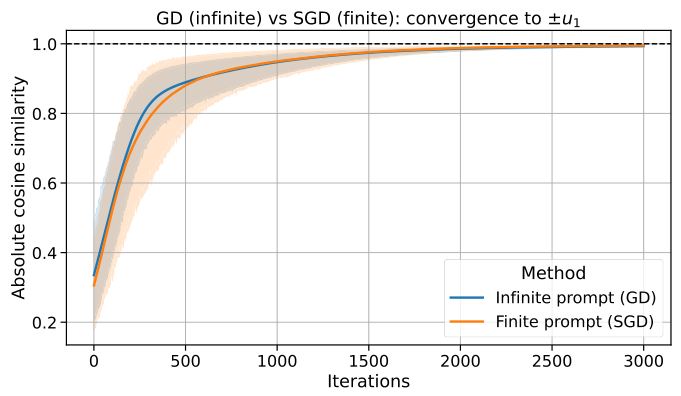
그림 1. 유한 길이 L=100의 SGD와 공분산을 아는 무한 prompt GD에서 정렬이 어떻게 변하는지 비교합니다. 출처: Maulen-Soto & Boyer (2026), v2, p. 7, Figure 1.
유한 prompt 결과에는 길이가 충분히 크다는 조건과 분석 범위가 붙습니다. 유한 prompt에 대한 population 평균도 고정된 유한 데이터셋의 실제 SGD와 같지 않습니다.
특히 L=1이면 attention이 선택할 토큰은 자기 자신뿐입니다. 가중치가 어떻게 바뀌어도 출력은 입력과 같아서 재구성 오차가 0이고, μ를 어느 방향으로 정할 이유가 없습니다. 가장 작은 예외만 보아도 “모든 길이의 attention은 PCA를 한다”는 설명은 틀립니다.
여러 prompt에 공통인 방향을 배우는 경우
논문은 prompt마다 공분산이 달라도 분포에 공통 방향 v가 있는 설정을 살펴, 여러 prompt에서 그 방향을 학습하는지 분석합니다.
이는 새 문제의 주성분을 prompt마다 계산하는 ‘문맥 안 PCA’가 아닙니다. 학습 분포에 반복되는 방향을 배운다는 뜻이며, 개별 공분산에서 출력이 언제나 v로의 정확한 정사영이 되는 것도 아닙니다.
여기에는 리뷰 과정에서 발견한 증명상의 주의점이 있습니다. 저자들의 유한 ICL 분석은 v에 수직인 정지점을 유한한 고립점처럼 세지만, 차원 d가 3 이상이면 v에 수직이면서 길이가 같은 정지점들이 구면을 이룹니다. 그 주변에는 다른 정지점이 계속 있습니다. 따라서 유한 ICL로 옮기는 해당 증명에는 이 연속 집합을 다루는 보완이 필요합니다. 이는 증명에 남은 공백이지, 고정된 가우시안 공분산에서 얻은 중심 항등식이나 PCA 최적점이 반박되었다는 뜻은 아닙니다. 또 finite ICL의 결론 전체가 거짓이라고 증명한 것도 아닙니다.
그림과 실험은 무엇을 보여 주나요?
그림은 주성분과 학습 벡터의 방향 정렬을 보여 줍니다. 긴 prompt에서 정렬이 높아지는 경향은 있지만 실험 조건의 결과이며, softmax와 linear attention은 서로 다른 λ를 써 속도 경주로 비교할 수 없습니다.
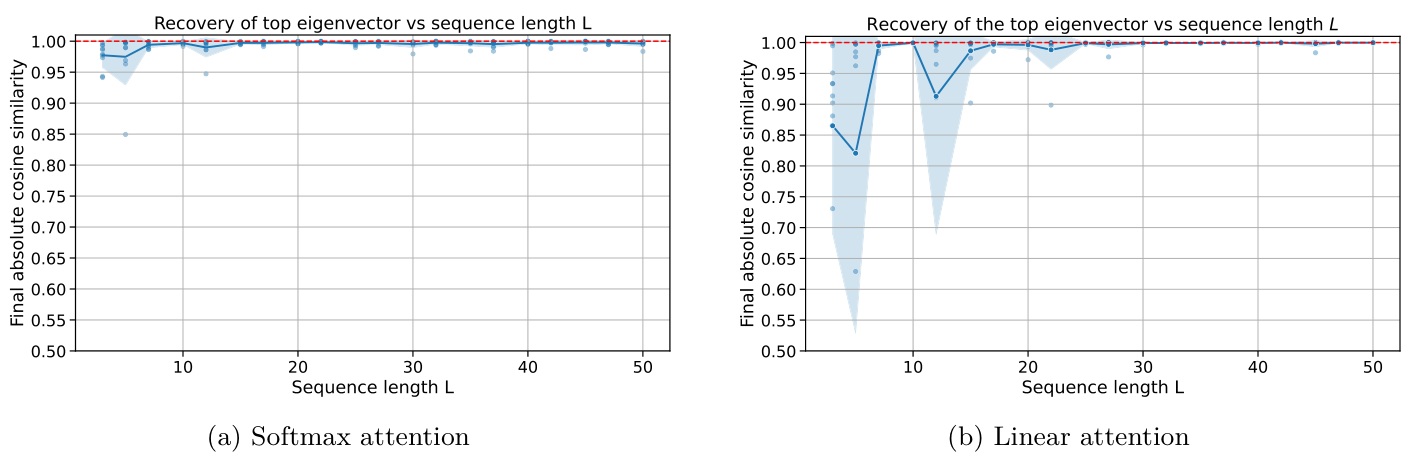
Figure 5. prompt 길이를 바꿔 관찰한 softmax와 linear attention의 최종 정렬입니다. 작은 길이에서의 변동과 긴 길이에서의 높은 정렬이 보이며, 두 방식은 서로 다른 λ를 사용합니다. 출처: Maulen-Soto & Boyer (2026), v2, p. 46.
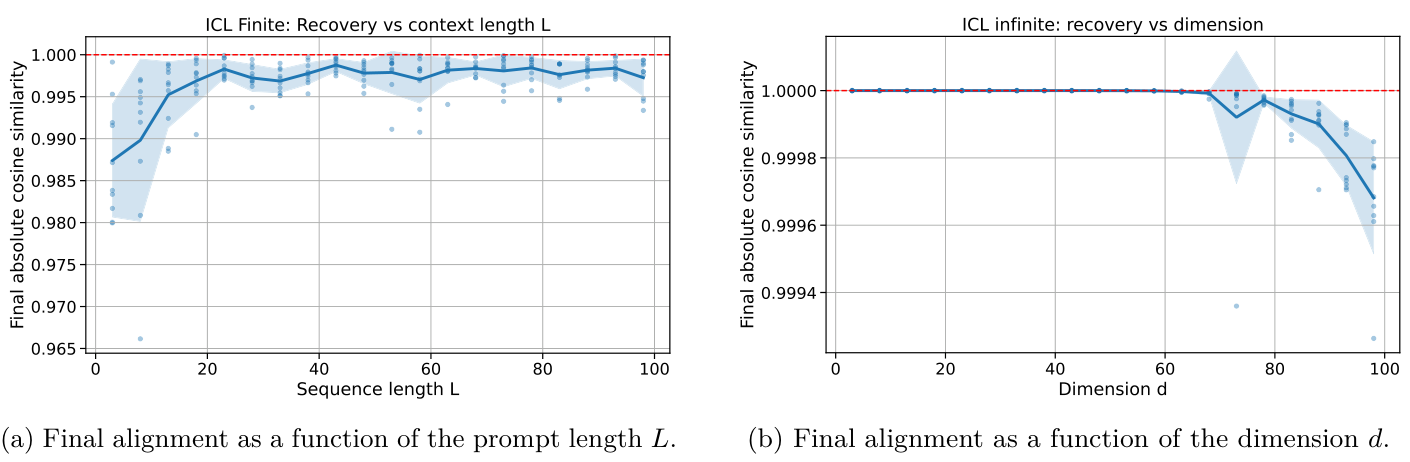
Figure 8. 공통 spike 방향을 학습한 실험의 prompt 길이 및 차원별 정렬입니다. 두 패널의 세로축 범위가 다르고 오른쪽은 1 근처를 확대하므로, 높이만 보고 패널 간 차이를 직접 비교하면 안 됩니다. 출처: Maulen-Soto & Boyer (2026), v2, p. 47.
측정값은 주로 벡터 방향의 코사인 정렬입니다. 이것만으로 최적 파라미터 크기, 재구성 오차, downstream 정확도가 좋아졌다고 할 수 없습니다. 보통의 Transformer가 PCA를 한다는 실증이나 SVD보다 빠르다는 벤치마크도 없습니다.
부록은 초기 벡터를 단위구면에서 뽑는다고 하지만, 확인한 공개 파일 하나(softmax_finite.py)는 0.1 * random.normal(...)로 초기화하고 update 전에 정규화하지 않습니다(정렬 기록 때 정규화). 이 차이는 해당 파일과 설명 사이의 불일치이지, 전체 구현을 감사한 결과나 이론을 반박하는 증거는 아닙니다.
가져갈 점
이 연구의 기여는 제한된 가우시안 설정에서 rank-one attention의 재구성 최적해와 PCA를 연결하고, 정확한 무한 prompt 식을 보인 데 있습니다. 다만 gradient flow를 실제 SGD 보장으로, 공통 방향 학습을 새 prompt의 PCA로, 정렬을 downstream 성능이나 속도 향상으로 바꿔 말할 수 없습니다. ICL의 유한 prompt 증명에도 구면 정지점 문제가 남습니다. “모든 attention은 PCA”가 아니라 정해진 목적과 가정에서 PCA가 나타나는 이유를 설명한 이론 연구로 읽는 것이 정확합니다. 자세한 읽기에서 증명과 수식을 확인하실 수 있습니다.
참고문헌
Maulen-Soto, R., & Boyer, C. (2026). Attention-based PCA (arXiv:2605.18315v2). https://arxiv.org/abs/2605.18315v2