Attention-based PCA
가우시안 토큰을 재구성하도록 학습한 단순 attention이 어떤 조건에서 첫 주성분을 찾는지 쉽게 설명합니다. 유한 프롬프트, 공유 spike, 증명상의 주의점도 함께 다룹니다.
Paper: Rodrigo Maulen-Soto & Claire Boyer (2026). Attention-based PCA. Sorbonne Université·CNRS·LPSM; Université Paris-Saclay·CNRS·Inria·Laboratoire de mathématiques d’Orsay; Institut Universitaire de France. PDF v2 · 서지 정보 · 코드. 최초 공개는 2026-05-18이며, 검토한 48쪽 PDF는 헤더에 v2·2026-06-18, 표제에 June 19, 2026을 표시한다. 최초 v1과 혼용하지 않는다.
Abstract: PCA는 데이터 분산이 가장 큰 방향을 찾는다. 이 논문은 같은 방향이 특정 attention의 학습 결과로 나타남을 분석한다. 가우시안 토큰, identity value, rank-one query–key 결합, 자기 토큰 재구성이라는 제한된 설정에서 무한 프롬프트의 softmax 연산이 선형 연산으로 바뀌고, population risk의 최적점이 첫 주성분과 정렬된다. 충분히 긴 유한 프롬프트로 옮기는 분석, 선형 attention의 닫힌식, 여러 프롬프트에 공유되는 spike 방향의 학습까지 확장한다. 일반 Transformer가 자동으로 PCA를 한다는 주장은 아니며, ICL 유한 프롬프트 증명에는 회전 대칭의 연속 정지점을 유한한 고립점처럼 다룬 기술적 문제가 남는다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 질문 | 비지도 재구성 목적을 학습한 제한된 attention이 공분산의 첫 주성분을 찾는가? |
| 모델 | 토큰은 i.i.d. Gaussian, value는 identity, query–key 결합은 μμᵀ, 학습 파라미터는 μ 하나. |
| 핵심 항등식 | Gaussian·무한 프롬프트에서 softmax 출력은 λΣμμᵀx. |
| 확실한 중심 결과 | 고정 양의 정부호 Σ·서로 다른 고윳값에서 무한 population risk의 최적점은 ±u₁/√(λσ₁), 출력은 u₁u₁ᵀx. |
| 유한 프롬프트 | 충분히 큰 L·유계 영역·population gradient flow의 결과다. 임의 L이나 실제 SGD의 동일 보장이 아니다. |
| 선형 attention | 유한 L에서도 population risk를 정확히 계산하고 최적 파라미터 방향을 구한다. |
| ICL의 범위 | 프롬프트마다 Σ는 달라도 공통 spike v는 고정된다. 매번 새 방향의 PCA를 학습 없이 수행한다는 정리가 아니다. |
| 주요 검토 사항 | d≥3에서 v에 수직인 정지점은 구면이다. Proposition 20의 고립점 논증은 이를 반영하도록 보완해야 한다. |
읽기 안내: 정리 번호와 실험 결과는 원문을 따른다. 대입·경계 사례·정지점 대칭성 검토는 이 글의 별도 계산이다. 논문의 모든 증명을 형식 검증하거나 학습 실험을 재현하지 않았다. 공개 코드도 지정한 실험 파일 하나만 확인했다.
목차
- PCA와 attention을 연결하는 정확한 질문
- 학습하는 것은 어떤 attention인가
- Gaussian softmax가 선형 연산으로 바뀌는 이유
- 최적점과 학습 경로를 구별한다
- 유한 프롬프트로 옮길 때 남는 조건
- 선형 attention과 출력 분포가 보여주는 것
- 공유 spike 학습은 새로운 문제의 PCA와 다르다
- ICL 정지점의 회전 대칭과 증명상의 공백
- 실험이 보여주는 정렬과 보여주지 않는 것
- attention이 PCA를 한다는 말의 적용 범위
1. PCA와 attention을 연결하는 정확한 질문
중심화한 데이터 X의 공분산이 Σ이고 첫 고유쌍이 (σ₁,u₁)이라면, rank-one 직교 투영의 최소 평균 재구성 오차는 tr(Σ)−σ₁이다. u₁ 방향의 분산을 남기고 나머지를 버리는 것이 PCA의 한 성분 복원이다.
Attention은 토큰끼리 점수를 계산하고 가중평균을 만든다. 겉으로는 고유벡터 계산과 다르다. 논문의 질문은 이 연산을 적절한 재구성 목적에 맞춰 학습시키면 PCA의 방향이 나오는지다. 아무 목적 없이 초기화한 attention이나 언어 모델 전체에 대한 동일성 명제가 아니다.
기존 Declarative Attention은 실제 언어 모델의 맥락 접근량과 정확도 교환을 다룬다. Concept-Grounded Attention은 주의 내부 개입이 답에 미치는 효과를 시험한다. 이 글의 대상은 그런 운영 결과가 아니라 단순화한 연산의 최적화 이론이다. 같은 attention이라는 이름만으로 서로의 효과를 설명하는 근거로 쓰지 않는다.
2. 학습하는 것은 어떤 attention인가
토큰 X_1,\ldots,X_L\overset{\mathrm{i.i.d.}}\sim\mathcal N(0,\Sigma), λ>0에서 모델은 다음과 같다.
T_L^\mu(X)_\ell=\sum_{k=1}^{L}\frac{\exp\{\lambda(X_\ell^\top\mu)(\mu^\top X_k)\}}{\sum_{j=1}^{L}\exp\{\lambda(X_\ell^\top\mu)(\mu^\top X_j)\}}X_k.Value matrix는 identity이고 query와 key의 결합은 \mu\mu^\top이다. 두 행렬을 독립적으로 학습하지 않는다. 여러 head·층·MLP·positional encoding·causal mask를 분석한 것도 아니다.
목적은 토큰 하나를 나머지를 포함한 전체 prompt로 재구성하는 것이다.
R_L(\mu)=\mathbb E\|X_1-T_L^\mu(X)_1\|^2.자기 토큰 X₁도 key와 value에 포함된다. 정리의 유한 L은 prompt 길이가 유한하다는 뜻이며, 이 기대값을 유한한 고정 학습 데이터셋으로 대체했다는 뜻이 아니다. 실제 실험의 minibatch SGD와 population gradient flow를 구분해야 한다.
또 score 파라미터가 rank one이라는 것과 유한 softmax 출력이 항상 한 고정 직선 위에 놓인다는 것은 다르다. 예를 들어 μ=0이면 출력은 prompt 평균이고, 그 주변분포의 공분산은 Σ/L이다. Σ가 full rank면 이것도 full rank다. 정확한 rank-one 출력 법칙은 아래의 무한 Gaussian 극한에서 나온다.
3. Gaussian softmax가 선형 연산으로 바뀌는 이유
Prompt가 길어지면 경험적 가중평균은 분포 ν에 대한 적분 비율에 접근한다. query를 z라 두면
T^\mu[\nu](z)=\frac{\mathbb E[X\exp(t^\top X)]}{\mathbb E[\exp(t^\top X)]},\qquad t=\lambda\mu\mu^\top z.Gaussian의 moment-generating function은 M(t)=\exp(\tfrac12t^\top\Sigma t)다. 따라서 분자/분모는 \nabla\log M(t)=\Sigma t가 되어
T_\infty^\mu(z)=\lambda\Sigma\mu\mu^\top z를 얻는다(원문 식 (3)). Softmax의 지수 함수를 무시하거나 테일러 일차 근사로 바꾼 것이 아니다. Gaussian의 지수 tilting 성질을 쓰는 정확한 극한 항등식이다. 일반 비Gaussian 분포의 \nabla\log M(t)는 보통 t의 선형 함수가 아니다.
a=\mu^\top\Sigma\mu, b=\mu^\top\Sigma^2\mu라 하면 오차는 사차다항식으로 정리된다.
R_\infty(\mu)=\operatorname{tr}(\Sigma)-2\lambda b+\lambda^2ab.이 닫힌식 덕분에 최적점뿐 아니라 saddle과 학습 동역학을 분석할 수 있다. Gaussian 가정은 단순한 실험 편의가 아니라 분석이 작동하는 중심 조건이다.
4. 최적점과 학습 경로를 구별한다
4.1 최적 파라미터의 길이도 중요하다
양의 정부호 Σ의 고윳값이 \sigma_1>\cdots>\sigma_d>0으로 서로 다르면 Proposition 1은 다음 임계점을 분류한다.
- μ=0: 엄격한 국소 최대.
\mu=\pm u_j/\sqrt{\lambda\sigma_j}, j≥2: strict saddle.\mu_\star=\pm u_1/\sqrt{\lambda\sigma_1}: 전역 최소.
최적점에서
\lambda\Sigma\mu_\star\mu_\star^\top=u_1u_1^\top,
\qquad R_\infty(\mu_\star)=\operatorname{tr}(\Sigma)-\sigma_1.
이것이 PCA와 정확하게 만나는 지점이다. 학습 파라미터 자체는 길이 1인 u₁이 아니라 스케일을 가진 벡터다. 부호 ±는 \mu\mu^\top에서 사라진다.
4.2 거의 모든 초기화와 국소 지수 수렴
Proposition 2는 population gradient flow가 거의 모든 초기화에서 두 전역 최적점 중 하나로 수렴한다고 한다. 모든 초기화는 아니다. μ₀=0이면 gradient도 0이므로 그 자리에 머문다. Saddle의 안정 집합도 예외에 포함된다.
Proposition 3의 지수 수렴은 충분히 가까워진 뒤의 국소 결과다. d≥2에서 원문의 최소 Hessian 고윳값은
\widetilde s=2\lambda\min\{\sigma_2(\sigma_1-\sigma_2),\;\sigma_d(\sigma_1-\sigma_d)\}이다. 작은 spectral gap뿐 아니라 작은 σd도 느린 방향을 만들 수 있다. 초기 위치·전체 구간과 무관하게 몇 step이면 끝난다는 복잡도 정리가 아니다. 충분히 작은 step의 GD로 확장 가능하다는 저자 설명도 임의 learning rate의 SGD 보장으로 바꾸지 않는다.
4.3 Oja와의 관계는 동일 궤적이 아니다
w=\Sigma^{1/2}\mu로 바꾸면 Oja flow에 Σ 전처리와 상태 의존 계수를 붙인 형태가 된다. 고유방향을 추출하는 구조를 공유하지만 동일한 시간 경로는 아니다. 일반 λ에서 이 모델의 정상 w는 \pm u_j/\sqrt\lambda이고 표준 Oja의 비영 정상점은 \pm u_j다. 원문의 ‘같은 stationary points’라는 표현은 스케일을 구분해 읽는 것이 정확하다.
여러 성분을 얻는 Remark 1도 이미 배운 방향의 직교 여공간으로 명시적으로 투영하는 반복 절차다. 단일 head가 한 번에 모든 주성분을 자동 분리했다는 결과가 아니다.
5. 유한 프롬프트로 옮길 때 남는 조건
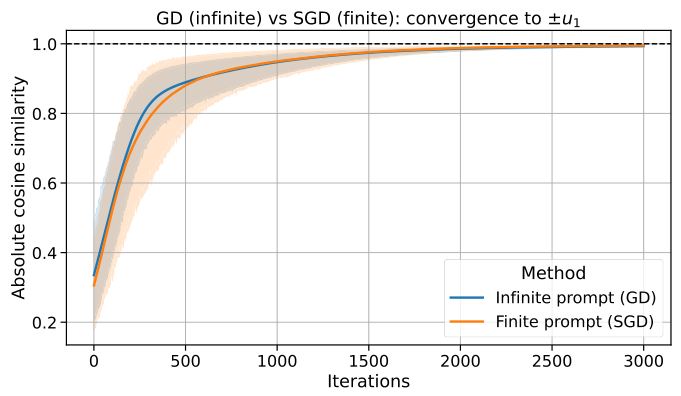
Figure 1. L=100인 finite SGD와 Σ에 직접 접근하는 infinite GD를 비교한다. 출처: Maulen-Soto & Boyer (2026), v2, p. 7, Fig. 1 — 연구·학습 목적 인용.
유한 prompt에서는 softmax 출력이 Gaussian 적분 비율과 정확히 같지 않다. 논문은 다음 순서로 옮긴다.
| 단계 | 결과 | 범위 |
|---|---|---|
| Proposition 4 | 출력 및 μ 미분의 제어로 risk·gradient·Hessian 수렴 | μ의 compact 영역, L→∞ |
| Propositions 5–7 | 큰 L에서 flow 유계성, 유한 시간 구간에서 무한 flow 추적 | 고정 초기화·충분한 L |
| Proposition 8 | 임계점이 무한 risk 임계점 근처에 대응 | 충분히 큰 공통 유계 영역 내부 |
| Proposition 9 | 일반적 초기화가 두 국소 최소 중 하나로 수렴, 국소 지수 속도 | finite-prompt population flow |
Proposition 8이 직접 부르는 것은 finite risk의 국소 최소다. 무한 공간 전체의 finite risk 지형을 완전히 분류했다고 확대하지 않는다. 또 L이 큰 극한의 정렬과 정확한 유한 L의 최적점 좌표를 동일시하지 않는다.
경계 사례: L=1이면 softmax weight는 무조건 1이므로 T_1^\mu(X)_1=X_1, R_1(\mu)=0이다. 어떤 μ도 최적이며 첫 주성분을 고를 신호가 없다. 이는 충분히 큰 L이라는 정리를 반박하지 않지만 ‘모든 prompt 길이에서 attention은 PCA’라는 요약을 반박한다.
유한 prompt를 기대값으로 평균한 population flow와 실제 SGD는 여전히 다르다. 실험은 이론과 정성적으로 맞는 예시이지 임의의 유한 학습 표본·step·반복 수에 대한 동일 보증이 아니다.
6. 선형 attention과 출력 분포가 보여주는 것
6.1 Softmax 없이도 같은 극한이 나온다
선형 attention은 정규화 지수 대신 점수를 직접 사용한다.
T_{L,\mathrm{lin}}^\mu(X)_1=\frac\lambda L\sum_{k=1}^{L}(X_1^\top\mu)(\mu^\top X_k)X_k.그 극한도 \lambda\Sigma\mu\mu^\top X_1이다. 부록 Proposition 14는 유한 L의 population risk도 정확히 계산한다.
R_{\mathrm{lin},L}=\operatorname{tr}\Sigma-\frac{2\lambda}{L}(\operatorname{tr}\Sigma)a-\frac{2\lambda(L+1)}L b
+\frac{\lambda^2(L+2)}{L^2}(\operatorname{tr}\Sigma)a^2
+\frac{\lambda^2(L+2)(L+3)}{L^2}ab.
Proposition 15는 최적 파라미터 방향이 u₁이고 유한 L에 따라 그 크기가 달라짐을 보인다. 충분히 큰 L에 기대어 지형을 비교하는 softmax 분석과 달리 여기서는 닫힌식에서 직접 방향을 구한다. 따라서 유한 linear 학습의 정렬 곡선이 L에 따라 달라진다고 해서 population 최적 방향 자체가 다른 고유벡터로 돌아간다고 해석하지 않는다. 유한 step·SGD·스케일의 영향도 남는다.
6.2 분포 수렴은 실제 표본의 정확한 투영과 다르다
고정 μ에서 무한 출력의 공분산은
\Gamma(\mu)=\lambda^2(\mu^\top\Sigma\mu)(\Sigma\mu)(\Sigma\mu)^\top.최적 μ에서는 \Gamma=\sigma_1u_1u_1^\top이 되어 첫 주성분으로 투영한 Gaussian 법칙을 얻는다. Corollary 1은 같은 파라미터로 finite 출력과 infinite 출력의 제곱 Wasserstein 거리를 제어한다. 무한 최적점 μ⋆에 대입한 상한은
W_2^2=O\!\left(L^{-1/145}(1+\ln L)^{144/145}\right).이는 W_2 자체의 속도도, 학습된 finite μ의 추정 오차율도 아니다. 또한 흔한 L^{-1/2} 정밀도 보장으로 바꾸면 안 된다. 논문도 관측 수렴이 이 보수적인 상한보다 훨씬 빠르다고 적는다. 숨은 상수와 작은 지수 때문에 이 식을 실용적인 최소 prompt 길이 공식으로 쓰기는 어렵다.
7. 공유 spike 학습은 새로운 문제의 PCA와 다르다
각 prompt의 공분산을
\Sigma\sim W_d(V,n),\qquad V=\xi^2I+\theta vv^\top,\quad\|v\|=1에서 뽑고 그 위에서 Gaussian 토큰을 생성한다. 부록의 조건은 ξ², θ, λ>0과 n≥d이다. 학습 risk는 Σ까지 평균한 \mathbb E_\Sigma R^{(\Sigma)}(\mu)이다. 표준 비정규화 Wishart라면 \mathbb E\Sigma=nV이며 V 자체가 평균 공분산은 아니다.
논문은 infinite risk의 두 전역 최소가 \pm\alpha_\star v이고 generic 초기화가 그쪽으로 수렴한다고 보인다(Proposition 19). 각 Σ의 고유벡터는 달라도 공통 v는 학습 분포 전체에서 고정이다. 따라서 이것은 공유 잠재 방향을 파라미터 학습으로 찾는 결과다. 고정된 μ가 처음 보는 임의의 새 v를 각 prompt에서 알아내는 universal in-context PCA 정리가 아니다.
출력 방향도 구분해야 한다. μ=αv로 학습했더라도 개별 prompt의 infinite 출력은 \lambda\alpha^2\Sigma vv^\top x다. 일반적인 Wishart 실현에서는 Σv가 v와 평행하지 않다. 파라미터가 spike에 정렬됐다는 사실만으로 모든 prompt 출력이 v로의 직교 투영이라고 말할 수 없다.
작은 ξ²에서 국소 수렴률이 ξ²와 θ에 비례한다는 분석도 있다. ξ²=0은 가정 밖이며, ‘잡음을 계속 많이 넣을수록 항상 학습이 빨라진다’는 단조 결과가 아니다. n에 관한 스케일도 정규화하지 않은 Wishart 공분산의 크기 변화와 함께 읽어야 한다.
8. ICL 정지점의 회전 대칭과 증명상의 공백
이 항목은 저자가 인정한 한계의 인용이 아니라 원문 식을 대조한 리뷰어의 검토다. 고정 Σ·simple spectrum의 분석과 구분한다.
Lemma 13은 infinite ICL risk가 r^2=|\mu|^2, \alpha^2=\langle\mu,v\rangle^2만의 함수라고 한다. 그 gradient는
\nabla R=2\{A(r,\alpha)\mu+B(r,\alpha)\alpha v\},\qquad
A=a_1r^2+a_2\alpha^2-a_3.
따라서 α=0이고 r^2=a_3/a_1이면 v에 수직인 어떤 방향도 정지점이다. d≥3에서 이 집합은
\{\mu:\mu\perp v,\ \|\mu\|=\sqrt{a_3/a_1}\}\cong S^{d-2}라는 연속 구면이다. Proposition 19도 이 점들에서 d−2개의 영 Hessian 고윳값을 직접 제시한다. 음의 고윳값이 있으므로 strict saddle이라 부르는 것 자체는 가능하지만, 비퇴화·고립 임계점이라는 뜻은 아니다.
그런데 본문 p.9와 Proposition 20(p.42)은 직교 임계점을 2(d−1)개로 열거하고, 각 점 주위에 다른 임계점이 없는 작은 공을 잡는다. d≥3의 위 구면에서는 그런 공을 잡을 수 없다. 예컨대 d=3이면 원 위의 각도를 연속적으로 바꿔 모두 정지점을 만들 수 있다.
이는 기재된 finite ICL 전이 증명의 보완이 필요한 부분이다. 전체 구면을 덮는 근방과 횡방향 곡률을 이용하는 별도 논증 등이 필요하지만, 이 리뷰에서 완전한 대체 증명을 제시하지는 않는다. 이 문제만으로 ±α⋆v의 최소성이나 실험상의 정렬이 틀렸다고 결론내려서도 안 된다. 다만 Proposition 13·20의 finite ICL 수렴 주장을 아무 유보 없이 완결된 고립점 섭동 정리로 소개하지 않는다.
별개의 표기 문제도 있다. Lemma 12(3), p.38의 좌변에는 Σ² 항이 두 번 등장하지만, 해당 증명과 Lemma 13에서 쓰는 것은 (\mu^\top\Sigma\mu)(\mu^\top\Sigma^2\mu)의 기대값이다. 이 글은 risk를 전개하는 실제 항을 기준으로 읽으며, 인쇄된 식의 불일치를 새 정리로 해석하지 않는다.
9. 실험이 보여주는 정렬과 보여주지 않는 것
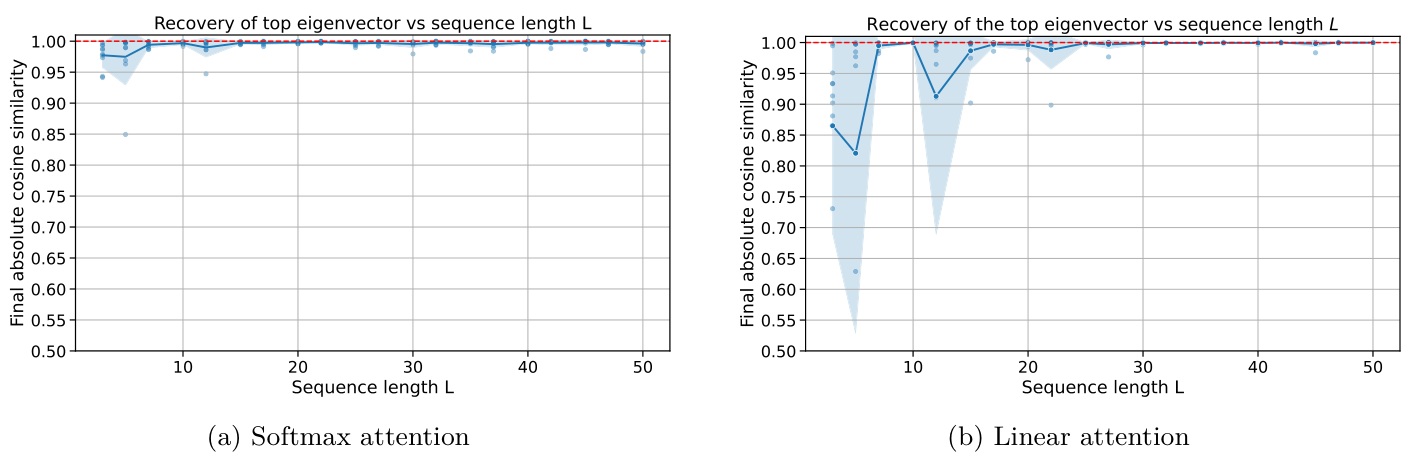
Figure 5. 같은 세로축이라도 두 모델의 λ는 다르다. 작은 L에서의 흔들림과 더 긴 L에서의 높은 정렬을 보여 준다. 출처: Maulen-Soto & Boyer (2026), v2, p. 46, Fig. 5 — 연구·학습 목적 인용.
| 실험 | 본문·부록에 적힌 조건 |
|---|---|
| 기본 covariance | Σ=AAᵀ+0.1I, A는 표준 Gaussian 행렬 |
| 기본 학습 | γ=10⁻⁴, batch 256, 10회; finite는 새 prompt를 뽑는 SGD, infinite는 알려진 Σ의 analytic GD |
| Linear 예시 | d=5, L=6, λ=0.01 |
| L sweep | d=5, L=3–50의 20개 값, 5,000회 반복, 조건당 10 runs; softmax λ=0.1, linear λ=0.001 |
| d sweep | 3–100 범위에서 5 간격이라고 서술; 5,000회, 10 runs; learning rate·λ도 d에 따라 변경 |
| ICL 예시 | d=5, ξ=1, θ=2, n=10; finite는 covariance 100개와 covariance별 data 100개로 Monte Carlo 근사 |
| ICL L·d sweep | 각각 3,000·2,000회; d sweep은 n=d, γ=0.5/d², λ=0.1/d |
Appendix D, pp.43–48. ‘3에서 100까지 5 간격’은 100을 반드시 포함하는 격자를 뜻하지 않으므로 정확한 끝점 배열로 재작성하지 않는다.
관측 지표는 |\langle\mu/|\mu|,u_1\rangle| 또는 v와의 절대 코사인이다. 이는 방향 정렬이지 최적 norm·재구성 오차·downstream 정확도와 동일하지 않다. Infinite GD는 Σ 또는 V를 직접 사용하는 비교라 실제 prompt만으로 covariance를 추정하는 비용까지 동일한 baseline도 아니다. Oja·power iteration·SVD와 같은 예산의 속도·정확도 경쟁을 한 논문으로 읽지 않는다.
차원 sweep에서는 d 외에 covariance·step·λ, linear의 L도 달라진다. 따라서 d의 순수 인과 효과나 고차원 통계적 임계현상을 분리한 결과가 아니다.
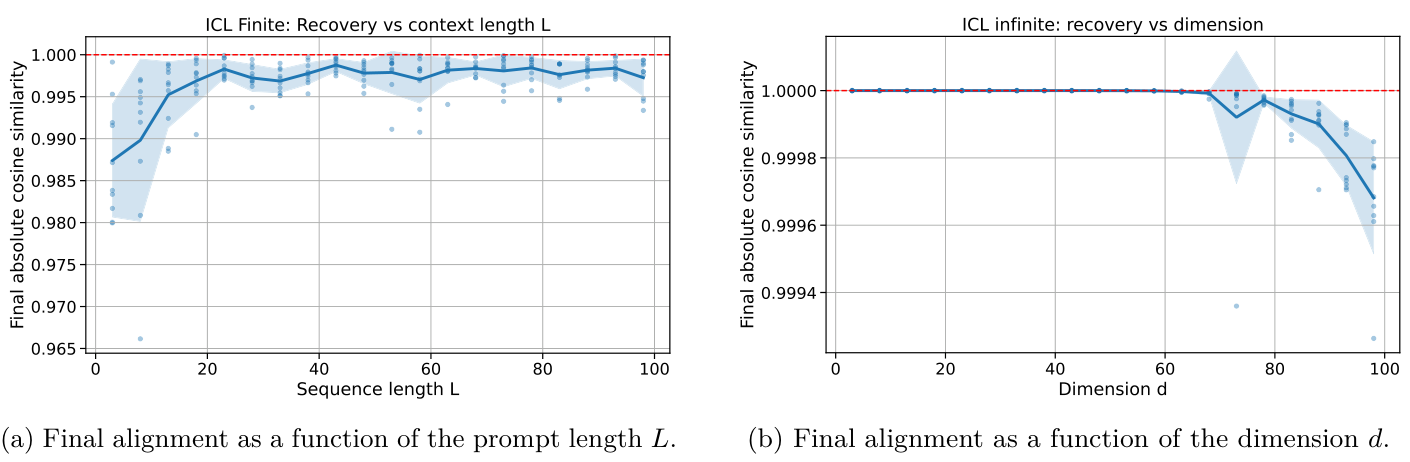
Figure 8. 좌우 패널의 세로축 범위가 다르다. 특히 오른쪽은 1 부근을 크게 확대한다. 출처: Maulen-Soto & Boyer (2026), v2, p. 47, Fig. 8 — 연구·학습 목적 인용.
공개 코드에서 확인한 한 가지 차이
부록 D.1은 초기화를 단위구면에서 뽑는다고 설명한다. 그러나 확인한 고정 revision의 softmax_finite.py는 μ를 0.1 * random.normal(...)로 초기화하고 실제 update 전에 단위 norm으로 맞추지 않는다. 정규화는 alignment 기록에 사용한다.
Gaussian 초기화도 방향 분포는 균일하지만 norm 분포는 다르다. 이 risk는 norm에 의존하므로 완전히 같은 실험 조건이라고 할 수 없다. 이것은 해당 공개 파일과 문서의 차이이며 모든 실험이 잘못됐거나 정리의 generic initialization 조건을 어겼다는 뜻은 아니다. 해당 파일은 d=5·L=100·batch 256·γ=10⁻⁴·λ=0.1·3,000 steps·10 runs를 지정한다. 코드를 실행하거나 이 파일이 출판 도판을 정확히 생성했는지는 검증하지 않았다.
10. attention이 PCA를 한다는 말의 적용 범위
저자 설정과 명시적 유보
- Gaussian·단일 rank-one head·재구성 목적·population risk를 선택했다.
- Gradient flow를 중심으로 분석하며 실험은 SGD/GD로 예시한다.
- 충분히 큰 L의 이론 상한은 실험보다 보수적이라고 설명한다.
- Spiked covariance 분석도 ‘to some extent’ ICL이라는 제한된 표현으로 도입한다.
리뷰어의 종합 판단
가장 명확한 기여는 Gaussian softmax의 정확한 선형 극한, 사차 risk의 지형, 최적 attention 출력과 rank-one PCA 투영의 일치다. 이를 바탕으로 finite prompt의 최적화·분포 수렴을 연결하는 시도도 가치가 있다.
다만 세 가지 구분은 끝까지 유지해야 한다. 첫째, score의 rank-one 제약과 출력의 rank-one 성질은 다르다. 둘째, finite prompt와 finite training data, population flow와 실제 SGD는 다르다. 셋째, 공유 spike를 파라미터로 학습하는 것과 처음 보는 각 문제의 PCA를 prompt 안에서 수행하는 것은 다르다.
추가로 ICL 부록의 직교 정지점 집합은 회전 대칭 때문에 비고립이다. 그 점을 잘못 열거한 finite 전이 논증과 공개 코드의 초기화 차이를 남겨 두지 않고 검토해야 한다. 그렇다고 고정 Gaussian covariance의 핵심 항등식과 최적점까지 한꺼번에 부정할 근거는 아니다.
따라서 이 연구는 특정 비지도 목적 아래 학습한 단순 attention이 PCA의 스펙트럼 구조를 회복한다는 이론적 연결로 평가하는 것이 정확하다. 일반 언어 모델의 attention 해석, SVD 대체 효율, 모든 in-context 추론의 보편적 설명으로 확장하는 것은 별도의 문제다.
References
Maulen-Soto, R., & Boyer, C. (2026). Attention-based PCA (arXiv:2605.18315v2). https://arxiv.org/abs/2605.18315v2
Maulen-Soto, R. (2026). Attention_based_PCA: softmax_finite.py implementation, revision 60510b40b284805cbd94c794ac3fa3ea3e64f598, softmax_finite.py. https://github.com/rodrigomaulen/Attention_based_PCA
선행 연구 범위: Oja·Gaussian attention의 measure-based 해석·PCA 문헌과의 관계는 대상 논문의 설명을 따른다. 해당 선행 논문 전체를 별도로 감사한 것은 아니다. 공개 저장소에서는 위 단일 파일을 읽었으며 실험 재실행·전체 구현 감사를 수행하지 않았다.