Cogentic: Multi-Agent Orchestration for Automated Proof Discovery
Cogentic은 여러 증명 후보를 병렬로 만들고 반박을 교차 검토하며, 다시 확인한 보조정리를 다음 탐색에 넘기는 연구용 하네스다. 다섯 수학적 성과의 조건과 자연어 비평·전문가 확인·형식 검증의 차이를 살펴본다.
Paper: Yang Cai; Vineet Gupta; Yanchen Jiang; Christopher Liaw; Aranyak Mehta; Grigoris Velegkas; Di Wang (2026). Cogentic: Multi-Agent Orchestration for Automated Proof Discovery. Google Research; Yang Cai는 Yale University, Vineet Gupta는 Google DeepMind에도 소속되어 있다. arXiv:2609.40324v1, 2026-09-30. PDF · 서지 정보 · 프로젝트. 실제 문제 프롬프트를 수록한 부록까지 포함해 17쪽을 읽는다.
Abstract: 열린 수학 문제에서는 후보 하나를 만드는 것보다 여러 방향을 시도하고, 잘못된 논증을 버리며, 유효한 중간 결과를 다음 시도로 넘기는 일이 중요하다. Cogentic은 이를 연구팀처럼 나눈다. 오케스트레이터가 자원을 배정하고 prover들이 병렬로 후보를 쓰며, 개별·교차 검토가 초안을 비판한다. 실패 기록과 다시 검토한 보조정리를 다음 라운드에 넘긴다. 논문은 온라인 학습·경매·메커니즘 설계에서 다섯 성과를 보고하지만, 이는 성공률을 측정한 벤치마크나 형식 증명 커널의 검증 결과가 아니다. 시스템의 역할 분리, 정리의 적용 조건, 사람의 문제 설정·사후 보강, 공개 증거의 범위를 나누어 살펴본다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 핵심 문제 | 긴 탐색에서 같은 오류를 반복하지 않고 검토한 부분 성과를 축적할 수 있는가? |
| 구조 | 방향 배정 → 개별 briefing → 병렬 증명 → 개별·교차 검토 → record·ledger·지시 갱신. |
| 검증의 뜻 | 모델의 자연어 비평과 이후 전문가 확인이다. Lean 같은 형식 증명 커널의 보장이 아니다. |
| 성과 | 효율적·proper O(d) 역최적화, 작은 시장 쪽 두 명 추가, 다수 전문가의 anytime 선도상수, 수익 근사 3.52, autobidding PoA 개선. 모두 저자 보고다. |
| 자율성 | 실행 중 수학적 개입이 없었다는 보고와 별개로 입력에는 목표 정리·참고문헌·메커니즘·가정이 있다. 사후 수정도 있다. |
| 계산 예산 | 대부분 O(100), 가장 어려운 문제 O(1000) Gemini 호출이라는 규모다. 정확한 호출 수·토큰·시간·총비용은 아니다. |
| 주요 경계 | 요청한 factor 3 대신 얻은 수익 보장은 3.52다. 일반 n autobidding 결과에는 undominated bids 조건이 있다. |
| 판단 | 연구 탐색을 조직하는 설계와 사례는 유의미하다. 다섯 성공으로 성공률·구성요소의 인과 효과·완전 자율성을 확정하지 않는다. |
읽기 안내: 정리와 선행 결과는 저자 보고다. 이 글의 분수·비율 계산은 설명용 검산이다. 동반 논문 다섯 편의 서지·초록도 확인했지만 전체 증명을 독립적으로 재증명하거나 시스템을 실행하지 않았다. ‘verified’라는 운영상 명칭과 오류가 불가능하다는 보장을 구별한다.
목차
- 증명 한 번보다 연구 과정의 상태가 중요하다
- 연구팀을 역할과 라운드로 나눈다
- 거부된 증명에서도 검토할 조각을 남긴다
- 문제문만 주었다는 표현의 범위
- 역최적화에서 시간에 무관한 효율적 후회 한계
- 작은 시장 쪽 두 명 추가의 정확한 의미
- 종료 시점을 몰라도 선도상수를 맞춘다
- 단순 판매의 보장을 개선하되 목표와 구분한다
- 자동입찰의 최적상수와 조건부 일반화
- 성과의 타당성과 시스템의 효과는 다른 질문이다
1. 증명 한 번보다 연구 과정의 상태가 중요하다
부등식을 증명하려고 세 가지 방법을 시도했다고 하자. 첫째는 반례가 나왔고, 둘째는 마지막 단계만 틀렸으며, 셋째는 유효한 보조정리를 남겼다. 다음 시도에 세 대화의 전문을 넣는 것과, 실패 이유·살아남은 결과·남은 공백을 구분해 넘기는 것은 다르다.
Cogentic은 후자를 위한 multi-agent harness다. 새 모델 구조나 RL 학습법이 아니라 증명 후보를 만들고 비판하고 재사용하는 실행 조직이다. 정해진 답을 투표로 고르는 과정만으로 설명되지 않는다. 중간의 주장·상수·구성·반례를 바꾸며 탐색할 수 있기 때문이다.
Self-Organizing Agent Teams는 과거 문제에서 협업 전략 bank를 학습해 동결한다. Cogentic의 advisor는 현재 연구 문제의 여러 라운드에서 지시를 조정한다. Context Language Models가 live context 자체를 편집한다면, Cogentic은 공유 디스크의 연구 산출물을 선택적 briefing으로 전달한다. 같은 문맥 편집 구현을 쓴다는 주장은 아니다.
프로그램·구조 탐색은 후보를 싸고 충실하게 평가하는 기계적 점수가 있을 때 강하다. 하지만 모든 증명 문제가 그런 평가기로 환원되지는 않는다. Cogentic은 사람이 읽는 논증을 생성하고 모델이 읽어 비판한다. 적용할 수 있는 문제는 넓어지지만, 그만큼 판정의 신뢰성이 중요한 문제가 된다.
2. 연구팀을 역할과 라운드로 나눈다
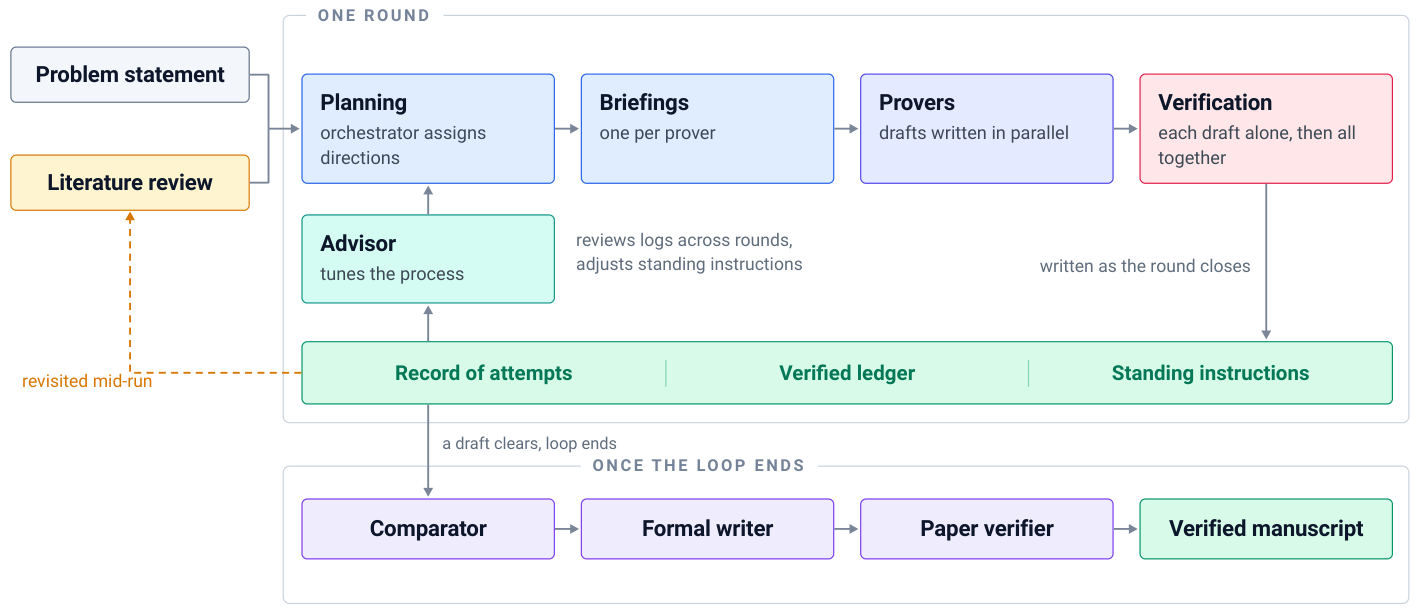
Figure 1. 각 라운드가 남긴 시도 기록·보조정리·지시를 다음 라운드가 읽는다. 그림은 통과 시 종료로 단순화하지만 §2.5는 더 나은 결과를 위한 추가 탐색도 허용한다. 출처: Cai et al. (2026), v1, p. 3, Fig. 1 — 연구·학습 목적 인용.
| 역할 | 하는 일 | 혼동하면 안 되는 경계 |
|---|---|---|
| Orchestrator | 전역 상태, 방향별 prover 수, 실행 순서, 기록 관리 | 직접 수학적 유도를 하지 않는다. |
| Literature reviewer | 정의·정리·관련 연구 탐색, 막힌 단계의 재검색 | 문헌을 가져왔다는 것만으로 정확한 인용이 보장되지는 않는다. |
| Summarizer | 이전 시도·판정을 골라 prover별 briefing 작성 | 전체 이력을 모두 전달하지 않는다. 긴 문서는 경로로 준다. |
| Prover | 배정된 주장·반례·수선 방향에서 독립적으로 논증 | 병렬 호출이 통계적으로 독립적인 오류를 보장하지 않는다. |
| Verifier | 초안 단독 검사와 라운드 전체 교차 검사 | 서로 다른 범위의 검토이지 논리 커널이 아니다. |
| Auditor | 부분 결과를 자립형 보조정리로 고쳐 단독 재검증 | 원래 맥락의 가정이 빠지지 않아야 한다. |
| Process advisor | 반복 오류·검토 누락을 찾아 지시와 자원 배분 조언 | 수학적 의견·기법 추천·방향의 유망성 선언은 금지된다. |
| 최종 정리 단계 | comparator → formal writer → paper verifier | 여기서 formal writer는 완전한 수학 원고 작성자이지 Lean 변환기가 아니다. |
§§2.1–2.5, pp. 3–5. Figure 1 캡션은 briefing 작성자를 advisor라고 부르지만 §2.1의 구체적 설명은 별도 summarizer다. 이 글은 후자를 기준으로 역할을 나눈다.
방향은 ‘상수를 더 낮추기’, ‘반례 찾기’, ‘유망한 증명의 공백 수선’처럼 무엇을 알아낼지를 지정한다. prover는 어떻게 풀지는 스스로 정한다. 각각의 summarizer가 같은 이력에서 다른 정보를 골라 주어 탐색 경로가 한곳으로 쏠리는 것을 줄이려 한다.
오케스트레이터와 advisor의 수학적 의견을 막는 것은 관리자가 미리 한 답을 밀어붙이지 않게 하는 설계로 읽을 수 있다. 그러나 방향 배분과 수학적 유망성 판단을 실제로 어떻게 분리·강제하는지, 그 규칙이 효과가 있는지는 별도 검증되지 않았다. 본문의 종료 설명이 ‘더 좋은 결과를 낼 유망한 방향’을 언급하는 점도 실제 운영 규칙을 확인할 이유다.
3. 거부된 증명에서도 검토할 조각을 남긴다
3.1 두 검토의 통과는 투표와 다르다
각 초안은 자신만 읽는 verifier와 같은 라운드의 모든 초안을 함께 읽는 verifier를 둘 다 통과해야 한다. 후자는 여러 초안이 공통으로 생략한 논리나 공유하는 잘못된 가정을 발견할 수 있다. 지침은 모든 단계와 인용이 틀렸다고 가정하고 확인하라는 adversarial 자세다.
이 설계는 상호 칭찬에 그치는 검토를 막으려는 시도다. 그러나 verifier들이 같은 기반 모델을 사용하면 공통 오류가 남을 수 있다. 둘을 통과했다는 사건의 오류확률을 개별 오류확률의 곱으로 계산할 근거도 없다. 모델 구성·불일치 처리·false accept 비율은 보고되지 않는다.
3.2 Record와 ledger는 서로 다른 기억이다
- Record: 무엇을 증명하려 했는지, 쓴 방법, 실패한 반론을 보관한다.
- Verified ledger: 검토를 통과한 보조정리와 반례에 의해 배제된 경계를 보관한다.
전체 증명은 거부돼도 일부 보조정리는 맞을 수 있다. auditor가 그 조각을 독립적으로 읽을 수 있는 명제로 다시 쓰고 따로 재검증한 뒤 ledger에 올린다. 이후 prover는 이를 다시 증명하지 않고 사용할 수 있다.
이것은 실패에서도 부분 성과를 얻는 장점이 있다. 반대로 잘못된 보조정리가 한 번 들어가면 후속 증명들이 그 오류를 공통 전제로 삼을 수 있다. 가정·의존관계·판본·기각과 철회 기록을 어떻게 보존하는지, 오류가 발견됐을 때 영향을 받은 결과를 어떻게 무효화하는지는 논문에 구체화되어 있지 않다. 이는 해설자의 재현·운영 질문이며 실제 ledger 오염을 관찰했다는 뜻은 아니다.
GraphCert의 인증도 범위를 제한해서 읽어야 하지만, 그쪽은 그래프 질의 실행과 구조적 근거 검사를 포함한다. Cogentic의 자연어 증명 ledger를 같은 종류의 실행 인증으로 부르면 안 된다.
3.3 최종 원고도 별도 오류 경로다
통과한 후보에서 comparator가 가장 강한 증명을 고르고 writer가 표기·배경·보조정리를 갖춘 원고로 확장한다. paper verifier는 설명 과정에서 오류가 추가되지 않았는지 승인된 증명과 대조한다. 탐색이 끝났다고 서술까지 자동으로 정확해지는 것은 아니라는 점을 설계에 반영했다.
4. 문제문만 주었다는 표현의 범위
논문은 문제 statement만으로 expert hint 없이 작동하며 실행 중 수학적 인간 개입이 없었다고 설명한다. 이를 사람이 연구 질문·추측·관련 지식을 전혀 제공하지 않았다는 뜻으로 읽기 전에 Appendix A를 볼 필요가 있다.
| 입력 | 실제로 제공된 내용 |
|---|---|
| 역최적화 | 단위구·분리 오라클·누적 손실·시간 독립 목표와 특정 선행 논문 |
| 양면시장 | STR이라는 메커니즘, FSD 조건, 판매자 두 명 추가라는 정확한 목표 정리 |
| Anytime experts | 기존 두 전문가 논문과 n이 커질 때 price가 1로 가는 conjecture |
| 판매 수익 | factor 3 목표, 참고문헌 두 편, 안 되면 factor 4부터 강화하라는 지시 |
| Autobidding | 두 입찰자의 메커니즘과 1.5 추측, 일반 n의 목표 형태, 양의 가치 가정·관련 논문 |
Appendix A, pp. 14–17. 이 프롬프트들은 리뷰 작성 지시가 아니라 분석 대상이다.
추측을 제시하는 것과 그 증명을 알려 주는 것은 다르다. 따라서 이 목록만으로 시스템이 증명을 찾지 않았다고 결론내리면 부당하다. 다만 문제 설정의 인간 기여가 없었다는 강한 해석은 배제된다. 특히 factor 4부터 시도하라는 지시는 탐색 전략의 일부다.
Autobidding 부록은 처음 넣었던 mild assumption을 제거하도록 생성된 증명을 Gemini에 다시 주어 수정했다고 밝힌다. 일반 n의 메커니즘과 분석은 시스템이 독자적으로 냈다는 저자 보고도 함께 보존해야 한다. 최초 실행과 사후 수정 요청을 합쳐 완전한 무개입 과정으로 표현하지 않는다.
Discussion은 저자들이 증명을 확인하고 문헌상 위치·기법 설명을 보강했으며, 일부 결과는 harness 산출보다 더 발전시켰다고 명시한다. 따라서 문제 설정, 실행 중 탐색, 후속 검증, 최종 동반 논문의 기여는 별개다. ‘독립적인 전문가 확인’도 저자와 무관한 외부 집단의 블라인드 재현이라고 확인된 것은 아니다.
5. 역최적화에서 시간에 무관한 효율적 후회 한계
5.1 행동을 보고 숨은 목적을 따라간다
단위구 안의 숨은 벡터 w^가 전문가의 선형 목적을 나타낸다. 매 시점 compact 행동 집합 X_t가 주어지면 학습자는 \hat x_t를 추천하고, 전문가가 고른 x_t를 본다. 목적의 실제 값이나 w^는 보지 못한다. 누적 shortfall은 다음과 같다.
R_T=\sum_{t=1}^{T}\langle w^*,x_t-\hat x_t\rangle.Proper 학습자는 행동 메뉴를 보기 전에 0이 아닌 추정 목적 \hat w_t를 정하고, 그 목적을 최대화하는 행동을 추천한다. 어떤 행동을 택했는지뿐 아니라 그 행동을 설명하는 목적을 내놓는 제약이다.
5.2 처음인 것은 O(d) 자체가 아니라 효율성과 properness다
Theorem 1은 결정론적·proper·anytime 알고리즘으로 모든 T에 대해 R_T=O(d), 라운드당 O(d²) 산술과 선형 최적화 한 번을 보고한다. 선형 최적화 오라클의 비용까지 무조건 O(d²)라는 뜻은 아니다.
기존 효율적 결과는 O(d ln T)로 시간이 길어지면 누적 손실이 커졌다. T와 무관한 O(d)는 이미 알려졌으나 improper하고 라운드당 T^{\Theta(d)} 비용이 들 수 있었다. 따라서 ‘최초의 유한 다항 regret’이 아니라 효율적인 proper O(d) 보장이라는 차별점이 중요하다.
5.3 증명 아이디어: 계속 커지는 잠재함수를 바꾼다
기존 variable-metric 틀의 rank-one 갱신을 dual-metric 길이로 정규화하고, log det 대신 \mathrm{tr}(H_t^{-1/2})를 쓴다. 이 잠재함수는 d에서 시작해 음수가 되지 않는다. 본문은 s_t=|g_t|_{H_t^{-1}}, \tau=\Theta(1/d)에 대해 다음을 설명한다.
\sum_t s_t^2\le 4d/\tau=O(d^2),\qquad
R_T=O\!\left(1/\alpha+\alpha\sum_t s_t^2\right)=O(d),\quad \alpha=\Theta(1/d).
T가 들어간 로그를 유한한 잠재량 감소로 대체하는 것이 요지다. 이 식의 대입은 스케치를 이해하는 데 도움이 되지만 잠재함수 감소 부등식의 전체 증명을 대신하지 않는다.
논문은 이후 비효율적이지만 tight한 O(√d) 결과가 나왔고, 효율적 O(√d)는 여전히 열린 문제라고 적는다. Cogentic의 O(d)를 차원 의존성까지 최적이라고 부르지 않는다. 동반 논문의 초록도 효율성과 properness를 강조한다.
6. 작은 시장 쪽 두 명 추가의 정확한 의미
구매자 m명과 판매자 n명, m≥n≥1인 양면시장을 생각하자. 구매자의 가치 분포가 판매자 비용 분포를 first-order stochastically dominate한다고 가정한다. 이는 분포 차원의 조건이지 모든 구매자 가치가 모든 판매자 비용보다 크다는 뜻은 아니다.
Theorem 2는 판매자 둘만 더 모집하면 Seller Trade Reduction의 **기대 거래이득(GFT)**이 원래 시장의 first-best 이상이라고 말한다.
\mathrm{STR}(m,n+2)\ge\mathrm{OPT}(m,n).기준은 원래 시장의 최적 거래이득이다. 참가자가 늘어난 시장의 first-best를 완전히 달성한다거나 판매자의 매출이 늘어난다는 정리가 아니다. GFT는 거래로 얻는 가치와 비용의 차이다.
기존의 상수 인원 추가 결과는 양쪽을 모두 늘리고 한쪽당 적어도 20,000명이라는 큰 상수를 사용했다. 새 결과는 더 작은 판매자 쪽 두 명만 추가한다. 같은 운영의 실행시간을 10,000배 줄였다는 식의 해석은 맞지 않는다. 참가자 수의 충분조건을 개선한 것이다.
외부 초록 대조: 동반 논문은 각 측에서 i.i.d.로 뽑은 unit-demand 구매자·unit-supply 판매자를 명시한다. 한 명으로는 부족하다는 하한은 prior-free, DSIC(우월전략 유인정합성), IR(개별 합리성), weak budget balance를 만족하는 메커니즘 클래스에 관한 것이다. Cogentic 본문의 ‘어떤 prior-independent mechanism도’라는 짧은 표현에서 조건을 지우지 않는다. 하한은 이미 m=n=1에서 균일 보장이 불가능하다는 뜻이지 모든 개별 분포에서 한 명이 항상 부족하다는 뜻은 아니다.
7. 종료 시점을 몰라도 선도상수를 맞춘다
전문가 n명의 매 시점 손실은 [0,1]에 있고, 학습자는 전문가들에 대한 분포를 선택한다. 후회는 학습자의 기대 누적 손실과 사후에 가장 좋았던 한 전문가의 손실 차이다.
고정 horizon T를 알면 multiplicative weights의 보장이 \sqrt{T\ln n/2}지만, 기존의 many-expert anytime 보장은 \sqrt{t\ln n}였다. Anytime은 언제 끝날지 모르면서 모든 시점에 보장을 유지하는 조건이다.
Theorem 3의 보고 결과는 다음과 같다.
R_t\le\left(1+O\!\left(\sqrt{\frac{\ln\ln n}{\ln n}}\right)\right)\sqrt{\frac{t\ln n}{2}},\qquad \text{모든 }t\ge1.핵심은 n→∞에서 앞의 오버헤드가 1로 간다는 것이다. 모든 유한 n에서 고정시간과 완전히 같은 minimax regret이라는 뜻은 아니다. 특히 두 전문가에서는 anytime의 차이가 알려져 있어 이를 지워서는 안 된다.
증명 스케치는 기하 격자 horizon H_m=(1+\varepsilon)^m마다 multiplicative-weights 인스턴스를 두고 master가 합치는 방식이다. 모든 인스턴스를 영원히 유지하면 master의 비용이 시간에 따라 늘어난다. 이를 피하려고 인스턴스를 \lfloor\delta H_m\rfloor에 깨우고 \lfloor H_m\rfloor 뒤에 종료한다. 동시에 깨어 있는 수를 O(\varepsilon^{-1}\log\delta^{-1})로 제한하고, 빠진 앞부분을 재귀적으로 처리한다.
본문은 \varepsilon=\sqrt{\ln\ln n/\ln n}, \delta=\varepsilon^3로 격자·합성·재귀의 오버헤드를 합친다. 이는 큰 n에 대한 점근 설명이며 숨겨진 상수로 유한 n의 실제 성능을 계산할 수는 없다. 동반 논문 초록도 같은 전 시점 보장과 점근 조건을 제시한다.
8. 단순 판매의 보장을 개선하되 목표와 구분한다
독립적인 품목 가치를 가진 단일 additive 구매자에게 물건을 판다고 하자. SRev는 개별 고정가격 판매의 최적 수익, BRev는 전체 묶음 고정가격의 최적 수익이다. 복잡한 무작위 메커니즘까지 허용한 OPT와 비교한다.
\mathrm{OPT}\le3.52\max\{\mathrm{SRev},\mathrm{BRev}\}.기존 상수 5.2를 3.52로 낮췄다. 설명용 계산으로 단순 방식이 보장하는 최적 수익의 비율은 약 19.23%(1/5.2)에서 28.41%(1/3.52)로 높아진다. 이는 최악의 경우의 이론적 보장이지 관측한 경매의 평균 매출 증가가 아니다. 알려진 근사비 하한 2와 간극이 남아 3.52가 최적이라는 주장도 아니다.
방법은 기존 duality를 이용해 비선호 품목의 기대 가치만 제한하는 것으로 환원한다. V=\sum_jv_j, M_{\max}=\max_jv_j, M=\max{\mathrm{SRev},\mathrm{BRev}}라 두면 본문은 다음 관계를 제시한다.
\mathrm{OPT}\le\mathrm{SRev}+\mathbb E[V-M_{\max}],\qquad
\mathbb E[V-M_{\max}]\le\mathbb E\!\left[\sum_j\min\{v_j,M\}\right].
기존 SRev 기준의 Core/Tail 분리 대신 BRev까지 반영한 M에서 잘라 단일 기대량을 제어한다. 그 절단합의 이차 모멘트 극값을 분석해 상수를 얻는다. 위 두 식만으로 3.52가 자동 도출되지는 않으며, 상세 논증은 동반 논문에 있다.
부록의 원래 목표는 factor 3이고, 실패하면 factor 4부터 강화하라고 했다. 결과 3.52는 기존 연구를 개선하고 4보다 좋지만 요청한 3을 달성한 것은 아니다. 제목의 ‘open problems resolved or improved’에서 improved에 해당하는 결과를 모두 완전 해결로 바꾸지 않는 것이 중요하다.
9. 자동입찰의 최적상수와 조건부 일반화
9.1 PoA는 낮을수록 좋다
Return-on-spend(RoS) 제약 아래 자동입찰의 Price of Anarchy는 최적 배분의 후생을 비효율적인 균형의 후생과 비교하는 비율이다. 이 문맥에서 1.5는 ‘성능 1.5배’가 아니라 후생 손실의 상한이다.
Cogentic이 다루는 r-proportional first-price auction은 다음 확률로 입찰자 i를 선택하고, 당첨되면 자기 입찰가를 지불한다.
x_{i,j}=\frac{b_{i,j}^{r}}{\sum_k b_{k,j}^{r}}.본문에는 경쟁 입찰이 없으면 무료로 낙찰받는 규칙도 있다. 비례 확률식만으로 경계 사례까지 완전한 메커니즘 명세가 된다고 보지 않는다.
9.2 두 입찰자와 일반 n은 서로 다른 결과다
| 조건 | 메커니즘과 보장 | 최적성의 범위 |
|---|---|---|
| 두 입찰자 | r=1, PoA≤1.5 | 익명·단조 메커니즘 클래스의 하한 1.5와 일치 |
| 일반 n≥2 | r=2n, PoA≤2−1/(4n+1) | undominated bid profiles 조건부; 2에서 줄어드는 항의 차수가 1/n |
Theorem 5, pp. 9–10. 익명·단조 조건과 undominated profiles 표현은 동반 논문 초록에서도 확인했다.
이전 두 입찰자의 보고 상한 1.8을 1.5로 낮춘 것은 명확한 개선이다. 그러나 모든 가능한 비익명 메커니즘이나 다른 제약까지 포괄하는 하한이라고 읽지 않는다.
일반 n에서는 RoS를 지키면서 입찰을 올려 더 얻을 수 없는 undominated 조건을 빼면 안 된다. 기존 하한 2-4/(n+4)는 원문이 짝수 n에 대해 소개한다. 새 상한과 하한은 2에서 빠지는 항의 차수가 같을 뿐 정확한 상수는 다르다. 그 두 감소항의 비율은 4(4n+1)/(n+4)로 큰 n에서 16에 간다. 이것은 PoA 자체가 16배 차이 난다는 뜻이 아니다.
또 n=2를 일반식에 넣으면 17/9≈1.889로, 전용 r=1의 1.5보다 약하다. 일반식은 r=4라는 다른 메커니즘이므로 모순이 아니다.
두 입찰자의 1.5와 비례 메커니즘은 사람이 이미 추측했다고 저자들이 밝힌다. 반면 일반 n의 메커니즘과 분석은 시스템이 독자적으로 찾았다고 보고한다. 초기 양의 가치 가정을 없애기 위한 후속 Gemini 요청은 Appendix A.5에 기록돼 있다. 이 제거를 일반 n의 undominated 조건까지 제거한 것으로 오해하지 않는다.
10. 성과의 타당성과 시스템의 효과는 다른 질문이다
10.1 저자가 명시한 범위와 남은 과제
- 자연어 증명이며 도메인 전문가가 사후 검토했다. Lean 등으로 형식화하는 것은 향후 선택지다.
- 문제들은 저자들의 전문 영역에서 골랐다. 일부 동반 논문의 공저자는 원래 해당 문제를 연구하고 있었다.
- 저자들이 설명·문헌상 위치를 보강하고 일부 결과를 더 발전시켰다.
- 후보 생성이 사람의 검토보다 빨라질 수 있어, 산출량 증가와 인간의 이해 사이의 간격이 남는다.
Discussion, p. 10. 전문가 검토가 있었다는 사실과 검토의 인력·절차·독립성을 외부에서 재현했다는 주장은 다르다.
10.2 해설자 관점에서 더 필요한 증거
| 질문 | 공개된 본문으로 확인할 수 있는 것과 없는 것 |
|---|---|
| 성공률은 얼마인가? | 다섯 성과는 있지만 총 문제·trial·실패·중단 수가 없다. 5/5 성공률로 계산하지 않는다. |
| 어떤 구성요소가 효과적인가? | ledger·advisor·교차 검증 제거 절제와 동일 예산 baseline이 없다. 설계의 기여를 분해할 수 없다. |
| 저렴한가? | O(100)~O(1000) 호출 규모다. 호출 길이·역할별 수·가격·벽시계 시간이 없어 다른 시스템과 비용비를 낼 수 없다. |
| 어떤 모델인가? | 본문은 Gemini라고만 한다. 별도 프로젝트 페이지는 Gemini 3.1 Pro 또는 초기 Gemini 4 Argon이라고 설명한다. 정확한 실행 snapshot과 설정을 재현한 것은 아니다. |
| 검증이 얼마나 정확한가? | false accept·false reject·검토자 간 판정 일치·수정 횟수·최종 오류율이 없다. |
| 독립 재현이 가능한가? | 사용자 문제 프롬프트는 있지만 전체 역할 프롬프트·원시 ledger·대화·실행 설정은 이 논문에 제공되지 않는다. |
수학적 prior state of the art는 새 정리가 무엇을 개선했는지 보여 준다. 하지만 그것이 single-shot Gemini나 단순 반복 샘플링보다 Cogentic이 낫다는 하네스 통제군은 아니다. 강한 수학 성과와 시스템 효과의 인과적 분해는 다른 증거를 요구한다.
논문의 독특한 가치는 실패한 증명에서도 검사 가능한 부분을 남기고, 반론을 다음 탐색의 입력으로 만드는 구체적 운영 방식이다. 반면 ledger의 가정 보존·철회 규칙, verifier의 오류 상관, 인간의 사후 보강은 핵심 경계다. 따라서 이 연구는 전문가가 확인하는 자연어 증명 탐색을 조직한 사례로 평가하는 것이 타당하다. 모든 열린 문제를 자동으로 해결하거나 결과의 soundness를 기계적으로 보증하는 시스템으로 확대하지 않는다.
References
Cai, Y., Gupta, V., Jiang, Y., Liaw, C., Mehta, A., Velegkas, G., & Wang, D. (2026). Cogentic: Multi-Agent Orchestration for Automated Proof Discovery [Preprint]. arXiv. https://arxiv.org/abs/2609.40324v1
동반 논문·외부 자료 확인 범위: 다음은 서지·초록과 프로젝트 페이지를 확인한 자료다. 전체 증명이나 저자 기여를 별도로 감사한 목록이 아니다. 본문 정리 설명의 일차 근거는 Cogentic §§3.1–3.5다.
- Efficient Online Inverse Optimization with O(d) Regret: https://arxiv.org/abs/2609.13440
- The Power of Recruiting the Smaller Side: Two Additional Traders Suffice in Two-Sided Markets: https://arxiv.org/abs/2609.27304
- Prediction with Expert Advice: Anytime Regret with Many Experts Matches the Fixed-Time Constant: https://arxiv.org/abs/2609.27206
- Improved Revenue Guarantees for Selling Separately and Bundling: https://arxiv.org/abs/2609.28873
- Efficiency of Generalized Proportional First-Price Auctions Under Auto-bidding: https://arxiv.org/abs/2609.38698 — Cogentic 참고문헌에서는 Forthcoming으로 표기하지만 프로젝트 페이지에 이 링크가 있다.
- 프로젝트 페이지: https://sites.google.com/view/cogentic — 페이지의 갱신 표기는 2026-09-30이며, 모델 계열 설명은 논문 본문과 구분해 사용했다.