DeepWalk: Online Learning of Social Representations
DeepWalk은 짧은 random walk를 단어열처럼 다루어 노드 임베딩을 학습한다. 희소 라벨 분류의 F1 개선은 당시 데이터·분할·선형 분류기 조건의 결과다.
Paper: Bryan Perozzi; Rami Al-Rfou; Steven Skiena (2014). "DeepWalk: Online Learning of Social Representations". Proceedings of the 20th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 701–710. arXiv:1403.6652 PDF.
한눈에 보기
문장에서는 같은 문맥에 자주 나타나는 단어가 비슷한 뜻을 가질 수 있다. DeepWalk는 이 아이디어를 그래프에 옮긴다. 한 노드에서 시작해 짧은 random walk를 반복하면 노드 ID의 열이 만들어진다. 이를 문장, 노드를 단어처럼 보고 Skip-gram으로 학습하면, 자주 같은 walk 문맥에 등장한 노드는 가까운 벡터가 된다.
그래프 전체를 분해하거나 모든 쌍 거리를 계산하지 않아도 된다는 점이 당시의 실용적 장점이었다. 학습된 벡터는 분류기·군집화·추천 같은 후속 모델의 입력이다. DeepWalk는 분류기나 그래프의 인과 관계를 밝히는 방법이 아니다. 가까운 임베딩은 random walk 문맥의 통계적 유사성이다.
1. 왜 walk를 문장으로 바꾸나
라벨이 적은 소셜 네트워크에서 노드의 연결 구조는 유용하지만, 전통적인 관계 분류는 그래프 전체에 대한 추론이 무거울 수 있다. DeepWalk는 지역 구조를 짧은 walk로 관측하고 그 관측을 연속 벡터로 압축한다. 논문은 저차원 표현, 희소성, 온라인 적응성, 병렬화를 장점으로 제시한다.
‘온라인’이라는 말도 과하게 읽으면 안 된다. 알고리즘은 새로 본 노드의 walk로 중간 표현을 계속 학습할 수 있는 형태이며, 논문은 이를 스트리밍 상황에 맞는 성질로 설명한다. 실제 서비스에서의 지연 시간·재학습 정책·개념 변화 대응을 검증한 시스템 실험은 아니다.
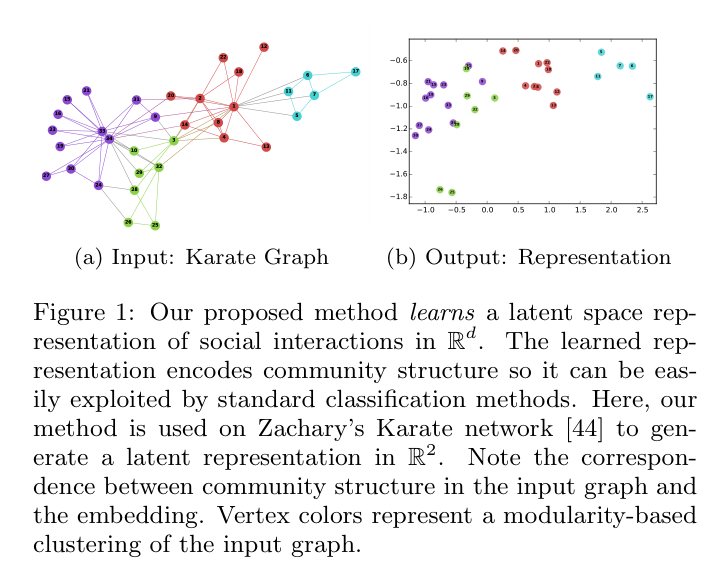
그림 1. Perozzi et al. (2014), Figure 1, arXiv:1403.6652 PDF p. 1의 원도판. Karate network에서 입력 그래프와 직접 학습한 2차원 표현의 군집 예를 비교한다. 본문 분류 실험의 128차원 표현을 투영한 그림은 아니다. 시각적 군집만으로 일반화 성능이나 실제 커뮤니티의 정답을 증명하지 않는다.
2. 알고리즘의 핵심
각 노드에서 짧은 무작위 보행을 여러 번 시작한다. 보행은 방문한 노드 ID의 순서 있는 목록이다. 그 목록에서 하나의 노드를 중심에 놓고 앞뒤의 작은 창에 나타난 노드를 문맥으로 삼는다. Skip-gram 학습은 중심 노드 벡터가 실제 문맥 노드를 잘 예측하도록 값을 조정한다. 일반 학습의 예측 계산에는 Huffman 부호 기반 계층적 softmax를 쓴다.
새 노드가 뒤늦게 들어오는 상황에 대해서는 별도 변형을 제안한다. 앞으로 등장할 노드 수의 상한을 알 수 있다면, 그 크기만큼 트리의 자리를 미리 할당하고 새 노드를 빈 잎에 배정하는 방식이다(§4.4.1). 이는 관측할 때마다 Huffman 트리를 동적으로 재구축했다는 뜻이 아니며, 실제 스트리밍 서비스의 지연·정확도를 검증한 결과도 아니다.
이 설계는 walk가 자주 방문하는 지역성을 포착한다. 직접 연결되지 않은 두 노드도 같은 이웃을 통해 반복해서 나타나면 가까워질 수 있다. 반대로 구조적으로 멀거나 walk에서 만날 기회가 적은 유사 노드는 가까워진다는 보장이 없다. walk 길이, 창 크기, 시작 횟수는 표현의 해상도를 바꾸는 하이퍼파라미터다.
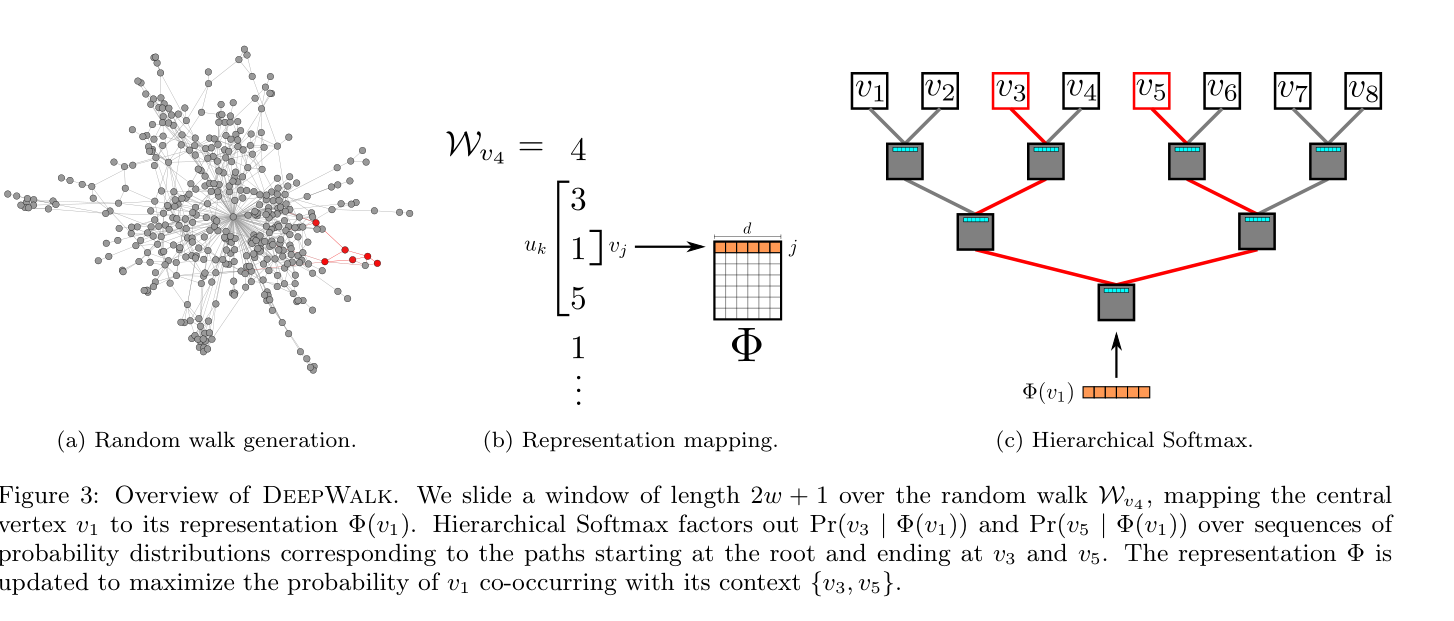
그림 2. Perozzi et al. (2014), Figure 3, PDF p. 5의 원도판. random walk, 노드 표현, Skip-gram 예측의 세 단계를 보인다. walk의 등장 빈도는 의미·원인·신뢰도의 직접 측정값이 아니다.
3. 예로 이해하기
친구 관계 그래프에서 A의 walk가 B·C·D 주변을 자주 지나고, E의 walk도 같은 동네를 자주 지난다고 하자. A와 E는 직접 친구가 아니어도 비슷한 문맥을 공유하므로 임베딩에서 가까워질 수 있다. 라벨이 일부만 있다면, 이 벡터를 one-vs-rest logistic regression에 넣어 관심사 그룹을 예측할 수 있다. DeepWalk는 분류기가 쓰기 쉬운 구조적 특징을 만든다. ‘A와 E가 같은 관심사’라는 라벨을 만든 것은 아니다.
4. 저자 보고 결과
논문은 BlogCatalog, Flickr, YouTube의 다중 라벨 분류를 평가했다. 임베딩 기반 방법의 후속 분류에는 LibLinear one-vs-rest logistic regression을 사용했다(§6.1). 관계 분류 기준선 wvRN과 Majority까지 동일한 LibLinear 분류기를 썼다는 뜻은 아니다. DeepWalk 설정은 노드당 보행 80회, 문맥 창 10, 표현 차원 128이다. 라벨을 무작위로 나누는 실험을 10회 반복해 F1을 비교했다.
라벨이 희소할 때의 이점을 보여 주는 핵심 수치는 YouTube Table 4의 라벨 1% 조건이다. DeepWalk의 Micro-F1 37.95와 EdgeCluster의 23.90 사이 차이는 14.05%포인트, Macro-F1 29.22와 19.48의 차이는 9.74%포인트다. 이는 상대 증가율 14%·10%라는 뜻이 아니다. 라벨 10% 조건에서는 각각 43.05 대 40.07, 35.67 대 31.54로 차이가 2.98·4.13%포인트다.
논문이 말하는 더 적은 학습 라벨로 경쟁 방법을 앞선 사례도 특정 데이터셋과 분할에서의 관찰이다. Table 3의 Flickr 결과를 다른 그래프의 보편적 라벨 절감률로 옮길 수 없다. 이 수치는 그래프·라벨 분포·문맥 창·후속 선형 분류기와 비교 방법의 구현을 묶은 결과이며, 새 데이터의 절대 F1을 보장하지 않는다.
5. 사용할 때의 조건과 한계
DeepWalk는 노드 ID와 그래프 연결만 있어도 시작할 수 있어 간단한 기준선으로 유용하다. 분류 실험에서는 라벨을 가린 노드도 포함한 그래프 구조로 임베딩을 먼저 학습한 뒤, 제공된 라벨 비율로 후속 분류기를 훈련한다. 따라서 이 결과는 새로운 미관측 그래프 전체로의 유도적 일반화 점수가 아니다. 원래 모델은 속성, 방향, 시간, 관계 타입을 명시적으로 구별하지 않는다. 이종 그래프의 ‘저자–논문–학회’ 관계나 시간 순서가 핵심이면, walk 설계나 다른 모델이 그 정보를 넣어야 한다. 또한 고차 walk가 인기 노드에 자주 머물면 표현도 그 방문 분포의 영향을 받는다.
임베딩을 설명에 사용하려면 별도 검증이 필요하다. 가까운 두 점이 보인다는 그림이나 높은 F1만으로 “같은 사회적 이유로 연결됐다”고 말할 수 없다. 라벨이 희소할수록 유용할 수 있다는 논문의 결과도, 대상 그래프에서 label-rate별 재평가로 확인하는 편이 안전하다.
더 긴 알고리즘·표 분석은 심화 보기에서 확인할 수 있다.
References
Perozzi, B., Al-Rfou, R., & Skiena, S. (2014). DeepWalk: Online learning of social representations. Proceedings of the 20th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 701–710. https://doi.org/10.1145/2623330.2623732