해석 한계: 네 항목은 같은 문제의 순위표가 아니다. GCN·GraphSAGE·GNN+는 서로 다른 예측·일반화 조건을 다루고, GNNExplainer는 이미 학습된 모델을 설명하는 사후 방법이다.
각 항목은 원논문에 근거합니다. 입력 그래프를 새로 만드는 방법이 아니거나 예측을 설명하는 기능이 없는 경우에는 ‘해당 없음’으로 표시했습니다. ‘미확인’은 논문에서 확인할 근거가 부족하다는 뜻입니다. 원문 실험의 제약을 모든 적용 상황의 한계로 일반화하지 않으며, GNN의 예측 설명과 GraphRAG의 원문 근거 확인은 구분해서 읽어야 합니다.
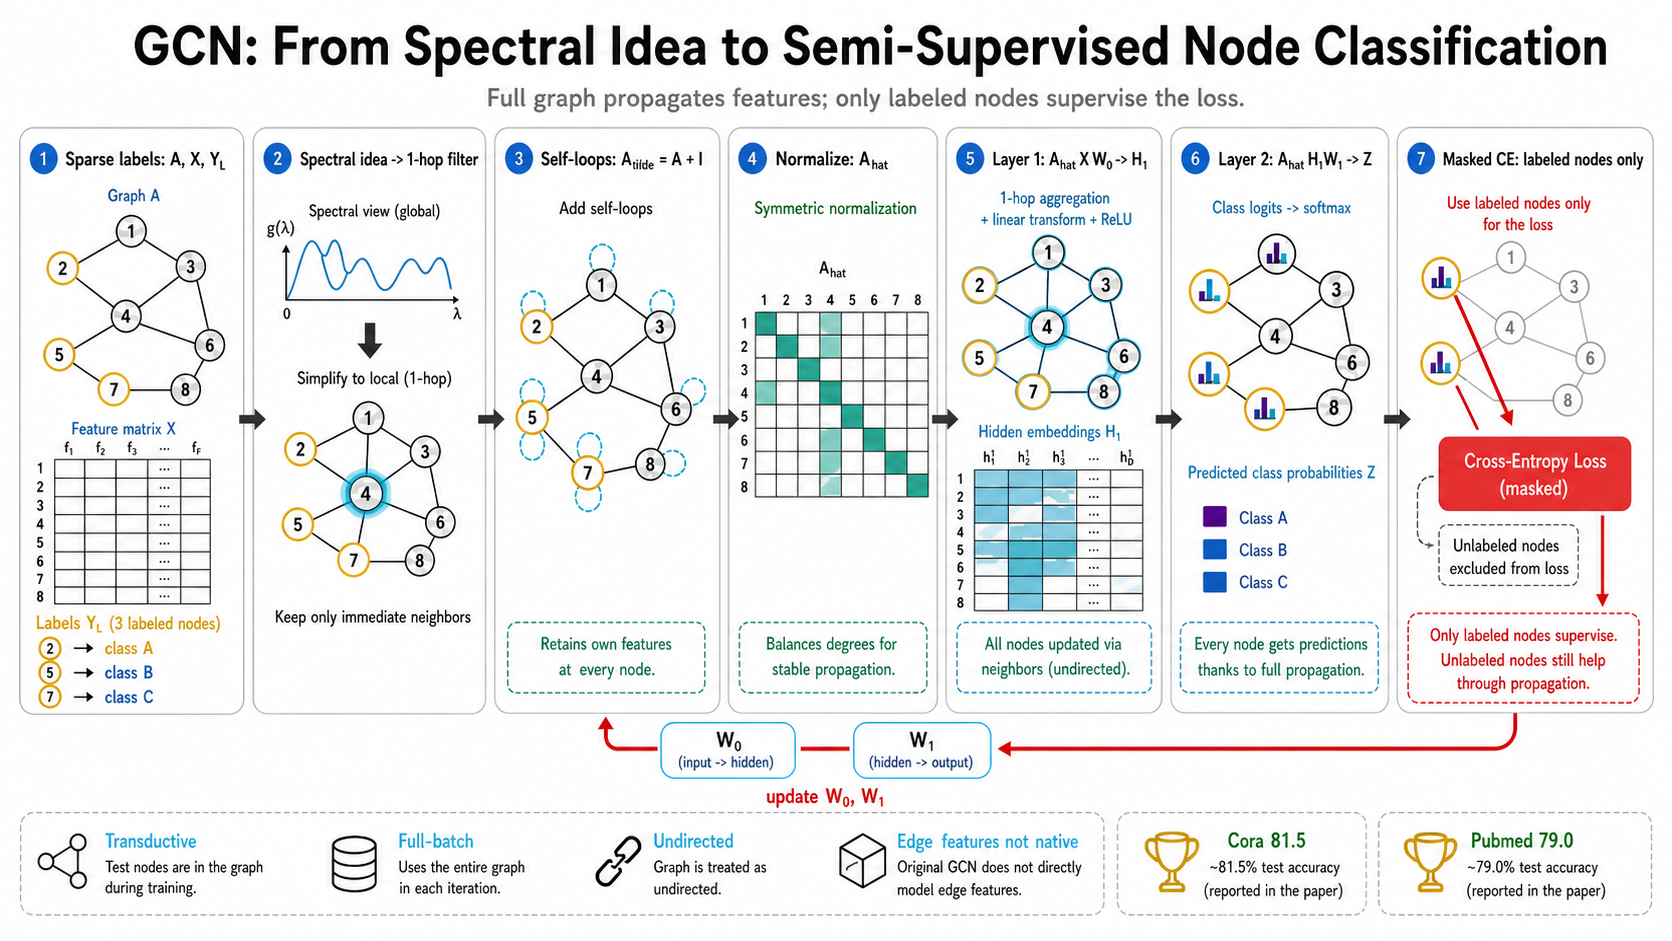
이웃 특징을 집계하는 예측 아키텍처다. 주어진 그래프의 인접행렬과 노드 특징을 정규화된 이웃 집계로 전파해 노드별 표현과 분류값을 만든다.
입력 그래프와 구성
해당 없음GCN은 입력 그래프의 인접행렬을 전제로 하며, 원시 데이터에서 그래프를 만드는 절차를 제안하지 않는다.
평가 조건
고정된 citation·knowledge graph에서 준지도 노드 분류를 평가하고, 전체 그래프를 한 번에 쓰는 full-batch 설정을 사용했다.
설명·근거 확인
해당 없음이 논문은 예측 표현 학습이 목적이며, 개별 예측에 대한 부분그래프·특징 설명 절차를 포함하지 않는다.
비용
희소 인접행렬을 쓰면 한 층의 계산과 메모리가 엣지 수에 선형이지만, 논문 구현은 데이터가 메모리에 들어가는 full-batch 학습을 전제로 한다.
실패 조건
원문의 실험은 고정 그래프와 full-batch 학습 조건이다. §7.2는 메모리 부담을 줄일 mini-batch 확장을 후속 과제로 논의한다. 새 노드·새 그래프에 대한 귀납적 적용은 이 실험으로 검증하지 않았으며, 이를 모든 GCN의 고유 제약으로 일반화하지 않는다.
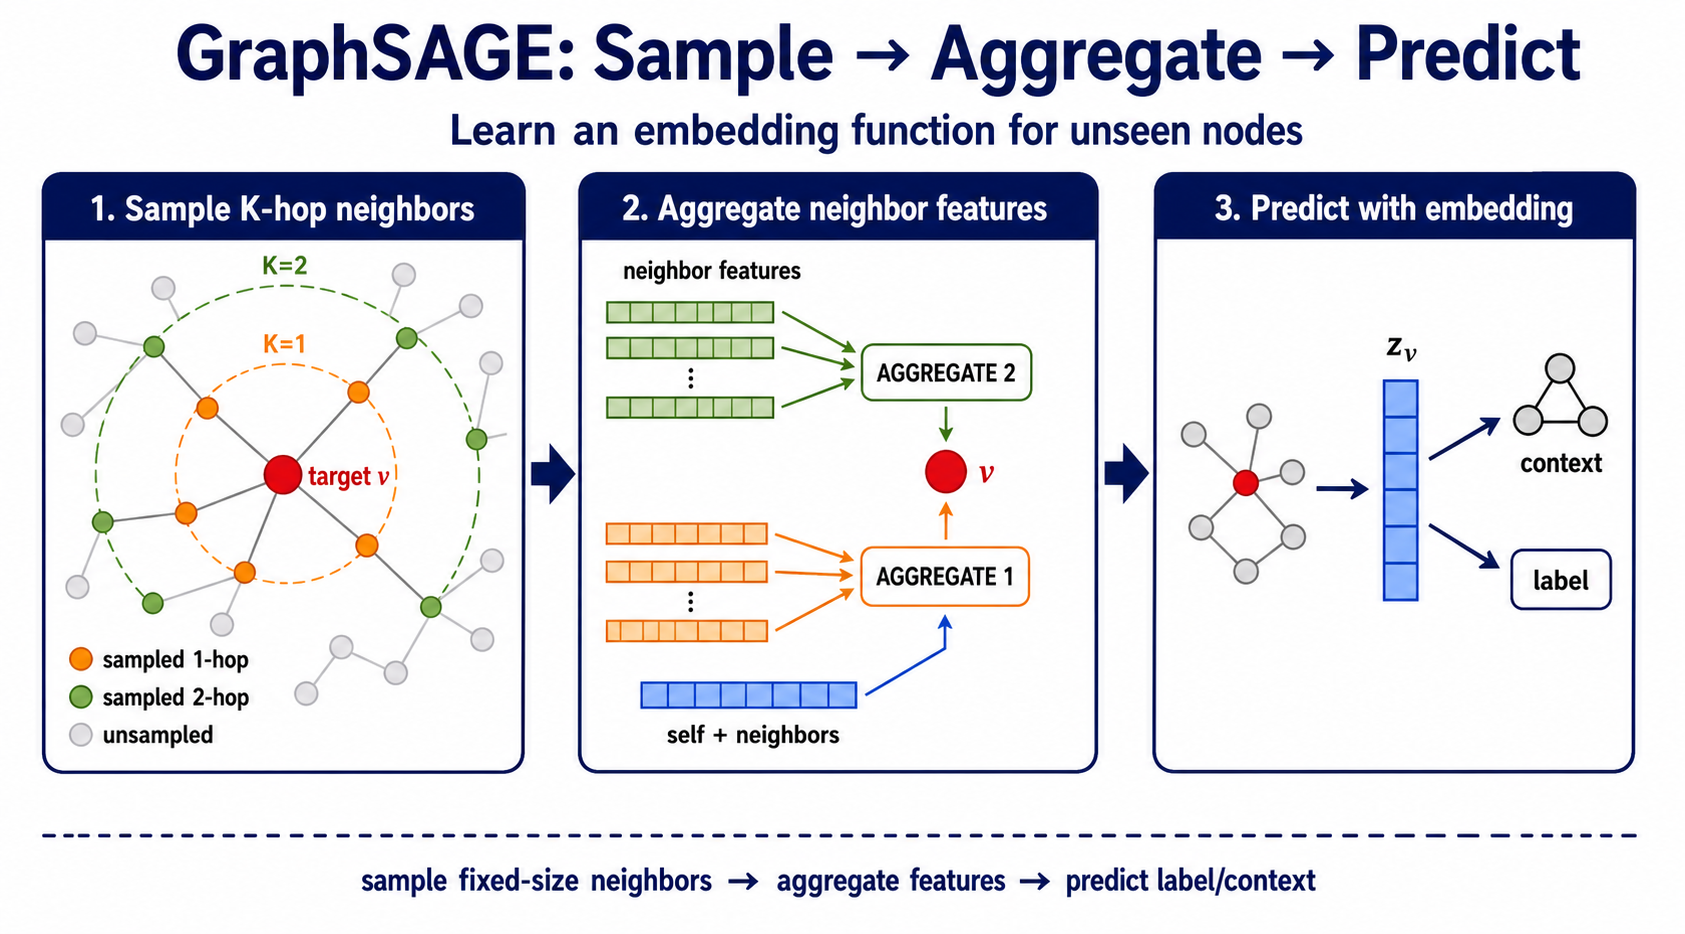
대상 노드의 고정 수 이웃을 샘플링하고 층별 aggregator로 이웃 특징을 합쳐, 보지 못한 노드에도 적용할 수 있는 표현 함수를 학습한다.
입력 그래프와 구성
해당 없음GraphSAGE는 citation·Reddit·PPI처럼 이미 정의된 그래프와 노드 특징을 사용하며 그래프 생성 자체를 다루지 않는다.
평가 조건
시간 뒤의 citation·Reddit 노드와 완전히 보지 못한 PPI 그래프를 대상으로 inductive node classification을 평가했다. 학습 때 없던 노드·그래프에 적용하는 귀납적 설정과 지도·비지도 학습 목적은 별개의 선택이며, 원문은 두 학습 목적을 모두 다룬다.
설명·근거 확인
해당 없음샘플링된 이웃은 계산 입력이지만, 원 논문은 이를 예측 근거 설명이나 인과적 증거로 검증하지 않는다.
비용
이웃 샘플 수로 계산량을 제한해 정확도와 실행시간을 조절한다. 큰 샘플은 수익이 줄고, 깊이가 늘면 필요한 다중-hop 이웃 수가 곱으로 커질 수 있다.
실패 조건
표현 품질은 사용할 수 있는 노드 특징과 이웃 샘플에 의존한다. 원문은 uniform sampling을 사용하며 directed·multi-modal graph와 학습형 sampling은 후속 과제로 남긴다.
기존 GCN·GIN·GatedGCN에 구조·학습 요소를 결합하고 조정하는 기준선 프레임워크다. message passing에 edge feature, normalization, dropout, residual connection, FFN, positional encoding을 결합해 node representation을 만든다. graph-level/property 과제에서는 이를 pooling해 graph representation으로 바꾸고, PATTERN·CLUSTER·PascalVOC-SP·COCO-SP에서는 node-level 출력을 유지한다.
입력 그래프와 구성
해당 없음GNN+는 주어진 분자·superpixel·code graph 등의 학습 블록과 튜닝 기준선이며, 그래프 구축 절차를 제안하지 않는다.
평가 조건
논문의 graph-level study가 묶은 14개 벤치마크에서 세 classic GNN 변형을 재평가했다. 이 가운데 10개는 graph-level/property prediction이고, PATTERN·CLUSTER·PascalVOC-SP·COCO-SP 네 개는 node classification이다. 여기서 graph-level은 그래프 단위 데이터 구성·분할 설정도 포함하며, 예측 출력이 모두 그래프 하나당 하나라는 뜻은 아니다.
설명·근거 확인
해당 없음이 연구는 강한 예측 기준선 구축이 목적이며, 개별 graph prediction의 근거를 설명하는 별도 메커니즘을 포함하지 않는다.
비용
논문은 여러 데이터셋에서 Graph Transformer보다 빠른 실행을 보고하지만, 이 비교는 선택한 모델·데이터셋·튜닝 조건에 한정된다.
실패 조건
성능은 edge feature, positional encoding, FFN과 데이터셋별 탐색을 포함한 조합에 의존한다. 장거리 의존성과 over-smoothing·over-squashing이 모든 그래프에서 해결됐다는 근거는 아니다.