GNNExplainer: Generating Explanations for Graph Neural Networks
GNNExplainer는 이미 학습된 GNN의 예측을 최대한 유지하는 작은 부분그래프와 feature mask를 찾는다. 그 mask가 인과적 원인이라는 뜻은 아니다.
Paper: Rex Ying; Dylan Bourgeois; Jiaxuan You; Marinka Zitnik; Jure Leskovec (2019). "GNNExplainer: Generating Explanations for Graph Neural Networks". PDF · arXiv:1903.03894v4
GNN이 노드의 종류나 그래프 전체의 성질을 예측했을 때, GNNExplainer는 전체 입력을 다시 해설하지 않는다. 그 예측을 잘 유지하는 작은 부분그래프와 feature 일부를 찾는다. 노드 분류에서는 목표 노드로 정보를 보낼 수 있는 계산 범위를 살피며, 그래프 분류에서는 여러 떨어진 부분이 함께 설명에 들어갈 수도 있다. 사용자는 어느 연결과 특징에 모델의 예측이 민감한지 살펴볼 수 있다. 하지만 이 결과는 현실 세계에서 결과를 일으킨 인과 원인의 증명이 아니다.
1. 설명의 질문을 좁히기
설명은 두 범주로 나뉜다. 하나는 한 예측을 묻는 local explanation이고, 다른 하나는 특정 클래스에서 반복되는 패턴을 묻는 global explanation이다. GNNExplainer의 기본 단위는 local이다. 노드 분류에서는 목표 노드의 K-hop computation graph 안에서 원래 예측을 유지하는 subgraph와 feature를 고른다. 그래프 분류에서는 그래프 전체의 예측을 대상으로 하며, graph-level pooling 때문에 설명의 부분그래프가 반드시 연결될 필요는 없다.
따라서 “이 edge가 중요하다”는 말은 “이 edge를 남긴 마스크가 현재 GNN의 \hat y 확률을 설명하는 데 유리했다”에 가깝다. 데이터 수집 과정에서 그 edge를 제거했을 때 실제 현상이 바뀐다는 뜻은 아니다. 이 차이를 지켜야 설명 그림을 원인 그림으로 오독하지 않는다.
2. mask를 어떻게 배우나
가능한 부분그래프를 전부 검사하면 경우의 수가 너무 많다. 논문은 computation graph의 adjacency에 연속적인 구조 mask M, feature 차원에 feature mask F를 둔다. sigmoid를 통과한 mask로 edge와 feature를 부드럽게 약화시키고, gradient ascent로 mutual information 목적을 크게 만든다.
직관은 간단하다. 연결과 특징을 가린 뒤에도 원래 예측이 유지되는가를 본다. 논문은 이 관계를 mutual information 목표로 적고, 실제 최적화에서는 고정된 GNN의 원래 예측이 마스크 뒤에도 잘 나오도록 log-likelihood를 높인다. mask가 전부 켜지는 것을 막기 위해 크기 penalty를, 0과 1 사이에서 흐릿해지는 것을 줄이기 위해 entropy regularization을 더한다. feature mask에서는 중요 feature가 우연히 0에 가까운 값일 때 놓치지 않도록 empirical marginal 분포를 이용해 다른 feature 값을 샘플링한다.
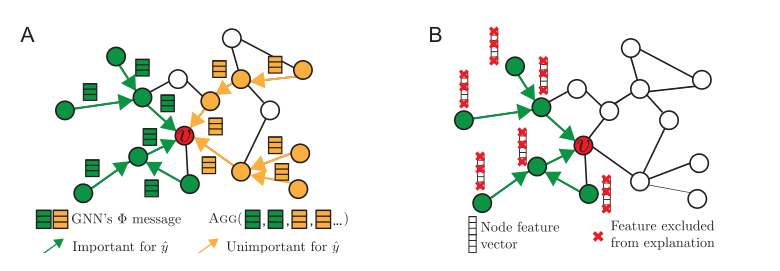
그림 1. Ying et al. (2019), Figure 2, PDF p. 3의 원도판. (A)는 computation graph의 edge mask, (B)는 node feature mask를 보인다. 두 mask는 예측을 낸 고정 GNN을 바꾸는 학습이 아니라, 그 GNN의 입력 중 설명할 부분을 고르는 최적화다.
3. 작은 예로 보기
어떤 논문 노드가 기계학습 클래스로 분류됐다고 하자. K-hop 이웃에는 인용 논문 수백 편과 단어 feature 수천 개가 있다. GNNExplainer는 모든 인용을 주는 대신, 예측 확률을 유지하는 몇 개의 연결과 ‘neural’, ‘learning’처럼 남겨야 할 feature를 높은 mask 값으로 줄 수 있다. 이런 결과는 모델 디버깅에 유용하다. 예를 들어 예상 밖의 저널 이름 feature가 높은 mask를 얻으면 모델이 이상한 shortcut을 썼는지 점검할 수 있다.
그러나 mask가 한 개라는 보장도 없다. 같은 예측을 보존하는 작은 subgraph가 여럿이면, 최적화 초기값과 regularization에 따라 다른 설명이 나올 수 있다. 논문이 sparsity를 유도하는 이유도 사람이 읽을 만큼 작은 설명을 만들기 위해서지, 유일한 진실을 찾기 위해서가 아니다.
4. 원문 실험은 무엇을 보여 주나
논문은 BA-Shapes와 BA-Community 같은 합성 그래프에서는 설계된 motif의 edge를 정답 표시로 삼아 Table 1의 explanation accuracy를 비교한다. 각 edge의 motif 소속 여부를 이진 정답으로 두고, 설명기가 준 edge 중요도를 예측 점수로 평가한다. Tree-Grid에서 GNNExplainer는 0.875, Grad는 0.667, Att는 0.612였다. 이는 그 합성 과제에서 설계된 motif edge를 얼마나 잘 가려냈는지의 지표다. 모델이 실제로 모든 motif edge를 인과적으로 썼다는 증거는 아니다. 실제 데이터에서는 Reddit-Binary의 토론 스레드 그래프 분류(질문·답변 대 온라인 토론)와 MUTAG의 분자 그래프 분류에 적용해 Figure 4와 Figure 5의 사례를 보여 준다.
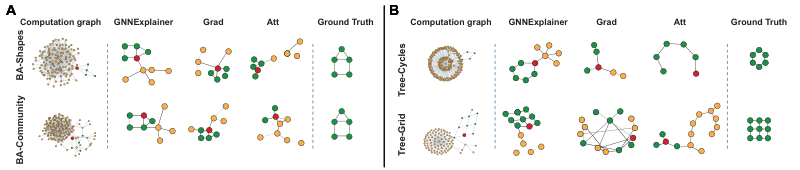
그림 2. Ying et al. (2019), Figure 3, PDF p. 8의 원도판. 합성 BA-Shapes/BA-Community에서 GNNExplainer가 찾은 강조 부분을 보여 준다. 정답 motif가 설계된 synthetic 조건의 정성 예시이므로, 현실 데이터에서의 인과 검증으로 확대하면 안 된다.
Figure 6은 같은 클래스의 여러 instance explanation을 모아 prototype을 만드는 예를 보인다. 그래서 local mask를 바로 global law로 선언하지 않고, 반복 패턴을 별도 집계해야 한다는 점도 드러난다. 수치 비교는 Table 1의 특정 합성 데이터·GNN·motif 구성에서의 측정값이며, 다른 모델의 calibration이나 사람의 이해도를 직접 측정한 결과는 아니다.
5. 사용할 때의 주의점
첫째, 설명 대상 GNN과 입력 preprocessing을 고정해야 한다. 모델을 재훈련하면 “같은 예측” 자체가 달라질 수 있다. 둘째, mask의 크기·entropy 계수와 threshold는 설명의 길이를 바꾼다. 셋째, computation graph 밖의 node는 이 예측에 message를 보낼 경로가 없으므로 선택되지 않는다. 이것은 유효한 message-passing 설명을 만든다는 장점이지만, 멀리 있는 실제 원인이 없다는 판정은 아니다.
가장 중요한 경계는 인과성이다. GNNExplainer는 관측 그래프에서 학습된 모델의 조건부 예측을 보존하는 explanation을 최적화한다. edge를 실제로 끊거나 feature를 조작하는 개입 실험, confounder 통제, counterfactual data 생성은 이 논문의 평가에 포함되지 않는다. 따라서 “모델이 이 신호를 이용했다”와 “이 신호가 현실의 원인이다”를 문장으로 분리해야 한다.
도입 판단: 설명 대상부터 고정한다
GNNExplainer가 맞는 경우는 이미 학습된 GNN의 특정 예측에서 어떤 부분그래프와 feature가 예측 보존에 기여했는지 사후 점검하려는 때다. 목적함수는 고정된 모델의 예측과 mask된 부분그래프 사이의 mutual information을 최대화한다(원문 §3–4). 따라서 규제·과학 판단처럼 현실의 원인이나 개입 효과를 입증해야 하는 과제라면 이 mask만으로 충분하지 않고, 별도의 counterfactual 또는 개입 검증이 필요하다.
6. 결론
GNNExplainer는 복잡한 message-passing 결과를 작은 subgraph와 feature mask로 축소해 사람이 검사할 창을 만든 방법이다. 모델 디버깅, shortcut 탐색, 도메인 전문가와의 가설 점검에 활용할 수 있다. 좋은 설명이 곧 좋은 인과 지식이라는 약속은 원논문에 없으며, 그 경계를 지키는 것이 이 방법을 가장 유용하게 쓰는 방식이다.
더 긴 목적함수·prototype 생성과 결과 표 해석은 심화 보기에서 확인할 수 있다.
References
Ying, R., Bourgeois, D., You, J., Zitnik, M., & Leskovec, J. (2019). GNNExplainer: Generating explanations for graph neural networks. Advances in Neural Information Processing Systems, 32. https://arxiv.org/abs/1903.03894v4