Structural Deep Network Embedding
SDNE: 그래프의 직접 연결과 이웃 구조를 함께 압축하기
SDNE는 인접행렬을 깊은 오토인코더로 복원하면서 연결된 노드를 가깝게 만드는 초기 그래프 임베딩 방법이다. 두 근접성을 함께 쓰는 이유와 결과를 읽을 때의 조건을 정리한다.
Paper: Daixin Wang; Peng Cui; Wenwu Zhu (2016). "Structural Deep Network Embedding." Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 1225–1234. https://doi.org/10.1145/2939672.2939753 · PDF
그래프 임베딩은 노드를 짧은 벡터로 바꾸되, 연결 구조를 잃지 않으려는 작업이다. SDNE는 이를 깊은 오토인코더로 풀었다. 각 노드의 인접행렬 행을 입력으로 압축하고 복원하는 한편, 실제로 연결된 노드쌍은 임베딩 공간에서도 가깝게 만든다. 논문은 이를 1차와 2차 근접성을 함께 보존하려는 설계로 설명한다.
1. 두 종류의 ‘가까움’
1차 근접성은 두 노드 사이에 실제 엣지가 있다는 사실이다. 2차 근접성은 같은 특정 이웃들과 연결되는 정도가 비슷하다는 뜻이다. 가령 A와 B가 모두 C·D에 연결되면 둘의 인접 벡터는 닮는다. 서로 전혀 다른 이웃을 가졌지만 둘 다 ‘허브’인 경우까지 같은 것으로 보는 구조적 역할 동등성과는 다르다. 직접 연결만 따르면 엣지가 없는 A·B의 공통 이웃을 놓칠 수 있고, 이웃 벡터만 복원하면 실제 연결된 쌍을 충분히 가깝게 만들지 못할 수 있다. SDNE는 두 신호를 하나의 목적함수에 넣는다(§3.1–3.2).
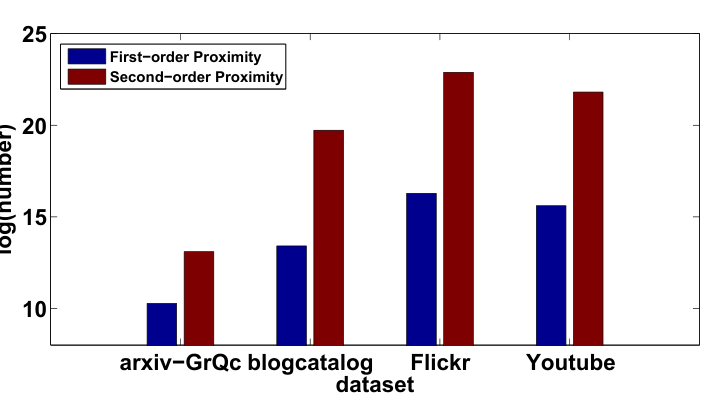
그림 1. Wang, Cui, & Zhu (2016), KDD ’16 최종본 Figure 1, PDF 2쪽·인쇄 1226쪽. 네 자료의 1차·2차 근접성 쌍 수를 비교한 원문 300 dpi 크롭이다. 원문 축과 범례를 모두 포함한다.
2. 인접행렬 한 행을 오토인코더에 넣는다
각 노드의 입력은 기존 모든 노드와의 연결을 차례로 적은 인접 벡터다. 인코더가 이를 짧은 임베딩으로 압축하고 디코더가 원래의 연결 목록을 복원한다. 그래프는 대체로 0이 많아서 0만 잘 복원해도 겉보기 오차가 작을 수 있다. 이를 막으려 원논문 Eq. 3은 실제 엣지의 복원 잔차에 β를 곱한 뒤 제곱한다. 따라서 0인 항목의 단위 가중 제곱오차에 비해 엣지 항목의 기여는 β²배다. β를 제곱오차 밖에 한 번 곱한 것처럼 설명하면 가중치를 작게 읽게 된다.
동시에 직접 연결된 두 노드의 임베딩이 멀어질수록 벌점을 준다. 이 벌점이 1차 근접성 손실이다(Eq. 4). 최종 목적은 2차 복원 손실, α가 조절하는 1차 손실, 정규화를 합친 것이다(Eq. 5). 그림의 두 오토인코더 탑은 같은 가중치를 공유하므로 노드마다 별도 모델을 만드는 방식은 아니다. ‘준지도’의 지도 신호도 사람의 클래스 라벨이 아니라 관측된 엣지다.

그림 2. Wang, Cui, & Zhu (2016), KDD ’16 최종본 Figure 2, PDF 3쪽·인쇄 1227쪽. 공유 오토인코더는 이웃 목록을 복원하고, 연결된 두 임베딩에는 거리 벌점을 건다. ‘supervised’ 신호는 클래스 라벨이 아닌 관측 엣지다.
3. 어떤 실험을 했나
저자들은 ARXIV GR-QC, BLOGCATALOG, FLICKR, YOUTUBE, 20-NEWSGROUP에서 재구성, 노드 분류, 링크 예측, 시각화를 평가했다(§4). 비교에는 DeepWalk, LINE, GraRep, Laplacian Eigenmaps 등이 들어간다. 분류는 라벨 일부로 분류기를 학습하고 나머지 라벨을 예측하는 설정이며, 링크 예측은 ARXIV GR-QC 엣지의 15%를 숨긴 뒤 순위 precision@k를 본다(§4.5).
재구성은 학습 그래프의 이웃 목록을 얼마나 잘 되살리는지, 링크 예측은 무작위로 숨긴 기존 엣지를 상위 후보에 올리는지를 측정한다. 둘 다 순위를 매기지만 학습 중 본 연결을 복원하는 일과 감춘 연결을 맞히는 일은 다르다. 재구성의 MAP는 각 노드에 대해 정답 이웃들이 예측 순위 앞쪽에 얼마나 모였는지 계산한 average precision을 노드들에 걸쳐 평균낸 값이다. P@K는 상위 K개 후보 중 실제 숨긴 엣지의 비율이다. 두 지표는 평가 대상과 분모가 달라 점수를 직접 맞비교하지 않는다.
4. 논문이 보여 준 결과
원논문 **Table 4(인쇄 1231쪽)**에서 재구성 MAP는 ARXIV GR-QC 0.836, BLOGCATALOG 0.63이다. Figure 3에서도 두 자료의 재구성 precision@K 곡선이 상단에 있다. 그러나 이것은 모델의 학습 목적과 가까운 구조 복원 결과다.
별도 링크 예측 **Table 5(인쇄 1232쪽)**는 ARXIV GR-QC의 기존 엣지 15%를 무작위로 숨긴 설정이다. SDNE의 P@100·200·300은 1.0, P@500은 0.99, P@800은 0.97, P@1,000은 0.91이다. 상위 순위에서 높은 정밀도를 보였지만 K가 커질수록 떨어진다. Figure 4–5의 노드 분류에서도 저자들은 높은 Micro-F1·Macro-F1 곡선을 보고하지만, 이 수치들을 미래 링크 예측의 근거로 바꿔 쓸 수는 없다.
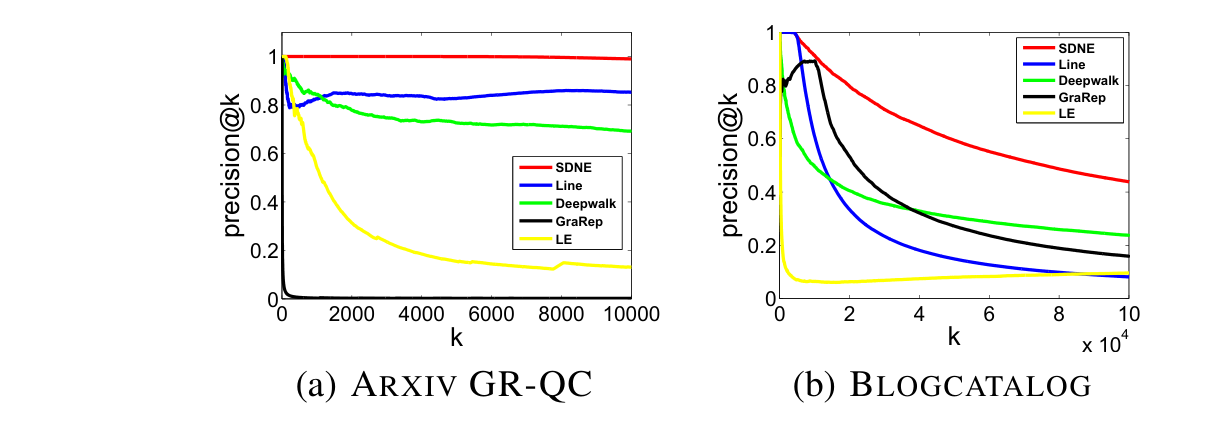
그림 3. Wang, Cui, & Zhu (2016), KDD ’16 최종본 Figure 3, PDF 7쪽·인쇄 1231쪽. ARXIV GR-QC와 BLOGCATALOG의 재구성 precision@K 두 패널을 모두 담은 원문 300 dpi 크롭이다. 미래 링크 예측 그래프가 아니다.
5. 성능 수치의 범위
재구성 평가는 SDNE가 직접 최소화하는 가중 재구성 손실과 가까운 과제다. 따라서 여기서의 큰 우위는 모델이 목표에 잘 맞는다는 증거지만, 새 그래프나 새 노드로의 일반화와는 별개의 근거다. 링크 예측도 무작위로 감춘 기존 엣지를 맞히는 설정이다. 시간 순서가 있는 네트워크에서 미래 엣지를 예측하는 엄격한 분할과는 다를 수 있다. 이는 논문에 명시된 무작위 은닉 설계에서 직접 따라오는 적용 범위다.
또한 입력과 출력은 학습 당시 그래프의 기존 노드 수만큼 길다. 새 노드가 기존 노드들과 맺은 연결을 알고 있다면, 원논문 §3.3처럼 그 연결을 같은 길이의 입력 벡터로 만들어 학습된 인코더에 통과시킬 수 있다. 따라서 새 노드를 전혀 처리할 수 없다는 단정은 틀리다. 다만 기존 노드와 연결 정보가 없는 고립 노드, 많은 노드 추가로 입력 차원이 바뀌는 환경은 별도 방법과 재학습 비용 검토가 필요하다. 이는 구조에서 따르는 적용 조건이다.
6. 정리
SDNE는 지역 엣지와 이웃 구조를 동시에 보존하려고 깊은 비선형 오토인코더에 직접 연결 손실을 결합했다. 당시 비교법보다 여러 실험 지표에서 높은 수치를 보고했으며, 특히 희소 그래프의 구조 복원을 강점으로 제시한다. 다만 그 강점은 고정 그래프의 재구성·무작위 링크 은닉 조건에서 확인된 것이므로, 시간 분할 예측이나 노드 유입 환경에는 별도 평가가 필요하다.
References
Wang, D., Cui, P., & Zhu, W. (2016). Structural deep network embedding. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 1225–1234. https://doi.org/10.1145/2939672.2939753