How Powerful are Graph Neural Networks?
GIN은 sum과 MLP로 이웃 다중집합을 보존해 1-WL과 같은 구별력에 도달하는 충분조건을 보인다. 이론적 표현력은 테스트 정확도나 일반화를 보장하지 않는다.
Paper: Keyulu Xu; Weihua Hu; Jure Leskovec; Stefanie Jegelka (2019). "How Powerful are Graph Neural Networks?". International Conference on Learning Representations. arXiv:1810.00826 PDF.
한눈에 보기
그래프 신경망은 이웃의 벡터를 모아 노드 표현을 만든다. 그런데 서로 다른 이웃 구조가 같은 집계값으로 무너지면, 뒤의 분류기는 그 차이를 되살릴 수 없다. GIN(Graph Isomorphism Network) 논문은 이 문제를 정확히 묻는다. 이웃 집계형 GNN은 그래프 구조를 어디까지 구별할 수 있고, 그 상한에 닿으려면 집계 함수가 어떤 성질을 가져야 하는가.
그 상한은 1차 Weisfeiler–Lehman(1-WL) test가 구별하는 범위다. 논문은 일반적인 message-passing GNN이 그 범위를 넘을 수 없음을 보이고, 단사적인 집계·결합·readout을 쓰면 그 범위에 도달할 수 있음을 보인다. GIN은 sum과 MLP로 그 조건을 구현하려는 간단한 모델이다. 이 결과는 구별력에 관한 이론이며, 테스트 정확도·최적화·일반화의 보증은 아니다.
1. 왜 평균만으로는 부족할 수 있나
이웃 표현은 같은 벡터가 여러 번 나타날 수 있는 multiset(다중집합)이다. mean은 중복의 절대 개수를 버리고 비율만 남긴다. 예컨대 같은 특징의 이웃이 하나인 경우와 둘인 경우는 평균이 같을 수 있다. max는 중복 자체를 버린다. 반면 sum은 적절한 변환과 함께 쓰면 어떤 특징이 몇 번 나타났는지를 보존할 수 있다.
이 차이만으로 “sum이 모든 과제에서 정확도가 높다”고 말할 수는 없다. 노드 분류처럼 이웃 feature의 분포만 중요하거나 feature가 거의 반복되지 않는 조건에서는 mean도 충분할 수 있다. 논문의 비교 대상은 다중집합을 구별하는 표현력이다.
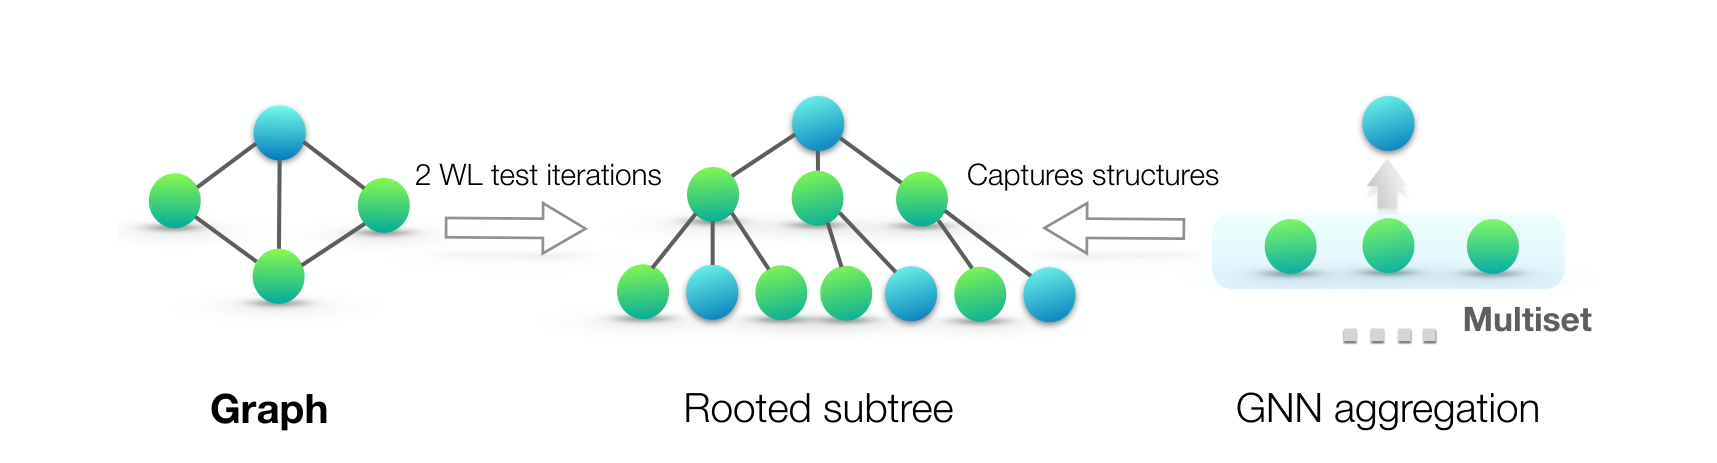
그림 1. Xu et al. (2019), Figure 1, arXiv:1810.00826 PDF p. 3의 원도판. 이웃 집계 GNN과 WL test의 구별력 관계를 개념적으로 보인다. 이 그림은 벤치마크 테스트 정확도의 순위를 뜻하지 않는다.
2. GIN의 갱신식
논문의 일반 GNN은 이웃 표현을 모으고 자신의 이전 표현과 합친다. Theorem 3은 이웃을 모으는 함수, 자신의 정보를 합치는 함수, 그래프 전체를 읽는 함수가 각각 서로 다른 입력을 구별할 수 있으면 1-WL이 구별하는 그래프 쌍을 GNN도 구별할 수 있다고 말한다. Lemma 5의 sum 표현에는 셀 수 있는 특징 종류와 크기가 제한된 이웃 다중집합이라는 조건이 있다. 연속값 특징이나 제한 없는 이웃 수에 같은 증명을 그대로 적용해서는 안 된다.
GIN의 한 층은 이웃 벡터를 합산하고 자신의 벡터에는 별도의 계수를 곱해 더한 다음, 결과를 MLP라는 작은 신경망에 통과시킨다. 자신의 계수는 학습할 수도 있고 고정할 수도 있다. 이웃의 개수를 버리지 않는 합산과 비선형 변환을 함께 쓰는 것이 핵심이다. 그래프 분류에서는 마지막 층만 읽지 않고 각 층의 노드 표현을 readout으로 모아 연결한다. 실제 실험에서는 생물정보 그래프에 sum, 소셜 그래프에 mean readout을 사용했다. 이론의 단사 readout 조건과 각 실험 구성을 구분해야 한다. 따라서 짧은 범위와 더 긴 범위에서 얻은 정보를 최종 분류기에 함께 준다.
논문의 표현력 정리는 필요한 함수들이 단사, 즉 서로 다른 다중집합을 서로 다른 출력으로 보내는 경우에 관한 것이다. 이 조건을 만족하는 함수의 존재와 실제 크기의 MLP가 학습으로 그 함수를 찾는 일은 다르다. 특히 자기 벡터에 붙는 추가 계수 ε을 0으로 고정해 자기 벡터를 한 번 더하는 GIN-0은, ε을 조절할 수 있는 일반 단사 구성보다 이론적으로 약간 덜 일반적이다. 이 차이를 실험에서 언제나 나타나는 성능 차이로 읽을 수는 없다.
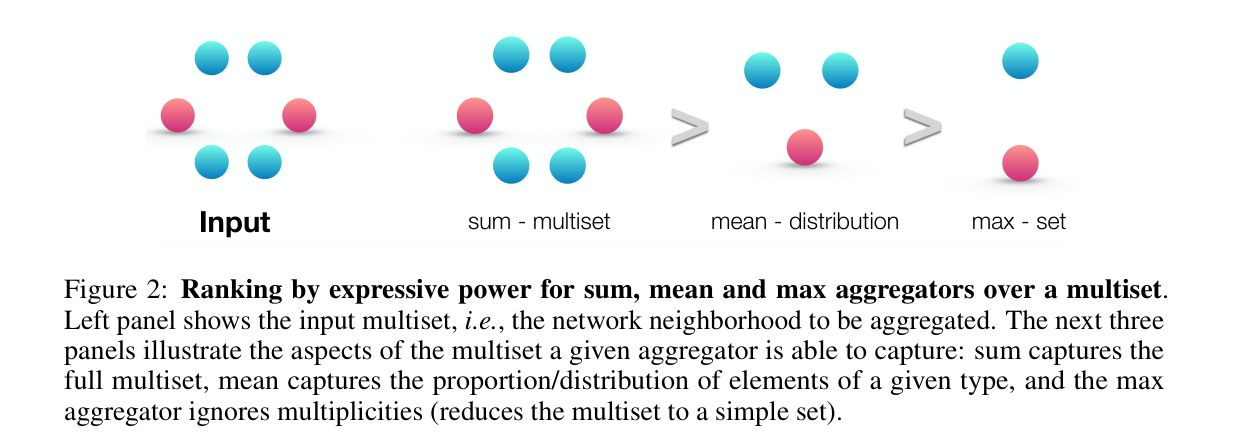
그림 2. Xu et al. (2019), Figure 2, arXiv:1810.00826 PDF p. 6의 원도판. sum·mean·max가 다중집합에서 보존하는 정보의 차이를 요약한다. 순위는 이 논문의 구별력 기준이며 모든 실제 과제의 성능 순위가 아니다.
3. 작은 예로 보기
서로 다른 특징을 나타내는 0이 아닌 one-hot 벡터 a와 b를 생각하자. 첫 노드의 이웃이 {a, b}, 둘째 노드의 이웃이 **{a, a, b, b}**이면 평균은 둘 다 (a+b)/2다. 그러나 합은 첫째가 a+b, 둘째가 2a+2b로 달라진다. 평균은 비율이 같을 때 이웃 수의 차이를 지우고, 합은 그 차이를 남긴다. 뒤의 MLP와 그래프 전체 readout도 이 구별을 보존해야 최종 그래프 표현에서 차이가 드러난다. 예가 보여 주는 것은 구별 가능성이지 높은 테스트 정확도의 보증이 아니다.
4. 저자 보고 실험
논문은 9개 그래프 분류 데이터셋에서 10-fold cross-validation의 fold 결과 평균과 표준편차를 보고했다(Table 1, PDF p. 10). 각 fold에서 빠진 자료로 성능을 평가하고, fold들의 평균 검증 정확도가 가장 높은 epoch를 선택했다. 표의 caption은 “Test set classification accuracies”라고 부르지만, 별도의 손대지 않은 외부 테스트 세트를 둔 절차는 아니다. 구조 정보가 특히 중요한 상수 node feature의 Reddit-Binary(RDT-B)에서 GIN-0은 92.4±2.5, Mean-MLP는 50.0±0.0이었고, Reddit-Multi-5K에서는 57.5±1.5 대 20.0±0.0이었다. IMDB-BINARY에서는 GIN-0 75.1±5.1, GIN-ε 74.3±5.1로 차이가 작다.
훈련 정확도 그림에서는 GIN 변형이 여러 데이터셋을 거의 완벽하게 적합하고, 어떤 GNN도 WL subtree kernel의 training accuracy를 넘지 못하는 양상을 보인다(Figure 4). 이는 이론의 구별력 논지와 잘 맞는 관찰이다. 하지만 같은 표에서 NCI1은 WL subtree 86.0±1.8이 GIN-0 82.7±1.7보다 높고, PTC는 Mean-MLP 66.6±6.9가 GIN-0 64.6±7.0보다 높다. 표현력과 일반화는 별개라는 논문 자신의 경고를 여기서 확인할 수 있다.
5. 적용 조건과 한계
GIN은 그래프 분류 baseline으로 구조적 다중집합 정보를 놓치고 싶지 않을 때 유용하다. 다만 이론에는 countable 입력 feature, 충분한 층, 단사 함수의 존재 같은 조건이 있고, 유한 정밀도 MLP를 학습하는 과정이 그 함수를 찾는다는 보장은 없다. 1-WL 자체가 구별하지 못하는 그래프도 남는다.
평가 프로토콜도 주의해야 한다. Table 1은 fold별로 빠진 자료의 결과를 사용하며, 같은 CV 평균 지표로 epoch도 고른다. 작은 데이터셋의 큰 표준편차와 여러 baseline의 원문 전재를 고려하면, 소수점 차이로 모델의 보편적 우위를 선언하기 어렵다. GIN을 인용할 때는 “1-WL 수준의 구별력”과 “특정 벤치마크의 정확도”를 구분해야 한다.
더 긴 정리·표 분석은 심화 보기에서 확인할 수 있다.
References
Xu, K., Hu, W., Leskovec, J., & Jegelka, S. (2019). How powerful are graph neural networks? International Conference on Learning Representations. https://arxiv.org/abs/1810.00826