Inductive Representation Learning on Large Graphs
GraphSAGE는 노드별 벡터표를 외우는 대신 특징과 이웃에서 표현을 계산하는 함수를 배운다. 새 노드·새 그래프에 적용되는 조건, 표집의 이득과 한계를 살핀다.
Paper: William L. Hamilton; Rex Ying; Jure Leskovec (2017). "Inductive Representation Learning on Large Graphs". PDF · arXiv:1706.02216v4
새 게시물이나 새 사용자처럼 학습 때 없던 노드가 들어오면, 노드마다 외워 둔 embedding 표는 곧 낡는다. GraphSAGE는 표를 다시 만드는 대신 노드 특징과 이웃에서 embedding을 만드는 규칙을 배운다. 따라서 새 노드에도 같은 규칙을 적용할 수 있다. 입력 특징은 텍스트나 프로필뿐 아니라 차수 같은 구조적 특징일 수도 있다. 이웃 관계가 관측되면 주변 정보까지 쓸 수 있지만, 고립 노드라는 이유만으로 함수 적용이 원천적으로 불가능한 것은 아니다. 입력의 의미가 학습 때와 호환되어야 하고 새 데이터의 정확도는 별도로 검증해야 한다.
1. 무엇이 문제였나
전통적인 node embedding 방법은 그래프 안의 각 노드에 벡터 하나를 직접 붙인다. 고정된 한 그래프에서는 편리하지만, 새 노드의 벡터는 없다. 새 노드를 기존 공간에 맞추려면 random walk를 다시 만들고 학습을 더 해야 한다. 원논문은 이것을 transductive 설정이라고 부른다.
GraphSAGE는 다음 질문에서 출발한다. “이 노드의 번호를 외우지 말고, 그 주변을 보는 법을 배울 수 있을까?” 예를 들어 논문 노드라면 제목·초록에서 만든 feature와 인용 이웃을, 게시물이라면 텍스트 feature와 같은 사용자가 댓글을 남긴 다른 게시물을 이용한다. 그래서 적용 대상이 바뀌어도 feature의 의미와 이웃의 의미가 유지되면 같은 함수를 쓸 수 있다.
2. 이웃을 모으는 방식
한 층에서 GraphSAGE는 먼저 이웃 일부를 뽑는다. 뽑은 이웃의 이전 단계 벡터를 하나로 모은 뒤, 노드 자신의 벡터와 결합해 새 표현을 만든다. 이 과정을 층마다 반복하므로 두 층이면 이웃의 이웃까지 입력에 반영된다.
이웃을 모으는 AGG에는 벡터 평균(mean), 이웃의 임의 순서를 입력받는 LSTM, 이웃별 변환 뒤 최댓값을 취하는 pooling이 있다. 서로 다른 집계 방식은 이웃의 어떤 차이를 남길지도 바꾼다. 모든 이웃을 읽으면 깊어질수록 계산량이 급증하므로 논문은 층마다 정해진 수 S_k를 균일하게 표집한다. 표집 수를 고정하면 한 목표 노드에서 펼쳐 읽는 이웃의 양을 통제해 큰 그래프도 묶음 단위로 처리할 수 있다.
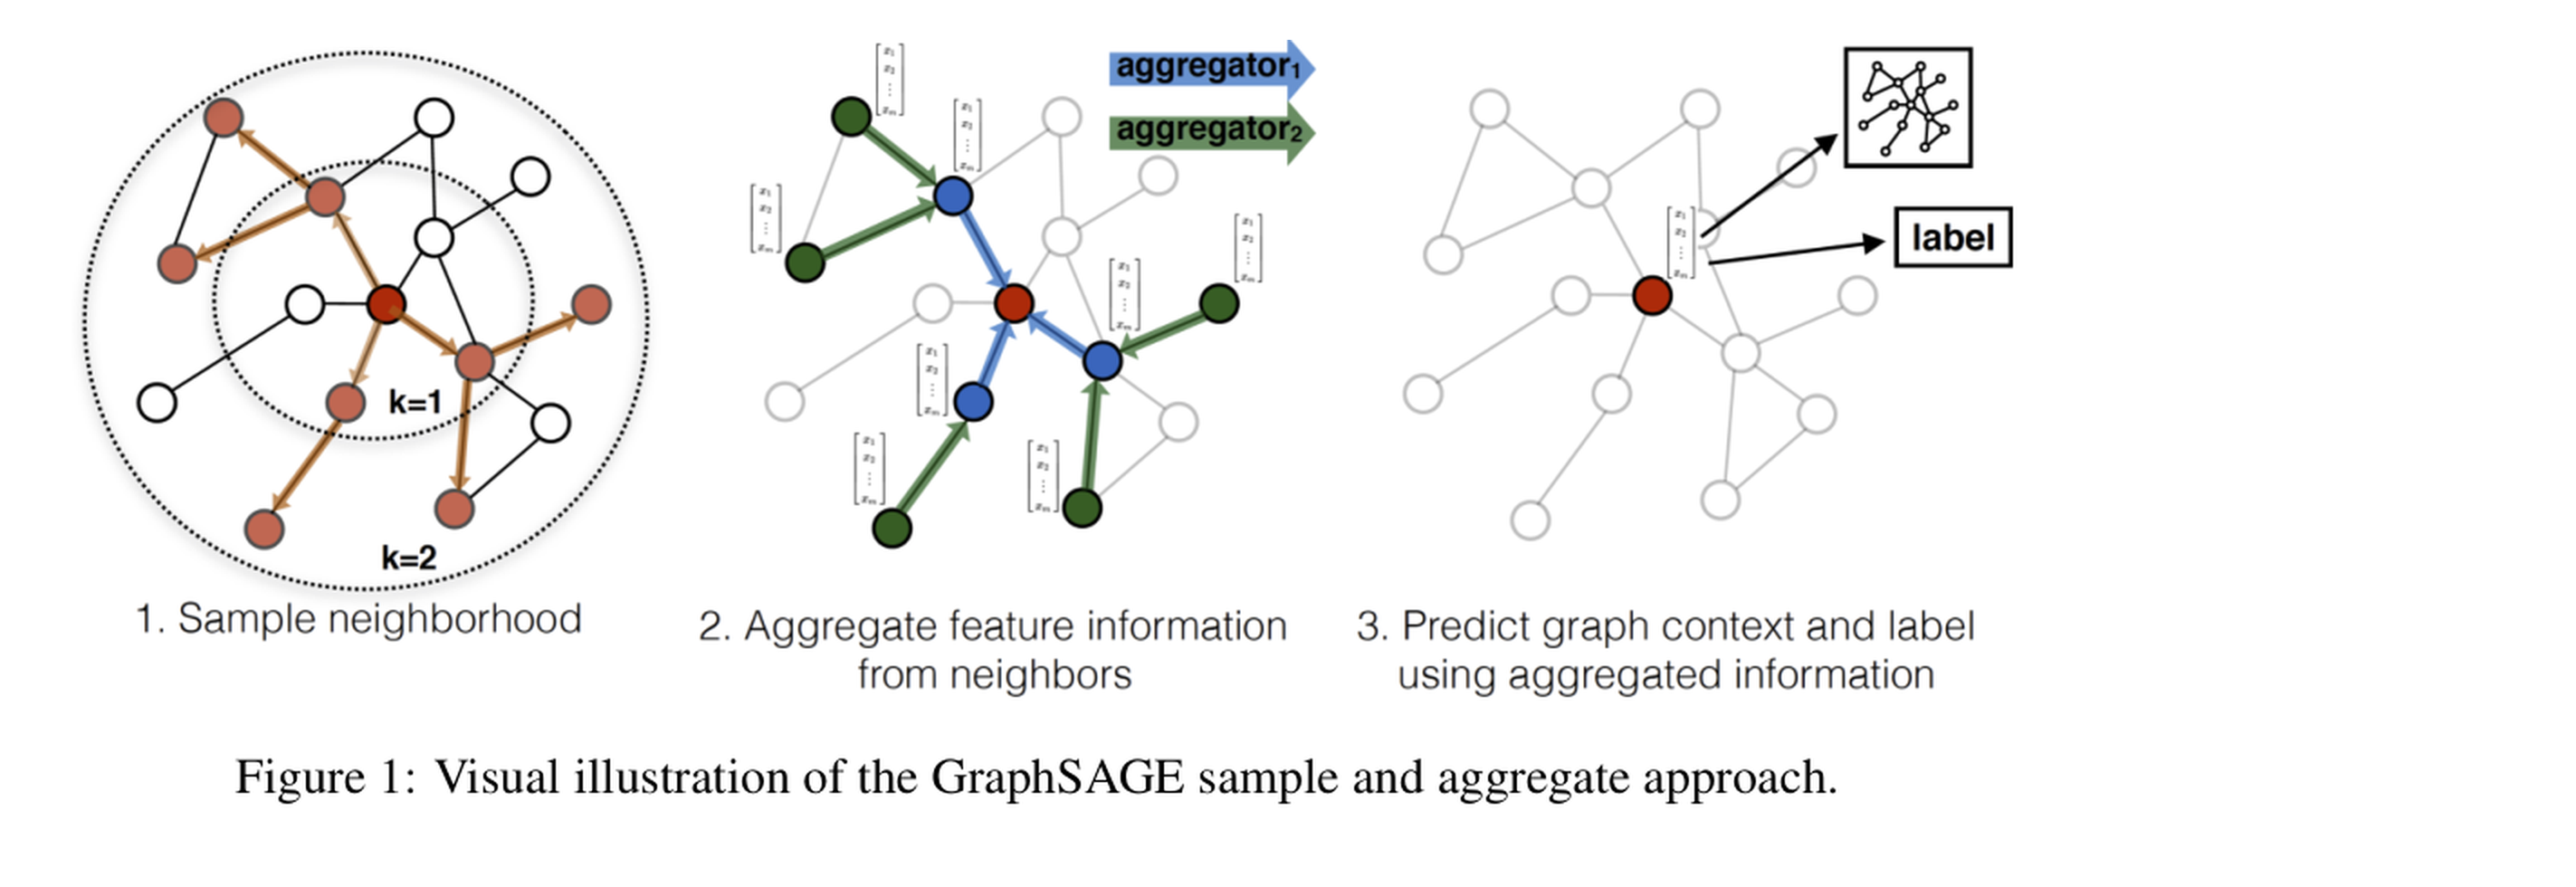
그림 1. Hamilton et al. (2017), Figure 1, PDF p. 2의 원도판. 목표 노드 주변을 표집하고, 이웃 특징을 층별로 집계해 embedding을 만드는 흐름이다. 그림은 label 자체를 전달하는 과정이 아니라 feature와 관측된 연결을 이용하는 과정이다.
3. 작은 예로 이해하기
새로운 질문 게시물이 들어왔다고 하자. 글의 단어 feature만 보면 ‘파이썬’ 질문과 ‘통계’ 질문이 비슷해 보일 수 있다. 하지만 같은 사용자가 댓글을 남긴 이웃 게시물들이 대부분 데이터 분석 범주에 있다면, 이웃 표현을 합친 GraphSAGE는 그 단서를 함께 쓴다. 두 층이면 ‘이웃의 이웃’까지 본다.
이 예에서 이웃의 단서까지 얻으려면 새 게시물의 특징과 연결이 실제로 관측되어야 한다. 연결이 없더라도 자기 특징이나 차수 같은 구조적 특징으로 표현을 계산할 수 있는 설정은 있다. 다만 쓸 만한 입력이 부족하거나 학습 그래프와 운영 그래프에서 edge의 뜻이 달라지면 “inductive”라는 이름만으로 좋은 예측이 보장되지는 않는다.
4. 원문이 보고한 결과와 조건
Table 1은 micro-averaged F1을 보고한다. Citation에서는 2000–2004년 논문으로 훈련하고 2005년 노드로 시험했으며, 2005년의 30%는 validation에 썼다. supervised GraphSAGE-pool은 0.839, raw feature는 0.575였다. Reddit에서는 첫 20일로 훈련하고 이후 날짜의 게시물로 시험했으며, pool은 0.948, raw feature는 0.585였다. PPI에서는 20개 조직 그래프로 훈련하고 서로 다른 2개 그래프에서 평가했다.
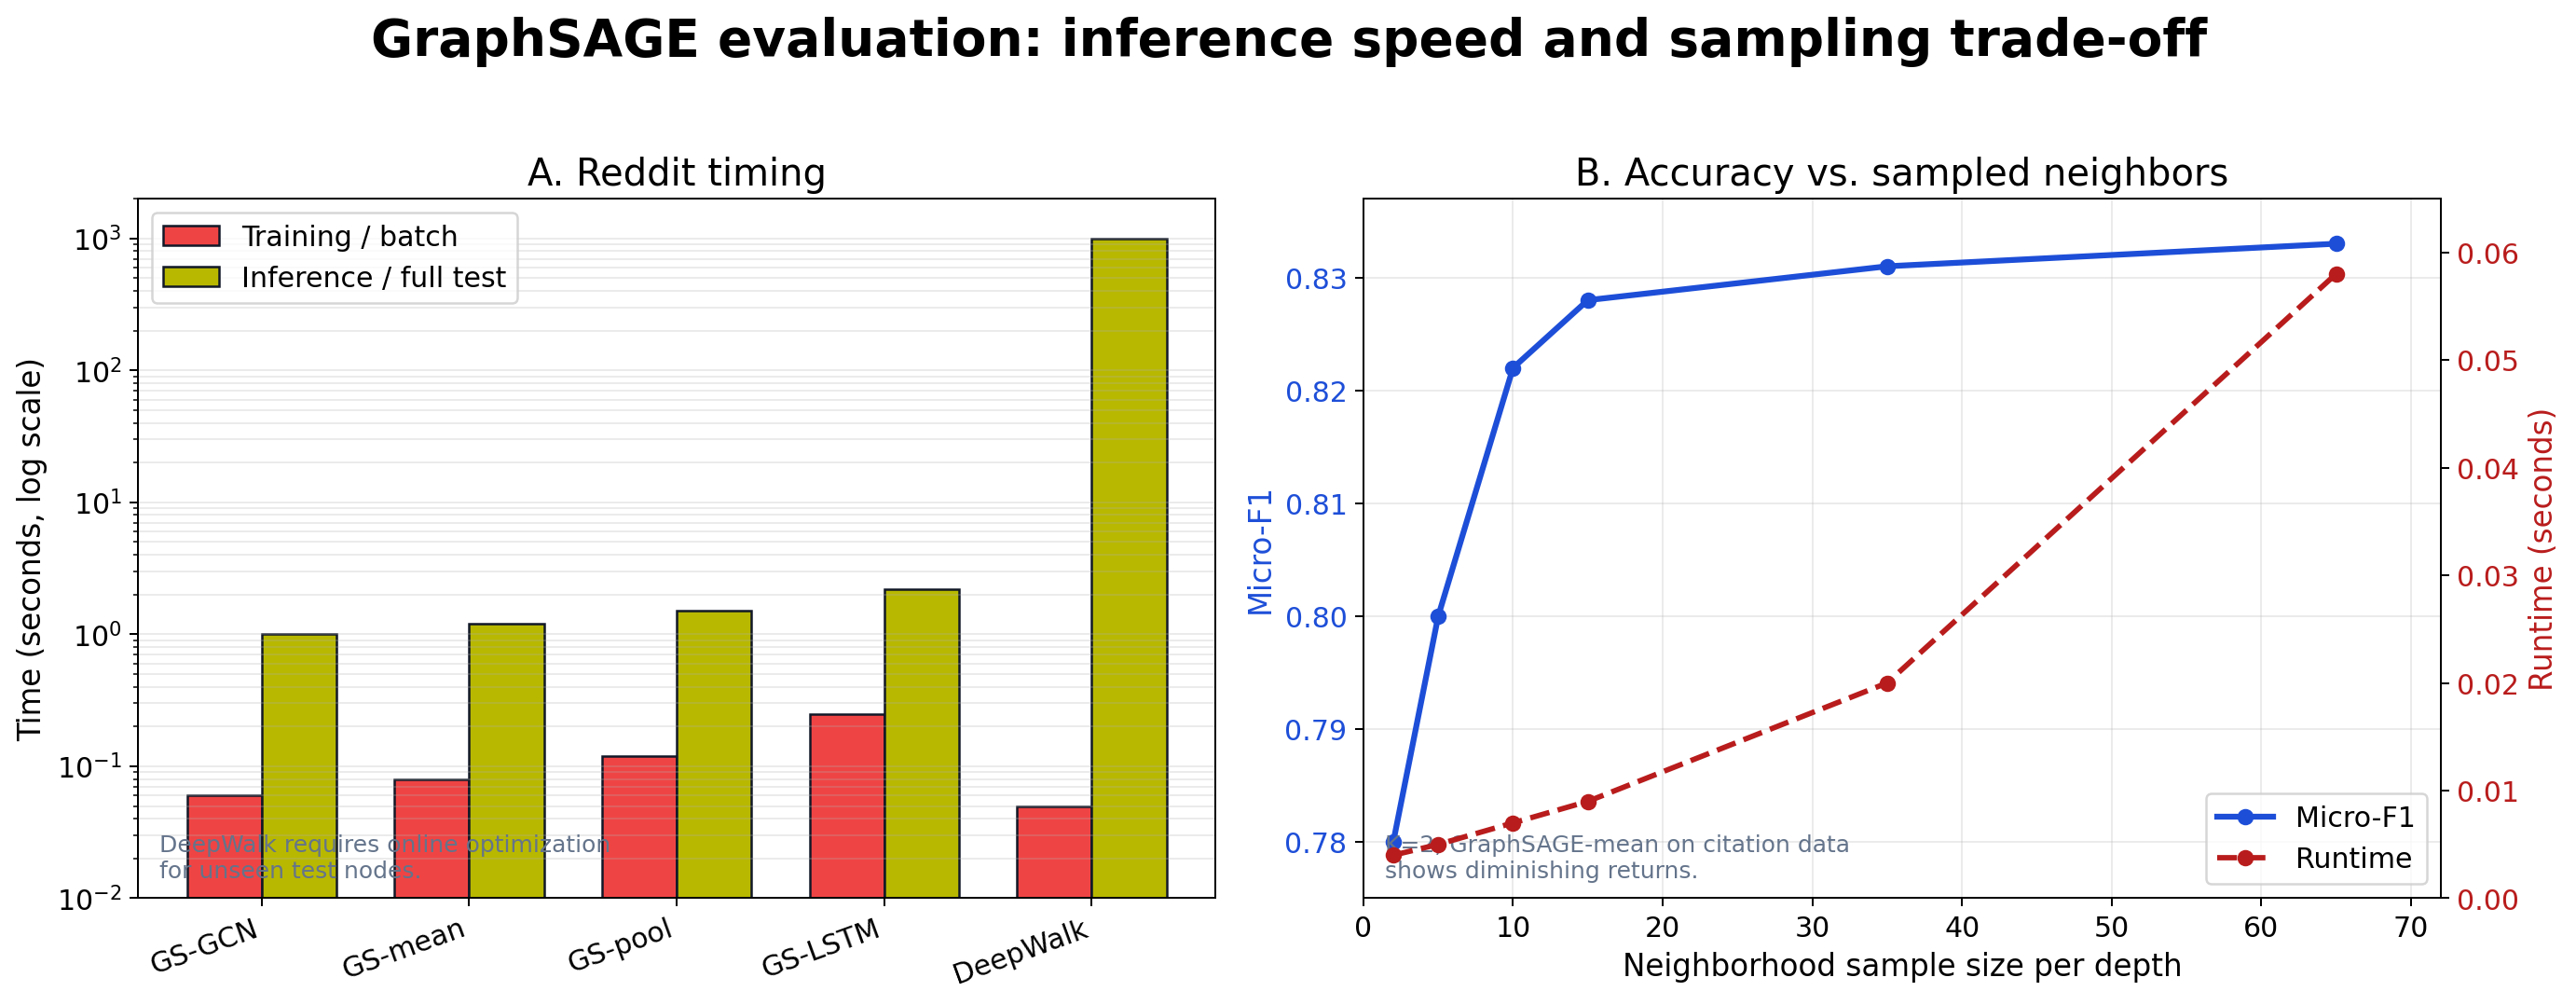
그림 2. Hamilton et al. (2017), Figure 2, PDF p. 7을 바탕으로 재구성한 설명 그림. 막대와 곡선의 점 위치는 원도판에서 대략 읽은 값이며 원문의 표 데이터가 아니다. Reddit은 학습 배치 512개와 시험 노드 79,534개 추론 시간을 구분하고, Citation 표집 실험은 GraphSAGE-mean의 K=2, S1=S2 조건이다.
논문 초록은 세 데이터셋의 지도학습 결과에서 raw feature 대비 F1의 **상대 개선율 평균 51%**를 보고한다. Citation 46%, Reddit 63%, PPI 45%를 평균한 값이지 F1이 51%포인트 올랐다는 뜻은 아니다. 표의 Reddit에서는 LSTM 0.954와 mean 0.950도 pool 0.948보다 높으므로 pool이 모든 데이터에서 최고라는 결론도 피해야 한다. DeepWalk는 새 노드에 대해 walk를 다시 표집하고 재학습해야 해 원문 §4.3의 시험 시점 비교에서 100–500배 느렸다. 같은 절은 시험한 표집 크기에서 K=2가 K=1보다 약 10–15% 높고, K>2의 추가 이득은 0–5%에 그치면서 실행시간은 10–100배 늘었다고 보고한다. 이 깊이 결과는 그림 2의 직접 수치가 아니라 별도의 본문 분석이다.
5. 적용할 때 확인할 것
GraphSAGE는 새 노드를 빠르게 임베딩해야 하고, 학습 때와 호환되는 특징과 가능하면 유용한 이웃 관계를 추론 시점에 얻는 경우에 잘 맞는다. 반대로 라벨은 훈련 노드에만 써야 한다. 시험 노드의 라벨을 메시지로 흘려보내면 반지도 학습의 성능이 아니라 누수의 성능을 재게 된다. GraphSAGE의 inductive 평가는 노드가 새롭다는 것과, 그 노드가 훈련 그래프 쪽 edge를 얼마나 갖는지가 모두 결과에 영향을 준다는 점도 보여 준다. 원문 Appendix D는 Citation 시험 edge의 96%, Reddit 시험 edge의 73%가 훈련 시기 쪽으로 연결된다고 적는다.
표집은 속도를 얻는 대신 같은 노드도 표집 난수에 따라 약간 다른 embedding을 낼 수 있다. 원논문도 non-uniform sampler를 future work로 남겼다. Theorem 1 역시 “pooling aggregator가 충분한 차원에서 특정 지역 구조를 구별하는 파라미터가 존재한다”는 존재 주장이다. 학습 알고리즘이 늘 그 파라미터를 찾는다는 보증은 아니다.
6. 결론
GraphSAGE는 특징과 이웃에서 표현을 계산하는 함수를 학습한다. 새 노드용 빈칸을 채우는 방식과 다르다. 이 관점은 이후 많은 message-passing GNN의 출발점이 됐다. 실무에서 읽을 때는 “새 노드에도 된다”를 입력 특징의 호환성, 이용 가능한 주변 구조, 시간 분할, 표집 예산으로 풀어 읽으면 과장 없이 쓸 수 있다.
더 긴 aggregator 비교와 정리의 적용 범위는 심화 보기에서 확인할 수 있다.
References
Hamilton, W. L., Ying, R., & Leskovec, J. (2017). Inductive representation learning on large graphs. Advances in Neural Information Processing Systems, 30. https://arxiv.org/abs/1706.02216v4