Graph Attention Networks
GAT은 이웃 특징에 masked self-attention을 적용해 노드별 가중합을 만든다. 벤치마크의 정확도 향상은 주어진 라벨 분할과 attention 가중치의 예측적 유용성을 보여 줄 뿐 설명의 진실성을 보장하지 않는다.
Paper: Petar Veličković; Guillem Cucurull; Arantxa Casanova; Adriana Romero; Pietro Liò; Yoshua Bengio (2018). "Graph Attention Networks". International Conference on Learning Representations. arXiv:1710.10903 PDF.
한눈에 보기
그래프 신경망은 한 노드의 표현을 이웃의 정보로 갱신한다. 가장 단순한 집계는 이웃을 같은 비중으로 평균내는 방식이다. GAT(Graph Attention Network)은 그 비중을 데이터에서 학습한다. 대상 노드와 이웃의 특징을 함께 보고 점수를 만든 다음, 그 대상의 이웃 안에서 점수 비율을 정해 가중합한다. 같은 이웃이라도 현재 노드와 이웃 집합에 따라 다른 계수를 받을 수 있다.
GAT은 그래프 전체 행렬 역산이나 스펙트럼 분해 없이, 이웃만 보는 masked self-attention으로 작동한다. 그러나 attention이 높다고 해서 그 이웃이 실제로 예측의 원인이거나 사람이 납득할 설명이라는 뜻은 아니다. 논문은 예측 성능을 평가했다. attention 설명의 충실성은 검증하지 않았다.
1. 어떤 문제를 푸는가
초기 그래프 합성곱 방법은 고정된 정규화 계수나 그래프 구조를 미리 알아야 하는 연산에 의존하는 경우가 많았다. GAT은 이웃별 중요도를 feature 기반으로 학습해 고정 평균의 제약을 완화하고, 같은 연산자를 보지 못한 테스트 그래프에도 적용할 수 있는 inductive 설정을 목표로 삼는다.
구조 정보를 무시한 전역 self-attention과도 다르다. GAT은 그래프에서 연결된 이웃에 대해서만 점수를 계산한다. 따라서 attention은 “그래프 전체에서 가장 비슷한 노드”가 아니라 주어진 인접 관계 안에서의 상대적 가중치다.
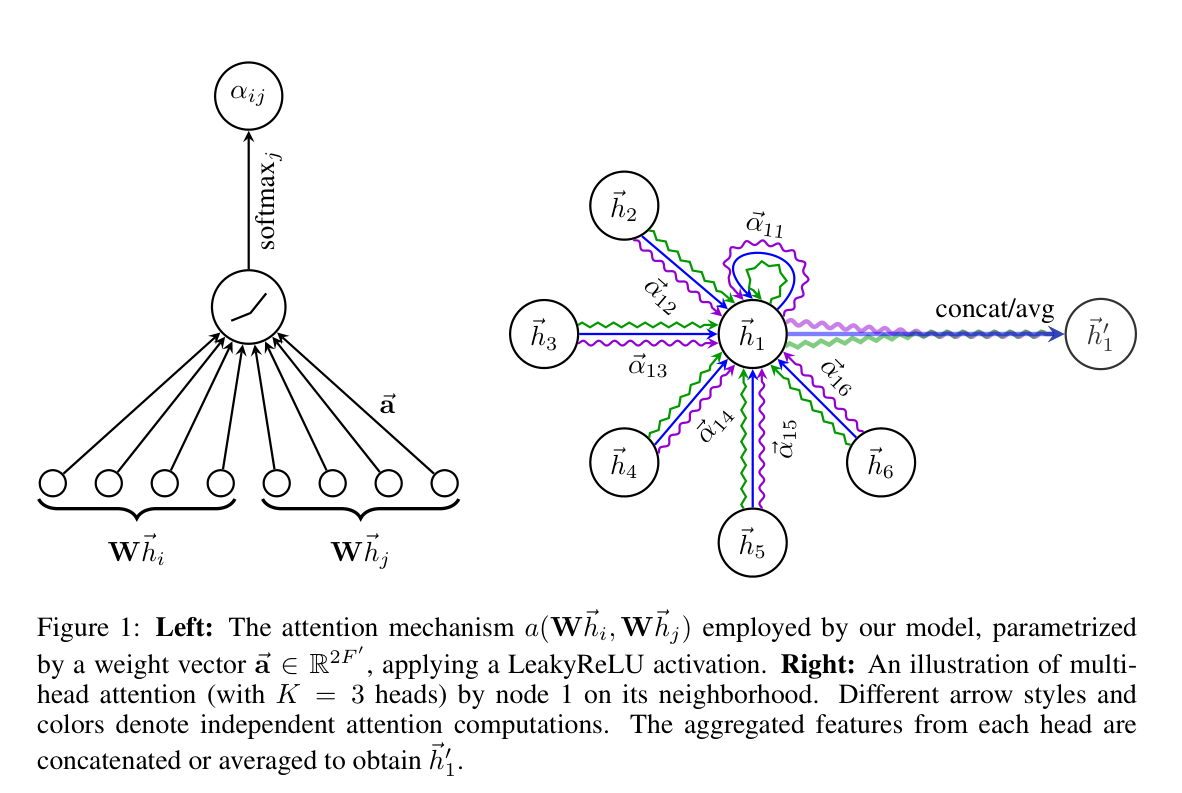
그림 1. Veličković et al. (2018), Figure 1, arXiv:1710.10903 PDF p. 4의 원도판. 왼쪽은 이웃 마스킹과 attention 계수, 오른쪽은 multi-head 집계를 보인다. 선의 굵기나 계수는 모델의 학습 가중치이며 원인·중요 사실의 검증값은 아니다.
2. 한 층의 계산
한 층은 네 단계로 읽을 수 있다. 먼저 모든 노드 특징을 같은 방식으로 변환한다. 이어 대상 노드와 각 이웃의 변환된 특징을 연결해 점수를 계산한다. 대상의 이웃 안에서 점수들을 합이 1이 되게 정규화한다. 마지막으로 이웃 특징을 해당 비율로 합쳐 대상 노드의 새 표현을 만든다. 논문의 점수 함수에는 학습 벡터와 LeakyReLU가 들어간다. 따라서 계수는 대상·이웃 특징과 대상의 이웃 집합에 의존하지만, 이 구조만으로 임의의 이웃 순위를 자유롭게 구현한다고 주장할 수는 없다.
학습을 안정화하려고 여러 attention head를 쓴다. 중간층에서는 각 head 출력을 이어 붙이고, 마지막 분류층에서는 head들의 출력을 평균한다. 이는 하나의 head가 항상 같은 이웃 패턴을 찾는다는 보장이 아니라, 여러 독립 파라미터의 집계를 쓰는 설계다. attention 계수는 대상 노드별로 정규화되므로 \alpha_{ij}와 \alpha_{ji}도 일반적으로 다를 수 있다.
3. 예로 보기
논문 인용 그래프에서 한 논문 노드가 여러 이웃 논문과 연결돼 있다고 하자. 제목·키워드 특징이 비슷한 이웃은 높은 점수를 받을 수 있고, 관련이 덜한 이웃은 낮은 점수를 받을 수 있다. 하지만 모든 가중치는 최종 라벨 분류 손실을 줄이도록 공동 학습된다. 특정 이웃을 제거했을 때의 예측 변화, 라벨 교란 실험, 전문가 주석 같은 별도 검증 없이 가중치만 보고 “이 논문이 결정적 근거였다”고 말할 수는 없다.
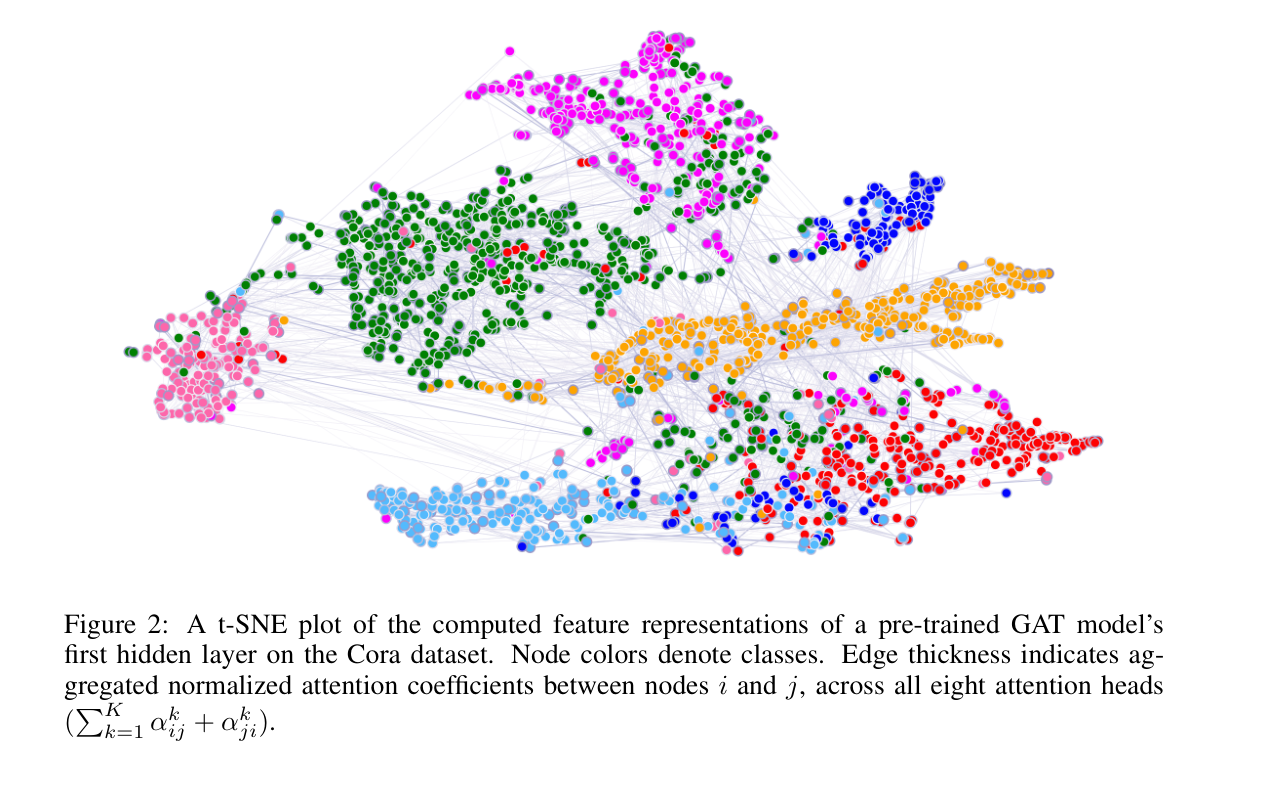
그림 2. Veličković et al. (2018), Figure 2, PDF p. 9의 원도판. Cora에서 첫 hidden layer 표현을 t-SNE로 투영한 예다. 투영의 분리는 2차원 시각화이며 out-of-sample 성능이나 attention 해석의 검증은 아니다.
4. 저자 보고 결과
transductive 인용 그래프에서 GAT은 100회 평균 test accuracy를 보고했다. Cora는 83.0±0.7%, Citeseer는 72.5±0.7%, Pubmed는 79.0±0.3%였다(Table 2). 같은 표에 실린 기존 발표 GCN 수치 81.5%, 70.3%, 79.0%와 비교하면 Cora는 1.5%포인트, Citeseer는 2.2%포인트 높고 Pubmed는 동률이다. 본문이 Citeseer에서 말하는 1.6%포인트는 GAT 72.5%와 별도의 *GCN-64 재실행 70.9%**를 비교한 값이다. 비교 대상을 바꾸면 차이도 달라진다.
PPI inductive 설정에서는 훈련 때 보지 못한 두 테스트 그래프의 노드에 대해 10회 평균 micro-F1을 보고했고, GAT은 0.973±0.002, 동일 구조에서 attention을 상수로 둔 Const-GAT은 0.934±0.006이었다(Table 3). Const-GAT 비교는 이 설정에서 학습된 attention의 효과를 살피는 통제 실험이다. 그러나 표의 다른 기준선 중에는 이전 연구의 보고값을 가져온 수치도 있다. 표 전체의 모델 순위를 동일한 재현 조건의 확정 순위로 읽어서는 안 된다.
5. 적용 조건과 한계
GAT은 노드 특징과 이웃 연결이 있고, 이웃별 중요도가 과제에 따라 달라질 수 있는 분류·예측에 적합하다. Cora/Citeseer에서는 첫 층 8개 head×8 feature, PPI에서는 세 층과 더 큰 head 구성을 썼다. 이 논문의 ‘GAT’ 성능은 하나의 고정된 작은 구성의 보편 성능이 아니다.
또한 한 층의 attention은 한-hop 이웃에서만 정규화되며, 여러 층을 쌓으면 더 먼 정보와 over-smoothing·비용 문제가 생길 수 있다. 그래프가 관계 타입·시간·방향을 가진다면 원래 GAT의 단일 인접 관계 표현만으로 그 의미를 자동 구분하지 않는다. 운영 환경에서는 이웃 수, 메모리, 분할 방식, head 수와 dropout을 해당 데이터에서 다시 점검해야 한다.
더 긴 수식·표 분석은 심화 보기에서 확인할 수 있다.
References
Veličković, P., Cucurull, G., Casanova, A., Romero, A., Liò, P., & Bengio, Y. (2018). Graph attention networks. International Conference on Learning Representations. https://arxiv.org/abs/1710.10903