Harness-Zero: Harness Distillation via Agent-as-Harness
외부 하네스가 대신 수행하던 검사와 작업 절차를 모델 자신의 행동으로 옮길 수 있을까. 실행 전 검토와 증류 과정을 설명하고, 도메인별 학습 결과와 행동 회복률의 의미를 살펴본다.
Paper: Haoran Ye; Yuxing Lu; Haonan Dong; Zhaochen Su; Guojie Song (2026). Harness-Zero: Harness Distillation via Agent-as-Harness. arXiv:2609.24974v1. 논문 PDF · HTML · 공식 저장소. 이 글은 25쪽의 v1을 기준으로 한다.
Abstract: 에이전트 하네스는 도구 사용과 상태 관리, 검사와 실행 순서를 조직해 모델의 성능을 높인다. 하지만 외부 시스템이 대신 수행한 절차가 모델 자체의 능력으로 남는 것은 아니다. Harness-Zero는 최적화된 하네스를 검토자용 안내로 바꾸고, 학생의 미실행 제안을 기본 실행 환경에 맞는 행동으로 고치게 한다. 이렇게 얻은 기록으로 학생을 학습하면 배포 때 전용 하네스와 검토자를 제거할 수 있다. 논문은 도메인별로 따로 학습한 Qwen3.5-9B의 세 벤치마크 점수 평균이 23.3%에서 44.3%로 높아지고, 선택된 28개 행동 패턴의 평균 회복률이 82.3%라고 보고한다. 이 글은 외부 안내를 실행 가능한 학습 신호로 바꾸는 방법과 결과의 범위를 구분하며, 이를 단일 통합 모델이나 하네스 없는 배포로 확대해 해석하지 않는다.
수식 없이 읽는 버전은 쉽게 읽는 Harness-Zero에 있다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 연구 질문 | 전용 하네스가 유도한 행동을 모델에 학습시켜 더 단순한 실행 환경에서도 활용할 수 있는가? |
| 핵심 방법 | 학생의 제안을 실행 전에 검토하고, 필요한 경우 학생의 도구와 관찰에 맞는 완전한 응답으로 교체한다. |
| 학습 대상 | 통과한 응답과 수정된 응답을 포함한 채택 궤적이다. 검토자의 비공개 토론 자체를 가르치지는 않는다. |
| 배포 구성 | 학습된 학생과 기본 하네스 h가 남는다. 전용 하네스 h⋆, 참조 안내 K, 검토자는 제거한다. |
| 학습 없는 비교 | 두 프론티어 모델×세 벤치마크에서 K 검토 조건은 평균 81.1%, 코드 하네스 조건은 78.1%다. 같은 계산량 비교는 아니다. |
| 증류 결과 | 세 지표 평균 23.3→44.3%. 도메인마다 따로 학습했으며, USPTO에서는 전용 하네스를 붙인 기본 모델에 못 미친다. |
| 행동 분석 | 82.3%는 선택된 지지 과제에서 계산한 28개 패턴별 회복률의 평균이다. 과제 성공률이나 성능 개선의 원인 비중이 아니다. |
| 남은 검증 | 공동 학습 단일 모델, 반복 실행의 변동, 전체 비용, 공개 실행 설정과 논문 결과의 대응을 추가로 확인해야 한다. |
목차
- 성공한 기록을 그대로 따라 하면 되는가
- 실행 환경과 전용 하네스와 참조 안내
- 실행 전에 고치되 학생이 할 수 있는 행동으로
- 채택된 궤적을 학습한다
- 학습 없는 검토는 무엇을 개선했는가
- 전용 하네스를 제거한 뒤의 성능
- 수집 성공률과 학습 가치는 다르다
- 행동 회복률은 성능의 원인을 말해 주는가
- 비용과 공개 구현에서 확인할 조건
- 적용 범위와 결론
1. 성공한 기록을 그대로 따라 하면 되는가
스프레드시트의 빈칸을 채운 뒤 파일을 저장하는 작업을 생각해 보자. 외부 검사기가 원본과 결과를 비교해 이미 채워져 있던 예시 셀의 변경을 막으면, 모델이 놓친 실수를 보완할 수 있다. 그러나 성공 기록을 학습한 모델이 같은 검사를 스스로 수행하리라는 보장은 없다. 검사기가 대신 한 일이 모델 자신의 행동으로 충분히 드러나지 않을 수 있기 때문이다.
전용 도구도 마찬가지다. 풍부한 하네스에서 제공하던 도구 이름을 그대로 학습해도, 배포 환경에 그 도구가 없으면 사용할 수 없다. 성공한 답을 모방하는 것과 다른 실행 환경에서 같은 절차를 수행하는 것은 다르다.
Harness-Zero는 하네스가 제공하는 도구·미들웨어·스킬·기억을 학습 시점의 안내로 사용하되, 그 의도를 학생의 기본 행동 공간으로 다시 표현한다. 전용 검사 도구를 부르는 대신 학생이 Python 코드를 작성하고 bash로 실행해 검증하는 식이다. 하네스 코드를 가중치에 그대로 압축하는 것이 아니라, 외부 시스템이 유도하던 행동을 실행 기록으로 드러내어 모방 학습한다. 논문 §1
2. 실행 환경과 전용 하네스와 참조 안내
| 기호 | 역할 | 사용 주체 |
|---|---|---|
| h | 고정 표적 하네스. 논문의 기본 설계는 시스템 프롬프트와 bash 실행 도구를 갖춘 mini-SWE-agent 방식이다. | 수집 중의 학생과 증류 후 학생 |
| h⋆ | 학습 과제의 실패를 분석해 개선한 전용 하네스. 도구·미들웨어·스킬·기억을 포함한다. | 코드 하네스 비교 조건의 학생 |
| K | h⋆를 h에 맞춰 검토자용으로 적응한 비공개 참조 안내다. | 검토 에이전트 |
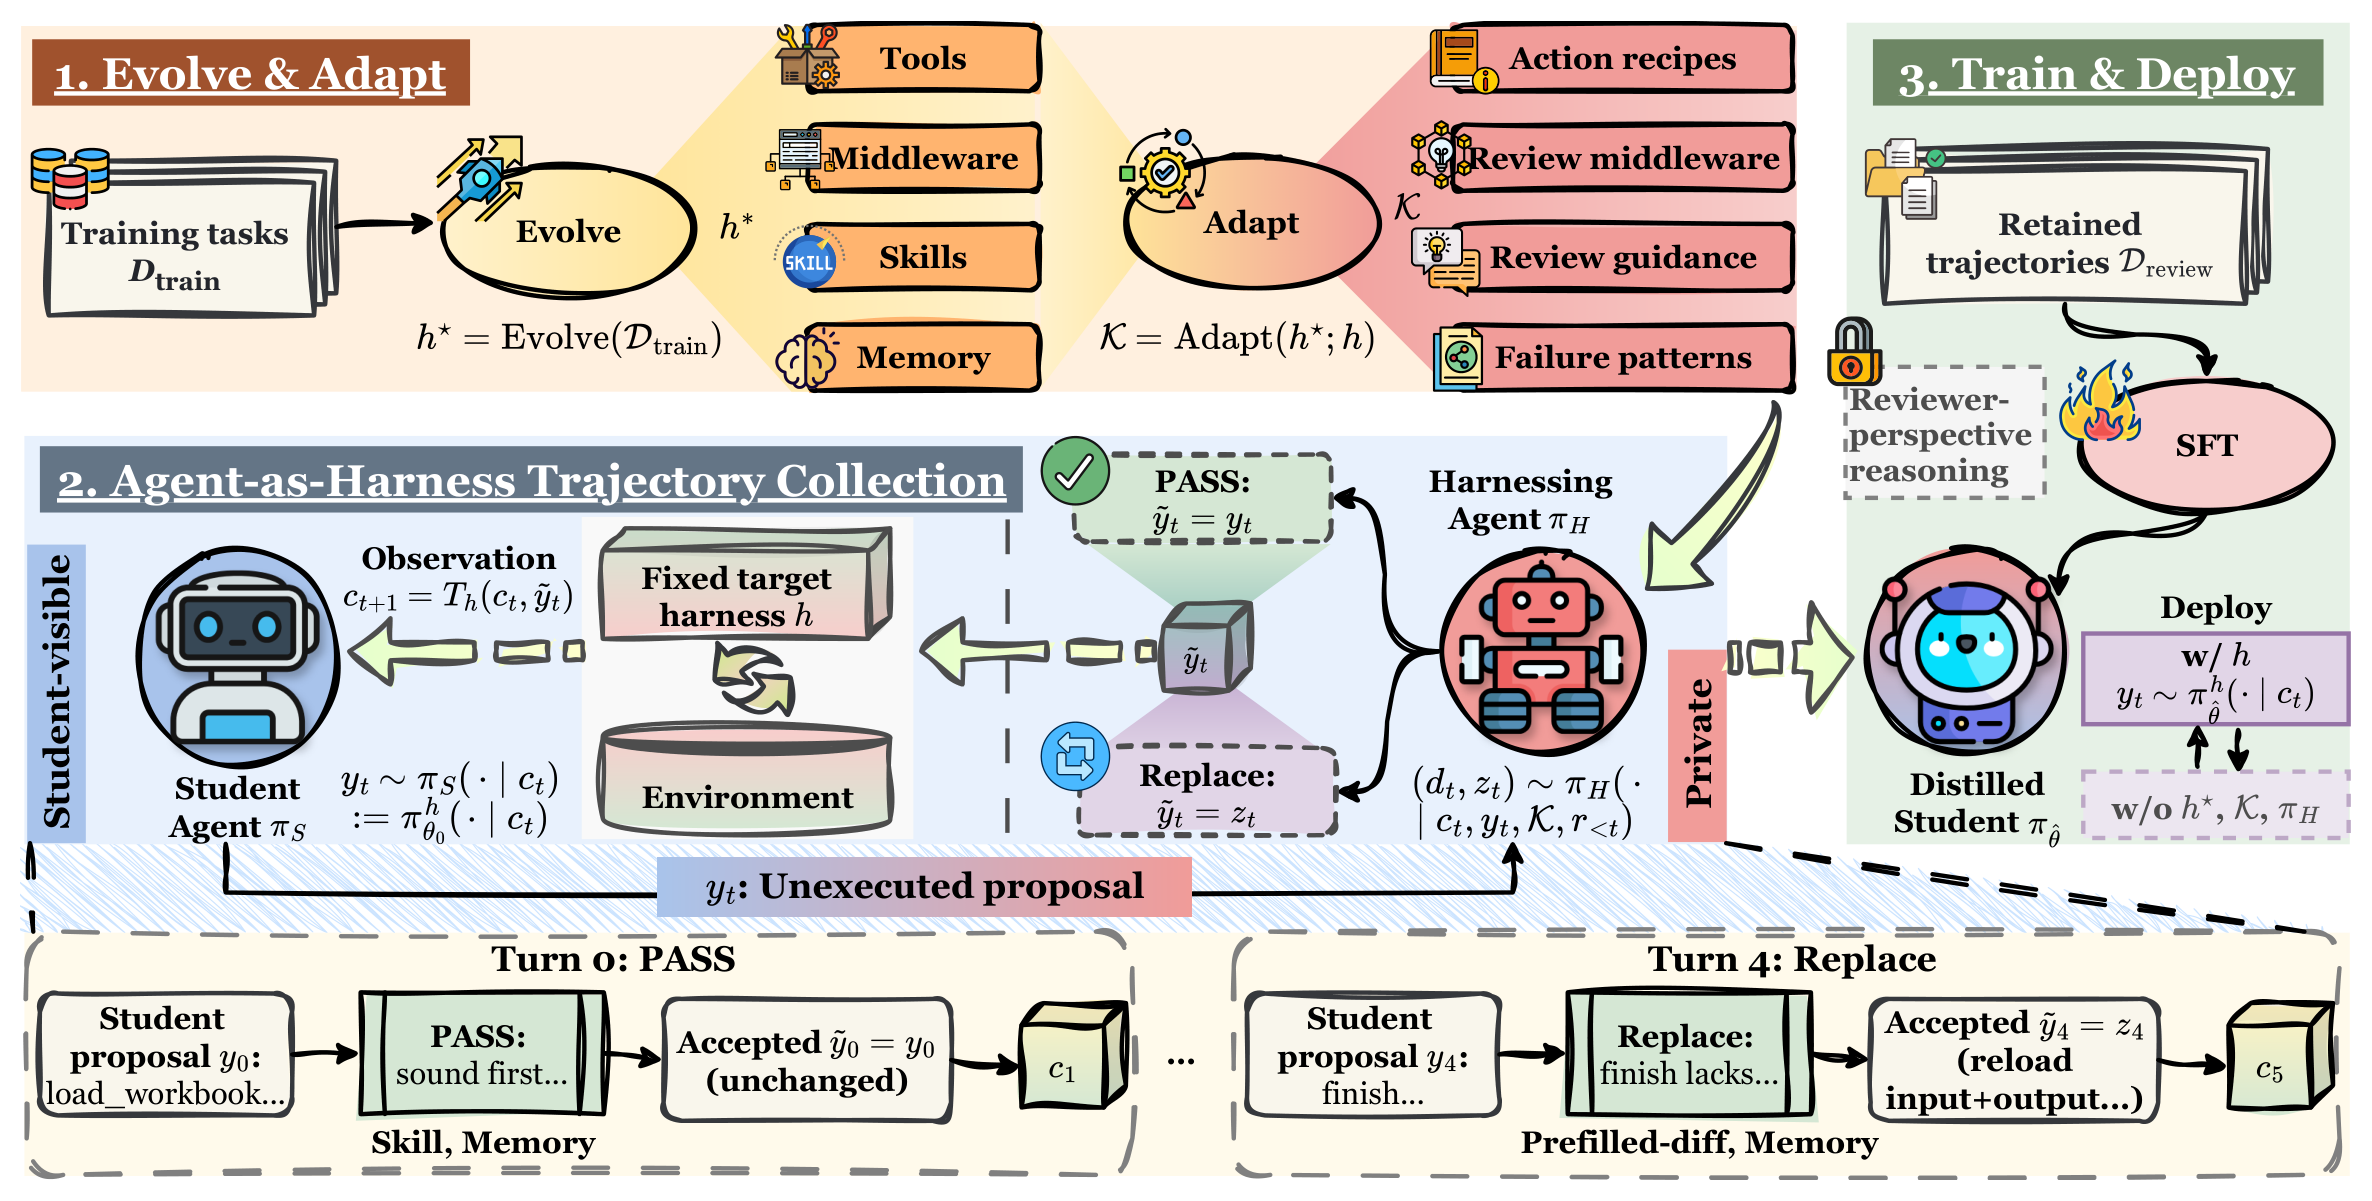
Figure 1. 검토자가 전용 하네스의 안내를 학생의 실행 가능한 행동으로 옮기고, 채택된 궤적으로 학생을 학습한다. 배포 때 전용 하네스와 검토자는 제거하지만 기본 하네스 h는 남는다. 논문 v1, 4쪽 Figure 1에서 도판 영역을 추출해 인용.
첫 단계는 **h⋆ = Evolve(D_train), K = Adapt(h⋆; h)**다. 구현에서는 학습 과제의 반복 실패를 분석해 하네스를 세 라운드 개선한다. 이후 도구는 학생이 동등한 행동을 구성할 수 있는 명세로, 미들웨어는 검토 시점의 조건과 경고로, 스킬과 기억은 판단 기준과 개입 안내로 바뀐다. 이 적응은 단순한 파일 복사나 일대일 변환이 아니다. 논문 §3.1
부록 B의 스프레드시트 예에서 전용 하네스는 완료 시점에 입력·출력 워크북을 비교한다. 검토자용 안내는 대신 학생 기록에 검증의 증거가 있는지 확인한다. 증거 없이 완료하려 하면, 완료 선언을 원본과 결과를 다시 읽고 비교하는 bash·Python 행동으로 바꾸도록 안내한다. 검사와 그 결과가 학생에게 보이는 궤적에 들어간다는 것이 중요하다. 논문 부록 B.2
3. 실행 전에 고치되 학생이 할 수 있는 행동으로
학생은 현재 이력 c_t를 보고 다음 응답 y_t를 제안한다. 검토 에이전트는 아직 실행되지 않은 응답을 읽고 두 결정 중 하나를 제출한다.
- PASS: 원래 제안을 그대로 채택한다.
- REPLACE: h에서 실행할 수 있는 완전한 학생 응답으로 교체한다.
채택 응답을 ỹ_t라고 하면 실제 실행은 **c_(t+1) = T_h(c_t, ỹ_t)**다. 거부된 제안은 실행하지 않는다. 검토자의 이유와 어떤 비공개 컴포넌트를 읽었는지는 학생 궤적과 분리한다. 논문 §3.2
검토자는 학생의 과제와 채택 응답, 학생에게 돌아온 환경 관찰, 현재 제안, K와 자신의 이전 검토 이력을 읽는다. 반면 학생 샌드박스를 별도로 조회하거나 학생에게 보이지 않은 환경 상태와 숨은 정답·검증자 피드백에 직접 접근하지는 않는다. 추가 증거가 필요하면 학생이 할 수 있는 읽기나 검사 행동을 제안해야 한다. 뒤의 오라클 답 절제 실험은 정답 접근을 허용한 별도 조건이다.
업데이트마다 submit_review를 제출하며, REPLACE는 조언이 아니라 추론·내용·선택적 도구 호출을 갖춘 완전한 응답이다. PASS에 대체 응답을 넣거나 REPLACE에 대체 응답이 없는 제출은 거부한다. 유효한 검토가 끝내 나오지 않으면 시행이 실패한다. 논문 부록 C
프롬프트는 건전한 제안과 유용한 탐색은 통과시키고 필요한 경우에만 작게 고치도록 지시한다. 다만 최소 수정은 정책이지 측정 결과가 아니다. 수집 조건별 실제 대체율이나 교사 작성 토큰 비율은 보고되지 않는다. 프롬프트의 on-policy도 학생의 진행 중인 시행과 가시 정보, 고유 행동 공간을 따른다는 뜻이다. 교정이 다음 상태를 바꾸므로 모든 궤적이 수정되지 않은 학생 정책에서만 나왔다는 보장은 아니다.
4. 채택된 궤적을 학습한다
학습 목적은 채택 응답의 지도 미세조정이다. 통과한 학생 응답과 검토자가 바꾼 응답을 모두 사용한다.
L(θ) = −Σ_(τ∈D_review) Σ_t log π^h_θ(ỹ_t | c_t)
배포 때 h⋆, K, 검토자는 제거하지만 도구 실행 인터페이스와 환경은 남는다. 부록 E.1은 bash 실행과 파일시스템, 같은 기본 모델에 단일 수준으로 위임할 수 있는 agent CLI도 설명한다. 저자들은 이 연구의 진화 하네스가 서브에이전트에 의존하지 않았고 위임은 드물게 사용되었다고 밝힌다. 논문 §3.3 · 부록 E.1
| 도메인 | 학습 과제 | 평가 대상 | 보고된 학습 궤적 | 보존 규칙 |
|---|---|---|---|---|
| SpreadsheetBench Verified | 300 | 100과제, pass@1 | 487 | 성공하고 실행 예외가 없는 시행 |
| AppWorld | 147 | test_normal 168과제, 56시나리오의 SGC | 282 | 성공하고 실행 예외가 없는 시행 |
| USPTO Retrosynthesis | 500 | 별도의 100과제, pass@1 | 500 | 실패도 포함한 수집 시행 |
과제 수와 궤적 수는 다르다. 같은 과제에서 여러 시행을 수집할 수 있다. 출처: §4.1 및 부록 D.
비공개 경로, 검토 도구 이름, 내부 메타데이터 등의 표지가 학생용 기록에 남으면 궤적을 제거한다. REPLACE 응답 중 정규식에 걸리는 검토자 관점의 추론 구간은 학습 손실에서 가린다. 모든 교사 추론을 지우는 것이 아니며, 문자열 필터가 모든 의미적 정보 누출을 막는다는 보장도 아니다. 논문 부록 D
학생은 Qwen3.5-9B, 수집의 검토자는 GPT-5.6 Sol이다. LoRA rank와 α는 각각 32, 배치는 8, 최대 시퀀스 길이는 65,536토큰이며 두 에폭 학습한다. 각 도메인은 자기 궤적으로 따로 학습한다. 같은 하네스를 쓰는 것과 하나의 통합 체크포인트를 쓰는 것은 다르다. 논문 부록 E.3
5. 학습 없는 검토는 무엇을 개선했는가
먼저 검토 자체의 효과를 묻는다. Table 1에서는 가중치를 학습하지 않고 같은 모델이 학생과 검토자 역할을 맡는다. 비교는 기본 h, 전용 코드 하네스 h⋆, 참조 없이 검토하는 빈 K, 진화한 안내 K를 읽고 검토하는 조건이다. 더 강한 검토자를 붙인 효과와 구분하려는 설계지만, 검토에는 추가 모델 호출이 필요하므로 같은 계산량 비교는 아니다.
| 벤치마크 | 모델 | h | h⋆ | 빈 K 검토 | K 검토 |
|---|---|---|---|---|---|
| SpreadsheetBench | DeepSeek-V4-Pro | 76.0 | 77.0 | 78.0 | 86.0 |
| SpreadsheetBench | GPT-5.6 Sol | 83.0 | 84.0 | 83.0 | 88.0 |
| AppWorld | DeepSeek-V4-Pro | 75.0 | 91.1 | 76.8 | 89.3 |
| AppWorld | GPT-5.6 Sol | 96.4 | 94.6 | 94.6 | 96.4 |
| USPTO | DeepSeek-V4-Pro | 31.0 | 56.0 | 30.0 | 60.0 |
| USPTO | GPT-5.6 Sol | 50.0 | 66.0 | 53.0 | 67.0 |
| 여섯 설정 평균 | — | 68.6 | 78.1 | 69.2 | 81.1 |
단위는 %. AppWorld는 세 과제를 묶은 시나리오의 목표 완료율(SGC), 나머지는 과제 pass@1이다. 평균은 표본을 합친 성공률이 아니라 설정별 점수의 동일 가중 평균이다. 논문 Table 1.
빈 K의 평균은 기본 h와 가깝고, K를 제공하면 평균이 높아진다. 이는 단순히 한 번 더 생각하게 하는 것보다 구체적인 절차 안내가 유용했음을 시사한다. K 검토는 h⋆보다 여섯 설정 중 다섯에서 높지만, AppWorld의 DeepSeek 조건에서는 1.8%p 낮다. 또 h⋆는 Qwen3.5-9B용으로 진화시킨 것을 재사용한다. 각 프론티어 모델에 맞춰 다시 최적화한 최선의 코드 하네스와 비교한 결과는 아니다.
논문의 상대 개선 27.6%는 설정별 (K 점수−h 점수)/h 점수를 평균한 값이다. 표시된 평균끼리 계산하는 (81.1−68.6)/68.6의 약 18.2%와는 집계 순서가 다르다. 낮은 기본 점수에서의 개선은 상대 비율로 더 크게 나타난다. 어느 하나가 다른 하나의 오기인 것은 아니지만, 27.6%를 평균 점수의 상대 상승으로 소개하면 안 된다.
K와 h⋆의 평균 차이는 3.0%p다. 논문은 반복 실행의 분산이나 과제별 짝지어진 결과를 제공하지 않으므로 이 표만으로 그 차이의 통계적 유의성을 판단할 수 없다. 서로 다른 여섯 모델·벤치마크 셀을 독립 반복처럼 취급하는 검정도 적절하지 않다.
6. 전용 하네스를 제거한 뒤의 성능
Table 2는 다른 질문을 묻는다. 검토를 붙인 채 잘하는가가 아니라, 검토 궤적으로 학습한 학생이 h만으로 얼마나 잘하는가다. 증류 행의 각 도메인은 별도로 학습한 Qwen3.5-9B 체크포인트이며 검토자는 배포에 참여하지 않는다. 기본 모델에 여러 실행 하네스를 붙인 조건은 외부 지원만으로 얻는 성능을 보여 준다.
| 조건 | SpreadsheetBench | AppWorld | USPTO | 평균 |
|---|---|---|---|---|
| 기본 모델 + h | 31.0 | 26.8 | 12.0 | 23.3 |
| 기본 모델 + h⋆ | 39.0 | 48.2 | 38.0 | 41.7 |
| 기본 모델 + DeepAgents | 35.0 | 19.6 | 7.0 | 20.5 |
| 기본 모델 + Claude Code | 31.0 | 10.7 | 6.0 | 15.9 |
| 도메인별 Harness-Zero + h | 44.0 | 58.9 | 30.0 | 44.3 |
단위는 %. 평균은 세 벤치마크 지표를 동일 가중한다. Claude Code 행도 같은 기반 모델을 연결한 하네스 비교이며, Claude 모델 자체의 점수가 아니다. 논문 Table 2.
표시된 평균 기준으로 기본 h 대비 21.0%p, 기본 h⋆ 대비 2.6%p 높다. 하지만 도메인별 모양은 다르다. SpreadsheetBench와 AppWorld에서는 h⋆보다 각각 5.0%p, 10.7%p 높고, USPTO에서는 8.0%p 낮다. 전용 하네스의 모든 이득을 일관되게 대체했다는 결과는 아니다.
저자들은 파일을 읽고 검증하는 절차와 화학적 후보를 만드는 지식의 전이 난도 차이로 이를 해석한다. 가능한 설명이지만, 절차와 지식만 따로 바꾼 실험은 아니다. 도메인·과제·하네스 구성의 여러 차이가 함께 존재한다. DeepAgents나 Claude Code의 점수 역시 이 기반 모델과 과제 설정에서의 결과이지 해당 프레임워크의 보편적 순위가 아니다.
이 비교는 추가 GPT 안내 데이터와 SFT를 사용한 뒤의 배포 성능을 보여 준다. 같은 학습 예산으로 다른 개선 방법을 적용한 비교는 아니며, 기본 모델과 미세조정 모델의 제공 경로도 다르다. 따라서 결과를 읽을 때는 배포 구성의 단순화와 학습에 들인 자원을 별도로 보아야 한다.
7. 수집 성공률과 학습 가치는 다르다
좋은 시연은 학생도 잘 배우게 하는가? Table 3은 USPTO에서 궤적의 출처를 바꿔 이 질문을 살핀다. 각 조건은 같은 500개 학습 과제를 쓰고, 실패도 포함한 수집 궤적에 같은 학습 레시피를 적용한다. 왼쪽 성공률은 수집 단계, 오른쪽은 별도의 100개 시험 과제에서 학습된 학생이 h로 수행한 결과다.
| 궤적 출처 | 수집 성공률 | 증류 후 시험 pass@1 |
|---|---|---|
| 미학습 학생 | — | 12.0 |
| 교사 직접 수행 | 52.0 | 12.0 |
| 교사 + h⋆ | 62.0 | 3.0 |
| 학생 + h⋆ | 39.4 | 12.0 |
| 빈 K로 검토 | 44.2 | 11.0 |
| 오라클 답으로 검토 | 98.6 | 15.0 |
| K로 검토하는 Harness-Zero | 59.4 | 30.0 |
단위는 %. 수집 때의 성공률과 증류 후 시험 성능은 서로 다른 집합과 단계의 측정이다. 논문 Table 3.
전용 하네스를 쓴 교사는 수집에서 62.0%를 성공하지만 학생의 시험 성능은 3.0%다. 논문은 이 학생이 h에는 없는 도구를 자주 호출한다고 설명한다. 이는 성공 시연의 행동 공간이 배포 환경과 맞아야 한다는 문제를 잘 보여 준다. 반대로 Harness-Zero의 교체 응답은 처음부터 h에서 실행되므로, 학습과 배포 사이에 전용 도구 이름을 그대로 넘기지 않는다.
오라클 조건은 수집 성공률이 98.6%인데 시험에서는 15.0%에 그친다. 저자들은 답을 향한 지름길 정정보다 재사용 가능한 절차 안내가 전이에 유리하다고 해석한다. 다만 정답 접근이 어떤 행동을 거쳐 성능 차이를 만들었는지 직접 분리한 증거는 아니다. 여기서 확실한 관찰은 이 USPTO 비교에서 높은 수집 성공률이 더 높은 증류 성능을 보장하지 않았다는 것이다.
같은 과제 수와 학습 레시피를 맞췄다고 응답 길이·학습 토큰 수·수집 계산량까지 같은 것은 아니다. 또 USPTO는 실패 궤적도 사용한다. 논문은 전체 궤적을 쓰는 편이 성공만 쓰는 것보다 나았다고 적지만 그 비교 수치는 제공하지 않는다. 따라서 이 표로 성공 시연만 학습하는 모든 증류 방법의 우열까지 일반화할 수는 없다.
8. 행동 회복률은 성능의 원인을 말해 주는가
점수 외에 실제 수행 절차가 바뀌었는지도 살핀다. 논문은 하네스에서 행동 규칙을 추출하고, 실행 궤적에서 그 행동이 나타나는지 탐지한다. 패턴마다 기본 모델이 h⋆에서는 행동을 보였지만 h에서는 보이지 않은 시험 과제를 지지 집합으로 삼는다. 지지 과제가 10개 이상인 패턴만 남기고, 증류 모델이 그 집합에서 행동을 보이는 비율을 계산한다.
이 조건을 만족한 패턴은 SpreadsheetBench 18개, USPTO 6개, AppWorld 4개로 총 28개다. 82.3%는 이 28개 패턴별 조건부 회복률의 동일 가중 평균이다. 기본 h의 0%, 기본 h⋆의 100%는 바로 이 선택 규칙으로 만들어진 값이다. 전체 시험 집합에서 두 모델의 행동 빈도가 각각 0과 100이라는 뜻은 아니다.
예를 들어 저장한 워크북을 다시 여는 행동은 17/17, 이미 채워진 셀을 보호하는 행동은 24/26에서 회복된다. USPTO의 후보 집합 열거는 59/88, AppWorld의 전체 페이지 가져오기는 21/53이다. 같은 “회복” 안에서도 행동별 차이가 크다. 지지 과제가 적은 패턴과 많은 패턴은 평균에서 같은 비중을 갖는다. 논문 Table 4 및 부록 G
이 분석은 하네스가 유도하던 절차가 학생의 궤적에도 나타난다는 증거다. 그러나 행동을 탐지했다는 사실만으로 그 행동이 성능 향상의 원인임을 입증하지는 않는다. 기본 h·h⋆ 대조는 있지만 다른 SFT 조건들의 동일한 행동 회복률은 보고되지 않는다. 내부 표현에 무엇이 저장되었는지 직접 측정한 것도 아니다. 따라서 “하네스 기능의 82.3%를 완전히 복제했다”거나 “성능 이득의 82.3%를 설명했다”는 해석은 피해야 한다.
9. 비용과 공개 구현에서 확인할 조건
검토 능력과 시간 비용
검토자가 안내를 읽는다고 항상 더 좋은 실행 결정을 내리는 것은 아니다. 부록 Table 8의 Qwen3.6-35B-A3B는 h 16%, h⋆ 48%, 빈 K 12%, K 검토 36%다. −12%p는 K 검토가 h⋆보다 낮다는 뜻이며, 기본 h보다 낮다는 뜻이 아니다. DeepSeek-V4-Flash에서도 K 검토는 57%로 h⋆의 58%보다 낮다. 같은 모델이 학생과 검토자를 맡는 실험이므로, 이것만으로 교사가 반드시 학생보다 강해야 한다는 필요조건을 세울 수는 없다. 논문 부록 F
또 검토는 학생의 다음 실행을 기다리게 한다. 논문이 보고한 USPTO 평균 시행 지연은 K 검토 237.2초, 기본 mini-SWE-agent 100.1초로 약 2.4배다. 이는 특정 설정의 지연시간이지 금전 비용이나 전체 데이터 수집 비용의 배율이 아니다. 증류 후 검토 호출은 없어지지만, 학습된 학생의 행동 길이까지 고려한 실제 종단간 속도 향상은 별도로 측정되지 않았다.
공개된 자료와 재현 레시피를 구분하기
공식 저장소의 고정 커밋 aa63a7751997969c2880896f9df3098c7f650fe2에는 검토 프로토콜, 학생 실행 래퍼, 궤적 수집과 SFT 코드, 하네스 뱅크가 있다. 과제 데이터 안내는 세 벤치마크의 과제와 분할을 제공한다. 공개 과제 파일과 검토를 거친 SFT 궤적은 서로 다른 자료다.
Hugging Face에도 세 도메인용 가중치가 공개되어 있다. 아래는 확인한 리비전에 고정한 링크다.
앞의 두 모델은 전체 체크포인트 파일 형태이고, USPTO는 어댑터와 출력 헤드 델타 적용 안내를 포함한다. 세 공개물을 모두 같은 형태의 어댑터라고 부르거나, 별도 확인 없이 같은 로딩 절차를 적용해서는 안 된다.
실행 예제와 논문 조건 사이에는 확인할 차이도 있다. 고정 커밋의 AppWorld README는 공식 ReAct 시연을 포함한 23개 teaching messages와 system 메시지를 초기 맥락으로 설명한다. 이는 논문 E.1의 과제 외 최소 고정 프롬프트 설명과 구분할 필요가 있다. 다만 공개 코드의 이 구성만으로 논문 실험에 같은 초기 맥락이 쓰였다고 단정하거나 데이터 누출을 주장할 근거는 없다.
또 공개 Quickstart의 USPTO 예제는 --reward-threshold 1.0으로 성공 궤적만 선별한다. 논문 부록 D의 실패 포함 500개 수집 궤적 학습과 다르므로, 이 예제를 그대로 논문 재현 명령으로 간주하면 안 된다. 실패 궤적 지원 자체가 없다는 뜻도 아니다.
이 글은 논문과 공개 자료를 대조했으며 코드·모델·벤치마크를 실행하지 않았다. 공개 코드와 과제·가중치의 존재는 확인할 수 있지만, 논문에 사용된 검토 SFT 세션과 실행별 설정·로그까지 대응시킨 재현은 아니다. 현재 공개 구현이 논문의 각 표를 산출한 바로 그 실행본이라는 주장 역시 하지 않는다.
10. 적용 범위와 결론
Harness-Zero의 중요한 기여는 외부 하네스를 학습 신호의 출처로 바꾼다는 데 있다. 검토자가 대신 답을 완성하고 학생에게 결과만 주는 대신, 학생이 가진 관찰과 도구로 실행 가능한 다음 행동을 만든다. 그 행동이 실제 환경에서 수행되고 결과가 이력에 남기 때문에, 학생은 전용 도구의 이름뿐 아니라 검사하고 복구하는 절차를 학습할 수 있다.
확인된 범위는 세 도메인의 별도 학습과 특정 표적 하네스다. 공동 학습한 하나의 모델이 여러 전용 하네스의 이득을 함께 유지하는지, 새로운 도메인이나 다른 실행 환경으로 옮겨도 유지되는지는 아직 평가되지 않았다. 맥락 관리나 자원 통제처럼 응답 하나로 표현하기 어려운 하네스 기능도 남는다. 모델이 검증을 배우는 것과 외부의 안전·실행 경계를 없애는 것은 별개의 일이다.
따라서 이 연구는 “하네스가 더는 필요 없다”는 결론보다 좋은 외부 규칙을 학생 자신의 실행 가능한 행동으로 번역하면 배포 시 외부 지원 일부를 줄일 수 있다는 결과로 읽는 편이 정확하다. 실제 적용에서는 어떤 절차를 행동으로 표현할 수 있는지, 학생에게 필요한 관찰이 있는지, 수집과 학습에 들인 비용에 비해 배포에서 얻는 이득이 충분한지를 함께 확인해야 한다.
References
- Ye, H., Lu, Y., Dong, H., Su, Z., & Song, G. (2026). Harness-Zero: Harness Distillation via Agent-as-Harness. arXiv:2609.24974v1. 방법 §3, 실험 §4, 구현·행동 분석 부록 B–G.
- MetaEvo AI. Harness-Zero 공식 코드·과제·하네스 자료. 고정 커밋 aa63a77. 도메인별 공개 가중치는 9절의 고정 리비전 링크 참조.