H+ Embedding: Harmonizing Global and Token-Level Retrieval with Context-Dependent Phrases
문서 하나의 벡터와 토큰 전부 사이에서 문맥별 구절을 만들고, 중요도에 따라 남겨 검색한다. 분할·선택·가중 상호작용의 원리부터 후보집합·벡터 예산·언어에 따른 성능과 비용의 적용 범위까지 읽는다.
Paper: Shusen Zhang; Junyi Hu; Ye Feng; Ziteng Wang; Zhaoyuan Pan; Xiaojun Yuan; Jiangshou Hong; Guosheng Dong; Xiangzhi Wang (2026). "H+ Embedding: Harmonizing Global and Token-Level Retrieval with Context-Dependent Phrases". arXiv:2608.00065v3. PDF.
Abstract: 문서 전체를 벡터 하나로 압축하면 세부 개념의 대응을 놓칠 수 있고, 토큰마다 벡터를 남기면 저장과 채점 부담이 커진다. H+ Embedding은 문맥에 따라 구절을 나누고 남은 토큰을 단일 단위로 유지한 뒤, 중요도가 높은 단위를 골라 질의 가중 MaxSim으로 문서를 비교한다. 검색 표현과 구절 경계는 공동으로 학습하지만 경계에는 교사의 BIO 레이블을 쓰며, 추론의 Phrase 점수를 직접 최적화하는 별도 손실은 없다. 저자들은 16개 과제에서 Global 상위 1,000개 후보를 Phrase로 재순위화했을 때 macro nDCG@10이 34.28에서 41.19로 높아졌다고 보고한다. 별도의 네 과제 공통 후보집합에서는 배포형 Phrase가 Token의 62.95에 가까운 62.94를 기록하면서 문서 벡터를 평균 13.7% 적게 사용했다. 이는 검색 단위를 문맥에 맞추는 접근의 가능성을 보여 주지만 모든 언어·벡터 예산에서의 우위나 전체 검색 시스템의 비용 절감을 입증한 것은 아니다.
Executive Summary
| 항목 | 핵심 |
|---|---|
| 질문 | 문서 하나와 토큰 전부 사이에, 함께 매칭할 검색 단위를 둘 수 있는가? |
| 방법 | 공유 인코더 → CRF 구절 분할 → 중요도 Top-B 선택 → 질의 가중 MaxSim. |
| 학습 | Global·Token·Lexical 검색 감독과 교사의 BIO 경계 감독을 결합한다. 별도 Phrase retrieval loss는 없다. |
| 주 결과 | 16개 과제·Global top-1,000 재순위화에서 34.28 → 41.19 nDCG@10, +6.91점. |
| 토큰 비교 | 별도 네 과제·union A에서 Phrase 62.94 / Token 62.95, 문서 벡터 평균 −13.7%. 통계적 동등성 검증은 아니다. |
| 예산과 언어 | 19개 과제에서 Phrase는 Token보다 높지만, 전체 다국어 평균에서는 Whole word·Equal chunks가 더 높다. |
| 비용 | 지역 벡터 FP16 payload 감소는 근거가 있다. 전체 인덱스 저장량·end-to-end 지연의 감소와는 구별한다. |
| 판단 | 분할·선택·가중의 결합이 유망하다. 독립 Phrase 검색, 언어별 강한 대조군, 재현 가능한 학습 자료는 추가 확인이 필요하다. |
목차
- 벡터 하나와 토큰 전부 사이
- 문맥으로 구절을 만들고 남은 토큰을 보존한다
- 중요도로 선택하고 질의별로 가중한다
- 검색 표현과 경계는 다른 신호로 배운다
- 무엇을 같은 조건에서 비교했는가
- 전역 후보의 순서를 바꾸면 얼마나 좋아지는가
- 같은 벡터 예산에서 어떤 단위가 유리한가
- 경계 위치와 중요도는 각각 무엇을 더하는가
- 벡터를 줄인 이득은 어디까지 측정됐는가
- 문맥 의존 검색 단위의 가치와 적용 조건
1. 벡터 하나와 토큰 전부 사이
“metformin in patients with type 2 diabetes and chronic kidney disease”를 검색한다고 하자. 당뇨라는 주제뿐 아니라 특정 약물·질환명·동반 조건을 함께 비교해야 한다. 이는 설명용 예시이지 실제 평가 질의나 임상 판단이 아니다.
전역 검색은 질의와 문서를 각각 벡터 하나로 압축한다. 대규모 코퍼스 검색에 편리하지만 여러 개념이 한 점으로 합쳐진다. 반대편의 ColBERT식 늦은 상호작용은 문맥화된 토큰 벡터를 유지하고 질의 토큰마다 가장 비슷한 문서 토큰을 찾는다. 토큰은 단어보다 작은 서브워드일 수 있다. 세밀한 대응을 남기는 대신 문서 길이에 따라 저장·비교 비용이 늘어난다(Khattab & Zaharia, 2020).
H+의 질문은 **함께 대응시킬 지역 단위를 문맥에 맞게 만들고 제한된 벡터 예산을 배분할 수 있는가?**다. “type 2 diabetes”를 하나로 볼 수 있지만, 늘 두 토큰씩 묶거나 공백마다 자르는 규칙으로 일반화하기는 어렵다.
H+는 CRF로 구절을 나누고 중요도 머리로 남길 단위를 고른 뒤 가중 MaxSim으로 비교한다. 분할은 가능한 단위를, 선택은 예산 배분을, 가중은 질의 단위별 기여를 정한다. 구절 임베딩이라는 이름보다 이 세 결정의 결합이 핵심이다.
2. 문맥으로 구절을 만들고 남은 토큰을 보존한다
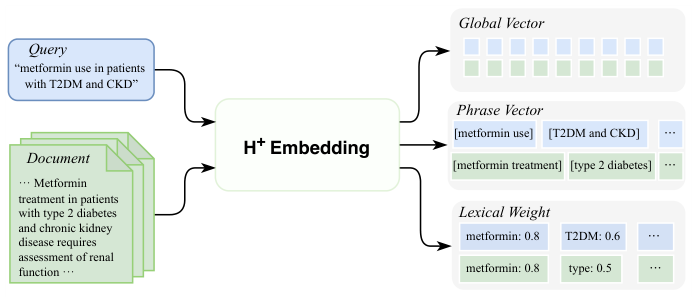
Figure 2. 하나의 텍스트를 전역·구절·어휘 관점으로 표현한다. 출처: Zhang et al. (2026), PDF v3, p. 2.
공유 양방향 인코더
초기 모델은 Qwen3-0.6B-Base이며 Qwen3-Embedding checkpoint가 아니다. Causal mask를 padding-aware bidirectional mask로 바꿔 양쪽 문맥을 보게 한다. 질의와 문서는 같은 인코더로 각각 독립 인코딩하므로 문서 표현을 미리 저장할 수 있다(Zhang et al., 2026, §3.1).
Hidden size는 1,024이며 검색 벡터 폭은 r다. MRL은 벡터 앞부분도 유용하도록 학습한다(Kusupati et al., 2022). MRL-128은 앞 128차원을 쓴다. 벡터의 폭 128과 단위 개수 상한 128은 다른 압축 축이다.
Global은 전체 토큰 상태를 평균한 뒤 L2 정규화한다. Phrase는 같은 상태에서 출발하되 평균 범위를 구절 내부로 좁힌다.
BIO 분할과 singleton
선형 체인 CRF는 각 토큰에 B, I, O 레이블을 붙인다. B는 새 구절의 시작, 뒤따르는 I는 그 구절의 연장이다. O는 삭제 표시가 아니라 singleton, 즉 토큰 하나짜리 단위가 된다. 이 구절과 singleton을 합치면 모든 토큰 위치가 정확히 하나의 단위에 속하는 완전한 partition이 만들어진다. 문맥이 달라지면 같은 표면 문자열도 다른 경계를 가질 수 있다.
구절 s의 벡터는 해당 토큰 상태의 평균을 정규화한 것이다. h_i^{(r)}는 선택한 폭의 토큰 상태이고, norm은 L2 정규화를 뜻한다.
\bar h_s^{(r)}=\frac{1}{|s|}\sum_{i\in s}h_i^{(r)}p_s^{(r)}=\operatorname{norm}(\bar h_s^{(r)})모든 토큰을 보존하는 것은 Top-B 선택 전이다. 완전한 분할을 만든 다음 예산에 따라 일부 단위를 제외한다. 구절 평균 역시 상호작용 단위를 바꾸는 압축이지 토큰별 유사도를 그대로 보존하는 변환은 아니다.
추론에는 용어 사전에 따른 결정적 경계 override인 trie를 더할 수 있다. 16개 과제의 broad-deployed는 CRF+trie, 통제된 경계·예산 실험은 CRF-only다. 이후 결과도 이 조건을 구분한다.
3. 중요도로 선택하고 질의별로 가중한다
남길 단위를 정하는 중요도
각 토큰의 중요도는 공유 상태에 선형 변환을 적용하고 softplus를 통과시켜 만든다. softplus 출력은 양수이고 상한이 없으며, 전체 합이 1인 확률 분포가 아니다. 구절 중요도는 내부 토큰 중요도의 합이다.
u_{x,i}=\operatorname{softplus}(w^{\top}h_i+b)a_x(s)=\sum_{i\in s}u_{x,i}각 텍스트에서 a_x(s)가 큰 단위를 최대 B개 남기며 질의·문서 예산 B_q, B_d를 따로 둘 수 있다. 완전한 partition이므로 중요도 총합은 선택 전 보존된다. Top-B와 MaxSim 이후 검색 점수가 보존되거나 토큰 검색과 동등하다는 뜻은 아니다.
MaxSim은 질의 단위마다 가장 잘 맞는 문서 단위를 찾는다
선택된 질의·문서 단위 집합을 각각 Q, D라고 쓰자. 먼저 각 질의 단위 s에 대해 문서 안에서 최대 내적을 찾는다. 그 값을 질의 중요도로 가중한 뒤 더한다.
m_s(q,d)=\max_{t\in D}p_{q,s}^{\top}p_{d,t}S_P(q,d)=\sum_{s\in Q}a_q(s)\,m_s(q,d)문서 중요도는 선택에만, 질의 중요도는 선택과 가중에 모두 쓰인다. 문서 중요도를 내적에 다시 곱하지 않는다. 여러 질의 단위가 같은 문서 단위를 골라도 되므로 일대일 대응도 아니다(Zhang et al., 2026, §3.3).
Global·Lexical과의 역할 분담
Global은 정규화한 전역 벡터의 내적이다. Lexical은 동일 token ID의 질의·문서 가중치 곱을 합산한다. 추론에서는 반복 ID의 최대 중요도를 써 출현 횟수의 과도한 누적을 막는다.
설계상 독립 검색 가지는 Global과 Phrase이며 Lexical은 검색한 후보의 보조 점수다. 세 독립 검색기의 조합이 아니다. 독립 Phrase 인덱스는 설계로 제시되지만 공개 주 결과가 검증한 경로는 아니다. 16개 과제에서는 Global 후보를 재순위화한다.
4. 검색 표현과 경계는 다른 신호로 배운다
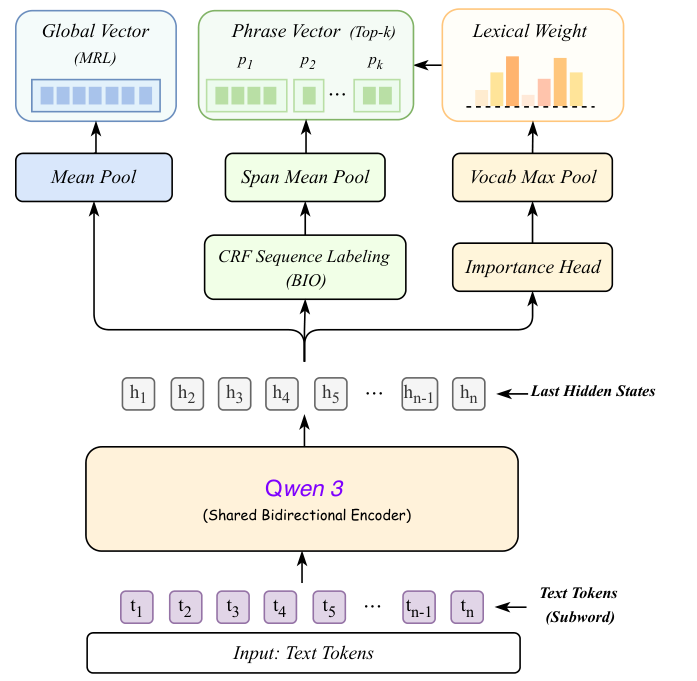
Figure 3. 공유 상태에서 경계와 중요도를 얻어 여러 표현을 만든다. 출처: Zhang et al. (2026), PDF v3, p. 3.
두 단계 학습과 네 손실항
| 단계 | 학습 대상 | 핵심 신호 |
|---|---|---|
| Stage 1 | Global만 학습 | 약 1,500만 약지도 질의–문서 쌍, MRL 폭 64·128·256·512·1,024의 대조 학습. |
| Stage 2 | Global·Token·Lexical 및 CRF | 세 검색 head의 NCE·교사 증류와 query·positive document의 BIO 감독. |
Stage 2에서 검색 head h는 Global, Token, Lexical 중 하나다. 정답 문서와 음성 문서를 구분하는 NCE에 더해, 교사의 점수 분포를 학생이 따르게 하는 KL 항을 쓴다. 방향은 teacher ∥ student다.
\mathcal L_h=\mathcal L_h^{\mathrm{NCE}}+
D_{\mathrm{KL}}(\pi^*\Vert\pi_h)
전체 목적함수는 다음과 같다.
\begin{aligned}
\mathcal L_{\mathrm{stage2}}
={}&\lambda_G\mathcal L_G+\lambda_T\mathcal L_T\\
&+\lambda_L\mathcal L_L+\lambda_{\mathrm{seg}}\mathcal L_{\mathrm{seg}}.
\end{aligned}
NCE는 in-batch negatives를 사용하고 Global에는 cross-device negatives도 추가한다. 증류는 명시적인 positive-negative group 안에서 계산한다. CRF는 LLM 교사가 질의와 정답 문서에 붙인 BIO 레이블을 배운다. 따라서 검색 순위에 대한 감독과 구절 경계에 대한 감독은 함께 학습되지만 동일한 신호는 아니다(Zhang et al., 2026, §3.5).
추론의 Phrase 점수를 그대로 학습하지는 않는다
별도 Phrase retrieval loss는 없으며, 검색 목적함수는 이산 partition을 직접 미분하지 않는다. 대신 Token head가 공유 상태에 검색 감독을 전달한다. 학습 때 Token은 학습 가능한 affine projection을 거친 정규화 벡터로 비가중 평균 MaxSim을 계산한다. 이 projection은 추론에서 버린다. 추론의 Phrase는 원 문맥 상태의 구절 평균, CRF 경계, Lexical 손실로 배운 중요도를 결합한다.
Lexical의 반복 ID 집계도 학습과 추론이 다르다. 학습에서는 중요도를 sum-pool하고 추론에서는 max-pool한다. Figure 3의 vocabulary max pooling은 추론 규칙으로 읽어야 한다. 학습 Token의 비가중 평균 MaxSim을 추론 Phrase의 질의 가중 합과 같은 식으로 취급해서도 안 된다.
서로 다른 감독을 한 추론 규칙에 조합하는 설계다. “검색 손실이 최적 경계를 직접 발견했다”는 해석은 성립하지 않지만, “경계가 검색 학습과 전혀 무관하다”도 과도하다. 공유 인코더 상태는 검색 감독을 받기 때문이다. 교사에게 그럴듯한 경계가 검색에서도 유용한가는 별도의 통제로 살펴야 한다.
데이터 규모와 재현 가능한 범위
본문 §4.1은 Stage 2를 12개 데이터셋의 약 151만 예시, 일반 도메인 88%·의료 12%라고 설명한다. 반면 부록 A는 Table 7의 1,510,657행을 공개 구성요소로 부르고 proprietary retrieval data도 혼합한다고 명시한다. 두 설명을 합쳐 151만을 비공개 자료까지 포함한 확정 총량으로 단정할 수 없다. 88:12 역시 최종 전체 혼합의 확인된 비율로 확대하지 않는다. 공개 소스가 열거되어도 비공개 양과 샘플링을 모르면 같은 분포를 재구성하기 어렵다.
학습 장비는 AMD Instinct MI308X 64개다. 이는 장비 수이지 GPU-hours나 총 학습비용이 아니다. 정확한 segmentation teacher checkpoint 식별자도 보존되어 있지 않다고 부록이 밝힌다.
5. 무엇을 같은 조건에서 비교했는가
검색은 후보를 찾는 일과 정렬하는 일로 나뉜다. H+의 주요 실험은 후자다. 점수 함수를 개선해도 후보에서 빠진 정답을 되살릴 수는 없다.
| 프로토콜 | 고정하거나 바꾸는 조건 | 답하는 질문 |
|---|---|---|
| Broad-deployed, 16개 과제 | MRL-128 Global top-1,000을 CRF+trie Phrase 등으로 재순위화 | 전역 후보에 지역 상호작용을 더하면 순위가 좋아지는가? |
| Shared-pool, 네 과제 | 같은 union 내부에서 후보 ID 동일 | 후보 접근을 맞추면 Token과 Phrase가 어떻게 다른가? |
| Exact-count, 19개 과제 | CRF-only, 텍스트별 실제 질의·문서 단위 수 동일 | 단순히 벡터를 더 쓴 것 이상의 이득이 있는가? |
| 경계 통제, 네 과제 | 표현·후보·단위 수를 맞추고 경계 위치 변경 | 구절 길이와 개수가 같아도 경계 위치가 중요한가? |
Global의 원래 상위 10개는 상위 1,000개 안에 있으므로 같은 후보를 Global 점수로 정렬하면 원래 nDCG@10을 유지한다. Phrase 비교는 점수 함수를 바꾼 효과다. 다만 지역 벡터를 추가로 저장·계산하므로 동일 비용 비교는 아니다.
Shared-pool은 H+ Global, Qwen3-Embedding-0.6B, BGE-M3가 각각 가져온 top-1,000의 합집합을 쓴다. 논문 Table 2의 union A 내부와 union B 내부에서는 각각 후보 ID가 같다. 그러나 B는 같은 source와 recipe를 별도로 materialize한 후보 cache여서 A와의 ID 일치를 보장하지 않는다. B의 압축 모델 결과를 A의 H+와 matched-candidate 정면 비교로 읽으면 안 된다.
공통 후보는 후보 접근만 맞추며 외부 모델의 백본·학습 데이터·차원·벡터 수까지 맞추지는 않는다. BGE/Jina의 자체 dense top-200은 공통 union과 별도이고, dense baseline은 전체 코퍼스를 검색한다.
주 실험은 16개 과제이며, CUREv1과 PublicHealthQA-en/zh를 더한 19개 과제는 별도 스트레스 평가다. Shared-pool과 경계·pool-size 통제의 네 과제는 NFCorpus·SciFact·MedicalQA·FeedbackQA다.
6. 전역 후보의 순서를 바꾸면 얼마나 좋아지는가
16개 과제: Global 대비 +6.91점
| Broad-deployed · 16개 과제 | Macro nDCG@10 |
|---|---|
| Global, full-corpus MRL-128 | 34.28 |
| Phrase, Global top-1,000·CRF+trie | 41.19 |
| Hybrid, 같은 후보 | 41.52 |
출처: Zhang et al. (2026), Table 1. 수치는 0–100 척도이며 macro는 과제별 동일 가중 평균이다.
Phrase는 Global보다 15/16개 과제에서 높고 예외는 Cmedqa-zh다. +6.91은 nDCG@10의 점수 차이이지 정확도 증가나 상대 개선율 6.91%가 아니다. nDCG@10은 관련 문서를 상위 10개에 얼마나 잘 배치했는지를 평가한다. 질의를 모두 합쳐 계산한 하나의 평균도 아니므로 과제 크기와 관계없이 각 과제가 같은 비중을 갖는다.
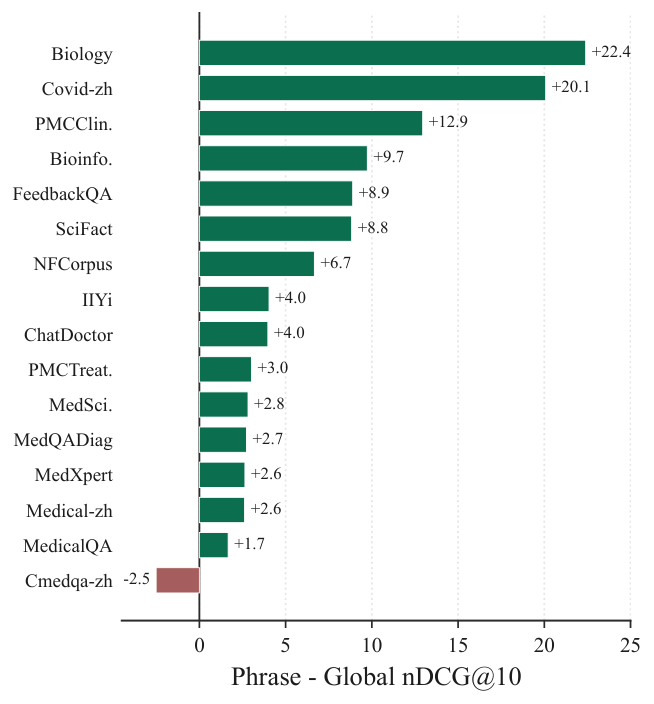
Figure 4. 배포형 Phrase의 전역 검색 대비 이득은 과제마다 다르다. 출처: Zhang et al. (2026), PDF v3, p. 11.
Hybrid는 Phrase보다 +0.33이다. 같은 broad-deployed의 네 과제에서도 Global 56.67, Phrase 63.17, Lexical 42.94, 세 관점 결합 63.41로 Phrase가 주요 기여를 한다. 다만 Global은 재순위화 후보를 공급하므로 최종 점수만으로 불필요하다고 판단할 수 없다.
학습 자료 provenance 표시가 있는 다섯 과제인 ChatDoctor·FeedbackQA·MedicalRetrieval-zh·Covid-zh·Cmedqa-zh를 제외하면 Global 26.10, Phrase 33.15로 +7.05다. 제외 후에도 방향이 유지된다는 민감도 근거지만 완전한 train/test 비중복을 증명하는 누수 감사는 아니다. 상세 source별 분할·중복 자료가 없는 부분까지 이 숫자로 해결되지는 않는다.
전체 16개 과제에서는 더 큰 Qwen3-Embedding 4B/8B가 각각 48.02/50.70으로 Phrase 41.19보다 높다. 이 dense 모델들은 전체 코퍼스를 검색하므로 후보 조건도 다르다. 따라서 이 연구를 “0.6B 모델이 모든 대형 임베딩을 이겼다”로 요약하는 것은 논문 결과와 맞지 않는다.
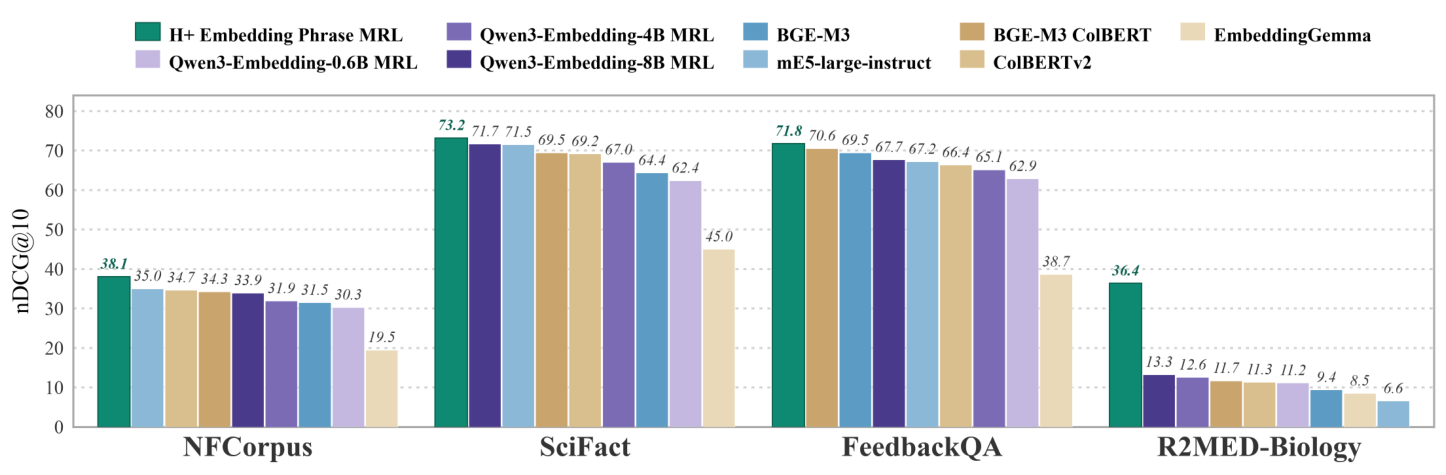
Figure 1. 선택된 네 과제의 성능을 서로 다른 검색 설정과 함께 보여 준다. 출처: Zhang et al. (2026), PDF v3, p. 2.
Figure 1은 아래 공통 후보 실험과 달리 MedicalQA 대신 R2MED-Biology를 포함한다. H+ 막대는 CRF-only·128차원·자체 Global top-1,000 조건이고 dense baseline은 full-corpus 검색이다. BGE-M3 ColBERT는 자체 dense top-200, ColBERTv2는 별도 shared union 결과에 해당하며 모델별 폭도 다르다. 이 그림은 선택된 과제에서의 작동점을 보여 주지만, 모든 막대가 같은 후보·차원·비용을 쓴 전체 순위표는 아니다. 네 과제의 시각적 우위를 전체 16개 과제에 일반화할 수 없는 이유다.
네 과제·union A: 토큰 수준에 가까운 점수와 더 적은 벡터
| 동일 후보 union A | 문서 벡터 평균 | Macro nDCG@10 |
|---|---|---|
| H+ MRL Token | 288.59 | 62.95 |
| H+ MRL Phrase, CRF-only | 250.90 | 62.90 |
| H+ MRL Phrase, CRF+trie | 249.03 | 62.94 |
| BGE-M3 ColBERT | 320.86 | 60.54 |
| Jina-ColBERT-v2 | 215.90 | 61.90 |
출처: Zhang et al. (2026), Table 2. NFCorpus·SciFact·MedicalQA·FeedbackQA의 동일 가중 평균.
이 H+ 비교는 같은 표현 계열·128차원·후보 ID를 사용한다. 배포형 Phrase는 Token보다 표시 점수가 0.01 낮으면서 문서 벡터는 약 13.7% 적다. 따라서 “비슷한 점수로 더 적은 지역 벡터를 쓴다”는 유용한 결과다. 하지만 반올림한 평균이 가깝다는 것만으로 통계적 동등성이 입증되지는 않는다. 벡터 수 역시 과제별 평균의 동일 가중 평균이지 모든 코퍼스의 문서 수로 가중한 전체 저장량 추정치가 아니다.
외부 모델의 백본·학습 조건은 다르므로 모델 간 점수 차이를 CRF의 단독 효과로 해석하지 않는다. BGE/Jina의 own dense top-200 점수 60.46/60.68은 공통 후보의 60.54/61.90과 별개다.
7. 같은 벡터 예산에서 어떤 단위가 유리한가
B는 실제 개수가 아니라 상한이다
Exact-count 비교는 방법마다 단위를 더 많이 보유해서 이기는 효과를 줄이려 한다. 규칙 집합을 \mathcal G, 텍스트를 x라고 하면 실제 사용할 수는 다음처럼 정한다.
C_x(B)=\min\!\left(B,\min_{g\in\mathcal G}|g(x)|\right)가장 적은 단위를 만드는 규칙의 수와 B 중 작은 값을 쓴다. 한 규칙이 7개만 만들면 B=32여도 다른 규칙까지 7개로 맞춘다. B는 모든 텍스트가 실제로 쓰는 개수가 아니라 상한이다.
| B | Token | Bigram | Random | Phrase |
|---|---|---|---|---|
| 4 | 23.47 | 25.65 | 27.21 | 25.70 |
| 8 | 29.73 | 30.84 | 31.65 | 30.72 |
| 16 | 33.76 | 34.30 | 34.63 | 34.86 |
| 32 | 36.38 | 36.37 | 36.57 | 37.39 |
| 64 | 37.45 | 37.37 | 37.27 | 38.63 |
| 128 | 37.47 | 37.43 | 37.46 | 38.71 |
출처: Zhang et al. (2026), Table 6. CRF-only·19개 과제의 macro nDCG@10. 사전 지정 예산은 8·16·32·64·128이며 4는 탐색점이다.
Phrase는 표시된 모든 예산에서 Token보다 높다. 사전 지정된 Phrase–Token 다섯 비교는 Holm 보정 후에도 유의하다. 그러나 아주 작은 예산에서는 다른 결과가 나온다. Random이 B=4와 8에서 더 높고, B=16에서는 Phrase와 통계적으로 구별되지 않는다. Phrase–Bigram도 B≤16에서는 분명하지 않다. 논문은 B≥32에서 Bigram·Random보다 유의한 Phrase 우위를 보고한다.
이를 “무작위보다 학습 구절이 언제나 좋다”로 읽기보다 단위를 충분히 남길 수 있을 때 구절의 선택성이 유리해지는 예산 의존적 패턴으로 읽는 편이 정확하다. 부록 D가 명시한 열 개의 Holm 비교군은 다섯 예산의 Phrase–{Token, Bigram}이다. Random 비교를 이 이름 붙은 보정군에 포함시키지 않는다. 또한 아래 경계 실험의 길이 보존 random은 여기의 Random과 다른 대조군이다.
전체 다국어 결과의 강한 반례도 남겨야 한다
전체 19개 과제의 joint-budget 평균에서는 Whole word와 Equal chunks가 모든 표시 예산에서 Phrase보다 높다. B=128에서는 각각 43.25, 42.79로 Phrase 38.71을 넘는다. 위 네 방법 표만 보고 Phrase를 모든 묶음 규칙의 승자로 선언할 수 없다.
whitespace 기반 whole-word 규칙은 중국어에서 취약하다. 중국어 네 과제의 공통 질의 개수가 평균 1.0–1.2로 낮아지면 Token·Bigram·Phrase도 그 수에 맞춰진다. 예산 128과 실제 해상도가 크게 달라진다. 개수를 맞춰도 그 기준 규칙이 언어 중립적이지 않을 수 있다.
부록의 비중국어 15개 과제 부분집합에서는 B≥32일 때 Phrase가 표시된 규칙 가운데 가장 높다. 이 표에는 Random이 없다. 이는 단위 통제의 문제를 진단하는 기술적 분석이지 전체 19개 과제 결과를 대체하거나 Phrase의 보편적 우위를 확정하는 판정은 아니다. 질의는 자연 단위를 유지하고 문서에만 예산을 적용해도 전체 19개에서는 Whole word가 가장 높다(Zhang et al., 2026, Tables 14–15).
8. 경계 위치와 중요도는 각각 무엇을 더하는가
길이와 개수가 같아도 어디서 자르는지가 중요하다
네 과제의 경계 통제는 표현·후보·단위 수를 맞추고 위치를 바꾼다. Length-histogram random은 길이 분포를, within-text shuffle은 텍스트별 구절 길이 multiset과 개수를 보존한다. 길이·개수와 경계 위치의 효과를 구별하는 대조다.
B=128에서 학습 경계는 length-histogram random보다 +0.74점, 95% CI [0.32, 1.17], Holm 보정 p=.0032다. Within-text shuffle보다는 +0.66점, CI [0.28, 1.05], p=.0056이다. 이 조건에서는 경계 위치 자체의 기여가 지지된다. 반면 B=64의 shuffle 대비 +0.42는 CI [−0.03, 0.88]로 0을 포함한다. 어떤 예산에서도 같은 크기의 효과가 확정된 것은 아니다.
네 과제의 경계 통제는 여덟 비교의 별도 Holm family다. B=128에서 Bigram 대비 +0.84, Whole word 대비 +0.56은 보정 전 신뢰구간이 양수지만 보정 p값이 각각 .116, .164여서 유의하지 않다. 이 결과를 19개 과제의 열 비교군과 합치거나, 보정 전 구간만 보고 모든 규칙보다 유의하게 낫다고 말하면 결론이 달라진다(Zhang et al., 2026, Tables 4·17).
구절을 묶는 것만큼 질의 가중이 중요하다
B=128에서 Phrase의 질의 가중치를 중요도 합에서 균등값으로 바꾸면 −1.66점, CI [−2.17, −1.17]이다. Token의 대응 하락은 −0.12, CI [−0.35, 0.11]로 불확실하다. 균등 질의 가중만 놓고 Phrase와 Token을 비교하면 Phrase가 오히려 −1.34, CI [−1.98, −0.73] 낮다. 따라서 최종 이득은 좋은 구절을 만들었다는 설명 하나보다 경계와 질의 중요도 가중의 결합으로 해석해야 한다.
반면 선택 점수의 sum 대 max 이득은 +0.03, CI [−0.06, 0.11]로 확인되지 않는다. 이 실험에서는 정확한 선택 집계 방식보다 질의 기여도 가중의 효과가 뚜렷하다.
높은 인간 기준 F1보다 먼저 기준을 확인한다
인간 평가는 영어·중국어 텍스트 200건의 경계를 다룬다. 먼저 operational reference가 무엇인지 정해야 F1을 읽을 수 있다. 본문 §4.2는 두 주석자 중 한 명이라도 표시한 경계를 남기는 합집합 adjudication을 설명하고, §5.3은 adjudicated reference에 대한 Boundary F1 0.900 [0.866, 0.931]을 보고한다. 그러나 Appendix H·Table 18은 Annotator A를 운영 기준으로 명시하며 0.899 [0.865, 0.930]을 보고한다. 두 reference 설명의 차이는 단순 반올림 문제가 아니다.
그 배경에는 주석자 간 낮은 합의가 있다. 평균 Cohen’s κ는 0.166, 대칭 Boundary F1은 0.436, exact-span F1은 0.230이다. 평균 경계 개수도 16.0 대 4.6으로 다르다. 따라서 특정 reference에 대한 높은 F1은 “모든 사람이 동의하는 의미 단위를 찾아냈다”는 뜻이 아니다. Boundary 지표는 item-macro이고 span 지표는 corpus-micro라 집계 단위도 다르다.
처음 누락된 두 항목에서 Annotator A는 CRF 분할을 수정 없이 받아들였다. 저장된 Teacher 경계 배열도 CRF와 동일하므로 Teacher 행을 독립적인 교사–학생 검증으로 볼 수 없다.
주석과 검색 기록이 연결되는 168개 질의에서 경계 F1과 검색 이득의 Spearman ρ=.007, p=.927이다. 단조 관계가 검출되지 않았다는 뜻이지 원리적 독립의 증명은 아니다. 언어적 타당성과 검색 효용을 구별하고, 후자는 후보·개수를 맞춘 검색 대조에서 판단해야 한다.
9. 벡터를 줄인 이득은 어디까지 측정됐는가
지역 벡터 payload와 전체 인덱스는 다르다
Union A에서 Token과 배포형 Phrase는 각각 문서당 평균 288.59개, 249.03개의 128차원 벡터를 쓴다. FP16이면 한 성분이 2바이트이므로 지역 벡터 payload는 다음처럼 계산된다.
288.59\times128\times2=73{,}879.04\ \mathrm{bytes/doc}249.03\times128\times2=63{,}751.68\ \mathrm{bytes/doc}이는 Table 9의 73.9·63.8 decimal KB/document에 대응한다. KB는 1,000바이트이며 KiB가 아니다. 같은 폭·정밀도에서 벡터 수 −13.7%가 payload 절감으로 연결된다.
하지만 메타데이터, 근사 검색 자료구조, Global 벡터, Lexical 저장, 색인 구축·갱신 비용까지 포함한 전체 인덱스 절감률은 아니다. 평균도 equal-task mean이므로 실제 서비스 코퍼스의 구성 비율을 반영한 총량과 다를 수 있다. BGE-M3의 지역 폭은 1,024이고 H+는 128이어서 모델 간 벡터 개수만 비교하면 저장량을 잘못 판단한다. 폭·개수·정밀도·인덱스 구조를 함께 보아야 한다.
후보가 늘면 채점 비용도 늘어난다
질의–문서 한 쌍의 단순 Phrase interaction 비용은 다음과 같다.
O(B_qB_dr)K개 후보를 모두 같은 방식으로 채점하면 다음처럼 후보 수가 추가된다.
O(KB_qB_dr)이는 채점 부분의 분석이며 인코딩·후보 검색·벡터 로딩, 인덱스의 근사화 비용은 별도다.
H20의 네 과제 pool-size sweep에서 K=1,000→2,000으로 늘리면 Phrase nDCG@10은 62.83→62.85, scorer P95는 4.379→8.251ms다. 이 표는 union A가 아니라 자체 Global top-K 조건이다. 약 +0.02점의 이득에 비해 채점 지연이 크게 늘어난다는 작동점 판단을 제공한다. 그러나 이 시간은 query encoding·후보 생성·벡터 로딩을 모두 포함한 end-to-end latency가 아니며, Token과 비교한 Phrase의 지연 절감 측정도 아니다.
폭을 늘리는 실험은 개수를 줄이는 실험과 다르다
CRF-only 차원 대조의 네 과제에서 128→1,024차원으로 바꾸면 Global은 55.61→56.70, Phrase는 62.90→62.90이다. 이 결과는 지역 상호작용이 작은 폭에서도 유용한 작동점을 만들 수 있음을 보여 준다. 다만 각 폭의 자체 Global top-1,000을 쓰는 own-gate 설정에서는 표현 폭뿐 아니라 후보도 달라진다.
19개 과제의 별도 차원 표는 Global +0.86, Token +0.13, Phrase −0.02를 보고한다. 앞의 네 과제 Global 증가 +1.09와 다른 집계다. MRL 후보를 고정한 local 대조의 Token/Phrase 변화는 −0.04/−0.12이며 Holm 보정 후 유의하지 않다. 따라서 차원 확대에 대한 관측을 후보 변화 효과와 완전히 분리된 보편 법칙으로 읽지 않는다.
표현 공간을 바꾼 네 과제 projection-space sensitivity에서도 B=64/128의 Phrase−Token은 −0.26/−0.20이고 두 신뢰구간이 0을 포함한다. 원 상태 공간의 19개 과제 결과가 어떤 projection에서도 보존되는 우위는 아니다(Zhang et al., 2026, Tables 8·13·16). 실제 도입에서는 작은 폭의 이점뿐 아니라 어떤 상태를 평균하고 비교하는지도 계약의 일부다.
천만 문서 실험은 별도 규모 근거다
비공개 평가에는 중복 제거된 문서 10,039,519개, 영어 500개·중국어 500개의 총 1,000질의가 있다. Global/Phrase의 nDCG@100은 0.8617/0.8777이다. 규모가 큰 자료에서도 개선이 관측됐다는 저자 보고지만 공개 nDCG@10과는 코퍼스·절단 순위·표시 척도가 모두 다르다. 독립 Phrase 인덱스의 재현 가능한 성능이나 전체 운영 비용이 확인됐다는 증거로 쓰지는 않는다.
10. 문맥 의존 검색 단위의 가치와 적용 조건
H+의 생산적인 관점은 검색 단위 자체가 설계 대상이라는 것이다. 문서와 토큰의 양자택일 대신 문맥 상태를 묶고 남길 단위를 조절한다. 공유 상태·공통 후보·실제 개수를 맞춘 대조는 적당한 예산에서 경계와 질의 중요도가 결합하는 이득을 뒷받침한다.
적용 판단은 네 축이다. 후보 회수율이 낮으면 재순위화에도 한계가 있다. 언어별 단위는 실제 남는 개수로 확인해야 한다. 교사의 경계 감독과 검색 효용은 구별해야 한다. 비용은 payload를 넘어 실제 색인과 온라인 지연에서 측정해야 한다.
재현 자료에도 확인 범위가 있다. 검토한 v3 PDF·HTML에서는 H+ 공식 코드·checkpoint 배포 링크, 버전이 고정된 trie 사전과 출처, 재현에 충분한 source별 식별·분할 명세를 확인하지 못했다. 정확한 segmentation teacher checkpoint 부재와 비공개 혼합량 문제도 남는다. 이는 인터넷 전체에 공개 자료가 없다는 판정이 아니라 이 리뷰가 확인한 자료 안의 제한이다. 외부 baseline의 라이브러리 버전이나 adapter probe가 제시되어도 H+의 재학습 재현을 대신하지는 않는다.
Global 후보를 잘 확보한 시스템에서 문맥 의존 구절과 중요도 가중은 토큰 상호작용에 가까운 품질을 더 적은 지역 벡터로 얻는 유망한 방법이다. 다국어 전체에서 모든 묶음 규칙을 이겼거나, 인간이 합의한 최적 경계를 찾았거나, 서비스 총비용까지 낮췄다는 결론과는 구별해야 한다.
성능·실험 절차는 논문의 저자 보고를 바탕으로 설명했다. 표시된 차이와 비율은 보고값의 산술이며, 이 리뷰에서 모델 학습이나 검색 실험을 독립적으로 재실행하지 않았다. 원문은 arXiv v3, 예시 중심 설명은 쉬운 해설에서 읽을 수 있다.
References
Khattab, O., & Zaharia, M. (2020). ColBERT: Efficient and effective passage search via contextualized late interaction over BERT. In Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval (pp. 39–48). Association for Computing Machinery. https://doi.org/10.1145/3397271.3401075
Kusupati, A., Bhatt, G., Rege, A., Wallingford, M., Sinha, A., Ramanujan, V., Howard-Snyder, W., Chen, K., Kakade, S., Jain, P., & Farhadi, A. (2022). Matryoshka representation learning. In S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, & A. Oh (Eds.), Advances in neural information processing systems (Vol. 35, pp. 30233–30249). Curran Associates. https://doi.org/10.52202/068431-2192
Zhang, S., Hu, J., Feng, Y., Wang, Z., Pan, Z., Yuan, X., Hong, J., Dong, G., & Wang, X. (2026). H+ Embedding: Harmonizing global and token-level retrieval with context-dependent phrases [Preprint]. arXiv. https://arxiv.org/abs/2608.00065v3