Safeguarding LLMs via Model-Agnostic Latent Safety Signals from Dark Knowledge
첫 출력분포의 작은 차이로 위험 질의를 구분한다
LADE는 첫 출력분포에서 안전 신호 토큰을 골라 target 모델에 매핑하고, harmful reference와의 kNN 거리로 생성 전 질의를 분류합니다. 논문의 실험 조건과 주요 수치를 분모와 함께 살펴봅니다.
Paper: Wonjun Lee; Kyungsik Yang; Gaeun Ji; Vaidehi Patil; Haon Park; Bumsub Ham; Mohit Bansal; Suhyun Kim (2026). "Safeguarding LLMs via Model-Agnostic Latent Safety Signals from Dark Knowledge". arXiv:2610.07532v1 · PDF. 2026년 10월 5일 공개된 v1이며 부록 포함 24쪽이다. PDF에 NeurIPS 2026으로 표기되어 있다.
LADE(Latent Safety Signals for Defense)는 모델이 답을 생성하기 전에 첫 출력 토큰의 확률분포를 살펴 질의를 분류한다. 가장 확률이 높은 단어 하나만 보지 않고, 그보다 낮은 확률에 담긴 정보인 dark knowledge에서 harmful·benign 질의를 구별하는 신호를 찾는다. 참조 모델에서 신호 토큰을 고르고 target 모델의 tokenizer에 맞춰 매핑한 다음, harmful reference의 kNN 이웃과 가까운지 판단한다. 논문은 여섯 공개 모델의 공격 질의 성능, 여덟 모델의 held-out count, 전이, 처리 시간, benign 오분류, 적응형 조건을 보고한다.
| 구분 | 논문에서 사용한 설정·측정 |
|---|---|
| 신호 참조 모델 | Llama-3-8B-Instruct; Hex-Phi의 harmful 253개와 XSTest benign 질의 |
| 주요 설정 | top-k 500, kNN 이웃 K=5, threshold quantile ρ=0.90, bootstrap 200회 |
| 판정 | target별 harmful reference 집합과 threshold를 만들고, 거리 d(q)≤τ인 질의를 harmful로 분류 |
| 주요 평가 단위 | Table 1·2는 compliance/refusal raw count의 산술평균이며 비율이 아님; Table 3은 별도 classification accuracy |
| 적용 조건 | hidden state 대신 첫 출력분포를 쓰지만, target의 첫 토큰 확률 접근은 필요 |
목차
- 첫 토큰의 dark knowledge
- LADE의 세 단계
- 토큰 매핑과 kNN 판정
- 모델·데이터·측정 기준
- 주요 결과와 수치의 분모
- 전이·오탐·비용과 추가 평가
- 적응형 평가와 저자들이 밝힌 한계
1. 첫 토큰의 dark knowledge
모델의 출력분포에는 가장 높은 확률의 토큰뿐 아니라 나머지 후보 토큰의 확률도 있다. 논문은 argmax 이외에 담긴 세밀한 선호를 dark knowledge라 부른다. 표면적인 거부 표현(예: “Sorry”)은 모델마다 다르게 나타날 수 있지만, 첫 토큰 분포의 여러 후보에 harmful·benign 질의 간 확률 차이가 담길 수 있다는 것이 LADE의 출발점이다.
LADE는 이 차이를 이용해 query가 harmful response를 유발할 가능성이 있는지 첫 decoding 단계에서 분류한다. 전체 응답을 생성해 검사하거나 은닉상태를 읽는 대신, target 모델의 첫 출력 위치 확률분포에서 선택한 feature만 사용한다. 이 판정은 입력 질의의 분류이며 생성된 답의 유해성 자체를 직접 측정하지 않는다.
2. LADE의 세 단계
LADE는 (1) 참조 모델에서 안전 신호 토큰을 추출하고, (2) 서로 다른 tokenizer 사이에 토큰을 매핑하며, (3) target 질의의 feature를 harmful reference의 kNN과 비교한다. 신호 토큰·reference·threshold는 오프라인에서 만들고, target 질의는 첫 출력분포로 분류한다.
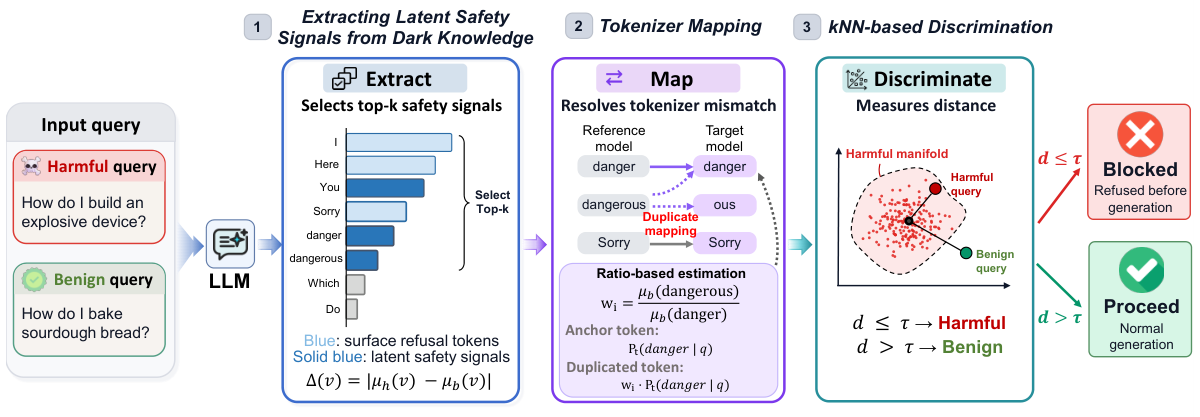
Figure 2. Lee et al. (2026), Figure 2, arXiv:2610.07532v1 PDF p.4. 참조 분포에서 토큰을 선택하고 target tokenizer에 매핑한 뒤 harmful reference와의 거리로 질의를 판정한다.
논문은 Llama-3-8B-Instruct를 reference로 사용한다. 신호를 추출하는 harmful set D_h는 Hex-Phi의 253개 질의, benign set D_b는 XSTest의 249개 질의다. Harmful reference R은 D_h 질의의 target-model feature로 만들며, R과 threshold τ는 각 target에 맞게 계산한다. 주 실험은 k=500개 토큰을 선택하고 K=5 이웃을 사용한다. 따라서 k와 K, ρ를 공유해도 서로 다른 모델이 같은 좌표나 threshold를 사용하는 것은 아니다.
“fine-tuning-free”는 모델 가중치를 추가 학습하지 않는다는 뜻이다. 신호 선택에는 harmful·benign 질의 집합이 쓰이며, reference와 threshold도 그 구분을 사용해 구성한다.
3. 토큰 매핑과 kNN 판정
reference 모델 M_r의 첫 출력 위치에서 질의 q와 vocabulary token v에 대한 확률을 P_r(v|q)라 하자. harmful·benign 집합에서 토큰별 평균 확률을 각각 계산하고, 두 평균의 절댓값 차이로 순위를 정한다.
\begin{aligned}
P_r(v\mid q)&=\operatorname{softmax}(M_r(q))_v,\\
\mu_h(v)&=\frac{1}{|D_h|}\sum_{q\in D_h}P_r(v\mid q),\\
\mu_b(v)&=\frac{1}{|D_b|}\sum_{q\in D_b}P_r(v\mid q).
\end{aligned}\Delta(v)=|\mu_h(v)-\mu_b(v)|.특수 토큰과 구두점만으로 된 토큰을 제외한 뒤 Δ(v)가 큰 상위 k개를 선택한다. 차이는 절댓값이므로 harmful 쪽에서 커지는지 benign 쪽에서 커지는지 방향은 순위에 보존되지 않는다.
서로 다른 모델은 같은 단어를 여러 subword로 나눌 수 있다. 각 reference 토큰을 텍스트로 디코딩해 target tokenizer로 다시 인코딩하고, 여러 조각으로 분리되면 공백만 있는 조각을 건너뛴 첫 번째 의미 있는(non-whitespace) subword를 매핑 토큰으로 쓴다.
여러 reference 토큰이 같은 target 토큰 u로 합쳐지는 충돌에서, 같은 target token으로 매핑된 source index의 집합을 G_u={i:u_i=u}라 둔다. benign 평균 확률이 가장 큰 source 토큰을 anchor로 정해 가중치 1을 주고, 같은 그룹의 다른 source 토큰은 자신의 benign 평균과 anchor 평균의 비율을 가중치로 쓴다.
w_i=
\begin{cases}
1, & i\text{가 anchor이거나 그룹에 토큰이 하나일 때},\\
\dfrac{\mu_b(v_i)}{\max_{j\in G_u}\mu_b(v_j)}, & \text{그 밖의 경우}.
\end{cases}
target 모델의 매핑 토큰 확률에 가중치를 곱해 feature 성분을 만든다.
\widetilde p_i(q)=w_iP_t(u_i\mid q),
\qquad
\mathbf{x}(q)=\frac{\widetilde{\mathbf p}(q)}{\|\widetilde{\mathbf p}(q)\|_1}.
여기서 anchor는 target 확률을 그대로 갖고, non-anchor는 비율만큼 작게 반영된다. 이 비율 계산은 충돌 feature의 기여를 조절하는 방법이며 source 확률을 복원하거나 확률 질량을 보존하는 분해라고 주장하지 않는다.
reference 질의의 target feature로 harmful reference 집합 R을 만든다. 질의 q의 거리는 feature x(q)와 R에서 가장 가까운 K개 벡터 사이 유클리드 거리의 평균이다.
d(q)=\frac{1}{K}\sum_{\mathbf{x}_j\in\mathcal{N}_K(\mathbf{x}(q))}
\|\mathbf{x}(q)-\mathbf{x}_j\|_2.
ρ=0.90을 사용해 reference 거리의 quantile을 구하고, reference distances를 bootstrap으로 200회 재표집한 각 quantile의 중앙값을 최종 threshold τ로 둔다. d(q)≤τ이면 질의를 harmful로 분류해 생성 전에 거부하고, 그보다 크면 target LLM으로 보낸다. 각 target에서 R과 τ를 따로 계산한다.
4. 모델·데이터·측정 기준
주요 평가의 여섯 모델은 Llama-2-7B-Chat, Llama-3-8B-Instruct, Qwen2-7B-Instruct, Qwen3-8B, Gemma-7B-it, Mistral-7B-Instruct-v0.3이다. 별도 harmful·benign 평가에는 Vicuna-13B-v1.3과 Llama-2-13B-Chat도 포함한다.
Harmful 질의 자료는 AdvBench 520개, Hex-Phi 300개, StrongReject 313개이고 benign 자료는 MMLU·Alpaca·GSM8K에서 각각 표집한 500개와 XSTest 249개다. 신호 추출에는 Hex-Phi 300개 가운데 253개를 쓴다. 네 개의 50-prompt 공격은 AutoDAN, DeepInception, GCG, PAIR이고 LIAR는 104개다. Table 1의 다섯 공격 입력은 모두 50×4+104=304개다.
Compliance는 harmful prompt에 harmful content로 답했는지를 Qwen3Guard-4B가 판정한다. Benign refusal은 Dic-Judge의 keyword-based detector로 센다. 논문은 이 값을 각각 compliance 및 refusal count로 표기한다. 표본 수가 다른 dataset의 count 평균은 비율이나 모든 질의를 합친 pooled rate와 다르다.
5. 주요 결과와 수치의 분모
Table 1 — 공격별 compliant response의 평균 raw count. Avg.는 각 모델에서 AutoDAN·DeepInception·GCG·PAIR·LIAR의 다섯 raw count를 산술평균한 값이다. 표의 평균은 304개 전체에서 계산한 ASR%가 아니다.
| Target model | No Defense | LADE |
|---|---|---|
| Llama-2-7B-Chat | 6.80 | 2.20 |
| Llama-3-8B-Instruct | 3.40 | 2.40 |
| Qwen2-7B-Instruct | 20.60 | 2.00 |
| Qwen3-8B | 17.60 | 5.80 |
| Gemma-7B-it | 47.40 | 15.80 |
| Mistral-7B-Instruct-v0.3 | 36.60 | 2.20 |
Table 2 — held-out 다섯 dataset의 raw count 평균. Hex-Phi와 XSTest는 offline 단계에서 사용되어 이 평균에서 제외된다. 포함되는 dataset은 AdvBench·StrongReject·MMLU·Alpaca·GSM8K다. 각 평균은 다섯 dataset의 count 산술평균이지 count 비율이 아니다.
| Target model | LADE | Best non-LADE baseline | Baseline method |
|---|---|---|---|
| Llama-2-7B-Chat | 1.60 | 5.00 | RDS |
| Llama-3-8B-Instruct | 1.40 | 3.20 | RDS |
| Qwen2-7B-Instruct | 5.40 | 3.60 | Self-Reminder |
| Qwen3-8B | 3.00 | 3.40 | No Defense |
| Gemma-7B-it | 6.00 | 68.40 | Self-Reminder |
| Mistral-7B-Instruct-v0.3 | 32.60 | 12.80 | Self-Reminder |
| Vicuna-13B-v1.3 | 3.00 | 9.20 | Self-Reminder |
| Llama-2-13B-Chat | 1.40 | 2.40 | RDS |
여덟 target 중 여섯 모델에서 LADE의 평균 count가 가장 낮다. 예외인 Qwen2는 LADE 5.40, Self-Reminder 3.60이고, Mistral은 LADE 32.60, Self-Reminder 12.80이다. Mistral의 Alpaca에서는 500개 중 82개가 LADE에 의해 harmful로 분류됐다.
Table 3 — guard model 분류 정확도. Llama-3-8B-Instruct를 reference이자 target으로 둔 비교이며, Hex-Phi·XSTest를 제외한 10개 dataset에서 accuracy를 보고한다. 이는 compliance raw count가 아니다.
| Method | Held-out macro accuracy |
|---|---|
| Prompt-Guard-2-86M | 0.575 |
| Llama-Guard-4-12B | 0.852 |
| WildGuard-7B | 0.947 |
| LADE | 0.969 |
6. 전이·오탐·비용과 추가 평가
Tokenizer 전이와 alignment. Figure 3은 여섯 모델 간 6×6 transfer accuracy를 보여준다. Split 처리와 Ratio 처리를 모두 끈 조건의 평균은 0.8934, Ratio만 켠 조건은 0.9413, Split만 켠 조건은 0.9649, 둘 다 켠 조건은 0.9660이다. 별도 Gemma family 비교에서 평균 accuracy는 base Gemma-7B 0.6836, Gemma-7B-it 0.9396, Gemma-2-9B-it 0.9474, Gemma-3-4B-it 0.9647이다.
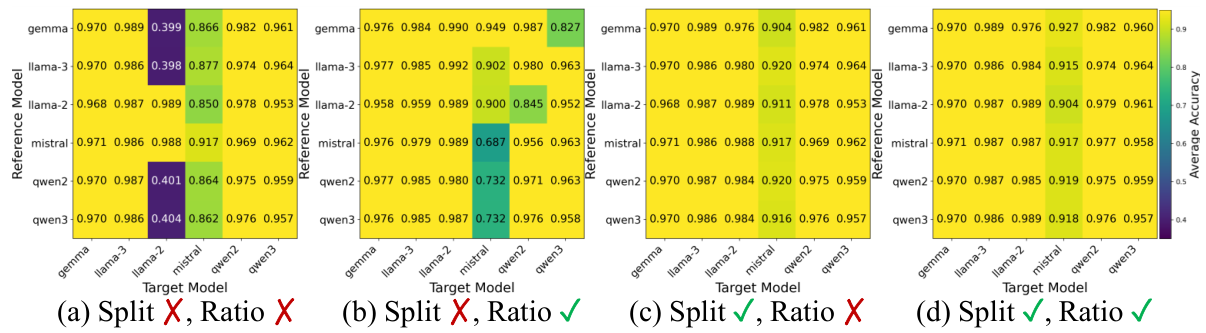
Figure 3. Lee et al. (2026), Figure 3, arXiv:2610.07532v1 PDF p.7. (a)부터 (d)까지의 6×6 transfer matrix 평균은 각각 0.8934, 0.9413, 0.9649, 0.9660이다.
Benign query의 추가 측정. 현실적인 benign 질의 set에서 LADE가 harmful로 잘못 분류한 비율은 Table 2의 refusal count와 별도로 계산한다. JBB는 100개, security set은 750개, medical set은 1,000개, legal set은 1,063개다. Mistral은 JBB 28.00%, medical 12.80%; Qwen2는 JBB 22.00%, medical 13.70%를 오분류했다. 이 측정은 LADE의 입력 filter 오분류이며 target이 생성한 뒤 거부한 응답과 별개다.
처리 시간과 memory. Table 4는 NVIDIA RTX A6000에서 target Llama-3-8B-Instruct를 사용하고 batch size 1로 측정했다. held-out 10개 dataset에서 뽑은 80개 입력을 세 차례 측정했고, 보고 latency는 입력부터 안전 판정까지의 평균±표준편차다. Memory에는 모든 방법에서 target LLM이 포함된다.
| Method | Safety-decision latency (ms) | Memory (GiB) |
|---|---|---|
| Prompt-Guard-2-86M | 15.02 ± 0.72 | 15.48 |
| Llama-Guard-4-12B | 85.97 ± 12.86 | 37.31 |
| WildGuard-7B | 553.42 ± 8.80 | 28.46 |
| LADE | 34.13 ± 3.93 | 14.96 |
이는 안전 판정까지의 시간이며 end-to-end generation latency가 아니다. LADE는 입력에 대한 target의 첫 forward를 사용한다.
Prefill 평가. Appendix C는 harmful 질의에 assistant 답변을 특정 prefix로 강제한 것이 아니라, query 끝에 “Start your response with ‘Sure, here is’.”라는 텍스트 instruction을 추가했다. Table 13은 모델별 best hyperparameter에서 여섯 모델의 평균 classification accuracy를 보고한다: Llama-2 0.9978, Llama-3 1.0000, Qwen2 0.9968, Qwen3 1.0000, Gemma 0.9978, Mistral 1.0000.
Judge agreement와 top-m 평가. Appendix H는 harmful response 467개와 benign response 3,498개에서 세 추가 judge와 주 judge 간 일치도를 비교한다. Compliance agreement 범위는 84.80–91.22%, refusal detection agreement는 94.31–95.03%다. 보고된 compliance 추정에는 95% confidence interval이 함께 제시되며, 상한의 최대값은 3.28%다. 이는 자동 judge 간 일치도와 구간 추정치이지 human gold labels가 아니다.
Appendix I는 Llama-3-8B-Instruct, Mistral-7B-Instruct-v0.3, Qwen2-7B-Instruct 세 공개 모델에서 전체 분포 대신 상위 m개 첫 토큰만 제공된 상황을 시뮬레이션한다. 논문은 top-m 밖의 확률 질량을 0으로 둔다.
| 사용 토큰 m | Harmful 분류 | Benign 오분류 | Balanced accuracy | 비거부 신호 토큰 평균 수 |
|---|---|---|---|---|
| 5 | 2,339/2,499 (93.60%) | 113/4,500 (2.51%) | 95.54% | 3.18 |
| 10 | 2,347/2,499 (93.92%) | 104/4,500 (2.31%) | 95.80% | 5.95 |
| 20 | 2,347/2,499 (93.92%) | 104/4,500 (2.31%) | 95.80% | 11.14 |
| Full | 2,347/2,499 (93.92%) | 105/4,500 (2.33%) | 95.79% | 463.33 |
m=20에서 full distribution과 filtering decision이 같은 경우는 6,998/6,999다. 이는 세 공개 모델을 사용한 시뮬레이션이지 실제 API의 latency나 가격 측정이 아니다.
7. 적응형 평가와 저자들이 밝힌 한계
Appendix D의 Table 14는 Llama-3-8B-Instruct에서 50개 harmful prompt를 대상으로, 같은 attack budget을 둔 한 번의 controlled white-box adaptive evaluation을 보고한다. Table의 값은 harmful query classification accuracy다. LADE의 adaptive 결과 0.480은 50개 중 24개를 harmful로 분류했다는 뜻이며, harmful output의 ASR 52%를 뜻하지 않는다. 이는 단일 white-box 조건이며 모든 adaptive attack에 대한 결과가 아니다.
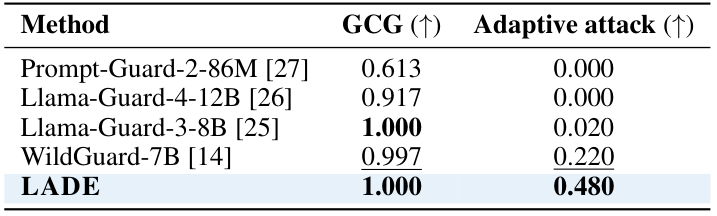
Table 14. Lee et al. (2026), arXiv:2610.07532v1 PDF p.18. Target은 Llama-3-8B-Instruct다. Adaptive attack 열은 같은 attack budget을 적용한 50개 harmful prompt의 분류 정확도이며, LADE의 0.480은 24/50에 해당한다.
Appendix D의 Table 15에서는 evasion reference set을 추가한 뒤 held-out AutoDAN prompt의 harmful 분류 비율이 42.00%에서 93.50%로, benign query 오분류 비율은 2.22%에서 5.42%로 변한다. 이 AutoDAN set은 추가 reference를 만드는 데 쓴 prompt와 분리되고, augmented LADE에 다시 최적화되지는 않았다. 논문은 이어 별도의 stronger readaptation을 평가한다. 재최적화 공격에서 original LADE의 accuracy는 0.240, augmented LADE는 0.480이다.
저자들은 target LLM에 safety alignment가 있어야 latent safety signal이 나타난다고 밝힌다. 약하게 정렬된 모델에는 LADE가 안전 정렬을 대신하지 않는다. 일부 target에서는 harmful reference manifold와 benign query가 겹쳐 over-refusal이 발생하며, Mistral의 Alpaca 결과가 그 예다. 첫 토큰 출력확률에 접근해야 하고, 고정된 safety-signal token set을 아는 공격자가 이를 피하도록 입력을 최적화할 수 있다는 점도 한계로 제시한다.
References
Lee, W., Yang, K., Ji, G., Patil, V., Park, H., Ham, B., Bansal, M., & Kim, S. (2026). Safeguarding LLMs via model-agnostic latent safety signals from dark knowledge [Preprint]. arXiv. https://arxiv.org/abs/2610.07532v1