A Survey of Agentic Reasoning for Large Language Models
에이전틱 추론을 기초 능력·자기 진화·협업으로 나누어 읽는다. 무엇을 실행 중에 바꾸고 무엇을 학습하는지, 어떤 평가가 필요한지 살펴보고, v2의 분류 경계와 PDF·HTML 서지 차이를 검토한다.
Paper: Tianxin Wei; Ting-Wei Li; Zhining Liu; 외 26인 (2026). A Survey of Agentic Reasoning for Large Language Models: Towards Recursively Self-Improving and Collective Agents. arXiv:2601.12538v2 (2026-09-20). PDF · HTML · 논문 목록 저장소. 이 글은 135쪽의 v2를 기준으로 한다. 위 제목은 arXiv 메타데이터의 표기이며, PDF·HTML 본문의 표제는 Agentic Reasoning for Large Language Models — Foundations · Evolution · Collaboration이다.
Abstract: 좋은 답을 생성하는 능력과, 환경을 관찰하며 여러 단계의 일을 끝내는 능력은 같지 않다. 이 서베이는 LLM의 추론을 계획·도구·검색, 경험을 활용한 갱신, 다중 에이전트의 협업으로 넓혀 정리한다. 핵심은 추론이 행동을 고르고, 행동의 결과가 다음 추론의 조건을 바꾸는 순환이다. 저자들은 기초 능력·자기 진화·집단 추론의 세 관점과 in-context·post-training의 두 접근을 연결하고, 이를 응용과 평가까지 확장한다. 이 글은 그 분류가 실제 설계에 어떤 질문을 던지는지 설명한 뒤, 서로 다른 최적화 대상을 한 이름으로 묶는 부분과 v2의 도판·서지 연결 문제를 검토한다. 연구 분야를 정리한 서베이지, 하나의 시스템이 모든 분야에서 우월함을 검증한 논문은 아니다.
수식 없이 읽는 버전은 쉽게 읽는 에이전틱 추론 서베이에 있다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 연구 질문 | 모델 내부의 답안 생성에서, 환경과 상호작용하며 계획·행동·수정하는 추론으로 범위를 넓히면 무엇을 함께 설계해야 하는가? |
| 세 관점 | 기초 능력은 한 과제를 수행하는 방법, 자기 진화는 경험이 다음 수행에 남는 방식, 집단 추론은 여러 에이전트가 역할과 정보를 나누는 방식을 다룬다. |
| 두 접근 | 모델 가중치를 고정한 채 문맥·검색·워크플로를 조정하는 in-context 접근과, SFT·RL 등으로 행동을 최적화하는 post-training 접근을 구분한다. 다만 협업 절에서는 후자를 프롬프트·연결 구조의 최적화까지 넓게 쓴다. |
| 중요한 구분 | 기억에 실패 원인을 기록하는 것, 도구 코드를 추가하는 것, 모델 가중치를 갱신하는 것은 서로 다른 변경이다. 자기 진화가 항상 가중치 학습을 뜻하지는 않는다. |
| 구조의 강점 | §4.3이 §3의 계획·도구·검색을 갱신 대상으로 다시 다루고, §6의 다섯 응용을 세 관점으로 반복해서 살펴본다. |
| 평가의 관점 | 개별 능력 평가와 종단간 업무 평가를 나눈다. 도구 호출 성공, 근거 검색, 장기 기억, 협업 조정은 같은 점수로 대체하기 어렵다. |
| 읽을 때의 경계 | 세 관점은 성숙도 등급이나 필수 도입 순서가 아니다. 표의 대표 시스템 목록도 성능 순위표가 아니다. |
| 판본 주의 | Figure 12의 안내 번호와 본문이 다르며, PDF와 HTML의 참고문헌 번호·본문 연결도 일치하지 않는다. 개별 연구를 재인용할 때 제목과 원문을 확인해야 한다. |
목차
- 더 오래 생각하는 것과 환경을 확인하는 것
- 관찰과 추론, 행동을 나누어 본다
- 기초 능력은 계획과 도구, 검색의 연결이다
- 경험이 다음 수행에 남아야 한다
- 여러 에이전트보다 중요한 것은 조정 방식이다
- 응용을 같은 질문으로 비교한다
- 무엇을 평가하는지 먼저 정한다
- 열린 문제는 순환의 어디에 놓이는가
- 분류와 서지를 읽을 때의 주의점
- 적용 조건과 결론
1. 더 오래 생각하는 것과 환경을 확인하는 것
코드를 고치는 에이전트를 생각해 보자. 오류 메시지만 읽고 수정안을 길게 설명할 수도 있지만, 파일을 열고 가정을 세운 뒤 테스트를 실행할 수도 있다. 테스트가 실패하면 새 관찰을 바탕으로 가정을 고친다. 두 경우 모두 추론은 필요하지만, 후자는 추론 도중에 얻을 정보와 수행할 행동을 스스로 선택한다. 이 예시는 차이를 설명하기 위한 것이며 서베이가 새로 실행한 실험은 아니다.
서베이는 이 차이를 test-time computation과 test-time interaction의 대비로 설명한다. 내부 계산을 늘리는 것뿐 아니라, 도구·검색·기억·환경 피드백을 이용해 다음 단계를 결정하는 일에 주목한다. 이때 추론은 단순한 중간 설명이 아니라 지각·계획·결정·검증을 연결하는 과정이 된다. 논문 §1–2
다만 이 대비를 ‘일반 LLM은 계획할 수 없고 에이전트만 계획한다’는 절대적인 구분으로 받아들일 필요는 없다. 같은 모델도 어떤 도구와 기억, 제어 흐름을 붙이느냐에 따라 다른 시스템으로 작동한다. 논문의 구분은 개별 모델의 능력을 이분하는 법칙보다 연구와 시스템을 바라보는 관점에 가깝다.
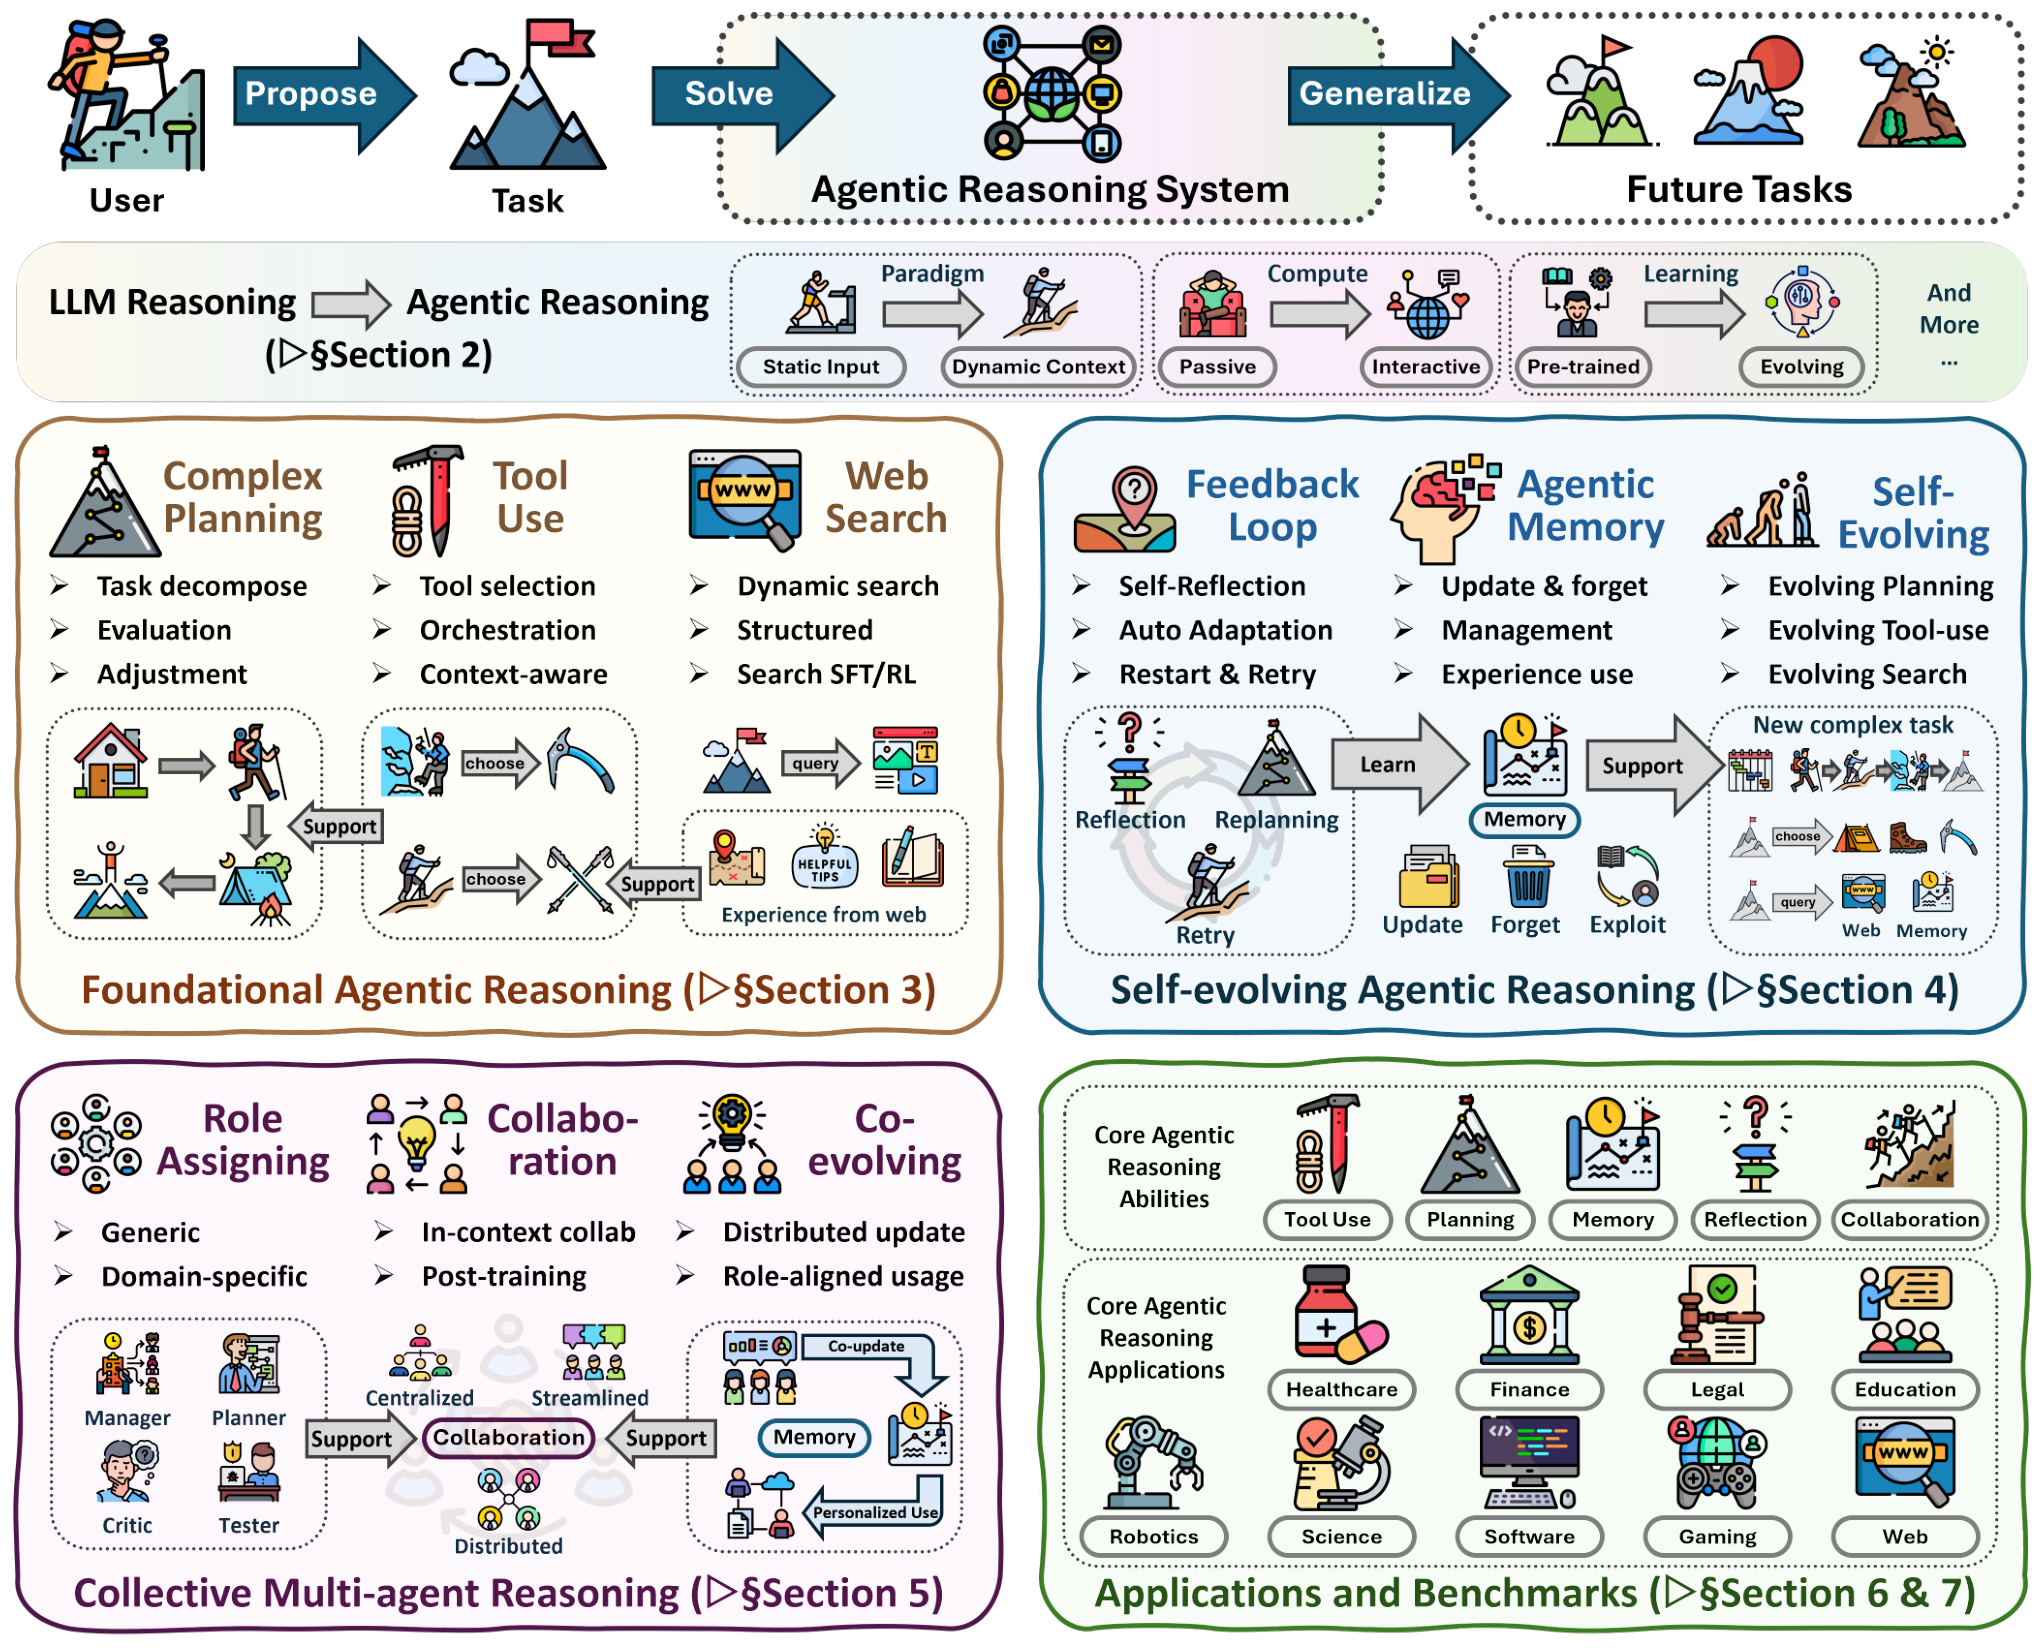
Figure 1. 계획·도구·검색, 피드백·기억·갱신, 역할·협업을 하나의 그림에 배치한다. 아래 오른쪽의 응용 아이콘과 실제 절 구성은 일대일 대응이 아니므로, 세부 탐색에는 본문 목차를 함께 사용해야 한다. 논문 v2, 2쪽 Figure 1에서 인용.
세 관점을 읽는 질문은 다음과 같다.
- 기초 능력: 지금 주어진 과제를 어떤 행동 순서로 풀 것인가?
- 자기 진화: 이번 경험에서 무엇을 바꾸어 다음 수행에 남길 것인가?
- 집단 추론: 여러 주체가 무엇을 맡고 어떤 정보를 교환할 것인가?
이는 반드시 기초에서 자기 진화를 거쳐 집단으로 올라가는 성숙도 사다리가 아니다. 기억을 갱신하는 단일 에이전트도 있고, 구성 요소를 학습시키지 않는 다중 에이전트도 있다. 한 시스템이 여러 관점에 동시에 해당할 수 있다.
2. 관찰과 추론, 행동을 나누어 본다
2.1 환경의 상태와 모델의 문맥은 다르다
§2.2는 환경을 부분 관측 마르코프 의사결정 과정(POMDP)으로 설명한다. 에이전트는 환경의 실제 상태를 전부 알지 못하고, 사용자 입력이나 API 반환값 같은 관찰을 얻는다. 내부의 기억·문맥은 그 관찰 이력을 요약한 것이지 환경 자체가 아니다.
예를 들어 웹페이지의 일부를 읽었다고 해서 전체 사이트의 상태를 아는 것은 아니다. 오래된 메모에 상품이 재고 있음으로 기록되어 있어도 지금의 재고는 달라질 수 있다. 이처럼 알고 있다고 기록한 상태와 바깥의 실제 상태를 구분하는 것이 도구 호출과 재검색의 이유가 된다.
논문은 이력 h_t에서 내부 추론 z_t와 외부 행동 a_t를 선택하는 정책을 다음과 같이 분해한다.
π_θ(z_t, a_t ∣ h_t) = π_reason(z_t ∣ h_t) · π_exec(a_t ∣ h_t, z_t) (식 1)
먼저 지금까지의 관찰과 이력에 따라 추론하고, 그 추론을 조건으로 행동을 선택한다는 뜻이다. 행동에는 도구 호출뿐 아니라 최종 답변도 포함된다. z_t는 잠재 계획이나 명시적으로 표현한 추론 흔적을 포괄하며, 언제나 사용자에게 보이는 긴 사고 문장이어야 하는 것은 아니다.
이 식은 여러 시스템을 설명하기 위한 형식화다. 두 항이 반드시 서로 다른 모델이어야 한다거나, 이 구조만 갖추면 과제 성공이 보장된다는 뜻은 아니다. 논문 §2.2
2.2 무엇을 고정하고 무엇을 바꾸는가
논문의 기본 대비는 다음과 같다.
| 접근 | 주로 바꾸는 대상 | 예시 | 남는 부담 |
|---|---|---|---|
| In-context | 문맥, 후보 경로, 도구 호출 순서, 실행 중 워크플로 | 추론과 행동을 번갈아 수행하거나 후보 계획을 탐색한다. | 검색·검증·추가 호출 비용이 추론 시점에 든다. |
| Post-training | 학습 가능한 정책의 파라미터 | 좋은 행동 궤적을 SFT로 학습하거나 결과 보상으로 RL을 수행한다. | 학습 데이터·보상·일반화 조건을 설계해야 한다. |
§2.2는 후자를 PPO·GRPO 계열의 정책 최적화로 설명한다. GRPO의 집단 상대 이점은 같은 질문에서 나온 보상 r_i를 평균 μ와 표준편차 σ로 정규화하는 형태다.
Â_i = (r_i − μ) / (σ + δ) (식 4, δ는 작은 양수)
그룹 안에서 상대적으로 좋은 행동에 더 큰 신호를 주는 장치지만, 보상이 원하는 능력을 잘 반영하는지는 별개다. 도구를 적게 쓰는 것만 보상하면 필요한 확인을 생략할 수도 있다. 이 예시는 보상 설계의 주의점을 설명하기 위한 것이며 서베이의 실험 결과는 아니다.
‘실행 중에 바꾸는가’와 ‘가중치를 바꾸는가’도 서로 다른 질문이다. 실행 중 메모만 바꿀 수도 있고, 별도의 시험 시점 적응 절차가 가중치를 바꿀 수도 있다. 또한 §5.2.2는 post-training collaboration에 프롬프트와 통신 구조의 탐색까지 포함한다. 따라서 이 서베이 전체에서 해당 이름을 기반 LLM 가중치 갱신의 동의어로 사용해서는 안 된다.
3. 기초 능력은 계획과 도구, 검색의 연결이다
3.1 계획: 다음 단계의 후보와 평가 기준을 만든다
계획은 해야 할 일을 나열하는 데 그치지 않는다. 후보를 만들고, 제약을 확인하고, 결과에 따라 순서를 고치는 과정이다. §3.1은 워크플로 설계, 트리 탐색·알고리즘 모사, 형식화, 분해, 외부 도구 활용, 보상·제어 관점의 연구를 묶는다.
Tree-of-Thoughts 계열은 부분 추론을 후보 노드로 두고 여러 경로를 탐색한다. 외부 계획기나 코드 실행을 활용하는 방식은 모델의 언어적 판단만으로 계획을 평가하지 않으려는 접근이다. 같은 ‘계획’이라도 후보를 누가 만들고, 무엇이 그 후보를 탈락시키는지가 다르다.
이 구분이 실무에 주는 질문은 명확하다. 계획이 실패했을 때 새로운 후보를 더 만들어야 하는가, 아니면 후보를 평가하는 기준부터 고쳐야 하는가? 실행 가능성을 확인하지 않는 계획을 길게 만드는 것과, 실제 제약을 검사하는 계획은 같은 개선이 아니다. 논문 §3.1
3.2 도구: 언제, 무엇을, 어떻게 호출할지 결정한다
도구 사용에서는 올바른 API 이름을 맞히는 것 외에도 호출 시점, 인자, 반환값의 해석, 실패 후 행동이 필요하다. 서베이는 이를 in-context 통합, post-training 통합, 오케스트레이션 기반 통합으로 정리한다.
ReAct처럼 추론과 행동을 번갈아 배치하는 방식은 반환값을 다음 판단에 사용한다. SFT는 호출 예시와 상호작용 궤적을 학습시키고, RL은 결과 신호를 이용해 정책을 조정한다. 오케스트레이션은 여러 도구와 처리 단계를 어떻게 연결할지에 초점을 둔다. 이들은 하나의 배타적인 분류라기보다 서로 결합할 수 있는 설계 선택이다.
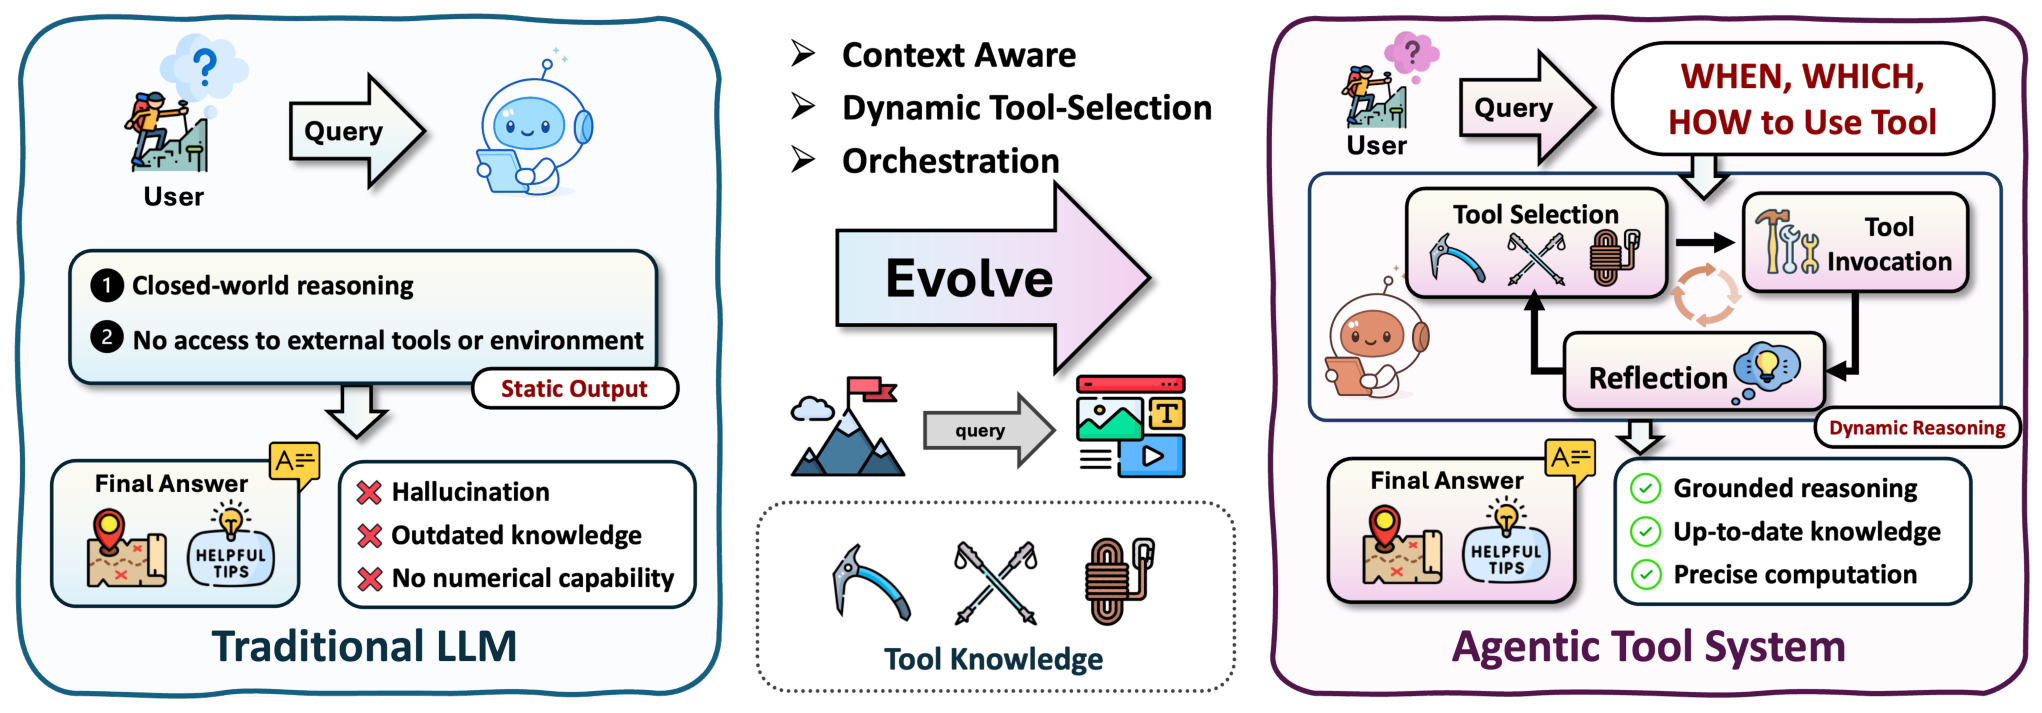
Figure 3. 도구를 쓸 시점·종류·방법을 선택하고 반환 결과를 다시 판단하는 순환을 보여 준다. 원도판의 환각 감소·최신성·정확한 계산은 기대하는 효과이며, 도구를 연결하기만 하면 자동으로 보장되는 성질은 아니다. 논문 v2, 15쪽 Figure 3에서 인용.
예를 들어 검색 도구가 성공 응답을 반환해도 찾은 내용이 질문의 근거라는 보장은 없다. 코드가 실행되어도 그 코드가 의도한 계산을 했는지 확인해야 한다. 따라서 호출 성공과 과제 성공을 분리해서 평가하는 것이 중요하다. 논문 §3.2
3.3 검색: 부족한 근거가 다음 질의를 바꾼다
고정된 질의로 한 번 검색한 뒤 답하는 방식과 달리, 에이전틱 검색은 언제 무엇을 더 찾아야 하는지 추론 과정에서 결정한다. Self-Ask나 IRCoT처럼 질문을 나누고 중간 결과에 따라 검색을 이어 가는 방법이 이 관점을 보여 준다.
가령 A와 B의 관계를 묻는 질문에서 A에 관한 근거만 찾았다면, 모델은 곧바로 연결을 추측하는 대신 빠진 연결 사실을 대상으로 후속 검색을 할 수 있다. 이는 방법의 동작을 설명하기 위한 예시다.
§3.3과 Table 4는 in-context, post-training, 구조 강화 검색을 다룬다. 그래프·계층 구조는 지식을 조직하는 방식이고, in-context·post-training은 행동을 조정하는 방식이므로 축이 완전히 같지는 않다. 본문의 구조 강화 검색은 §3.3.1 아래 소제목으로 배치된다. 표의 세 묶음을 세 개의 동등한 번호 절로 옮겨 읽지 않는 편이 정확하다. 논문 §3.3
4. 경험이 다음 수행에 남아야 한다
4.1 피드백은 출처와 반영 방식이 다르다
서베이는 피드백을 반성적 피드백, 파라미터 적응, 검증자 주도 피드백으로 나눈다. 이름보다 중요한 것은 신호가 어디에서 와서 무엇을 바꾸는가다.
| 방식 | 주로 쓰는 신호와 반영 방식 | 구분할 점 |
|---|---|---|
| 반성적 피드백 | 시도의 실패를 분석한 문장을 다음 추론의 문맥에 넣는다. | 자기 비평이 정확한 진단인지는 별도 검증이 필요하다. |
| 파라미터 적응 | 피드백을 학습 데이터나 보상으로 바꾸어 정책을 갱신한다. | 잘못된 신호가 이후 과제에도 남을 수 있다. |
| 검증자 주도 피드백 | 출력의 적합성을 판정하고 재시도·수정을 유도한다. | 통과 여부와 실패 원인 설명은 같은 정보가 아니다. |
§4.1.3은 해당 범주의 피드백이 비진단적일 수 있다는 한계를 적는다. 이것을 ‘모든 외부 검증자는 이유를 설명하지 못한다’로 일반화할 수는 없다. 테스트나 실행 로그는 구성에 따라 상세한 진단을 제공할 수 있다. 서베이가 나누는 것은 연구 흐름의 특징이지 모든 검증기의 필수 속성이 아니다. 논문 §4.1
4.2 기억의 내용과 기억을 관리하는 정책을 나눈다
기억은 단순히 대화 이력을 길게 보관하는 기능보다 넓다. §4.2는 원문·요약·워크플로·행동 궤적 같은 평면적 기억의 활용, 그래프·멀티모달 구조, 그리고 기억을 관리하는 정책의 학습을 다룬다.
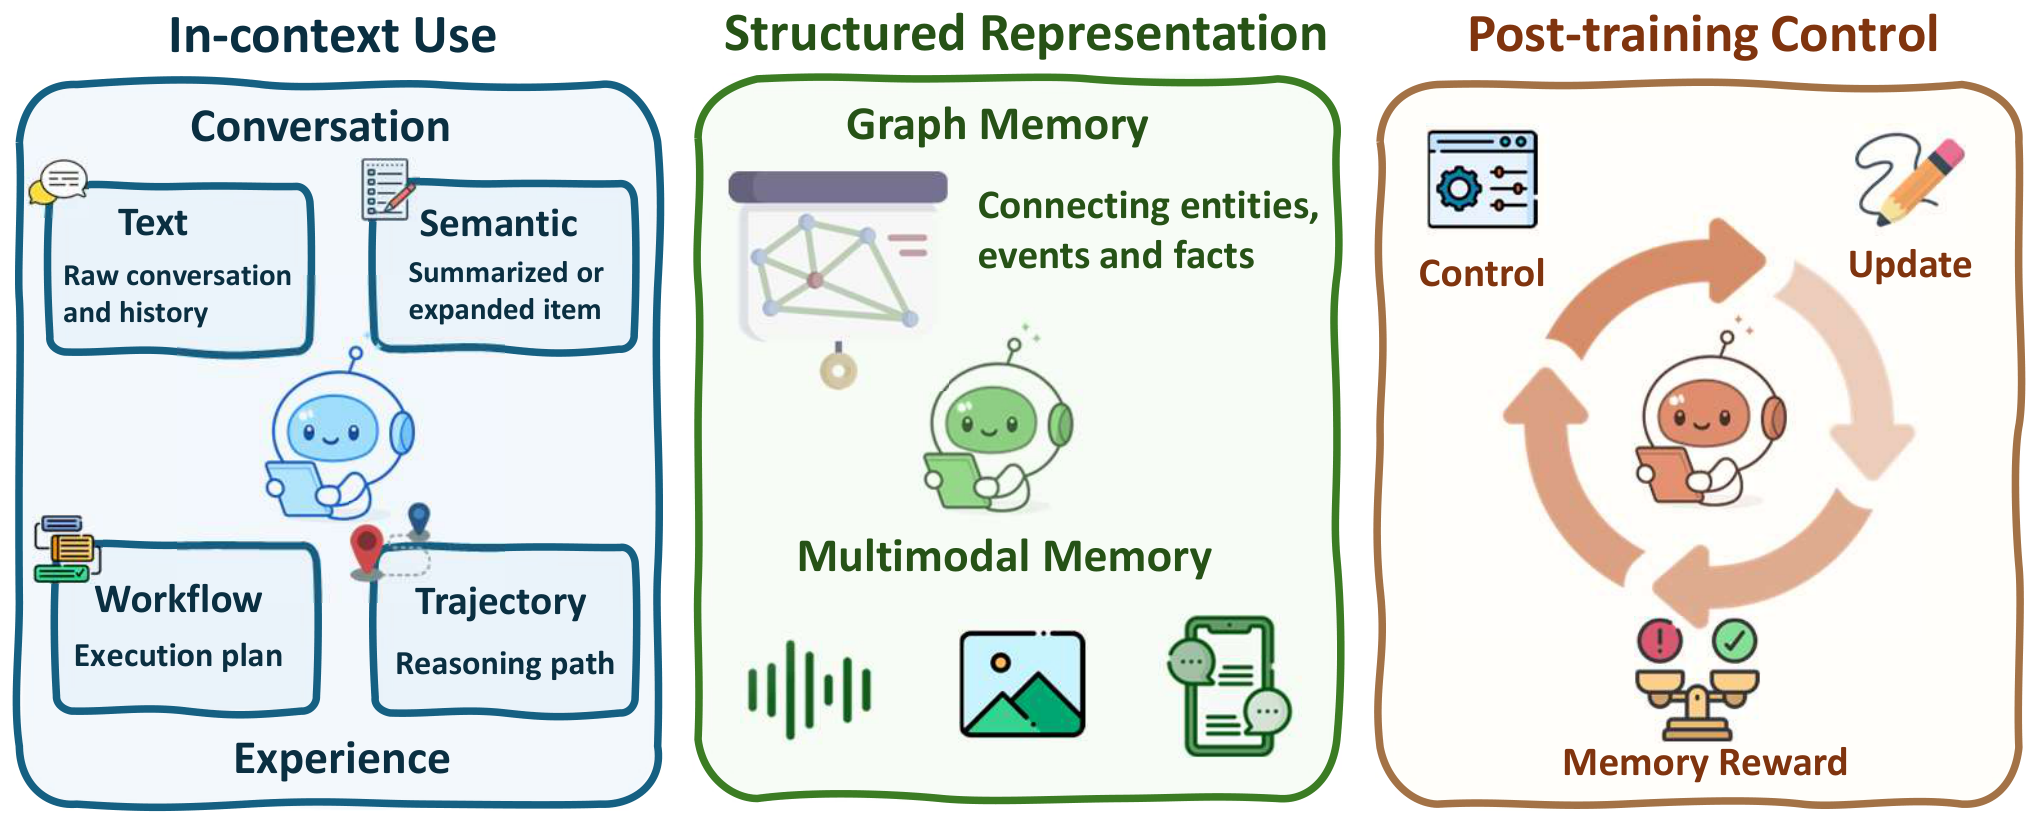
Figure 6. 왼쪽은 대화·경험을 어떤 형태로 남기는지, 가운데는 기억을 어떻게 연결하는지, 오른쪽은 제어·갱신 정책을 어떻게 학습하는지에 초점을 둔다. 서로 조합 가능한 관점이다. 논문 v2, 24쪽 Figure 6에서 인용.
예를 들어 “다음에는 파일을 고치기 전에 버전을 확인하라”는 메모를 저장하면 다음 과제의 문맥이 바뀐다. 그러나 모델 가중치가 달라진 것은 아니다. 반대로 어떤 메모를 저장·검색·삭제할지 정책을 학습하면, 바뀌는 것은 기억의 개별 내용뿐 아니라 기억을 다루는 의사결정 방식이다.
좋지 않은 기록을 오래 남기는 것은 개선과 반대일 수 있다. 따라서 무엇을 보존할지와 함께, 오래되거나 잘못된 정보를 언제 갱신·폐기할지 확인해야 한다. 논문 §4.2
4.3 계획·도구·검색 자체를 갱신한다
§4.3이 서베이의 구조를 가장 잘 보여 준다. §3에서 다룬 세 능력을 그대로 받아, 계획 전략을 고치고, 새 도구를 만들고, 검색·지식 기반을 갱신하는 연구를 정리한다.
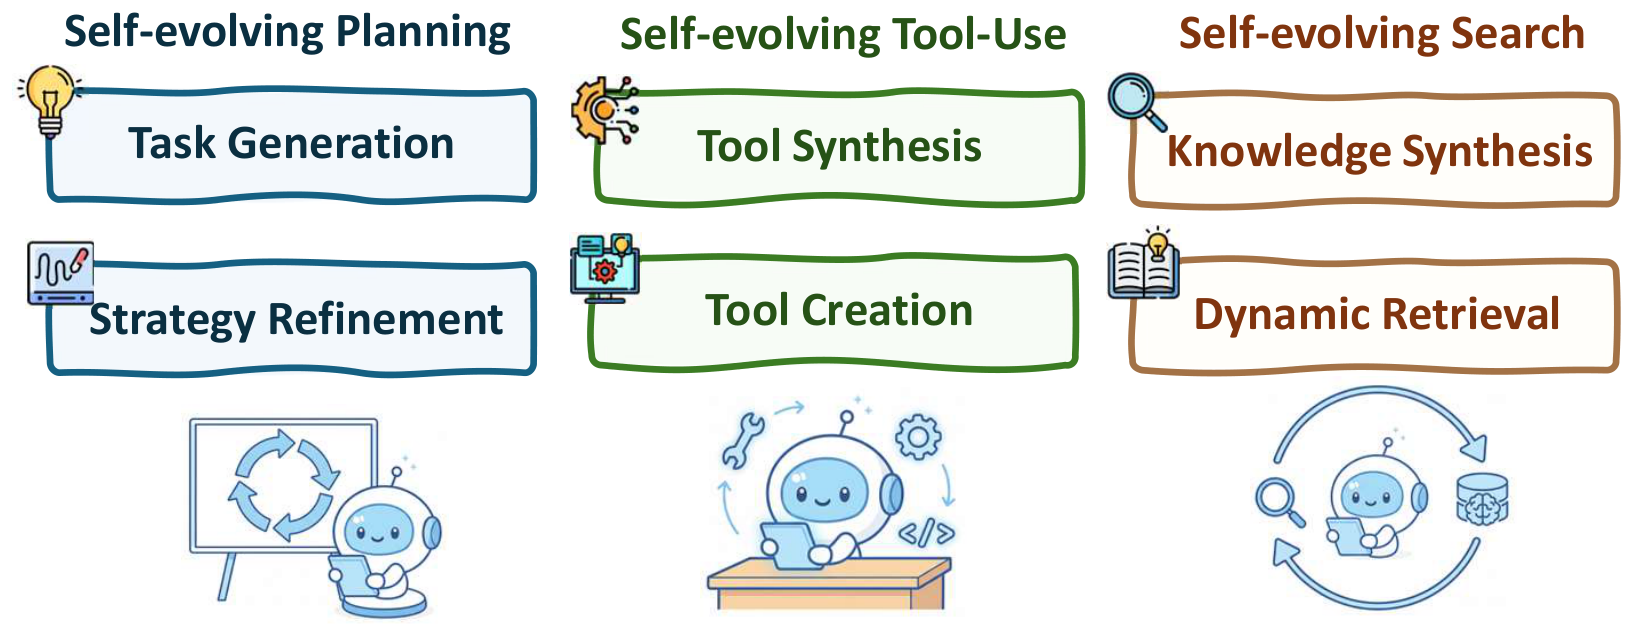
Figure 7. 기초 능력의 실행과 그 능력을 만드는 구성 요소의 갱신을 연결한다. 도구를 한 번 사용하는 일과 이후에도 재사용할 도구를 만드는 일은 다르다. 논문 v2, 28쪽 Figure 7에서 인용.
LATM의 tool maker와 tool user 구분은 이 차이를 설명하기 좋다. 하나의 역할은 필요한 도구를 만들고 다른 역할은 그것을 사용한다. 실행 가능한 함수를 라이브러리에 넣는 것은 행동 수단을 확장하는 일이며, 그 자체로 기반 모델을 미세조정했다는 뜻은 아니다.
§2.2의 자기 진화 식은 이 관계를 간단히 나타낸다.
S_(k+1) ← U(S_k, τ_k, F_k) (식 5)
시스템 상태 S_k를 실행 궤적 τ_k와 피드백 F_k로 갱신한다. 상태에는 텍스트 지침, 기억, 도구 라이브러리, 코드 등이 들어갈 수 있다. 중요한 질문은 U라는 갱신 절차가 무엇을 바꾸고 어떤 검증을 거치는가다. 상태가 달라졌다는 사실만으로 성능이 좋아졌거나 재귀적 자기개선이 달성됐다고 말할 수는 없다. 논문 §4.3
5. 여러 에이전트보다 중요한 것은 조정 방식이다
5.1 역할 이름보다 책임과 정보 흐름을 본다
§5.1은 계획자·비평가 같은 일반 역할과 도메인별 역할을 나눈다. 그러나 프롬프트에 역할 이름을 적는 것만으로 협업이 성립하지는 않는다. 누가 어떤 입력을 받고, 어떤 결과를 넘기며, 충돌이 생겼을 때 누가 결정하는지가 필요하다.
§5.2의 in-context 협업은 고정된 순차 파이프라인, 계층적 조정, 역할 기반 분해, LLM이 구성하는 동적 워크플로를 포함한다. 라우팅은 그중 누구에게 다음 작업을 맡길지를 정하는 결정이다. 중앙 조정자가 모든 결과를 보는 구조와, 각 에이전트가 일부 정보만 받아 움직이는 구조는 실패 양상도 다를 수 있다.
서베이는 이를 다중 주체의 부분 관측 문제로 확장한다. 한 에이전트가 보낸 메시지가 다른 에이전트에게는 관찰이 되고, 그 관찰이 다음 추론과 행동을 바꾼다. 따라서 통신은 단순한 부가 비용이 아니라 추론 과정의 일부다. 논문 §5.1–5.2
5.2 협업에서 post-training의 범위는 더 넓다
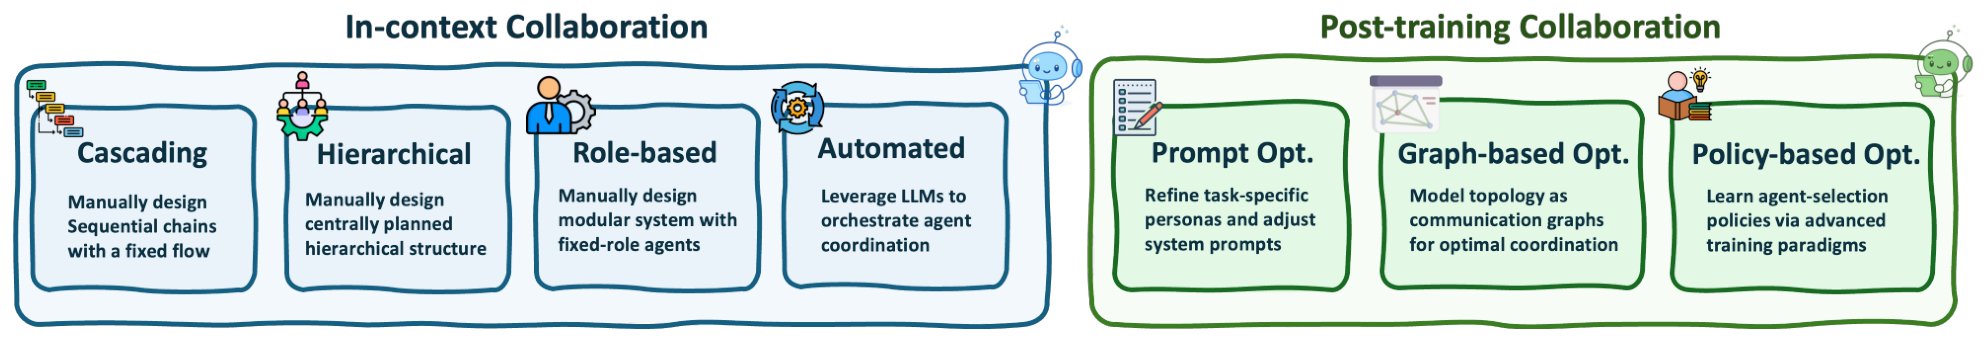
Figure 9. 왼쪽은 순차·계층·역할·자동 조정, 오른쪽은 프롬프트·그래프·정책 최적화를 배치한다. 오른쪽의 모든 방법이 기반 LLM의 가중치를 갱신하는 것은 아니다. 논문 v2, 34쪽 Figure 9에서 인용.
이 절에서 post-training collaboration은 학습뿐 아니라 탐색으로 역할·연결·라우팅을 최적화하는 연구까지 포괄한다. 예를 들어 DSPy Assertions는 검증 실패를 이용한 프롬프트 수정과 예시 구성을 다루고, AFlow는 연산자와 워크플로를 탐색한다. 이들과 정책을 SFT·RL로 학습하는 방식은 최적화 대상이 다르다.
따라서 이 절을 읽을 때는 다음 네 가지를 따로 표시하는 편이 유용하다.
- 역할 지시와 예시 같은 프롬프트를 바꾸는가?
- 누가 누구에게 말하는지 정하는 통신 그래프를 바꾸는가?
- 다음 에이전트를 고르는 라우팅 정책을 학습하는가?
- 개별 에이전트의 모델 파라미터를 갱신하는가?
이는 원문의 여러 최적화 대상을 풀어 정리한 독서 기준이다. 어느 방식이 항상 더 좋다는 순위는 아니다.
5.3 팀의 경험은 어디에 남는가
§5.3은 개별 에이전트의 개선을 팀 수준으로 확장한다. 공유 기억을 누가 쓰고 고칠지, 역할마다 무엇을 볼 수 있을지, 공동 결과에 대한 보상을 누구에게 배분할지가 문제다. §5.3.2는 특히 다중 에이전트 기억 관리의 post-training을 아직 충분히 다뤄지지 않은 영역으로 짚는다.
다중 에이전트가 같은 잘못된 근거를 공유하면 독립적인 확인이 아니라 오류의 반복이 될 수 있다. 역할을 늘린 효과와 총 계산량을 늘린 효과도 구분해야 한다. 따라서 같은 예산의 단일 에이전트와 비교하고, 메시지·도구 호출·실패 복구 비용까지 살펴보자는 것이 이 리뷰의 적용상 권고다. 서베이가 모든 방법에 대해 그런 통제 실험을 수행했다는 뜻은 아니다. 논문 §5.3
6. 응용을 같은 질문으로 비교한다
§6의 장점은 다섯 응용을 모두 기초 능력·자기 진화·집단 추론이라는 같은 틀로 살펴본다는 것이다. 독자는 분야가 달라도 ‘지금 무엇을 하는가, 경험이 어디에 남는가, 누가 역할을 나누는가’를 반복해서 물을 수 있다.
아래 표의 영역 구분은 원문을 따르고, 각 칸의 질문은 그 논의를 압축한 해설이다. 공통 조건에서 실행한 성능 비교표는 아니다.
| 응용 | 기초 능력에서 볼 것 | 자기 진화에서 볼 것 | 집단 추론에서 볼 것 |
|---|---|---|---|
| 수학 탐색·코딩 | 풀이·코드 후보를 만들고 실행·검증하는가? | 오류·성공 경험이 전략이나 도구로 남는가? | 제안·구현·검증의 역할이 어떻게 연결되는가? |
| 과학적 발견 | 가설·실험·분석 도구를 어떻게 연결하는가? | 실험·시뮬레이션 결과가 다음 탐색을 바꾸는가? | 전문 지식과 검증 책임을 어떻게 나누는가? |
| 체화 에이전트 | 관찰과 물리적 행동을 어떻게 연결하는가? | 환경 변화와 실패에 어떻게 적응하는가? | 여러 주체의 행동과 자원을 어떻게 조정하는가? |
| 의료·건강 | 필요한 정보와 근거를 어떻게 수집하는가? | 피드백을 축적할 때 오류와 민감정보를 어떻게 관리하는가? | 전문 역할의 판단을 어떻게 통합하는가? |
| 자율 웹 탐색·연구 | 탐색·증거 추출·종합을 어떻게 이어 가는가? | 탐색 이력과 전략을 어떻게 재사용하는가? | 탐색자·추출자·통합자가 무엇을 주고받는가? |
웹 탐색의 INFOGENT 사례에서는 Navigator가 페이지를 찾고, Extractor가 증거를 추출하고, Aggregator가 결과를 합치며 추가 탐색을 요청한다. 이 예시는 ‘여러 모델이 답한다’보다 중간 산출물과 피드백 경로가 어떻게 연결되는가를 보여 준다. 논문 §6.5.3
과학 분야에서는 가설을 언어로 설득력 있게 만드는 것과 실험·시뮬레이션 결과로 검증하는 것이 다르다. 의료에서도 문헌이나 시뮬레이션 과제를 잘 수행했다는 사실만으로 임상 효용과 안전성이 확립되는 것은 아니다. 이 서베이의 응용 목록은 연구를 찾는 출발점이지 각 배포 환경에 대한 검증을 대신하지 않는다. 논문 §6
7. 무엇을 평가하는지 먼저 정한다
7.1 능력 평가와 전체 업무 평가를 나눈다
§7.1은 도구, 검색, 기억·계획, 다중 에이전트 시스템을 다룬다. §7.2는 체화·과학·자율 연구·의료·웹·일반 도구 사용의 응용 평가를 다룬다. 개별 능력이 어디서 실패하는지 진단하는 일과 전체 업무가 끝났는지 판단하는 일은 서로 보완적이다.
| 평가 질문 | 서베이에 나오는 예시 | 구분할 점 |
|---|---|---|
| 언제 어떤 도구를 골라야 하는가? | MetaTool, T-Eval | API 호출 형식이 맞는 것과 도구 선택이 적절한 것은 다르다. |
| 탐색으로 필요한 근거를 모으는가? | WebWalker, Mind2Web 2, MMSearch | 검색 결과를 얻는 것과 답을 뒷받침하는 증거를 찾는 것은 다르다. |
| 지난 기록을 회수하고 제약을 유지하는가? | LOCOMO, LongMemEval, PlanBench, TravelPlanner | 기억 회수와 여러 단계 계획은 하나의 능력이 아니다. |
| 공동 의사결정을 잘하는가? | LLM-Coordination, AvalonBench, 게임·시뮬레이션 계열 | 발언 수나 합의율만으로 협업의 유용성을 판단하기 어렵다. |
| 실제 형태의 업무를 완료하는가? | 과학·웹·체화·의료 응용 벤치마크 | 성공률과 함께 실패의 위치·비용·안전 제약을 살펴야 한다. |
마지막 열은 원문의 분류를 바탕으로 정리한 해석상 주의점이다. 각 벤치마크의 정의와 세부 지표는 해당 원논문에서 확인해야 한다. 논문 §7
7.2 도판과 본문의 안내가 다르다
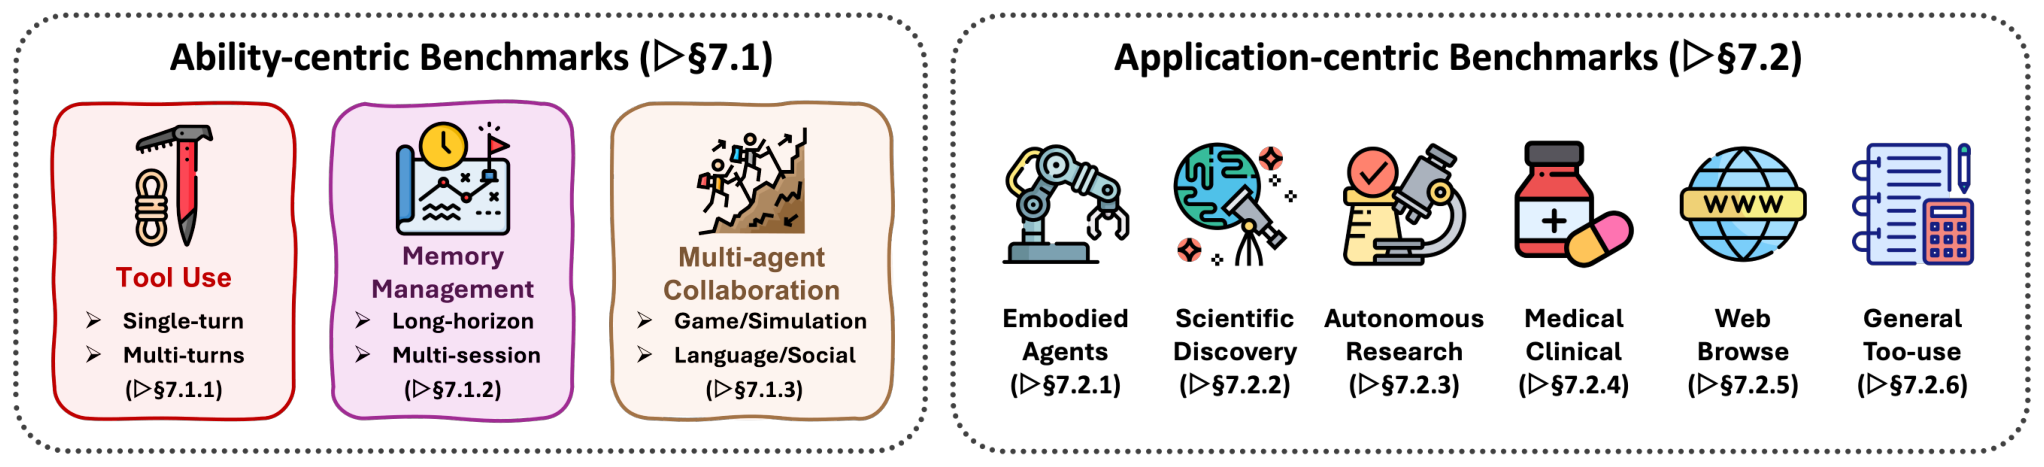
Figure 12. 왼쪽에는 도구·기억·다중 에이전트 세 상자가 있지만 본문 §7.1에는 검색도 포함된다. 도판의 기억 §7.1.2는 실제 §7.1.3, 다중 에이전트 §7.1.3은 실제 §7.1.4에 해당한다. 원도판은 수정하지 않고 이 차이를 설명한다. 논문 v2, 65쪽 Figure 12에서 인용.
도판의 번호를 그대로 따라가면 다른 절로 이동할 수 있으므로 본문 목차를 기준으로 읽는 편이 낫다. 다만 이 불일치가 언제, 어떤 편집 과정에서 생겼는지는 공개된 도판만으로 알 수 없다.
수학·소프트웨어 개발도 범위를 정확히 말해야 한다. §7에는 이를 위한 전용 하위 절이 없지만, 과학 에이전트의 코드 구현이나 CodeAct의 실행·구성 평가처럼 코딩을 포함하는 논의는 있다. 따라서 ‘코딩 평가가 전혀 없다’는 요약은 부정확하다. §6.1은 기존 수학 벤치마크의 한계를 논의하지만, 그것이 §7의 절 구성을 정한 명시적 이유라고 서술하지는 않는다.
7.3 시스템을 고를 때는 비교 예산을 맞춘다
도구 호출, 재검색, 반성, 토론은 모두 자원을 쓴다. 성공률만 높아졌을 때, 구성 자체가 더 효과적인지 아니면 더 많은 토큰과 호출을 사용한 결과인지 구분할 필요가 있다.
이 리뷰에서는 적용 환경의 평가를 다음처럼 나누는 것을 권한다.
- 같은 모델·문항·도구 권한에서 직접 응답, 단일 에이전트 루프, 다중 에이전트를 비교한다.
- 성공률과 함께 호출 수·시간·비용, 잘못된 행동과 복구율을 기록한다.
- 기억을 쓰면 과거 기록의 오류·노후화와 새로운 과제로의 전이를 확인한다.
- 자기 갱신을 쓰면 갱신에 사용하지 않은 과제에서 개선과 회귀를 확인한다.
이는 서베이의 분류를 실제 검증 질문으로 바꾼 제안이다. 원문이 이런 조건의 공통 리더보드를 제공한다는 뜻은 아니다.
8. 열린 문제는 순환의 어디에 놓이는가
§8의 여섯 주제는 이름만 나열하면 추상적이지만, 추론–행동–갱신 순환의 병목으로 읽으면 구체적이다.
| 열린 문제 | 남는 질문 |
|---|---|
| 개인화 | 사용자의 목표가 바뀔 때 무엇을 기억하고 수정할 것인가? 적응이 오래된 선호의 고착이나 과도한 추정으로 이어지지 않는가? |
| 장기 시야 추론 | 긴 상호작용의 마지막 성공·실패를 어느 계획·도구 호출·기억 갱신에 귀속할 것인가? |
| 월드 모델 | 실행 전 결과를 예측하는 모형이 실제 환경과 얼마나 맞는가? 예측 오차가 긴 계획에서 누적되지 않는가? |
| 협력 추론과 학습 | 팀의 보상을 개별 기여에 어떻게 나누고, 통신 비용과 비정상적인 상호작용을 어떻게 다룰 것인가? |
| 잠재 추론 | 내부 표현으로 효율을 높일 때 과정을 검사하고 오류의 원인을 찾는 능력은 어떻게 보존할 것인가? |
| 거버넌스 | 여러 도구·기억·에이전트를 거친 결과의 책임과 권한, 감사 기록을 어떻게 추적할 것인가? |
표는 열린 문제의 논의를 질문 형태로 정리한 것이다. 모두 해법이 확립됐다는 뜻은 아니다. 특히 자기 반성이나 다중 에이전트 토론은 독립적인 검증자, 신뢰할 수 있는 근거, 명확한 권한 경계를 자동으로 만들어 주지 않는다. 상호작용이 늘어날수록 검증할 접점도 늘어난다. 논문 §8
9. 분류와 서지를 읽을 때의 주의점
9.1 분류는 유용하지만 모든 절을 같은 축으로 나누지는 않는다
§4.3과 §6의 대응은 일관되고 유용하다. 그러나 in-context·post-training이 모든 하위 절을 양분하는 것은 아니다. 피드백은 출처와 반영 방식, 기억은 표현과 제어, 역할은 일반·도메인 특화라는 다른 축을 사용한다.
Table 2의 Modality는 언어·시각 멀티모달 입력을 뜻하지만, Table 3·4에서는 통합 방식이나 구조 강화 접근을 가르는 이름으로 쓰인다. 앞서 본 §5.2.2의 post-training도 시스템 수준의 탐색을 포함한다. 따라서 같은 표제어가 나와도 각 절에서 실제로 무엇을 분류하는지를 확인해야 한다.
§4.2에는 구체적인 개수 불일치가 있다. 도입은 ‘four emerging trends’라고 적지만 이어지는 설명, 세 하위 절, Figure 6은 세 흐름으로 구성된다. 이는 판본의 안내상 문제로 남는다. 반면 초록이나 그림의 짧은 요약이 모든 목차 항목을 되풀이하지 않는다는 사실만으로 내용상의 모순이라고 할 수는 없다.
Figure 1의 금융·법률·교육 아이콘도 같은 원칙으로 읽어야 한다. §6에 각각의 전용 절은 없지만 §5.1.2의 도메인 역할에서는 다룬다. 전용 응용 절의 부재와 분야 전체의 누락은 다르다.
9.2 PDF와 HTML의 서지 연결은 같지 않다
서베이는 참고문헌 자체도 중요한 탐색 자료이므로, v2의 PDF와 HTML을 각각 검사했다. 두 매체 모두 References 이전 영역으로 범위를 맞추면 인용·링크가 확인된 항목 수는 같다. 다만 표시 번호와 References 뒤의 링크 구성은 다르다.
| 확인 항목 | v2 PDF | v2 HTML |
|---|---|---|
| 참고문헌 항목 수 | 797 | 797 |
| References 이전에서 인용·링크가 확인된 서로 다른 항목 수 | 769 | 769 |
| 같은 범위에서 인용·링크가 확인되지 않은 항목 수 | 28 | 28 |
PDF에서는 References 제목 이전의 숫자 인용을 추출하고, 같은 영역의 cite.* 링크 주석에 표시된 번호 집합을 별도로 대조했다. 두 방식 모두 [152]–[171], [173]–[180]의 28개 항목에서 인용 위치를 찾지 못했다. 본문의 마지막 문단이 74쪽에 남아 있으므로 References 제목을 경계로 삼았으며, 그 직전의 [797]은 포함했다.
HTML에서는 인용 링크가 가리키는 내부 서지 ID를 항목 목록과 비교하되, References 앞뒤를 나누어 집계했다. 표·도판·SVG 내부의 링크도 DOM에 있는 경우 포함했다. References 이전에는 769개 항목의 링크가 있고, HTML 번호 [770]–[797]의 28개 항목은 그 범위에서 연결되지 않는다.
References 뒤의 번호 나열 블록은 이 28개와 [203]을 포함한 29개 항목을 링크한다. 이 블록까지 포함한 합집합은 797개지만, 이를 ‘797편 모두 본문 논의에서 인용됐다’고 표현할 수는 없다. 예를 들어 Transformer Copilot은 PDF에서는 [172], HTML에서는 [203]이며 References 이전에도 인용된다. 번호만 옮겨 검색하면 다른 문헌을 검사할 수 있다.
정정: 최초 게시본은 HTML의 References 뒤 번호 나열 블록까지 포함한 집계를 ‘본문 쪽 링크’라고 설명했다. References 이전의 인용 연결은 두 매체 모두 769개로 바로잡고, 뒤쪽 블록은 별도로 표시했다.
이 결과는 해당 PDF의 인용 표시와 HTML의 링크 연결을 확인한 감사다. 논문의 수록 경위, 각 연구의 관련성, 저자의 의도나 연구 부정행위를 판정한 것이 아니다. 이름의 겹침이나 제목의 특정 단어 빈도만으로 그런 결론을 낼 수도 없다. 또한 한 표현의 연결 문제를 나머지 참고문헌 전체의 부정확성으로 확대해서는 안 된다.
재인용할 때는 매체와 판본을 명시하고 번호뿐 아니라 제목·저자·식별자와 인용 위치를 함께 확인하는 편이 안전하다. 이 글도 본문 설명에는 절 링크를 주로 사용하고, 숫자 범위에는 PDF·HTML 기준을 각각 명시한다. PDF References, 74쪽부터 · HTML References
9.3 큰 목록이 포괄성과 비교 가능성을 보장하지는 않는다
논문의 Survey Scope는 ‘up to 2025’라고 범위를 적는다. 개정일이 2026년 9월이라는 사실을 곧바로 그때까지의 연구를 빠짐없이 포함했다는 뜻으로 바꾸어 읽으면 안 된다. 대표 시스템 표도 공통 데이터셋·모델·예산으로 다시 평가한 순위표가 아니다.
문헌 수집의 검색어, 포함·제외 기준, 대표 시스템의 선정 절차가 더 구체적이면 목록의 성격을 판단하기 쉬워진다. 현재의 분류는 관심 연구를 찾는 데 유용하지만, 특정 방법이 표에 없다는 사실만으로 중요하지 않다거나 성능이 낮다고 결론 낼 수는 없다.
부속 저장소는 계획·도구·검색·자기 진화·협업·응용·벤치마크별 링크 목록과 자료를 제공하며 계속 갱신되는 목록이라고 밝힌다. 이번에 확인한 커밋 6c3d3c6은 PDF와 별개의 시점으로 고정해 읽었다. 저장소 목록과 v2 서지의 일대일 일치, 797개 개별 논문의 내용·실험 정확성은 전수 대조하지 않았다.
10. 적용 조건과 결론
10.1 설계에 사용할 질문
이 서베이를 실제 시스템에 적용한다면 ‘어느 층까지 올라갈까’보다 다음 질문으로 시작하는 편이 낫다.
- 관찰: 지금 모르는 정보는 무엇이며, 어떤 도구가 그것을 확인할 수 있는가?
- 판단: 후보 행동의 좋고 나쁨을 무엇으로 평가하는가? 자기 평가 외의 근거가 있는가?
- 갱신: 문맥·기억·도구·통신 구조·가중치 가운데 무엇이 바뀌는가?
- 지속성: 변경은 현재 시도에서만 쓰이는가, 다음 과제에도 남는가?
- 검증: 갱신에 사용하지 않은 과제에서도 개선되고, 기존 능력은 유지되는가?
- 협업: 역할을 나누면서 새로 생기는 정보 손실·통신 비용·책임 문제는 무엇인가?
- 권한: 잘못된 행동의 영향 범위와 사람의 승인·중단 지점은 어디인가?
이 질문들은 서베이의 구분을 설계 검토용으로 재구성한 것이다. 특정 알고리즘을 도입하라는 처방도, 원문이 모든 조건을 검증했다는 주장도 아니다.
10.2 검토 범위
이 글은 v2 PDF·HTML의 구조와 주요 설명, 원도판, 부속 저장소를 대조했다. PDF의 참고문헌 번호와 본문 인용·링크 주석을 전수 비교했고, HTML의 서지 ID와 인용 링크를 별도로 검사했다. 제공된 도판의 원본 PDF 해시도 내려받은 v2와 일치함을 확인했다.
반면 개별 시스템을 실행하거나 학습하지 않았으며, 각 원논문의 성능 수치를 재현하지 않았다. 저자별 기여와 편집 이력, PDF·HTML 차이가 생긴 원인은 확인하지 못했다. 따라서 방법 설명, 문헌 연결에 관한 관찰, 적용을 위한 해설자의 권고를 구분해 제시했다.
10.3 결론
이 서베이의 유용한 점은 에이전트를 기능 목록으로만 보지 않게 한다는 데 있다. 무엇을 관찰하고 어떤 행동을 선택하는지, 경험이 어디에 남는지, 여러 주체가 무엇을 교환하는지를 한 틀에서 질문할 수 있다. 특히 기초 능력을 갱신 대상으로 다시 보는 §4.3과, 다섯 응용을 같은 세 관점으로 읽는 §6이 좋은 탐색 경로다.
다만 분류 이름이 같다고 최적화 대상까지 같은 것은 아니며, 복잡한 구조가 곧 더 높은 성능을 뜻하지도 않는다. 도판의 안내 불일치와 PDF·HTML의 서지 차이도 재인용할 때 확인해야 한다.
결국 이 논문은 최고의 에이전트를 고르는 순위표보다, 에이전트의 변경 지점과 검증 책임을 찾는 지도로 읽을 때 가장 유용하다. 설계의 선택지를 넓히되, 개선의 증거는 실제 과제·동등 예산·독립 평가에서 따로 확보해야 한다.
References
본문에서 직접 설명한 주요 연구와 자료를 추렸다. 아래 번호는 이 글의 목록 번호이며 원논문의 PDF·HTML 서지 번호와 다르다.
- Wei, T.; Li, T.-W.; Liu, Z.; et al. (2026). A Survey of Agentic Reasoning for Large Language Models: Towards Recursively Self-Improving and Collective Agents. arXiv:2601.12538v2. PDF·HTML 표제: Agentic Reasoning for Large Language Models — Foundations · Evolution · Collaboration.
- Yao, S.; Zhao, J.; Yu, D.; et al. (2022). ReAct: Synergizing Reasoning and Acting in Language Models. arXiv:2210.03629.
- Yao, S.; Yu, D.; Zhao, J.; et al. (2023). Tree of Thoughts: Deliberate Problem Solving with Large Language Models. arXiv:2305.10601.
- Shinn, N.; Cassano, F.; Gopinath, A.; Narasimhan, K.; Yao, S. (2023). Reflexion: Language Agents with Verbal Reinforcement Learning. arXiv:2303.11366.
- Cai, T.; Wang, X.; Ma, T.; Chen, X.; Zhou, D. (2023). Large Language Models as Tool Makers. arXiv:2305.17126.
- Zou, J.; Ban, Y.; Li, Z.; Qi, Y.; Qiu, R.; Yang, L.; He, J. (2025). Transformer Copilot: Learning from the Mistake Log in LLM Fine-tuning. arXiv:2505.16270. 본문의 번호 차이 예시로 사용했다.
- Wei, T., et al. Awesome-Agentic-Reasoning. 확인한 저장소 커밋. 갱신되는 문헌 목록이며 v2 PDF와 동일한 고정 산출물로 취급하지 않는다.