Intent Propagation Contrastive Collaborative Filtering
IPCCF는 사용자–아이템 관계와 2-hop 구조를 교차 전파하고 의도 표현을 대조학습으로 정렬한다. 추천 성능의 개선이 의도 해석의 검증을 뜻하지는 않는다.
Paper: Haojie Li; Junwei Du; Guanfeng Liu; Feng Jiang; Yan Wang; Xiaofang Zhou (2025). "Intent Propagation Contrastive Collaborative Filtering". IEEE Transactions on Knowledge and Data Engineering, 37(5), 2665–2679. https://doi.org/10.1109/TKDE.2025.3543241 · arXiv:2604.15704v1 https://arxiv.org/abs/2604.15704v1
Abstract: IPCCF는 사용자–아이템 직접 관계와 2-hop 사용자–사용자·아이템–아이템 관계를 결합하는 그래프 추천 모델이다. 두 관계의 전파 순서를 교차하는 이중 나선 구조에서 노드 표현을 만들고, 이를 이용해 간선마다 잠재 의도별 가중치를 계산한다. 의도별 이웃 가중치를 정규화한 뒤 평균해 메시지를 전파하며, 구조·의도 관점의 표현을 대조학습으로 정렬한다. Gowalla·Amazon-book·Tmall의 Precision·Recall·NDCG @20/@40에서 비교 모델보다 높은 점수를 보고하고, 의도 전파와 고차 관계를 제거한 절제에서 큰 성능 하락을 보인다. 이 결과는 구조를 확장한 의도 전파의 유용성을 뒷받침하지만, 학습된 의도가 실제 행동 이유와 일치하는지는 별도의 문제로 남는다.
Executive Summary
| 항목 | 핵심 내용 |
|---|---|
| 연구 질문 | 직접 상호작용과 동종 2-hop 구조를 결합하면 잠재 의도를 활용하는 추천 표현이 개선되는가? |
| 방법 | 서로 다른 관계의 전파 순서를 교차하고, 의도별로 정규화한 간선 가중치를 평균해 전파한다. |
| 자기지도 신호 | 동일 노드의 구조·의도·사슬 표현을 정렬한다. 실제 의도 정답을 제공하는 지도학습은 아니다. |
| 보고된 성능 | 세 데이터셋의 Precision·Recall·NDCG @20/@40에서 모두 1위. BIGCF 대비 평균 상대 개선은 각각 6.37%, 6.14%, 9.36%다. |
| 핵심 한계 | 추천 성능과 의도의 의미적 정확도는 서로 다른 평가 대상이다. 반복 통계와 세부 장치의 독립적인 기여는 충분히 제시되지 않았다. |
목차
- 협업 필터링에서 잠재 의도를 분리해야 하는 이유
- 직접 관계와 2-hop 동종 관계
- 이중 나선 메시지 전파
- 의도 메시지 전파
- 추천·대조 목적함수와 설계 근거
- 평가 설계와 비교 조건
- 결과와 절제
- 논문의 기여와 한계
- 결론
1. 협업 필터링에서 잠재 의도를 분리해야 하는 이유
1.1 관측한 행동과 잠재 의도를 구분하기
같은 구매나 클릭에도 가격, 장르, 브랜드 등 여러 이유가 작용할 수 있다. 의도 분리 추천은 관측된 상호작용을 여러 잠재 요인으로 설명하려는 접근이다. 여기서 가격과 장르는 개념을 설명하기 위한 예시다. IPCCF가 학습한 각 의도에 이런 의미가 자동으로 붙는 것은 아니다.
IPCCF의 입력은 사용자–아이템 상호작용이다. 실제 구매 이유를 정답으로 주지 않으므로, 학습된 의도 벡터는 우선 추천에 유용하도록 최적화되는 잠재 파라미터로 이해해야 한다. 추천 성능과 의도의 의미적 정확도는 서로 관련될 수 있지만 같은 평가 대상은 아니다.
1.2 저자들이 겨냥한 문제
논문은 기존 의도 분리 방법이 직접 상호작용에서 얻은 구조에 의존하고, 추천 목적함수만으로 잠재 의도를 학습할 때 분리 과정에 충분한 신호를 받지 못할 수 있다고 진단한다. IPCCF는 동종 노드 관계와 교차 전파로 구조적 관점을 넓히고, 대조학습으로 구조 기반 표현과 의도 기반 표현을 직접 연결한다. 이는 논문 §I의 문제 설정이다.
이 진단을 “기존 GCN은 1-hop만 본다”거나 “기존 의도 분리 모델에는 자기지도 신호가 없다”는 뜻으로 확대하면 부정확하다. 다층 GCN은 이미 다중 홉 정보를 전달하고, DCCF·BIGCF처럼 대조학습을 사용하는 비교 모델도 있다. IPCCF의 특징은 동종 관계를 별도 그래프로 구성하고, 직접 관계와 교차 결합한 구조에서 의도 가중치를 학습한다는 설계에 있다.
이 구분은 DCCF의 관점 간 대조학습과 BIGCF의 상호작용·의도 공간 대조 정규화에서도 확인할 수 있다. DGCF 역시 의도별 상호작용 그래프와 표현을 반복적으로 갱신한다.
1.3 주요 비교 축
| 방법 | 주요 특징 |
|---|---|
| LightGCN | 사용자–아이템 그래프에서 선형 전파를 사용하는 기본 구조. 다층 전파를 통해 고차 연결성도 반영한다. |
| DGCF | 잠재 의도별 상호작용과 표현을 학습하는 비교 대상. |
| DCCF | 의도 분리와 대조학습을 결합하는 비교 대상. |
| BIGCF | 개별·집단 의도를 활용하는 비교 대상이며, 논문 Table III의 모든 평가 칸에서 가장 강한 기준선이다. |
| IPCCF | 동종 2-hop 그래프, 관계 종류의 교차 전파, 의도 가중 전파와 관점 정렬을 결합한다. |
IPCCF는 이러한 선행 방법 위에 동종 2-hop 관계의 명시적 구성과 관계 종류의 교차 전파를 더한다. 논문 §II–III
2. 직접 관계와 2-hop 동종 관계
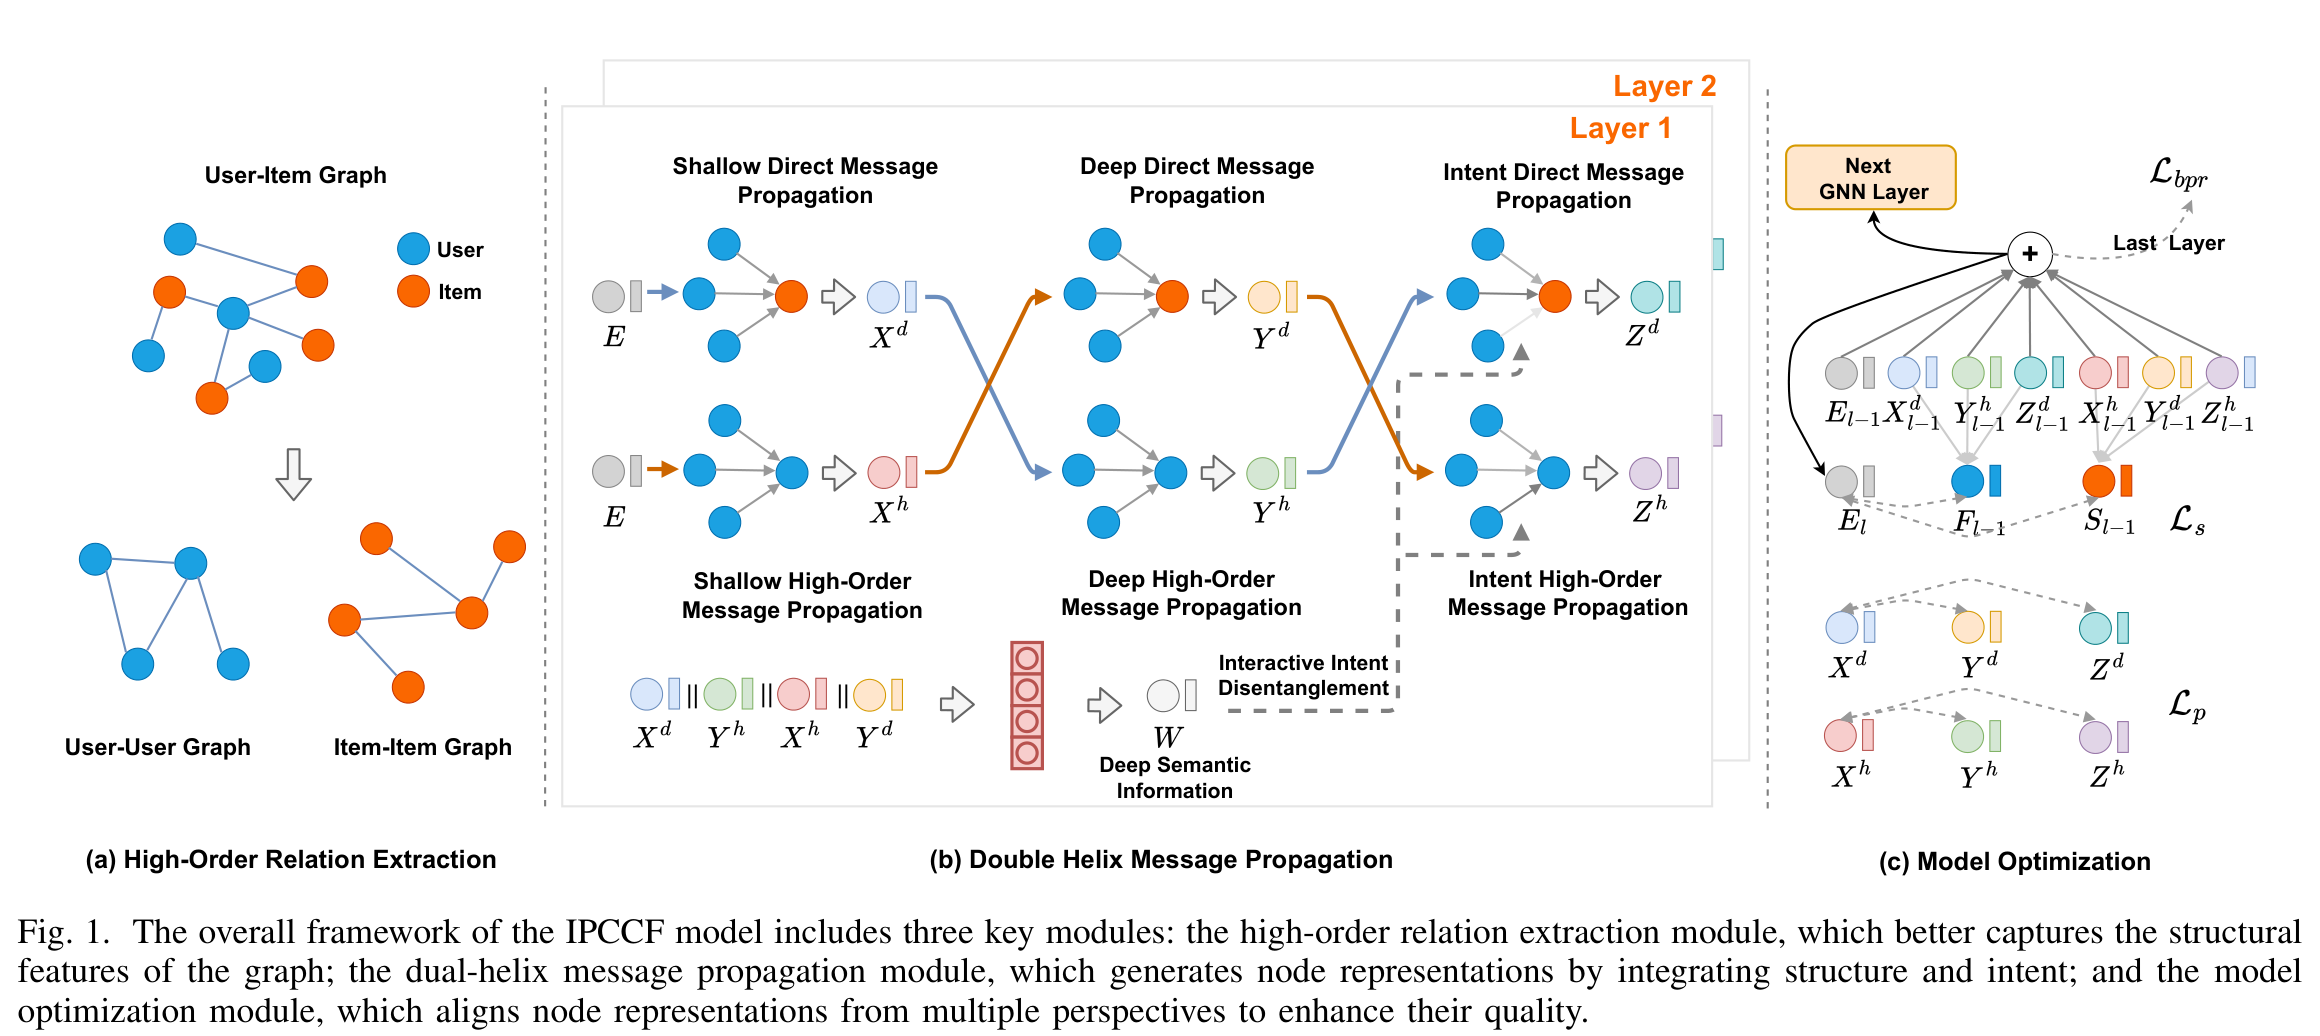
그림 1. IPCCF의 전체 구조. (a) 고차 관계 추출, (b) 이중 나선 메시지 전파, (c) 모델 최적화. Li et al. (2025), Figure 1, arXiv 공개본. CC BY-NC-ND 4.0, 원문 그림을 변경 없이 캡처·축소.
사용자–아이템 이분 그래프에서 두 번 이동하면 사용자–사용자 또는 아이템–아이템 관계를 얻는다. 논문은 이렇게 추출한 2-hop 관계를 high-order relation이라고 부른다. 이것이 모델 전체의 최대 도달 범위가 2-hop이라는 뜻은 아니다. 두 관계를 합성하고 여러 층을 쌓으면 더 먼 노드의 신호도 반영할 수 있다.
동종 노드 u,v의 이웃 집합을 N(u),N(v)라고 하면 Jaccard similarity는 다음과 같다.
\operatorname{sim}_{u,v}=\frac{|N(u)\cap N(v)|}{|N(u)\cup N(v)|}.논문의 추출 규칙은 이 유사도가 \eta 이상이거나, 노드 u에 대한 상위 Q개에 포함되는 관계를 남긴다. 따라서 Q를 “최대 이웃 수”라고 해석해서는 안 된다. 임계치를 넘는 관계가 더 많으면 Q개보다 많이 남을 수 있다. 기본 설정은 Q=5, \eta=0.8이다. 논문 §III-A, §IV-A
결과적으로 두 종류의 전파 행렬을 만든다.
| 행렬 | 연결 | 정규화 |
|---|---|---|
\bar{\mathcal A} |
사용자–아이템 직접 관계 | LightGCN식 대칭 정규화 |
\bar{\mathcal H} |
사용자–사용자 및 아이템–아이템 관계 | 행 정규화 |
동종 그래프는 원래 상호작용에서 유도한 구조다. 새로운 행동 정답이나 외부 의미 정보를 추가하는 것은 아니다. 따라서 “그래프 구조를 더 다양하게 활용한다”는 해석이 적절하다.
3. 이중 나선 메시지 전파
3.1 관계를 적용하는 순서가 다르다
한 층의 입력 표현을 \mathbf E라고 하자. 얕은 전파는 두 그래프에서 각각 한 번 집계한다.
\mathbf X^d=\bar{\mathcal A}\mathbf E,\qquad
\mathbf X^h=\bar{\mathcal H}\mathbf E.
깊은 전파는 다른 관계에서 얻은 출력을 입력으로 받는다.
\mathbf Y^d=\bar{\mathcal A}\mathbf X^h
=\bar{\mathcal A}\bar{\mathcal H}\mathbf E,\qquad
\mathbf Y^h=\bar{\mathcal H}\mathbf X^d
=\bar{\mathcal H}\bar{\mathcal A}\mathbf E.
오른쪽의 연산자 합성 표현은 논문의 전파 정의를 풀어 쓴 것이다. 일반적으로 두 행렬의 곱은 교환되지 않으므로, 두 경로가 같은 표현을 만들 필요는 없다.
| 사슬 | 얕은 전파 | 깊은 전파 | 의도 전파에 사용할 누적 입력 |
|---|---|---|---|
| 첫째 사슬 | Direct: \mathbf X^d |
High-order: \mathbf Y^h |
\mathbf F_{\mathrm{pre}}=\mathbf X^d+\mathbf Y^h |
| 둘째 사슬 | High-order: \mathbf X^h |
Direct: \mathbf Y^d |
\mathbf S_{\mathrm{pre}}=\mathbf X^h+\mathbf Y^d |
“이중 나선”은 이 교차 전파를 설명하는 이름이다. 구체적 연산을 이해할 때는 두 관계의 적용 순서와 사슬별 누적 표현을 보면 된다. 논문 §III-B, 식 (4)–(9)
3.2 의도 전파는 사슬의 누적 표현을 전달한다
의도 전파 함수 P는 가중치를 만들기 위한 표현 \mathbf W, 관계 그래프, 실제로 전달할 메시지 표현을 각각 받는다.
\mathbf Z^d=P(\mathbf W,\hat{\mathcal A},\mathbf F_{\mathrm{pre}}),\qquad
\mathbf Z^h=P(\mathbf W,\hat{\mathcal H},\mathbf S_{\mathrm{pre}}).
따라서 \mathbf W 자체를 그대로 전파하는 구조와는 구별해야 한다. \mathbf W는 간선 가중치 계산에 사용하고, 메시지는 사슬에서 누적한 표현이다. 의도 전파 후에는
\mathbf F=\mathbf X^d+\mathbf Y^h+\mathbf Z^d,\qquad
\mathbf S=\mathbf X^h+\mathbf Y^d+\mathbf Z^h
를 얻고, 다음 층의 입력을 잔차로 갱신한다.
\mathbf E_l=\mathbf E_{l-1}+\mathbf F_{l-1}+\mathbf S_{l-1}.여기서 \mathrm{pre}는 설명을 위해 추가한 표기다. 논문 식 (13)–(16)
4. 의도 메시지 전파
4.1 가중치를 만드는 표현
네 구조 표현을 이어 붙이고 완전연결 신경망을 적용한다.
\mathbf W=\operatorname{FCNN}([\mathbf X^d;\mathbf X^h;\mathbf Y^d;\mathbf Y^h]).이 완전연결 신경망은 직접·동종 관계에서 얻은 얕은 표현과 깊은 표현을 함께 받아, 의도 가중치를 계산할 공통 표현을 만든다. 논문 식 (13)
4.2 상호작용 강도와 의도별 가중치
논문은 cosine similarity로 간선 강도를 정의한다.
T_{u,v}=\frac{\cos(\mathbf w_u,\mathbf w_v)+1}{2},\qquad
\tilde R_{u,v}=T_{u,v}R_{u,v}.
이어 각 의도 벡터 \mathbf c^k와 상호작용 표현의 점수를 계산한다.
a^k_{u,v}=(\mathbf w_u\odot\mathbf w_v)^\top\mathbf c^k.논문 식 (11)은 의도별 점수를 전체 의도 점수의 합으로 나누고, 여기에 간선 강도를 곱한다.
\ddot R^k_{u,v}=\tilde R_{u,v}\frac{a^k_{u,v}}{\sum_o a^o_{u,v}}이 식에서 의도 벡터는 두 노드의 상호작용 표현과 얼마나 잘 맞는지를 가중한다. 다만 점수 합으로 나누는 비율이므로, 점수의 부호와 분모 조건을 추가로 가정하지 않으면 이를 비음수 확률로 해석할 수는 없다. 논문 식 (10)–(11)
4.3 의도별 이웃 정규화가 평균보다 먼저다
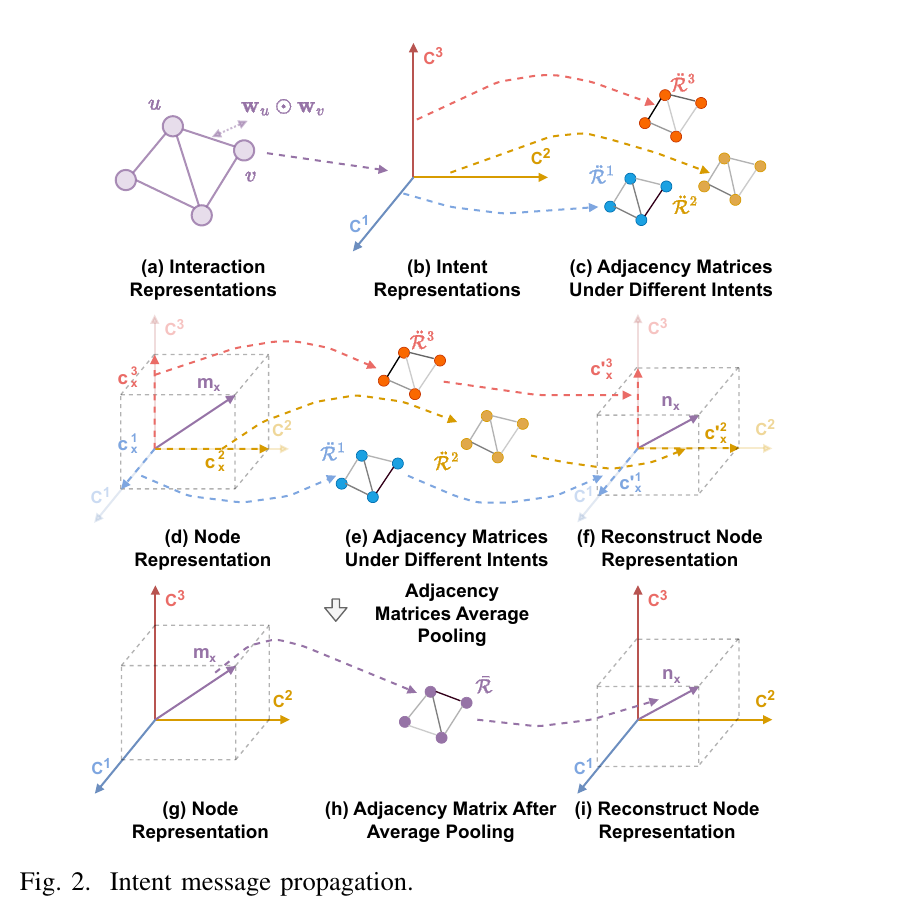
그림 2. 의도별 인접행렬과 메시지 전파. 의도별 정규화 행렬을 평균해 하나의 전파 행렬로 결합한다. Li et al. (2025), Figure 2, arXiv 공개본. CC BY-NC-ND 4.0, 원문 그림을 변경 없이 캡처·축소.
의도별 가중치를 만든 다음에는 각 의도 안에서 이웃 방향으로 정규화하고, 그 결과를 의도 축으로 평균한다. 논문 식 (12)에서 누락된 것으로 보이는 의도 첨자 k를 보충해 읽으면 다음과 같다.
B^k_{u,v}=\frac{\ddot R^k_{u,v}}
{\sum_{j\in N_R(u)}\ddot R^k_{u,j}},\qquad
\bar R_{u,v}=\frac1K\sum_{k=1}^K B^k_{u,v}.
위 식은 논문 식 (12)의 분자와 분모에 의도 첨자 k를 명시한 형태다. 실제 메시지 전파는
\mathbf N=\bar{\mathbf R}\mathbf M으로 수행한다. “의도 확률을 평균한다”는 설명만으로는 핵심이 빠진다. 간선마다 합이 1인 의도 확률을 먼저 평균하면 1/K가 되지만, 여기서는 의도별 이웃 정규화를 먼저 하므로 그와 같은 단순한 상쇄는 일반적으로 발생하지 않는다.
정규화한 뒤 평균하면 의도마다 각 노드의 이웃에 배분하는 가중치가 먼저 결정된다. 따라서 원래 의도 점수를 곧바로 평균하는 연산과는 다른 전파 행렬을 얻는다.
4.4 평균 전파의 의미와 한계
같은 메시지 행렬 \mathbf M에 의도별 행렬을 적용한 결과를 평균한다면 선형성에 의해
\left(\frac1K\sum_k\mathbf B^k\right)\mathbf M
=\frac1K\sum_k(\mathbf B^k\mathbf M)
이 성립한다. 이 등식 자체에는 의도 벡터의 직교성이 필요하지 않다. 다만 의도마다 서로 다른 부분공간에 투영한 메시지를 전파하고 재구성하는 더 일반적인 과정까지 이 등식 하나로 동치라고 결론낼 수는 없다.
논문은 의도 표현의 근사 직교성과 선형 전파를 간소화의 근거로 설명하지만, 의도별 투영·전파·재구성 전체가 평균 행렬 전파와 동치라는 엄밀한 보장으로 읽기는 어렵다. 그 두 구현을 직접 비교한 절제도 제시하지 않는다. 따라서 확인되는 기여는 의도별 가중치로 통합 전파 행렬을 구성하는 방법이며, 의도별 표현을 끝까지 분리해 유지한다는 뜻은 아니다. 논문 §III-B3, Figure 2의 설명
5. 추천·대조 목적함수와 설계 근거
5.1 최종 표현과 추천 손실
논문은 초기 임베딩부터 마지막 층까지 평균한다.
\mathbf E'=\frac1{L+1}\sum_{l=0}^L\mathbf E_l,\qquad
\hat y_{u,i}=\mathbf e'_u{}^\top\mathbf e'_i.
이 점수를 이용해 관측한 아이템이 샘플링한 미관측 아이템보다 높은 점수를 갖도록 BPR 목적함수를 최적화한다. 미관측 아이템은 학습상 음성 표본으로 취급하지만, 사용자가 실제로 싫어한다는 정답은 아니다. 논문 식 (17)–(18)
5.2 무엇과 무엇을 정렬하는가
대조 함수 \mathcal I는 같은 노드의 두 관점 표현을 가깝게 하고 다른 노드와 구별하도록 학습한다. 사슬 대조는 융합 표현을 기준으로 한다.
\mathcal L_s=\mathcal I(\mathbf E,\mathbf F)+\mathcal I(\mathbf E,\mathbf S).전파 과정 대조는 얕은 표현을 기준으로 깊은 표현과 의도 표현을 각각 정렬한다.
\mathcal L_p=
\mathcal I(\mathbf X^d,\mathbf Y^d)+\mathcal I(\mathbf X^d,\mathbf Z^d)
+\mathcal I(\mathbf X^h,\mathbf Y^h)+\mathcal I(\mathbf X^h,\mathbf Z^h).
즉 shallow·deep·intent의 모든 조합을 비교하는 것이 아니다. 또한 이 “직접 지도”는 분리 과정에 추가한 자기지도 목적함수를 가리킨다. 외부 의도 정답과의 일치나 인과적 구매 이유의 복원을 보장하지 않는다. 논문 식 (19)–(21)
5.3 독립 의도 제약과 공동 최적화
서로 다른 의도 벡터가 유사한 방향에 몰리지 않도록 논문은 의도 쌍의 유사도를 줄이는 항을 둔다.
\mathcal L_i=\frac{2}{K(K-1)}\sum_{i=1}^{K}\sum_{j=i+1}^{K}s(\mathbf c^i,\mathbf c^j).이 항은 의도 간 평균 유사도를 낮추는 역할을 한다. 다만 부호 있는 유사도의 평균을 최소화하는 것만으로 모든 의도 쌍의 직교성이나 통계적 독립성이 보장되는 것은 아니다.
전체 손실은 추천 순위를 학습하는 BPR, 두 종류의 대조 손실, 독립 의도 항, 임베딩 정규화를 함께 최적화한다.
\mathcal L=\mathcal L_{BPR}+\lambda_1\mathcal L_s+
\lambda_2\mathcal L_p+\lambda_3\mathcal L_i+
\lambda_4\|\Theta_1\|_F^2+\lambda_5\|\Theta_2\|_F^2.\Theta_1은 초기 노드 임베딩, \Theta_2는 의도 임베딩이다. BPR은 추천 점수에, 대조 손실은 관점 간 일관성에, 독립 의도 항은 의도 벡터 사이의 유사도에 각각 학습 신호를 준다. 논문 식 (22)–(23)
6. 평가 설계와 비교 조건
6.1 데이터와 평가 지표
| 데이터셋 | 사용자 | 아이템 | 상호작용 |
|---|---|---|---|
| Gowalla | 50,821 | 57,440 | 1,172,425 |
| Amazon-book | 78,578 | 77,801 | 2,240,156 |
| Tmall | 47,939 | 41,390 | 2,357,450 |
논문은 전체 아이템을 대상으로 순위를 평가하는 full-rank protocol을 사용하고, Precision·Recall·NDCG를 cutoff 20과 40에서 측정한다. 데이터셋 통계는 Table II에 따른다. 기준선은 14종이며, 그중 BIGCF가 주 결과표의 모든 평가 칸에서 가장 높은 기준선 점수를 기록한다. 논문 §IV-A, Tables II–III
6.2 학습 설정
| 항목 | 논문 설정 |
|---|---|
| 최적화 | Adam, 학습률 0.001 |
| 임베딩 차원 | d=32 |
| GNN 층 수 | L=2 |
| 잠재 의도 수 | K=8 |
| 고차 관계 필터 | Q=5, \eta=0.8 |
| 배치 크기 | 10,240 |
이 설정에서 IPCCF는 추천 손실과 대조 손실을 함께 학습한다. 하이퍼파라미터 실험에서는 층 수, 의도 수, 고차 관계 필터와 손실 가중치를 바꾸어 추천 성능의 변화를 비교한다. 논문 §IV-A4, §IV-B5
7. 결과와 절제
7.1 세 데이터셋의 추천 성능
논문 Table III에서 IPCCF는 세 데이터셋의 여섯 지표, 총 18개 평가 칸에서 모두 가장 높은 값을 보고한다. 아래는 @20 결과를 모아 비교한 것이다.
| 데이터셋 | P@20: BIGCF → IPCCF | R@20: BIGCF → IPCCF | NDCG@20: BIGCF → IPCCF |
|---|---|---|---|
| Gowalla | .0280 → .0297 | .2086 → .2178 | .1242 → .1310 |
| Amazon-book | .0338 → .0376 | .0989 → .1106 | .0761 → .0894 |
| Tmall | .0205 → .0216 | .0755 → .0803 | .0535 → .0579 |
@20/@40을 함께 집계한 저자 보고 평균 상대 개선은 Precision 6.37%, Recall 6.14%, NDCG 9.36%다. 예를 들어 Amazon-book NDCG@20은 절대값으로 .0133, 상대값으로 약 17.48% 높다. 상대 개선율과 지표의 절대 차이는 구별해야 한다. 논문 Table III
같은 데이터셋에서 여러 지표와 cutoff는 동일한 추천 순위에 기반하므로 서로 관련된다. 18개 칸이 같은 방향이라는 점은 보고 결과의 일관성을 보여 주지만, 독립적인 18회 재현을 의미하지 않는다. 또한 본문과 결과표에는 여러 시드의 평균·표준편차·신뢰구간·유의성 검정이 제시되지 않는다. 따라서 점수 차이의 반복 안정성까지 판단할 수는 없다.
7.2 큰 제거 효과와 독립적 기여를 구분하기
아래 표는 Table IV의 Recall@20으로 계산한 상대 하락률 (\mathrm{Full}-\mathrm{Variant})/\mathrm{Full}이다.
| 제거·변경 요소 | Gowalla | Amazon-book | Tmall |
|---|---|---|---|
의도 전파 w/o ip |
19.8% | 22.4% | 16.1% |
고차 관계 w/o ho |
11.6% | 16.7% | 15.2% |
사슬·전파 과정 대조 w/o spc |
9.2% | 9.8% | 12.7% |
교차 전파 w/o he |
4.6% | 5.7% | 5.7% |
깊은 전파 w/o dp |
4.2% | 5.1% | 5.3% |
전파 과정 대조 w/o pc |
2.6% | 6.9% | 9.6% |
얕은–깊은 정렬 w/o pcd |
1.9% | 4.0% | 6.0% |
얕은–의도 정렬 w/o pci |
1.1% | 1.8% | 1.9% |
사슬 대조 w/o sc |
1.4% | 0.9% | 0.6% |
의도 전파와 고차 관계를 제거했을 때 가장 큰 하락이 나타난다. 두 변형 각각의 Recall@20·NDCG@20 여섯 칸은 모두 BIGCF보다 낮다. 이 관측은 전체 모델 안에서 해당 모듈이 중요하다는 해석을 지지한다. 논문 Table IV
그러나 w/o ip는 의도 가중치 생성과 메시지 전달을 포함한 모듈을 제거하고, w/o ho는 관련 구조 경로를 함께 바꾼다. 이 표만으로 “동종 2-hop 구조 위의 의도 분리 자체가 개선의 독립적인 원인”이라고 분리할 수는 없다. 다른 구성요소를 고정했을 때의 제거 효과이며, 모듈 사이 상호작용도 포함된다.
개별 대조 항의 효과도 묶어서 작다고 표현하기 어렵다. 사슬 대조 제거의 하락은 작지만, 전파 과정 대조 제거는 Tmall Recall@20에서 약 9.6%에 이른다. 또한 w/o spc는 \mathcal L_s와 \mathcal L_p를 제거한 변형으로, 독립 의도 항 \mathcal L_i까지 모두 제거했다고 해석해서는 안 된다. \mathcal L_i를 0으로 끈 별도 절제와 평균 전파를 의도별 전파와 직접 비교하는 절제는 제시되지 않는다.
7.3 희소도와 의도 수
Figure 3의 희소도 분석은 Gowalla에서 상호작용 수에 따라 사용자와 아이템을 나눈 결과다. 저자는 희소한 집단을 포함해 높은 Recall@20을 보고한다. 이는 해당 데이터의 집단별 분석이며, 상호작용 이력이 전혀 없는 신규 사용자·아이템에 대한 cold-start 성능을 평가한 것은 아니다.
Figure 4는 K\in{4,8,16,32}에서 성능 변화가 비교적 작고 K=8에서 가장 좋은 결과를 얻었다고 보고한다. 이 결과는 시험한 범위의 민감도에 관한 근거다. 그 원인이 평균 풀링인지, 다른 학습 장치인지 분리하는 실험은 없으므로 특정 원인을 확정할 수 없다. 논문 §IV-B3
7.4 과다평활과 노드 표현의 거리
MAD는 노드 표현 사이의 평균 거리를 요약한다. 논문은 정규화한 임베딩에서 이를 계산하며, 값이 클수록 표현이 덜 비슷해진 것으로 해석한다.
| 데이터셋·노드 | 가장 높은 기준선 MAD | IPCCF | 표시된 정밀도에서의 비교 |
|---|---|---|---|
| Amazon-book 사용자 | .999 | .999 | 공동 최고 |
| Amazon-book 아이템 | .994 | .996 | 단독 최고 |
| Tmall 사용자 | .999 | .986 | 최고보다 낮음 |
| Tmall 아이템 | .998 | .995 | 최고보다 낮음 |
Table V는 IPCCF의 표현이 일부 비교 조건에서 덜 평활함을 보여 주지만 모든 조건의 우월성을 보여 주지는 않는다. MAD가 크다는 사실만으로 의도가 정확히 분리됐다고 판단할 수도 없다. 또한 이 표는 Gowalla를 포함하지 않고, 층 수 증가에 따른 MAD 변화 자체를 비교하는 실험도 아니다. 논문 Table V
7.5 비용: 에폭 시간과 목표 성능 도달 시간
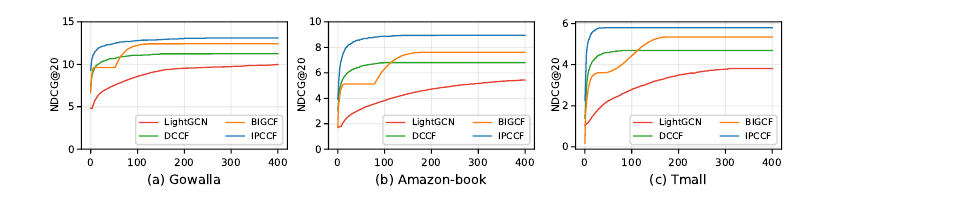
그림 3. 학습 에폭에 따른 NDCG@20의 변화. Li et al. (2025), Figure 5, arXiv 공개본. CC BY-NC-ND 4.0, 원문 그림을 변경 없이 캡처·축소.
| 데이터셋 | BIGCF / IPCCF 에폭 시간 | BIGCF 최고 NDCG@20 도달까지의 시간 비율 |
|---|---|---|
| Gowalla | 12.0초 / 16.5초 | 49.68% |
| Amazon-book | 12.8초 / 20.1초 | 14.67% |
| Tmall | 12.7초 / 19.2초 | 11.52% |
저자 보고에서 IPCCF의 에폭당 비용은 BIGCF보다 약 37.5–57.0% 높지만, BIGCF의 최고 NDCG@20에 도달하기까지의 시간은 더 짧다. 세 비율의 산술평균이 25.29%다. 이 평균은 데이터셋별 절대 시간을 합산한 전체 시간 비율도, IPCCF 자체의 최종 최고점까지 학습하는 시간의 비율도 아니다. 논문 Tables VI–VII
이 결과의 핵심은 에폭당 연산이 가벼워졌다는 데 있지 않다. 한 에폭의 비용은 더 크지만, 비교 모델의 최고 성능에 도달하는 데 필요한 에폭 수가 줄어 전체 도달 시간이 짧아졌다는 것이다. 비용 비교는 이 목표 성능과 실험 환경에 한정되며, 동종 그래프를 구축하거나 갱신하는 비용까지 포함한 서비스 전체 비용을 뜻하지 않는다.
8. 논문의 기여와 한계
8.1 확인되는 성과
논문이 직접 보고하는 것은 정해진 세 데이터셋과 평가 절차에서 비교 모델보다 높은 추천 점수다. 의도 전파와 동종 고차 관계를 제거하면 성능이 크게 낮아지는 절제는 두 모듈의 중요성을 뒷받침한다. 서로 다른 그래프 구조를 결합하고 학습한 간선 가중치로 전파하는 설계는 이 근거에 맞춰 평가할 수 있다.
반면 학습된 각 의도가 가격·장르 같은 인간의 의미 단위를 정확히 복원했다는 주장에는 별도의 검증이 필요하다. 추천 지표, MAD, 사례 분석은 서로 다른 관측이며, 의도 정답과의 일치를 직접 평가하는 지표를 대신하지 않는다.
8.2 실험이 다루지 않은 범위
논문의 평가에는 몇 가지 경계가 있다. 희소도 분석은 Gowalla의 상호작용 수별 집단을 대상으로 하고, MAD 비교는 Amazon-book과 Tmall을 대상으로 한다. 따라서 각 분석이 모든 데이터셋과 신규 사용자·아이템에 동일하게 적용된다고 볼 수는 없다.
또한 의도 전파와 고차 관계의 제거 효과는 전체 모듈의 중요성을 보여 주지만, 그 안에 포함된 세부 장치의 효과를 따로 분리하지는 않는다. 의도별 투영·전파와 평균 행렬 전파를 직접 비교한 실험, 독립 의도 제약을 완전히 제거한 절제, 여러 시드의 변동성은 제시되지 않는다. 추천 성능 향상을 잠재 의도의 의미적 정확성으로 연결하려면 의도 자체를 평가하는 근거도 필요하다.
9. 결론
IPCCF는 직접 사용자–아이템 관계와 동종 2-hop 관계를 교차 전파하고, 잠재 의도에 따라 간선 가중치를 조정하는 그래프 추천 모델이다. 의도별로 정규화한 전파 행렬을 평균해 메시지를 전달하고, 서로 다른 전파 과정에서 얻은 표현을 대조학습으로 정렬한다.
세 데이터셋의 추천 성능과 구성요소 절제는 구조를 확장한 의도 전파의 유용성을 뒷받침한다. 특히 의도 전파와 고차 관계가 전체 모델에서 중요한 역할을 한다. 다만 추천 점수가 높아졌다는 사실과 학습된 의도가 실제 행동 이유를 정확히 복원했다는 주장은 구분해야 한다. IPCCF의 기여는 다양한 그래프 관계를 의도 가중 전파에 결합해 추천 표현을 개선한 데 있다.
References
Li, H., Du, J., Liu, G., Jiang, F., Wang, Y., & Zhou, X. (2025). Intent propagation contrastive collaborative filtering. IEEE Transactions on Knowledge and Data Engineering, 37(5), 2665–2679. https://doi.org/10.1109/TKDE.2025.3543241
Li, H., Du, J., Liu, G., Jiang, F., Wang, Y., & Zhou, X. (2026). Intent propagation contrastive collaborative filtering (arXiv:2604.15704v1) [arXiv 공개본]. arXiv. https://arxiv.org/abs/2604.15704v1
Wang, X., Jin, H., Zhang, A., He, X., Xu, T., & Chua, T.-S. (2020). Disentangled graph collaborative filtering (arXiv:2007.01764). arXiv. https://arxiv.org/abs/2007.01764
Ren, X., Xia, L., Zhao, J., Yin, D., & Huang, C. (2023). Disentangled contrastive collaborative filtering (arXiv:2305.02759). arXiv. https://arxiv.org/abs/2305.02759
Zhang, Y., Sang, L., & Zhang, Y. (2024). Exploring the individuality and collectivity of intents behind interactions for graph collaborative filtering (arXiv:2405.09042). arXiv. https://arxiv.org/abs/2405.09042