Residual Dominance as a Structural Account of Last-Item Reliance in Causal Self-Attention Recommenders
마지막 위치를 읽는 추천 모델: Residual Dominance
SASRec의 마지막 위치 readout과 residual 경로가 최근 아이템 의존을 어떻게 표현하는지 살펴봅니다. 아홉 데이터셋의 norm 분해, 순위 진단, 고정 가중치 residual scaling, 조건부 회복과 validation 제약을 구분합니다.
Paper: Keito Kozaki; Keigo Sakurai; Ren Togo; Takahiro Ogawa; Miki Haseyama (2026). "Residual Dominance as a Structural Account of Last-Item Reliance in Causal Self-Attention Recommenders". Hokkaido University. arXiv:2608.14021v1 PDF · arXiv 서지 정보 · 출판 DOI. 2026년 8월 14일 공개된 10쪽 v1 PDF를 기준으로 한다. 논문은 Proceedings of the 20th ACM Conference on Recommender Systems (RecSys ’26), pp. 457–466에 수록되었다.
순차 추천 모델은 사용자의 과거 상호작용을 시간순으로 받아 다음 아이템을 예측한다. 이 논문은 학습이 끝난 뒤 입력의 마지막 아이템이 예측 표현에서 어떤 구조적 경로로 두드러지는지 분석한다. 결론의 중심은 attention만 보는 대신 residual 연결까지 포함해 표현을 분해하고, 추론 때 residual 강도를 바꾸어 순위와 표현 혼합이 어떻게 함께 달라지는지 관찰한다는 데 있다.
핵심 요약
| 항목 | 논문이 다루는 내용 |
|---|---|
| 질문 | causal self-attention 추천에서 마지막 입력 아이템의 높은 순위 의존이 예측 표현에 어떻게 나타나는가? |
| 구조 분석 | Attention 출력, 같은 위치 입력을 더하는 residual, layer normalization을 포함해 위치별 norm 기여를 계산한다. |
| 진단 결과 | Attention 출력만으로 계산한 contextual mixing은 높고, residual을 더한 뒤에는 낮아진다. 이 경향은 여러 위치에서 관찰된다. |
| 개입 | 학습 가중치를 고정하고 모든 위치와 attention 층의 residual 성분에 같은 α를 곱한다. α가 작아지면 mixing은 증가하고 HRLI와 전체 HR/NDCG는 감소한다. |
| 조건부 결과 | 표준 조건에서 마지막 위치가 놓친 최종 test target을 앞선 위치가 이미 맞힌 일부 사례는 작은 α에서 회복된다. |
| 범위 | Residual scaling은 추론 시 민감도 진단이며, 새 추천 기법이나 strict causal identification은 아니다. 저자들은 last-item reliance의 유일한 원인으로 residual dominance를 제시하지 않는다. |
목차
- 마지막 아이템 의존과 SASRec의 readout
- 데이터와 평가 지표
- 순서 교란과 마지막 아이템 순위
- Residual을 포함한 norm 분해
- 고정 가중치 residual scaling
- 앞선 위치의 hit와 조건부 회복
- Validation 선택과 저자가 밝힌 한계
1. 마지막 아이템 의존과 SASRec의 readout
SASRec은 causal self-attention을 사용해 아이템 이력의 각 위치를 처리하고, 다음 아이템 예측에 마지막 위치의 표현을 사용한다. 여기서 causal attention은 mask로 미래 위치를 가린다는 뜻이며, 인과 추론을 수행한다는 뜻은 아니다. 위치 i의 attention은 그 위치까지의 prefix만 참조한다.
각 attention sublayer에는 입력 표현을 attention 출력에 더하는 residual connection이 있다. 입력 표현을 xᵢ, attention 출력을 Attn(x)ᵢ라 하면 residual이 포함된 값은 xᵢ + Attn(x)ᵢ다. 뒤이어 layer normalization을 적용한다. 모델의 readout은 이 처리 뒤 마지막 위치 L의 표현을 받아 전체 아이템의 점수를 산출하는 예측 인터페이스다. 따라서 마지막 위치의 자기 상태를 보존하는 경로와 마지막 위치만 읽는 readout이 함께 작동한다.
이 구조적 경향을 논문은 residual dominance라고 부른다. 이는 residual이 추가된 attention block의 위치별 표현에서 같은 위치 성분의 상대적 norm이 커지는 현상이다. 저자들의 주장은 residual dominance가 최근 아이템 의존의 유일한 원인이라는 것이 아니라, 이미 학습된 last-item reliance가 추론 표현에서 나타나는 한 구조적 설명이라는 것이다.
2. 데이터와 평가 지표
실험 데이터는 Beauty, Sports, Video, Diginetica, Toys, Steam, BeerAdvocate, ML-1M, Zvuk의 아홉 가지다. 전처리는 5-core filter와 연속 반복 아이템 제거를 사용한다. 학습·validation 자료를 합쳐 전체의 90%로 두고 나머지를 test로 분리하는 Global Time Split(GTS), GTS-Last target 전략과 GT 기반 validation 분할을 적용한다.
표준 순위 평가는 test에서 full-catalog ranking으로 수행한다. 실제 다음 아이템을 정답으로 하며 HR@10은 정답이 상위 10개에 들었는지, NDCG@10은 순위에 따라 할인된 정답의 기여를 측정한다. 일반적으로 이전에 상호작용한 아이템을 추천 목록에서 제외하는 filter-seen을 쓰지만, 논문은 반복 소비가 데이터 특성인 Diginetica와 Zvuk에서는 이 필터를 적용하지 않는다.
HRLI@K는 실제 다음 정답이 아니라 입력의 마지막 아이템 vₜ가 예측된 Top-K 목록에 다시 들어가는 비율이다. HRLI@1은 그 아이템이 1위인지 센다. HRL2I@K는 끝에서 두 번째 입력 아이템 vₜ₋₁에 같은 검사를 한다. 두 진단 지표는 모든 데이터셋에서 filter-seen 없이 계산한다. 이 아이템들을 제거하면 순위에 다시 등장하는지 측정할 수 없기 때문이다. 그러므로 HRLI는 마지막 입력 아이템의 재등장 순위를 나타내며, 실제 다음 아이템의 적중률이나 마지막 아이템 제거에 대한 반사실적 효과가 아니다.
3. 순서 교란과 마지막 아이템 순위
논문은 표준 입력과 두 가지 순서 교란을 비교한다. Partial shuffle은 마지막 아이템을 마지막 위치에 고정하고 그 앞의 아이템만 섞는다. 앞선 입력을 삭제하지 않는다. Full shuffle은 마지막 위치까지 포함해 전체 아이템 순서를 섞는다. 두 조건 모두 아이템의 구성은 유지한다.
Figure 1에서 희소 데이터는 partial shuffle보다 full shuffle에서 성능 하락이 더 컸다. ML-1M 같은 조밀 데이터에서는 partial shuffle도 성능을 낮추지만 full shuffle의 변화가 더 컸다. 논문이 순차 신호가 약하다고 다룬 Steam과 Diginetica에서는 shuffle 대비가 작았다. 이 비교에서 partial과 full의 차이는 마지막 아이템 위치를 보존하는 조건의 결과이지, 과거 아이템이 제거된 조건의 결과가 아니다.
순위 진단에서도 causal self-attention 모델은 일반적으로 HRLI@1이 HRL2I@1보다 높았다. 이는 마지막과 그 바로 앞 입력 위치 사이의 순위 재등장을 비교한다. HRLI의 계산 대상은 실제 다음 정답이 아니라 입력에 이미 있는 위치별 아이템이며, 평가 때 모든 데이터를 filter-seen 없이 처리한다.
4. Residual을 포함한 norm 분해
Attention weight만으로는 value 변환의 크기, residual 합산과 normalization 이후 각 위치의 벡터 기여를 알 수 없다. 논문은 다음 attention block 출력을 위치별 성분으로 분해한다.
\tilde{x}_i = \operatorname{LN}(\operatorname{Attn}(x_i, X) + x_i).보충문서가 설명하는 head 합산 attention contribution을 a_{i,j}라 두면, residual을 더한 뒤의 위치별 성분과 합은 다음과 같다.
y_{i,j}=a_{i,j}+\mathbf{1}[j=i]x_i,\qquad y_i=\sum_j y_{i,j}.Layer normalization의 평균은 성분별 합으로 분배할 수 있고, 분모의 표준편차 s(y_i)는 전체 y_i에서 계산한 공통 스칼라다.
g_{y_i}(y_{i,j})=
\frac{y_{i,j}-m(y_{i,j})\mathbf{1}}{s(y_i)}\odot\gamma,
\operatorname{LN}(y_i)=\sum_j g_{y_i}(y_{i,j})+\beta.β는 이 성분 합 밖의 별도 bias이며, mixing ratio 계산에서도 제외한다. 이 식은 전체 합의 공통 분모를 사용하는 분해이며, \operatorname{LN}(a+b)=\operatorname{LN}(a)+\operatorname{LN}(b)라는 뜻은 아니다.
본문의 p.5 mixing ratio 식은 위치 i 이외의 성분별 norm을 더해 전체 성분별 norm 합으로 나눈다.
r_i^{\mathrm{sum}}=
\frac{\sum_{j\ne i}\|F_i(x_j)\|}{\sum_j\|F_i(x_j)\|}.
반면 저자 보충문서의 Eq. 22는 context 성분을 벡터로 먼저 합한 뒤 그 합의 norm을 계산한다.
r_i^{\mathrm{agg}}=
\frac{\left\|\sum_{j\ne i}g_{y_i}(y_{i,j})\right\|}
{\left\|\sum_{j\ne i}g_{y_i}(y_{i,j})\right\|+\|g_{y_i}(y_{i,i})\|}.
앞 식은 개별 norm의 합이고 뒤 식은 벡터 합의 norm이므로, context 성분끼리 상쇄될 때 두 값은 달라질 수 있다. 저자들은 고정 revision의 공개 코드 저장소와 같은 revision의 보충문서 PDF를 제공한다.
Table 2의 Attn은 attention 출력만, +Res는 residual 추가 뒤, +LN은 layer normalization 뒤의 mixing ratio다. 값은 위치, 층, test sequence에 걸친 평균이다.
| Dataset | SASRec Attn | SASRec +Res | SASRec +LN | DuoRec Attn | DuoRec +Res | DuoRec +LN |
|---|---|---|---|---|---|---|
| Beauty | 0.776 | 0.119 | 0.119 | 0.776 | 0.116 | 0.115 |
| Sports | 0.775 | 0.126 | 0.122 | 0.790 | 0.119 | 0.119 |
| Toys | 0.772 | 0.123 | 0.123 | 0.780 | 0.121 | 0.121 |
| Video | 0.798 | 0.169 | 0.169 | 0.773 | 0.170 | 0.170 |
| Diginetica | 0.721 | 0.150 | 0.149 | 0.724 | 0.152 | 0.151 |
| ML-1M | 0.856 | 0.395 | 0.386 | 0.862 | 0.367 | 0.359 |
| Steam | 0.794 | 0.317 | 0.276 | 0.767 | 0.299 | 0.277 |
| BeerAdvocate | 0.959 | 0.301 | 0.287 | 0.949 | 0.311 | 0.307 |
| Zvuk | 0.941 | 0.267 | 0.265 | 0.926 | 0.274 | 0.271 |
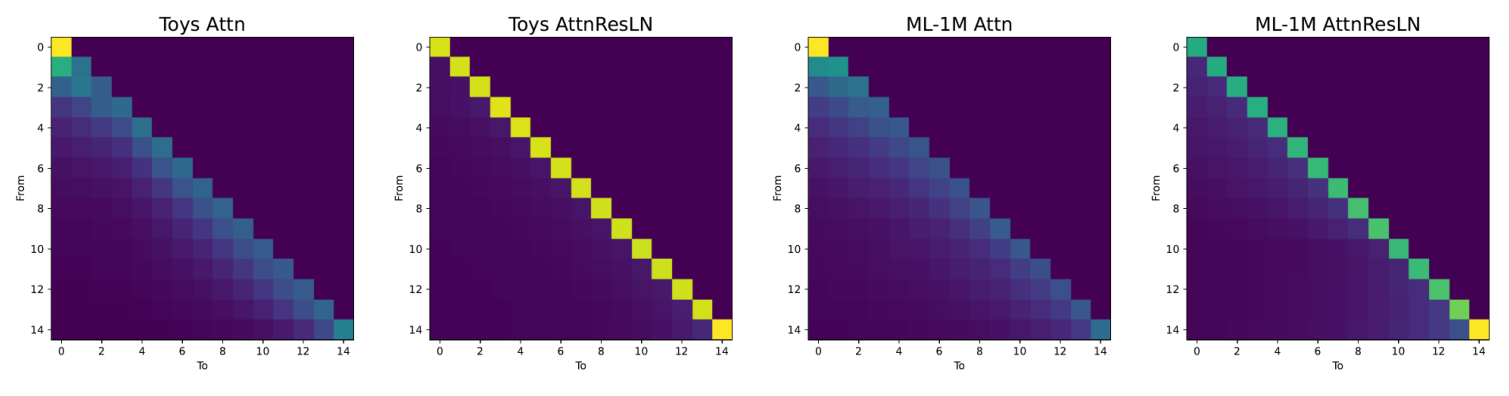
Figure 3. Kozaki et al. (2026), arXiv v1 PDF p.6. Toys와 ML-1M의 attention-only 기여와 residual 및 layer normalization 뒤의 기여를 비교한다. 후자의 heatmap은 같은 위치 성분이 더 두드러지는 모습을 보인다.
논문 Table 3은 위치와 층별 값도 보고한다. 아래 값은 각 데이터셋의 두 SASRec 층에서 L, L−1, L−2 위치의 mixing ratio다.
| Dataset | Layer | L | L−1 | L−2 |
|---|---|---|---|---|
| Toys | 1 | 0.1278 | 0.1283 | 0.1251 |
| Toys | 2 | 0.1182 | 0.1178 | 0.1135 |
| ML-1M | 1 | 0.3984 | 0.3819 | 0.3798 |
| ML-1M | 2 | 0.3660 | 0.3617 | 0.3606 |
이 값은 마지막 위치가 앞선 위치보다 항상 낮은 mixing을 갖는 형태가 아님을 보여 준다. 논문은 residual dominance가 특정 위치만의 현상이라기보다 측정한 여러 위치와 층에서 나타나는 자기 상태 보존 경향이라고 설명한다. 깊은 층의 xᵢ에는 앞선 층에서 처리된 정보도 포함되므로 같은 위치 성분을 원래 아이템 하나와 동일시하지 않는다.
5. 고정 가중치 residual scaling
SASRec block에서 논문은 residual 항을 α배 하는 추론 개입을 적용한다. hᵢ⁽ᵅ⁾ = αxᵢ + Attn(x)ᵢ다. 학습된 가중치는 고정하며 재학습하지 않는다. scaling은 모든 sequence 위치와 attention layer의 residual branch에 적용된다(고정 revision의 공개 models.py). FFN residual을 α배 하는 개입은 아니다. α=0이면 이 attention-block 합산식에서 residual 항이 빠지지만, 마지막 아이템은 입력으로 남아 query/key/value를 만드는 attention 경로에 참여할 수 있다.
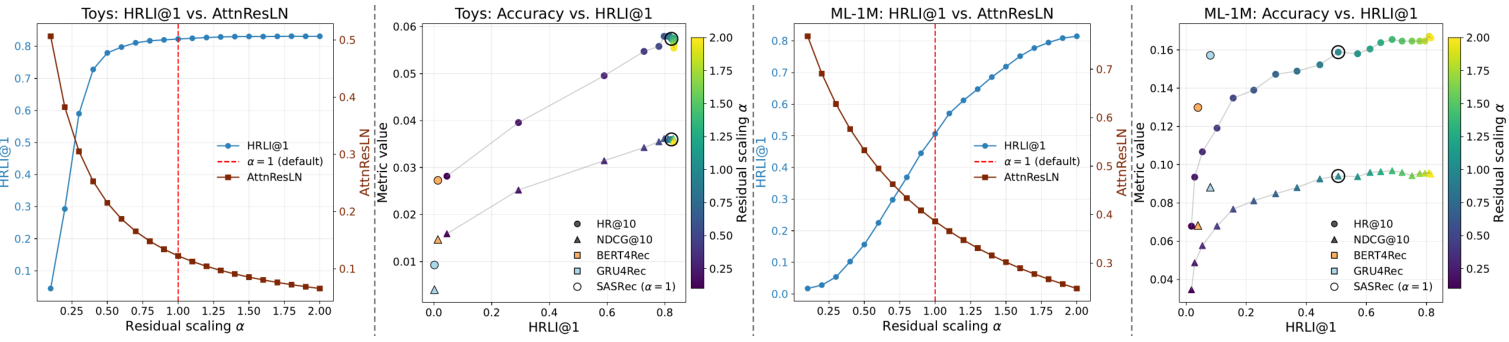
Figure 4. Kozaki et al. (2026), arXiv v1 PDF p.7. 모든 위치의 attention residual에 α를 적용했을 때, α 감소에 따라 AttnResLN mixing ratio는 증가하고 HRLI@1, HR@10, NDCG@10은 감소하는 결과를 그린다.
논문은 α를 낮추면 residual의 자기 위치 보존이 약해지고 contextual mixing이 증가하는 한편, HRLI@1과 표준 추천 성능도 함께 낮아지는 곡선을 보고한다. 따라서 구조적 mixing의 증가와 전체 추천 정확도의 증가는 같은 방향의 결과가 아니다. 저자들은 이 개입을 예측 시 표현과 순위의 민감도 진단으로 설명하며, 엄밀한 인과 식별이나 새 추천 방법으로 제안하지 않는다.
6. 앞선 위치의 hit와 조건부 회복
Table 4의 non-final hit는 위치별 학습 정답이 아니라 모든 위치가 같은 최종 test target vₜ₊₁을 상위 10위에 넣는지 검사한다. 첫 행의 HR@10은 표준 추론에서 마지막 위치 L이 정답을 맞힌 비율이다. 다음 세 행은 L에서 miss하고 L−1, L−2, L−3 표현 중 해당 위치가 최종 정답을 맞힌 경우의 비율이다. 각 값의 분모는 final miss subset이 아니라 전체 test sequence다.
| Dataset | HR@10 at L | L−1 hit & L miss | L−2 hit & L miss | L−3 hit & L miss |
|---|---|---|---|---|
| Beauty | 0.0381 | 0.0116 | 0.0124 | 0.0112 |
| Sports | 0.0342 | 0.0157 | 0.0125 | 0.0115 |
| Toys | 0.0574 | 0.0185 | 0.0134 | 0.0150 |
| Video | 0.0403 | 0.0171 | 0.0145 | 0.0124 |
| Diginetica | 0.2900 | 0.1153 | 0.0782 | 0.0914 |
| ML-1M | 0.1588 | 0.0347 | 0.0422 | 0.0298 |
| Steam | 0.0639 | 0.0235 | 0.0241 | 0.0236 |
| BeerAdvocate | 0.0389 | 0.0150 | 0.0141 | 0.0139 |
| Zvuk | 0.2416 | 0.0583 | 0.0415 | 0.0431 |
각 데이터에서 세 비율 중 가장 큰 단일 위치의 비율은 표준 HR@10 값의 약 24–46%에 해당한다. 이것은 전체 test sequence를 분모로 한 각 공동 사건을 baseline HR@10과 비교한 비율이다. 오답 subset의 24–46%를 회복했다는 의미는 아니다.
저자들은 residual scaling 회복 곡선을 이 조건에 맞춘 고정 부분집합에서 계산한다. S = {표준 α=1에서 L 위치는 miss하고, L−1·L−2·L−3 중 적어도 하나는 같은 최종 target을 hit}로 두고, 각 α에서 q(α) = P(L 위치가 최종 target을 hit | S)를 측정한다. S는 α=1에서 정의한 채 고정한다. 그러므로 α=1에서 회복률은 정의상 0이며, 저자들은 α≈0.1–0.3에서 이 subset의 회복이 가장 큰 결과를 보고한다.
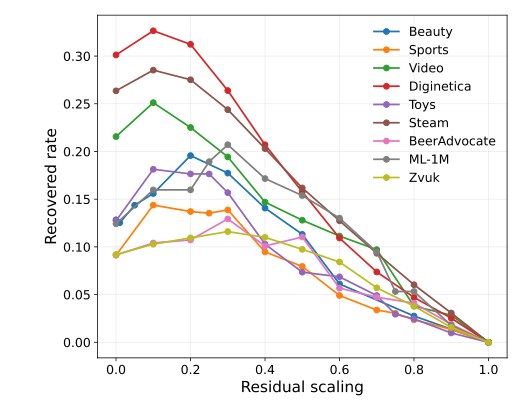
Figure 5. Kozaki et al. (2026), arXiv v1 PDF p.8. α=1에서 마지막 위치가 miss하고 L−1, L−2, L−3 중 하나 이상이 맞힌 고정 subset을 분모로 한다. 모든 위치가 같은 최종 test target을 평가하며, α=1의 회복률은 0이다.
이 조건부 회복과 전체 HR/NDCG는 서로 다른 양을 잰다. α를 바꾸면 subset 안에서 새로 맞히는 사례가 생기더라도, 표준 조건에서 맞혔던 다른 사례가 miss로 바뀔 수 있다. 논문에서 α 감소에 따라 전체 HR@10과 NDCG@10은 하락하는 한편, 조건부 subset의 회복은 증가한다.
7. Validation 선택과 저자가 밝힌 한계
논문은 test label을 쓰지 않고 validation에서 global α를 고르는 규칙을 정의한다.
\alpha^*=\arg\max_\alpha\operatorname{Recovery}_{\mathrm{val}}(\alpha)\text{subject to }\quad
\operatorname{HR@10}_{\mathrm{val}}(\alpha)
\ge(1-\epsilon)\operatorname{HR@10}_{\mathrm{val}}(1).ε는 baseline HR@10 대비 허용하는 상대 감소율이다. 이는 HR 점수에서 percentage point를 빼는 제약이 아니다. 목적은 HR 손실 한도 안에서 조건부 recovery를 크게 하는 것이다.
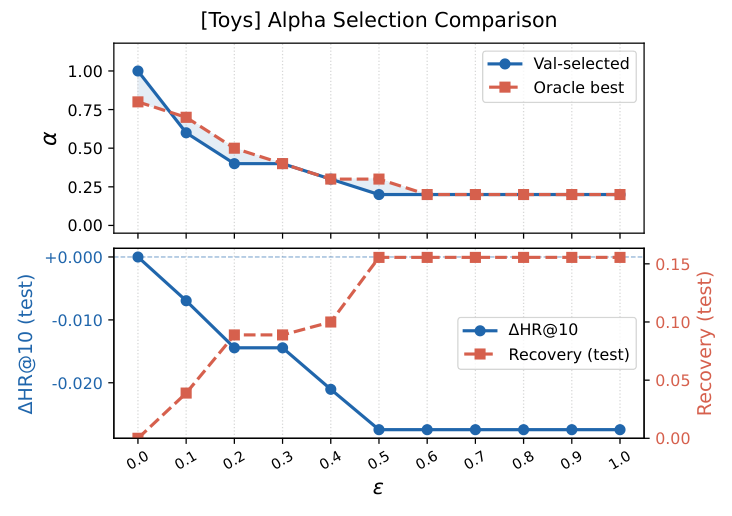
Figure 6. Kozaki et al. (2026), arXiv v1 PDF p.8. Toys에서 ε에 따른 validation-selected α와 oracle-selected α를 위에, 선택된 조건의 test HR 변화와 recovery를 아래에 나타낸다.
저자들은 residual dominance가 last-item reliance의 유일한 원인이 아니라고 명시한다. Causal masking, positional information, 예측 readout, 학습 목적, 데이터 특성과 optimization도 영향을 줄 수 있다. 분석과 개입은 마지막 위치 표현으로 예측하는 causal self-attention 모델에 한정되며, 다른 prediction head와 학습 목적에 대한 확장은 향후 과제다. HRLI와 실제 온라인 효용의 관계도 확립되지 않았다고 한계를 둔다.
참고문헌
Kozaki, K., Sakurai, K., Togo, R., Ogawa, T., & Haseyama, M. (2026). Residual dominance as a structural account of last-item reliance in causal self-attention recommenders. In Proceedings of the 20th ACM Conference on Recommender Systems (pp. 457–466). Association for Computing Machinery. https://doi.org/10.1145/3773078.3831798