Self-Organizing Agent Teams Learn to Reason Together
고정된 세 모델이 과거 협업 기록에서 역할·대화 단계·검토 절차를 학습한다. 정답을 만들어 내는 능력과 골라내는 능력을 구분하고, 라우팅 오라클·계산 예산 대조·demonstrability 상관의 의미를 분석한다.
Paper: Aneesh Pappu; Mirac Suzgun; Yongchan Kwon; Federico Bianchi; Batu El; Mykel J. Kochenderfer; Hancheng Cao; James Zou (2026). "Self-Organizing Agent Teams Learn to Reason Together". arXiv:2609.22682v1. PDF · 서지 정보. 30쪽의 v1을 기준으로 읽는다.
Abstract: 모델 여러 개의 답을 모으는 것과 서로의 불완전한 풀이를 고쳐 정답을 만드는 것은 다르다. Self-Organizing Agent Teams(SAT)는 고정된 팀의 과거 대화를 검토해 역할·대화 단계·정보 전달·종합 절차를 재사용 가능한 텍스트 전략으로 학습하며 모델 가중치는 바꾸지 않는다. 서로 독립적으로 학습한 두 전략 묶음을 동결한 뒤 새 문제마다 각 묶음의 열 전략을 모두 실행하고 한 구성원이 후보 풀이 전체를 감사해 답을 고른다. 수학·물리 다섯 벤치마크의 동일 가중 평균 정확도는 66.7%로, 관측한 독립 답의 완벽 선택 범위인 59.0%와 단일 모델로 전략을 수행한 58.7%보다 높다. 지식·논리에서는 정답 후보가 존재하는 비율이 평균 87.9%인데 최종 정확도는 72.8%여서 생성과 선택의 간격이 크다. 여덟 벤치마크에서 관찰한 demonstrability와 성능 이득의 상관은 이 간격을 이해할 단서지만 검증하기 쉬운 설명이 성능을 높인다는 인과적 보장은 아니다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 질문 | 구성원을 바꾸지 않고 협업 절차를 학습하면 불완전한 풀이를 더 잘 고칠 수 있는가? |
| 학습 대상 | 역할·단계·참여자·정보 전달·종합 규칙을 담은 텍스트 전략. 가중치 학습이 아니다. |
| 학습과 배포 | AIME 15문제와 GPQA 25문제로 각각 별도 bank를 학습한다. 배포에서는 동결한 열 전략을 전부 실행한 뒤 한 judge가 고른다. |
| 수학·물리 | 평균 정확도 SAT 66.7%, best member 48.8%, linearization 58.7%, 독립 답 routing-oracle coverage 59.0%. |
| 지식·논리 | 평균 정확도 SAT 72.8%, linearization 72.1%. SAT coverage 87.9%를 최종 정답으로 충분히 전환하지 못한다. |
| 오라클의 범위 | 관측한 독립 후보에서만 정답을 완벽히 고른다. 개별 모델의 능력 한계나 동일 예산의 다중 샘플 상한이 아니다. |
| 설명의 단서 | Demonstrability와 best member 대비 이득의 순위상관은 약 0.905다. 학습 신호가 아닌 사후 분석이다. |
| 남은 질문 | 실제 비용, seed별 변동, 일부 점수의 유효 평균 분모, 학습·다양성·선택 각각의 기여는 더 확인해야 한다. |
읽기 안내: 쉬운 읽기는 장면 중심으로 설명한다. 성능·사례는 저자 보고이며 모델 실험은 재실행하지 않았다.
목차
- 답을 모으는 대신 풀이를 고칠 수 있을까
- 전략은 누가 무엇을 읽고 검토할지를 정한다
- 실패 기록을 다음 문제의 작업 지침으로 바꾸기
- 배포에서는 열 전략을 실행한 뒤 풀이를 고른다
- 협업의 이득을 구별하는 비교와 지표
- 두 팀의 결과는 같은 이야기가 아니다
- 없던 정답 만들기와 있던 정답 지키기
- 좋은 풀이를 알아보는 능력인 demonstrability
- 비용과 반복과 재현성을 어디까지 알 수 있을까
- 팀의 크기보다 검토 절차를 설계한다
1. 답을 모으는 대신 풀이를 고칠 수 있을까
한 모델이 핵심 아이디어를 찾았지만 마지막 계산을 틀렸다고 하자. 다른 모델은 전체 문제를 풀지 못해도 빠진 항 하나는 발견할 수 있다. 세 번째 모델이 그 수정을 확인한다면, 처음에는 누구도 내놓지 못한 정답이 만들어질 수 있다. 필요한 것은 완성된 답의 투표가 아니라 불완전한 추론을 서로 고치는 절차다.
같은 대화에 넣기만 하면 좋은 협업이 생기지는 않는다. 틀린 다수가 맞는 소수를 지우거나 오류가 복제되기도 한다. SAT는 이런 실패 기록에서 다음 문제에도 쓸 검토 절차를 찾는다.
Multiagent Debate(Du et al., 2024)는 서로의 답을 읽으며 수정하는 틀이고, Mixture-of-Agents(Wang et al., 2025)는 여러 출력을 다음 단계 모델에 전달하는 계층적 구조다. 이들도 새로운 추론을 만들 수 있다. SAT의 차이는 역할과 대화 조직을 실행 경험으로 고르는 탐색 과정이지, 기존 방법의 공동 추론이 불가능하다는 데 있지 않다.
2. 전략은 누가 무엇을 읽고 검토할지를 정한다
2.1 작업 지침을 탐색 가능한 형태로 쓴다
전략은 팀 공통 지침, 지속 역할, 대화 단계로 구성된다. 검토가 중복되지 않도록 참여자와 전달 정보를 정한다.
P=(S,\tau,\alpha)S=[s_1,\ldots,s_K],\qquad
s_k=(A_k,r_k,f_k,\pi_k,\rho_k)| 요소 | 일상적인 뜻 |
|---|---|
S, \tau, \alpha |
단계 목록, 팀 공통 원칙, 각 구성원이 유지할 역할 |
A_k, r_k |
해당 단계 참여자와 라운드 수; 참여자는 라운드마다 한 번 발언 |
f_k |
참여자끼리만 교환할지, 종료 후 요약을 전원에게 전할지 |
\pi_k, \rho_{k,i} |
해당 단계의 공통 지시와 구성원별 지시 |
정보 흐름의 local 모드 L에서는 해당 단계 참여자만 발언을 받는다. Summary 모드 S도 단계 진행 중에는 로컬 대화다. 종료 후 무작위로 고른 참여자 한 명의 요약을 전체 구성원 문맥에 추가한다. 모든 대화 전문을 항상 전원에게 방송하는 구조는 아니다. 전략에 발언 순서가 없으면 순서를 무작위로 섞는다. 이 규칙은 정보 전달 범위를 말할 뿐, 문맥을 언제 초기화하거나 삭제하는지까지 규정하지 않는다.
‘방법 제안→배정→충돌 재검토→종합’이라는 지침도 문제마다 대수·기하 또는 불변량·열거를 선택할 수 있다. 고정되는 것은 대화의 틀이지 풀이 내용이 아니다. 시험 중 전략을 새로 최적화하는 외부 controller는 없다.
2.2 두 팀과 두 bank는 별개다
| 팀 | 고정 구성원 | 학습 자료 | 반성·최종 judge |
|---|---|---|---|
| 수학·물리 | o3-mini, Claude Sonnet 4, DeepSeek-V3 | AIME 2024의 15문제 | o3-mini |
| 지식·논리 | Gemini-2.5-Flash, Llama-4-Maverick, GPT-4.1 | GPQA Diamond의 25문제 | Gemini-2.5-Flash |
저자 보고, §2–3. 반성 담당은 source 학습 집합에서 가장 정확한 구성원이다.
두 roster는 별도 bank를 학습한다. 저자들은 포화를 피해 개선 여지가 있는 모델을 골랐다. 새 문제 전이가 새 모델 조합으로의 전이를 보장하지는 않는다.
3. 실패 기록을 다음 문제의 작업 지침으로 바꾸기
3.1 답이 아니라 반복 가능한 행동을 남긴다
출발점인 P_{\mathrm{init}}는 단순하다. 각자 독립적으로 답을 낸 뒤 다른 구성원의 최신 답을 읽으며 두 라운드 토론하고, 마지막 답의 다수결로 정한다. 엄격한 다수가 없으면 구성원 하나의 답을 무작위로 고른다. 이 초기 전략에는 학습된 지속 역할이나 팀 지침이 없다. 부록 B
학습 문제마다 archive에 이전 전략, 대화, 구성원 답, 팀 결과와 probe 결과를 쌓는다. 반성 모델은 이를 읽고 어느 전략을 부모로 삼을지와 무엇을 바꿀지를 정한다. ‘사라진 근거를 마지막 검토자가 다시 제시하라’처럼 실행 가능한 지시를 제안한다.
문제당 여섯 라운드, 라운드당 최대 세 후보를 제안한다. 후보가 source 문제를 풀면 지침을 고정해 다른 학습 문제 다섯 개에서 실행한다. 이 validation probe 결과는 archive로 돌아가 후속 탐색에 쓰인다. 손대지 않은 검증 집합이 아니라 학습 피드백이다.
GEPA(Agrawal et al., 2026)와의 차이도 여기 있다. SAT 논문은 GEPA의 instance-wise Pareto frontier에서 확률적으로 부모를 고르는 방식과 달리, SAT에서는 반성 담당이 부모와 변이를 모두 선택한다고 설명한다. 이는 관련 방법과의 비교이며 GEPA 소프트웨어를 의존성으로 사용했다는 뜻은 아니다.
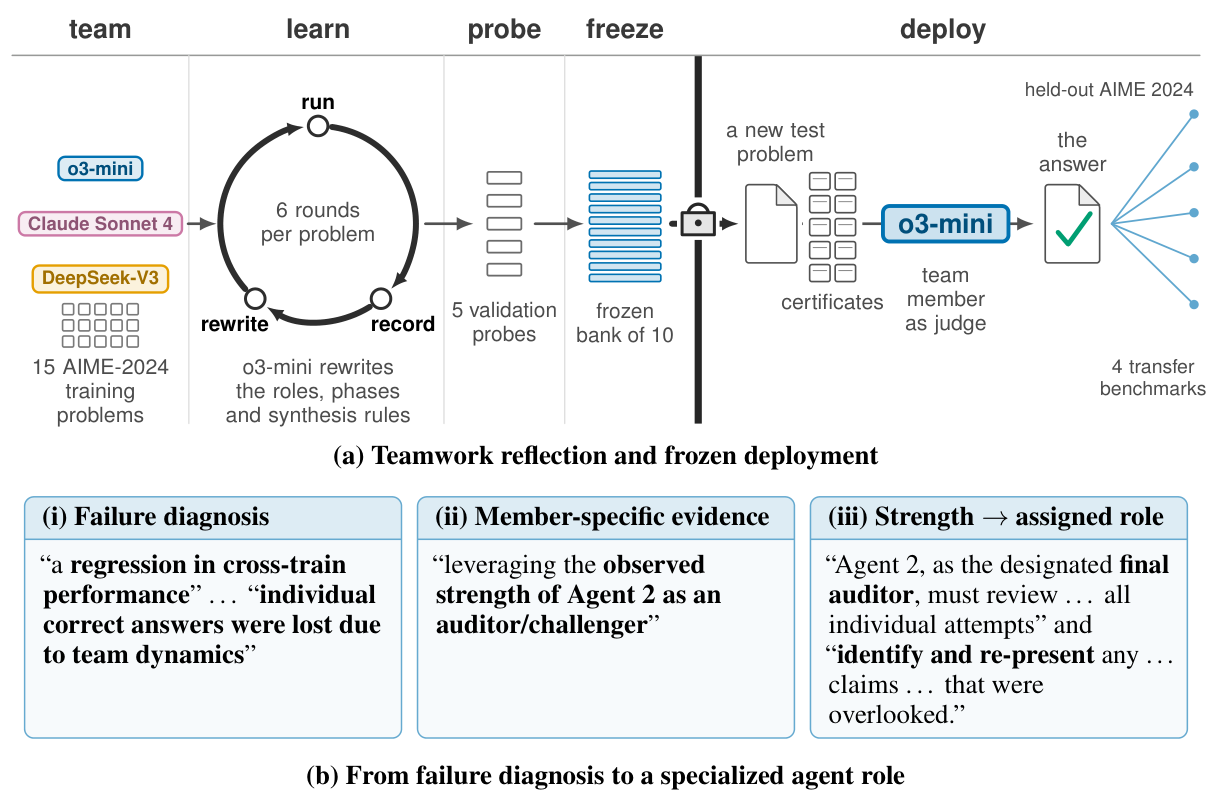
Figure 3. 위는 수학 팀의 학습→동결→배포, 아래는 GPQA의 검토자 역할 발견이다(Agent 2: Gemini-2.5-Flash). 출처: Pappu et al. (2026), v1, p. 6, Fig. 3.
3.2 문제별 정보가 전략에 남는 위험을 줄인다
한 문제의 실패에서 전략을 고치면 그 문제의 답 숫자나 특수한 풀이가 지침에 섞일 수 있다. 이를 줄이기 위해 반성 모델과 같은 모델의 별도 인스턴스가 후보의 모든 필드를 검사한다. 답 값, 문제별 사실·구성, source 문제에서 유래한 풀이 recipe를 담은 후보는 제외한다. 앞서 본 다른 학습 문제 probe도 특정 문제에만 유용한 지침이 살아남기 어렵게 한다.
이는 위험 완화 장치이지 누출 방지의 증명이 아니다. 같은 모델이 의미를 판단하고 학습 집합에 반복 적응하므로 과적합도 남는다.
3.3 최고 하나 대신 서로 보완하는 전략을 고른다
탐색 후 학습 성능을 바탕으로 coverage-greedy 선택을 한다. 이미 고른 전략들이 놓친 문제를 보완하도록 최대 열 개를 남긴다. 공개된 두 bank는 각각 열 개다.
선택 원리는 공개되지만 동률 처리까지 완성된 구현은 아니다. 초기 전략의 독립 풀이도 모든 학습 전략의 공통 계약으로 확대할 수 없다. 초기 답을 캐시하는지 새로 생성하는지, ‘독립’ 단계가 다른 구성원의 문맥에서 격리되는지는 확정되지 않았다. 분명한 결과물은 동결된 텍스트 전략이다. §2, pp. 5–6
4. 배포에서는 열 전략을 실행한 뒤 풀이를 고른다
4.1 먼저 고르는 라우터가 아니라 나중에 고르는 judge다
새 문제를 받으면 적합한 전략 하나를 예측하는 대신 bank의 열 전략을 전부 실행한다. 각 실행은 최종 답과 짧고 독립적으로 읽을 수 있는 추론 기록인 certificate를 만든다. 한 judge가 문제와 후보 전체를 하나의 프롬프트로 받아 최종 답을 선택한다.
새 문제 → 동결한 열 전략을 모두 실행
       → 각 전략의 최종 답과 certificate
       → 한 judge가 후보 전체를 감사
       → 최종 답 하나 선택
Certificate라는 이름은 형식 증명을 뜻하지 않는다. 한 단계씩 검토하기 좋게 쓰도록 요청한 자연어 풀이다. 정식 증명 검사기가 유효성을 보증한 객체가 아니므로, 그럴듯하지만 잘못된 설명도 들어올 수 있다. 후보를 많이 만드는 것과 그중 정답을 고르는 것은 별도 문제다.
4.2 빈도를 무시하는 감사와 빈도를 쓰는 선택
선택 프롬프트는 judge에게 문제를 새로 풀기보다 각 풀이의 구체적인 결함을 찾으라고 요구한다. 계산 오류, 누락한 경우, 근거 없는 가정, 정당화되지 않은 선택지 제거가 대상이다. ‘내 답과 다르다’는 이유만으로 기각하지 말라는 것이다. 부록 D.1, pp. 29–30
- AUDIT: 답의 빈도를 보지 않고 모든 후보의
named_defects를 기록한다. 특정 결함을 못 찾으면 빈 목록을 둔다. - DECIDE: 감사를 마친 뒤 근거가 가장 잘 뒷받침된 후보를 고른다. 결함 목록이 빈 후보가 여러 개면 그 집합 안에서 가장 흔한 답을 골라야 한다.
- 빈도까지 같으면 명시적 근거가 더 완전한 후보를 택한다. 모든 후보가 결함을 가지면 남은 결함을 밝히며 가장 덜 나쁜 후보를 선택한다.
다수결이 사라진 것이 아니라 감사 후에 제한적으로 쓰인다. 빈 목록은 judge가 결함을 못 찾았다는 기록이지 무오류 보증이 아니다. ‘직접 풀지 말라’는 지시도 내부 독립 계산이 없었다는 증거는 아니다.
5. 협업의 이득을 구별하는 비교와 지표
5.1 더 많은 계산만으로 설명할 수 있을까
Best member와 독립 답의 member-vote는 단순 조합의 효과를, Debate·MoA는 고정 토론·집계의 효과를 비교한다. Self-consistency는 후보를 열 개 생성하고, 5-pass self-reflection은 한 모델의 재검토 깊이를 늘린다. 강한 모델 세 복사본을 쓰는 homogeneous team도 같은 전략으로 평가한다.
Linearization에서는 source 학습의 최강 모델이 모든 역할·단계를 순차 수행한다. 저자들은 팀 전체 추론 예산에 대략 맞춘다고 설명한다. SAT가 더 좋다면 한 모델의 긴 실행만으로 충분하다는 설명은 약해지지만, 상호작용과 다양성의 기여는 분리되지 않는다. 실제 예산 계측의 한계는 §9에서 다룬다.
기준선도 항상 같은 모델을 쓰지는 않는다. Self-consistency와 self-reflection은 평가 벤치마크별 독립 성능이 가장 좋은 구성원을 쓰므로 TQA-physics에서는 Sonnet 4, MMLU-Pro에서는 GPT-4.1이다. HMMT의 동률에서는 각각 Sonnet 4와 o3-mini를 택한다. 반면 linearization과 동종 팀은 source 학습에서 정한 o3-mini 또는 Gemini-2.5-Flash를 유지한다.
5.2 후보에 있던 정답과 제출한 정답을 구분한다
아래 식은 논문 지표를 설명하기 위한 리뷰의 표기다. I_q는 문제 q의 관측된 독립 답 집합, C_q는 전략들의 최종 후보 집합, y_q^*는 judge가 고른 답이라고 하자. \mathrm{ok}_q는 해당 문제의 채점 함수다.
R=\frac1N\sum_q
\mathbf1[\exists y\in I_q:\mathrm{ok}_q(y)]
C=\frac1N\sum_q
\mathbf1[\exists y\in C_q:\mathrm{ok}_q(y)]A=\frac1N\sum_q\mathbf1[\mathrm{ok}_q(y_q^*)]R은 routing-oracle coverage, C는 team coverage, A는 최종 accuracy다. 같은 후보 집합에서 답을 고르는 한 A\le C다. C-A는 전체 문제 중 정답 후보가 있었는데 오답을 선택한 문제의 비율이다. 정답이 있었던 문제만을 분모로 한 조건부 judge 오류율과 다르다. 또한 coverage는 최종 certificate를 세므로 대화 도중 정답이 잠깐 등장했다 사라진 경우까지 포함하지 않는다.
A>R이면 관측된 독립 답만 골라서는 얻을 수 없는 성공이 생겼다는 뜻이다. 더 많은 샘플이나 긴 계산으로도 풀 수 없다는 뜻은 아니다. 이 oracle은 능력 상한이나 동일 예산 oracle이 아니다. A-R도 순이득이므로 신규 성공의 총비율과 다르다. 새 성공과 기존 정답의 손실을 나누려면 문항별 교집합이 필요하다.
6. 두 팀의 결과는 같은 이야기가 아니다
6.1 수학·물리에서는 비교적 큰 평균 이득이 있다
| 방법 | AIME24 | AIME25 | AIME26 | HMMT26 | TQA-phys | 평균 |
|---|---|---|---|---|---|---|
| Best member | 64.4 | 40.0 | 42.2 | 26.3 | 71.1 | 48.8 |
| Self-consistency, K=10 | 75.8 | 44.4 | 53.4 | 31.9 | 71.5 | 55.4 |
| Self-reflection | 71.1 | 41.1 | 52.2 | 29.3 | 72.2 | 53.2 |
| Linearization, o3-mini | 74.0 | 43.3 | 68.5 | 39.4 | 68.4 | 58.7 |
| Member-vote | 60.7 | 38.5 | 40.9 | 25.3 | 71.3 | 47.3 |
| Debate | 66.7 | 41.1 | 53.3 | 30.3 | 72.2 | 52.7 |
| Mixture of Agents | 75.6 | 46.7 | 57.8 | 32.3 | 74.0 | 57.3 |
| Homogeneous team, o3-mini | 66.7 | 46.7 | 60.0 | 36.4 | 70.2 | 56.0 |
| SAT 정확도 | 84.7 | 60.8 | 71.2 | 39.4 | 77.2 | 66.7 |
| Routing-oracle coverage | 73.3 | 51.1 | 57.8 | 36.4 | 76.6 | 59.0 |
| SAT coverage | 93.3 | 73.3 | 73.3 | 54.5 | 81.6 | 75.2 |
저자 보고(%), Table 1, p. 8, 세 seed 평균. 마지막 두 행은 실제 제출 정확도가 아닌 완벽 선택의 coverage다.
SAT의 평균 66.7%는 best member 48.8%, linearization 58.7%, 독립 답 oracle 59.0%보다 높다. AIME24는 15개 학습 문제와 겹치지 않는 시험 집합이며 나머지 네 과제는 같은 bank를 추가 학습 없이 사용했다. 수학·물리 평가의 정확한 문항 수는 명시되지 않아 AIME24 시험이 15문제라거나 전체 대회 문항을 썼다고 추정하지 않는다.
AIME26은 best member보다 29.0pp, oracle보다 13.4pp 높다. 반면 HMMT26은 linearization과 39.4%로 동률이고 TQA-physics의 oracle 대비 차이는 0.6pp다. 이득의 크기는 과제마다 다르다.
평균 열은 벤치마크 동일 가중 평균이며 문항을 합친 pooled accuracy가 아니다. SAT의 표시된 다섯 셀 평균은 66.66%다. 반올림된 평균 열끼리 빼면 best member 대비 17.9pp, oracle 대비 7.7pp, linearization 대비 8.0pp다. 개별 표시 셀의 차이를 먼저 평균하면 각각 17.86, 7.62, 7.94pp가 된다. 두 계산의 끝자리 차이는 집계와 반올림 순서의 차이이므로 구분한다.
6.2 지식·논리에서는 좋은 후보를 놓친다
| 방법 | GPQA | MMLU-Pro | BBEH | 평균 |
|---|---|---|---|---|
| Best member | 72.7 | 79.7 | 45.3 | 65.9 |
| Self-consistency, K=10 | 71.6 | 81.2 | 49.8 | 67.5 |
| Self-reflection | 77.7 | 81.7 | 54.7 | 71.4 |
| Linearization, Gemini-2.5-Flash | 79.0 | 84.0 | 53.3 | 72.1 |
| Member-vote | 67.0 | 79.9 | 43.6 | 63.5 |
| Debate | 73.7 | 79.7 | 57.3 | 70.2 |
| Mixture of Agents | 72.0 | 84.3 | 57.3 | 71.2 |
| Homogeneous team, Gemini-2.5-Flash | 78.0 | 76.0 | 58.7 | 70.9 |
| SAT 정확도 | 80.0 | 82.4 | 56.0 | 72.8 |
| Routing-oracle coverage | 84.0 | 88.0 | 66.7 | 79.6 |
| SAT coverage | 94.0 | 91.0 | 78.7 | 87.9 |
저자 보고(%), Table 2, p. 9, 세 seed 평균. GPQA 시험은 학습 25문제와 겹치지 않는 100문제, MMLU-Pro는 100문제, BBEH는 다섯 논리 하위 과제의 75문제다. 마지막 두 행은 coverage다.
SAT는 평균이 가장 높지만 linearization 72.1%와의 차이는 0.7pp다. MMLU-Pro는 MoA 84.3%가, BBEH는 동종 팀 58.7%가 SAT보다 높다. 따라서 이질적 팀이 항상 우월하다고 볼 수 없다. 여기의 72.8%도 세 벤치마크의 동일 가중 평균이지 275문항의 통합 정확도가 아니다.
더 큰 특징은 87.9% coverage와 72.8% accuracy 사이의 15.1pp다. BBEH에서는 78.7−56.0으로 22.7pp다. 세 과제 모두 SAT 후보의 coverage가 독립 답 oracle보다 높지만 최종 정확도는 oracle보다 낮다. 후보에 없던 정답을 만들어 내는 이득이 선택 실패로 충분히 실현되지 못한 것이다. 이 차이는 전체 문제 기준이며 ‘judge가 정답 후보 중 15.1%를 틀렸다’는 조건부 비율이 아니다.
6.3 초기 전략과의 차이에는 여러 효과가 섞인다
초기 P_{\mathrm{init}}의 평균은 수학·물리 54.1%, 지식·논리 69.6%다(부록 Table 4). 하지만 초기 전략은 문제당 한 번, SAT는 열 전략+judge를 쓴다. 절차·다양성·실행량·선택기가 함께 바뀌므로 학습만의 절제 실험은 아니다. 같은 bank 크기·예산·judge에서 학습 여부를 비교해야 한다.
7. 없던 정답 만들기와 있던 정답 지키기
7.1 전체 문제를 못 풀어도 한 줄은 고칠 수 있다
HMMT 2026의 6번 사례에서는 세 구성원의 초기 답이 모두 틀렸다고 보고한다. o3-mini가 불변량과 소인수 구조를 찾았지만 지수가 1인 소수를 다섯 개로 셌다. DeepSeek-V3는 7,11,13,17,19,23이 여섯 개라고 고쳤고 Sonnet 4는 수정을 검토했다. 마지막 계산은 다음과 같다.
\begin{aligned}
\tau(N)&=(4+1)(3+1)(2+1)(1+1)^6\\
&=5\cdot4\cdot3\cdot64\\
&=3840.
\end{aligned}
여섯 인자에 대한 이 산술은 독립적으로 확인할 수 있다. 이것이 원문 문제 전체와 불변량 증명을 다시 풀어 확인했다는 뜻은 아니다. 사례가 보여 주는 것은 핵심 아이디어를 낸 모델과 결정적인 누락을 고친 모델이 다를 수 있다는 점이다. Figures 5·9, pp. 10·26
7.2 소수 의견을 보호하는 것도 다른 종류의 성공이다
AIME 2026 II-01의 초기 답은 032/178/032다. 두 표를 얻은 032를 그대로 택하면 실패한다. Sonnet의 단계별 검토는 음의 항 index를 허용한 오류를 짚었고, 유효한 열 번째 항 13, 22, 49, 94의 합 178을 보존하게 했다. 여기서 178은 처음부터 있었다. 따라서 새 답의 생성이 아니라 올바른 소수 답의 보존 사례다. Figure 12, p. 28
divergence_reconciliation은 DeepSeek의 풀이를 나머지 둘이 재계산하고 그 단계에서 DeepSeek를 제외한다. 반대로 minority_reasoning_challenge는 소수 근거를 되살린다. 다수나 소수를 무조건 믿기보다 서로 다른 검토 절차가 공존한다.
7.3 사례는 작동 장면이지 평균 인과 효과는 아니다
GPQA 초기 답은 MoA D/D/C, Debate D/B/D, SAT D/A/D로 다르다. SAT는 모두 틀린 답에서 B를 만들지만 동일 후보에서 프로토콜만 바꾼 비교는 아니다. 축약된 대화는 국소 수정을 보여 줄 뿐 역할별 평균 기여를 측정하지 않는다. Figure 10, p. 27
8. 좋은 풀이를 알아보는 능력인 demonstrability
8.1 정답과 그럴듯한 오답을 나란히 놓는다
후보를 생성해도 고르지 못한다면, 올바른 추론을 알아보기 얼마나 쉬운지가 중요해진다. 논문은 이를 demonstrability라는 관점에서 측정한다. SAT의 최종 certificate에 정답과 오답이 모두 있는 문제를 고르고, 문제마다 정답 하나와 오답 하나를 짝짓는다. 정답 라벨을 숨기고 A/B 순서를 균형 있게 제시한 뒤, 두 팀 roster 밖의 열 judge 모델이 올바른 풀이를 선택하는 비율을 잰다. 순서·문제·judge에 걸쳐 평균하면 벤치마크별 점수 하나가 된다.
이런 적격 문제가 최소 열 개 있는 여덟 벤치마크가 대상이다. 정확한 적격 문항 수, 쌍 표집의 세부, 추가 반복과 판정 누락 처리는 충분히 제시되지 않았다. 점수는 선택된 SAT 산출물과 특정 패널에 대한 구별 능력이지, 과제의 고유 난도 상수가 아니다. 외부 패널의 정답/오답 한 쌍 비교는 배포 judge가 후보 전체에서 하나를 고르는 작업과도 다르다. §5·부록 E
| 벤치마크 | Demonstrability | SAT−best member |
|---|---|---|
| AIME 2024 | 0.550 | +20.3pp |
| AIME 2025 | 0.559 | +20.8pp |
| AIME 2026 | 0.687 | +29.0pp |
| HMMT 2026 | 0.519 | +13.1pp |
| TheoremQA-physics | 0.423 | +6.1pp |
| GPQA | 0.534 | +7.3pp |
| MMLU-Pro | 0.517 | +2.7pp |
| BBEH | 0.537 | +10.7pp |
저자 보고, Table 5, p. 30. 오른쪽은 상대 개선율이 아니라 정확도의 퍼센트포인트 차이다.
여러 점수는 0.5 부근이다. TQA의 0.423은 이진 무작위 기준 0.5 아래지만, 판정 수와 의존성을 모르면 통계적으로 우연보다 못하다고 할 수 없다. 높은 순위상관은 높은 절대 정확도와 다르다.
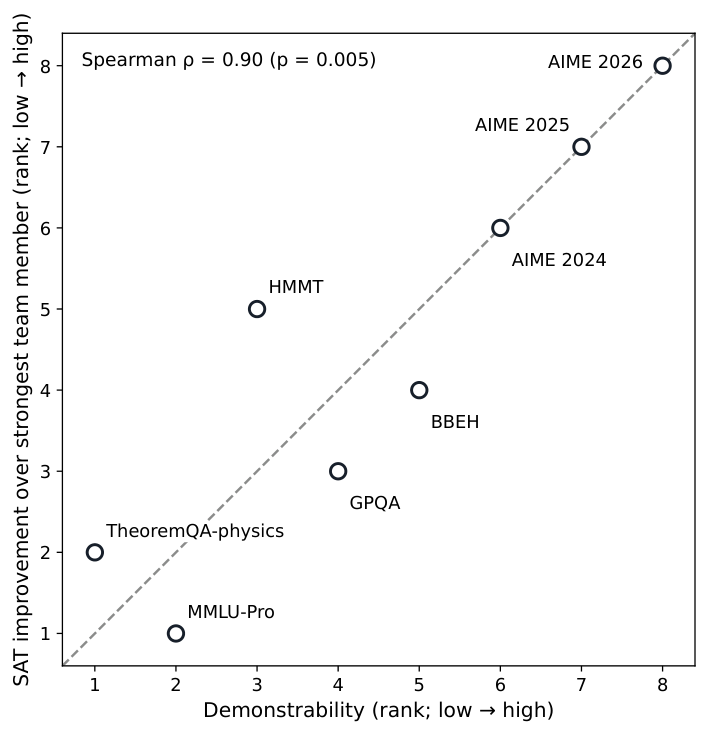
Figure 6. 두 축은 원시 점수가 아닌 demonstrability와 성능 이득의 순위다. 출처: Pappu et al. (2026), v1, p. 11, Fig. 6.
8.2 강한 순위상관을 원인이나 예측기로 확대하지 않는다
표의 여덟 점에 대한 리뷰의 산술 확인에서 Spearman 상관은 \rho=19/21\approx0.9047619다. 결과 순위의 40,320개 순열을 실제로 모두 열거했을 때 양측 극단에 해당하는 경우는 184개다.
p=\frac{184}{40320}\approx0.00456349논문의 반올림 값 0.005와 일치하며, 한 벤치마크씩 제외한 상관도 0.8571–0.9643으로 보고 범위와 맞는다. 이 확인은 표의 통계 산술을 재계산한 것이지 모델 판정을 다시 실행한 것은 아니다.
분석 단위는 여덟 벤치마크다. 닮은 AIME 연도들, 두 roster와 bank, 기본 성능·풀이 표현, 정답·오답이 함께 생긴 문제의 선택 조건이 섞인다. 한 점을 빼는 분석이 이 영향을 모두 제거하지는 않는다.
무엇보다 이 분석은 사후적이며 전략 학습의 입력이 아니다. Demonstrability를 높이도록 개입하면 SAT 정확도가 올라가는지, 새로운 과제에서 팀의 이득을 미리 예측할 수 있는지는 시험하지 않았다. ‘정답을 알아볼 수 있을 때 협업이 더 유용할 수 있다’는 설명의 단서이지, 배포를 결정하는 검증된 예측 공식은 아니다.
9. 비용과 반복과 재현성을 어디까지 알 수 있을까
9.1 적은 학습 문항이 적은 실행 비용을 뜻하지는 않는다
최대 제안 규칙을 곱하면 수학 쪽은 15×6×3=270, 지식 쪽은 25×6×3=450개다. 이는 후보 제안의 상한일 뿐 실제 후보 수나 모델 호출 수, 비용이 아니다. 반성, source-dependence 검사, 여러 번의 팀 발언, 다른 학습 문제 probe, bank 선택과 배포의 최종 judge가 추가로 필요하다. 열 후보를 맞춘 self-consistency 역시 SAT와 비용이 같다는 근거가 되지 않는다.
Linearization의 대략적인 예산 일치는 저자들이 설명한 설계다. 실제 입력·출력·추론 토큰, 호출 수, 지연 시간과 허용 오차가 제공되지 않아 정확한 비용 대비 이득은 재구성할 수 없다. 동종 팀도 이질적 팀에서 학습된 bank를 그대로 쓰므로 동종 팀에 맞춰 새로 학습했을 때의 최선과 비교한 결과는 아니다. 실행량, 학습, 다양성, 선택기 효과를 나누는 데 아직 여지가 있다.
9.2 평균의 끝자리에서 드러나는 미해결 집계 조건
Tables 1–2는 세 seed 평균을 보고하지만 seed별 결과와 분산, 문항별 paired 결과가 없다. 어떤 무작위 요소를 다시 뽑았는지도 명확하지 않으므로 세 번의 독립 bank 학습 반복으로 단정할 수 없다. 지식·논리의 linearization 대비 0.7pp, 물리의 oracle 대비 0.6pp 같은 작은 차이는 이 요약만으로 안정성을 판단하기 어렵다.
더 구체적인 집계 의문도 있다. MMLU-Pro는 100문항을 선택지 exact match로 채점한다고 되어 있다. 각 seed가 그 100문항을 한 번씩 보통의 이진 정오로 채점하고 세 결과를 단순 평균했다면, 한 자리 소수의 끝자리는 .0, .3, .7 중 하나여야 한다. 그런데 SAT 82.4%, self-consistency 81.2%, member-vote 79.9%는 이 해석에서 나오지 않는다.
여기서는 저자 보고값을 그대로 유지한다. 추가 반복, 가중 평균, 유효 평균 분모 중 무엇이 달랐는지 공개 정보로는 해결되지 않았다. 값을 임의로 ‘수정’하거나 반복 횟수·정답 문항 수·신뢰구간을 역산하지 않는다. 이것은 집계 설명이 더 필요하다는 뜻이지 결과가 거짓임을 입증한 것은 아니다. 수학 시험의 분모도 명시되지 않았으므로 익숙한 대회 문항 수에서 실험 횟수를 추정하지 않는다.
9.3 공개된 프롬프트와 실행 재현성을 구분한다
부록 A에는 두 bank의 20개 전략, D.1에는 최종 선택 프롬프트가 있다. 부록 D는 self-consistency의 K=10과 temperature 0.5도 명시한다. HMMT에는 MathArena 채점기, 다른 수학에는 math-verify, MMLU-Pro에는 선택지 exact match, BBEH에는 공식 평가 로직을 쓴다고 밝힌다. 공개된 설정이 전혀 없는 것은 아니다.
다만 전체 모델별 설정과 토큰 한도, 오류·재시도 처리, source 및 시험 문항의 정확한 ID, 예산 계측, 실행 가능한 archive 탐색과 bank 구성 구현까지 재현 가능한 형태로 모두 제공되지는 않는다. 검토한 v1 본문과 HTML에서는 SAT 공식 실행 저장소 링크를 확인하지 못했다. 이는 다른 곳에도 저장소가 없거나 연구가 비공개라는 전역적 주장이 아니다.
가까운 학습형 방법인 OPTAGENT(Bi et al., 2025)는 언어적 피드백으로 다중 에이전트 상호작용을 최적화한다. SAT는 역할·참여자·정보 흐름·종합 절차까지 넓게 표현한다고 구분하지만 Tables 1–2에 OPTAGENT의 직접 비교 수치는 없다. 검사한 고정 토론·집계와 단일 모델 기준선의 결과를 모든 학습형 multi-agent 시스템에 대한 우월성으로 확장할 수는 없다.
10. 팀의 크기보다 검토 절차를 설계한다
설계 단위는 에이전트 수보다 검토할 주장과 수정 절차다. 풀이가 갈라진 지점을 찾아 다시 계산하고, 수정이 최종 답에 남았는지 확인하면 협업이 바꾼 지점을 알 수 있다.
정답 후보가 없다면 생성을, 있는데 놓친다면 선택을 개선해야 한다. 최종 정확도만 보면 비용을 쓸 곳을 잘못 짚을 수 있다. 열린 업무에서는 정답 자체가 불명확해 외부 문서·도구·실험으로 근거를 확인하는 일이 더 중요해진다.
Harness-Zero의 행동 학습과 달리 SAT는 가중치를 유지하고 조직 절차를 텍스트로 남긴다. JEV-as-a-Judge는 판정·추가 검토를, Dynamic Latent Routing은 모델 내부의 계산 조절을 함께 읽을 관점이다.
더 좋은 선택기, demonstrability의 인과 검증, 협업을 개별 모델에 증류해 재귀적으로 강화하는 과정은 미래 연구다. 결론은 ‘셋이면 항상 낫다’가 아니다. 학습한 협업은 불완전한 추론을 고칠 수 있지만, 최종 답으로 남기려면 그 근거를 알아볼 수 있어야 한다.
References
Agrawal, L. A., Tan, S., Soylu, D., Ziems, N., Khare, R., Opsahl-Ong, K., Singhvi, A., Shandilya, H., Ryan, M. J., Jiang, M., Potts, C., Sen, K., Dimakis, A. G., Stoica, I., Klein, D., Zaharia, M., & Khattab, O. (2026). GEPA: Reflective prompt evolution can outperform reinforcement learning. In C. Vondrick, B. Hariharan, C. Raffel, L. Pinto, D. Yang, & A. Faust (Eds.), International Conference on Learning Representations (Vol. 2026, pp. 8479–8565). https://proceedings.iclr.cc/paper_files/paper/2026/hash/0e9e708b6f48e14fd0ac29e167413f76-Abstract-Conference.html
Bi, Z., Lu, M., Li, Y., Roy, S., Guan, W., Ziyadi, M., & Wang, X. (2025). OPTAGENT: Optimizing multi-agent LLM interactions through verbal reinforcement learning for enhanced reasoning. In K. Inui, S. Sakti, H. Wang, D. F. Wong, P. Bhattacharyya, B. Banerjee, A. Ekbal, T. Chakraborty, & D. P. Singh (Eds.), Proceedings of the 14th International Joint Conference on Natural Language Processing and the 4th Conference of the Asia-Pacific Chapter of the Association for Computational Linguistics (pp. 1713–1728). The Asian Federation of Natural Language Processing and The Association for Computational Linguistics. https://doi.org/10.18653/v1/2025.findings-ijcnlp.107
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). Improving factuality and reasoning in language models through multiagent debate. In R. Salakhutdinov, Z. Kolter, K. Heller, A. Weller, N. Oliver, J. Scarlett, & F. Berkenkamp (Eds.), Proceedings of the 41st International Conference on Machine Learning (Vol. 235, pp. 11733–11763). PMLR. https://proceedings.mlr.press/v235/du24e.html
Pappu, A., Suzgun, M., Kwon, Y., Bianchi, F., El, B., Kochenderfer, M. J., Cao, H., & Zou, J. (2026). Self-organizing agent teams learn to reason together [Preprint]. arXiv. https://arxiv.org/abs/2609.22682v1
Wang, J., Wang, J., Athiwaratkun, B., Zhang, C., & Zou, J. (2025). Mixture-of-agents enhances large language model capabilities. In Y. Yue, A. Garg, N. Peng, F. Sha, & R. Yu (Eds.), International Conference on Learning Representations (Vol. 2025, pp. 33944–33963). https://proceedings.iclr.cc/paper_files/paper/2025/hash/5434be94e82c54327bb9dcaf7fca52b6-Abstract-Conference.html