Self-Organizing Agent Teams Learn to Reason Together
답 세 개를 투표할까, 틀린 한 줄을 고칠까: Self-Organizing Agent Teams
고정된 세 모델이 과거 협업 기록에서 역할·대화 단계·검토 절차를 학습한다. 정답을 만들어 내는 능력과 골라내는 능력을 구분하고, 라우팅 오라클·계산 예산 대조·demonstrability 상관의 의미를 분석한다.
Paper: Aneesh Pappu; Mirac Suzgun; Yongchan Kwon; Federico Bianchi; Batu El; Mykel J. Kochenderfer; Hancheng Cao; James Zou (2026). "Self-Organizing Agent Teams Learn to Reason Together". arXiv:2609.22682v1. PDF · 서지 정보.
1. 정답을 아무도 못 냈는데 고칠 부분은 보인다
큰 수의 약수 개수를 구하는 문제를 AI 세 개가 풀었다고 하자. 첫 모델은 소인수의 지수를 이용하면 된다는 핵심을 찾았지만, 지수가 1인 소수의 개수를 잘못 센다. 두 번째 모델은 전체 풀이에는 실패했어도 목록을 보고 ‘다섯 개가 아니라 여섯 개’라고 지적한다. 세 번째가 그 수정을 확인하면 처음 셋 중 누구도 내놓지 못한 답이 완성될 수 있다.
SAT 논문이 소개한 HMMT 2026 사례가 이런 장면이다. o3-mini가 풀이의 구조를 제시하고, DeepSeek-V3가 7, 11, 13, 17, 19, 23을 다시 세고, Claude Sonnet 4가 검토한다. 마지막 곱셈은 5×4×3×64=3840이다. 이 산술은 확인할 수 있지만, 그것만으로 원래 문제의 모든 증명까지 다시 검증한 것은 아니다.
여기서 중요한 질문은 ‘누가 제일 똑똑한가’보다 누가 남의 풀이에서 무엇을 고칠 수 있는가다. 완성된 답만 투표했다면 모두 오답인 출발점에서 벗어나기 어렵다. Self-Organizing Agent Teams, 줄여서 SAT는 이런 부분적인 기여를 연결하는 작업 순서를 배운다.
2. 사람을 더 뽑는 대신 회의 방식을 바꾼다
이 연구의 팀원은 고정되어 있다. 모델 가중치를 다시 학습하지도 않는다. 바뀌는 것은 ‘먼저 무엇을 하고, 누구에게 무엇을 보여 주며, 마지막에 무엇을 확인할지’라는 텍스트 지침이다.
가령 ‘풀이가 갈라진 지점 찾기→그 계산을 다른 구성원이 다시 하기→고친 근거로 답 정리하기’라는 순서를 생각할 수 있다. 이는 원리를 설명하는 예다. 지침을 다음 문제에도 쓰지만 실제로 검토할 계산은 달라진다. 동결된 전략은 정답을 외운 대본이 아니라 반복 가능한 작업 방식에 가깝다.
모든 발언을 늘 전원에게 보여 주는 것도 아니다. 특정 단계는 참여자끼리만 대화한다. 요약 전달 모드도 대화 중에는 그 안에서만 교환하고, 끝나면 무작위로 고른 참여자가 쓴 요약을 전원에게 전한다. 순서를 따로 지정하지 않은 단계에서는 발언 순서를 무작위로 섞는다. 어떤 정보를 누구에게 언제 줄지도 전략의 일부인 셈이다.
연구에는 서로 별개인 두 팀이 있다. 수학·물리는 o3-mini, Sonnet 4, DeepSeek-V3가 AIME 15문제로 전략을 배우고, 지식·논리는 Gemini-2.5-Flash, Llama-4-Maverick, GPT-4.1이 GPQA 25문제로 따로 배운다. 40문제를 합쳐 하나의 범용 팀을 만든 실험은 아니다.
3. 실패한 대화에서 다음번 규칙을 찾는다
학습 중에는 문제별로 과거 전략과 대화, 각자의 답, 팀의 성공·실패 기록을 모은다. 반성 담당 모델은 그 기록을 읽고 어느 전략을 고칠지와 어떻게 고칠지를 정한다. 합의 과정에서 맞는 주장이 사라졌다면, 최종 검토자가 처음 주장들을 다시 꺼내게 하는 식이다.
문제당 여섯 라운드에서 매번 최대 세 후보를 제안한다. 후보가 출발 문제를 풀면 다른 학습 문제 다섯 개에서도 시험한다. 그 결과는 다시 탐색에 사용되므로 손대지 않은 최종 검증 자료가 아니다. 답 숫자나 그 문제만의 풀이가 지침에 남지 않도록 같은 반성 모델의 별도 인스턴스가 검사하지만, 완전한 누출 방지의 증명은 아니다.
마지막에는 서로 다른 문제를 보완하는 전략을 최대 열 개 고른다. 공개된 두 묶음은 각각 열 개다. 한 전략이 놓친 문제를 다른 전략이 풀 수 있도록 고른다는 뜻이다. 학습 문항은 적지만 후보를 만들고 검사하고 여러 문제에서 실행하는 일이 반복된다. 270개와 450개는 제안 규칙으로 계산한 상한이지 실제 호출 수나 비용이 아니다.
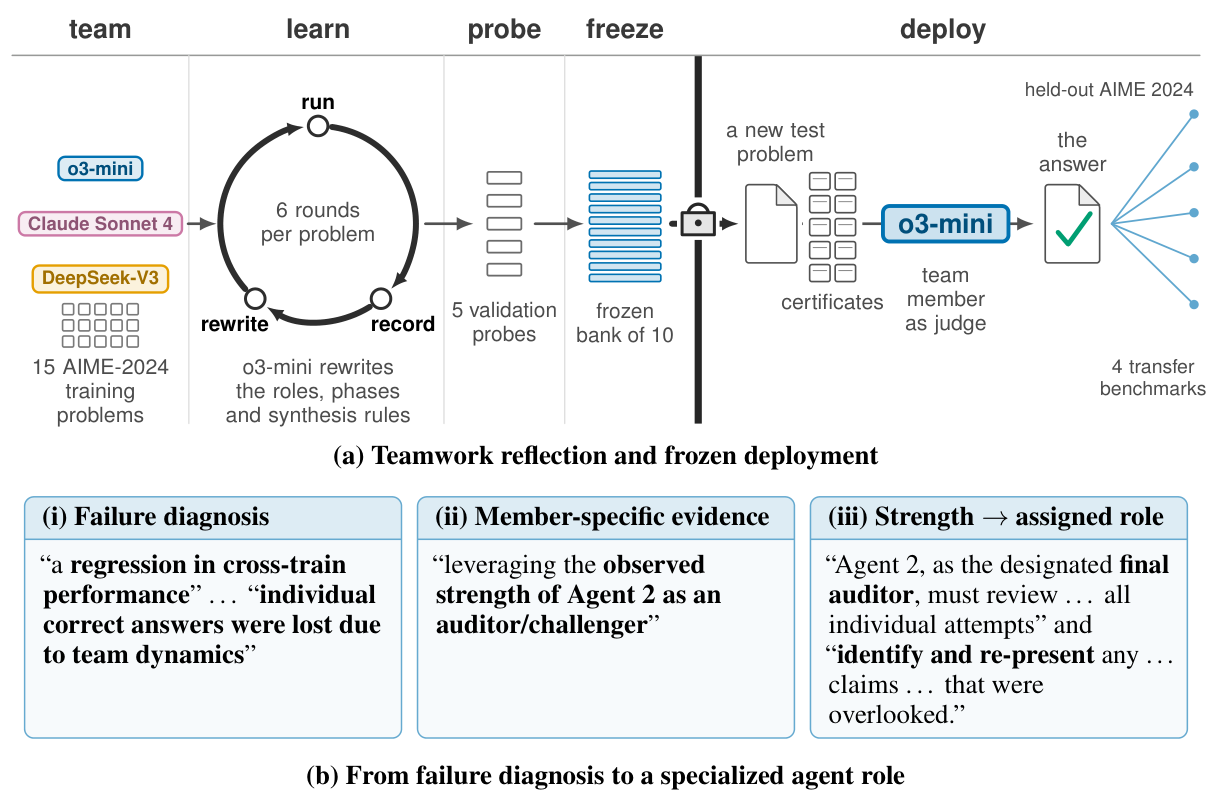
Figure 3. 위는 수학 팀의 학습과 배포, 아래는 GPQA의 검토자 역할 발견이다(Agent 2: Gemini-2.5-Flash). 출처: Pappu et al. (2026), v1, p. 6, Fig. 3.
4. 열 가지 방식으로 풀고 마지막에 하나를 고른다
새 문제가 들어오면 가장 알맞을 듯한 전략 하나를 먼저 고르지 않는다. 동결한 열 전략을 모두 실행한다. 각각 최종 답과 읽고 검토할 수 있는 풀이 기록을 만들고, 한 judge가 문제와 후보 전체를 한 번에 받아 최종 답을 선택한다. 시험 중 전략을 다시 최적화하는 과정은 없다.
이 풀이 기록을 certificate라고 부르지만 형식적으로 검증된 증명은 아니다. 자연어 설명이므로 오류가 있을 수 있다. judge는 우선 답의 빈도를 무시하고 모든 풀이에서 계산 실수, 빠진 경우, 근거 없는 가정 같은 구체적인 결함을 찾는다. ‘내 생각과 다르다’는 이유만으로 버리지 않도록 지시한다.
그 뒤 결함을 못 찾은 후보가 여러 개면 그 후보들 안에서 가장 흔한 답을 고른다. 빈도까지 같으면 명시적 근거가 더 완전한 쪽을 택하고, 모두 문제가 있으면 가장 덜 나쁜 후보를 고른다. 즉 투표가 완전히 사라진 것이 아니라 검토 뒤의 제한된 규칙으로 남는다. ‘직접 문제를 새로 풀지 말라’는 지시도 judge 내부 계산까지 보증하는 것은 아니다.
왜 소수 답을 검토해야 할까? AIME 사례의 처음 답은 032/178/032였는데, 다수인 032의 풀이가 항 번호 조건을 어겼다. 그 오류를 짚어 178을 남긴 것은 없던 답을 만든 성공과 다르다. 이미 있던 정답을 잘못된 합의에서 지킨 성공이다. 이런 사례는 유용하지만, GPQA의 방법별 예시는 초기 답부터 달라 같은 출발점의 통제 실험으로 볼 수 없다.
5. 수학에서는 좋아졌지만 모든 비교를 이긴 것은 아니다
논문은 수학·물리 다섯 벤치마크에서 SAT의 평균 정확도를 66.7%로 보고한다. 가장 잘하는 단일 구성원은 48.8%, 한 모델이 학습된 역할을 차례로 수행하는 linearization은 58.7%였다. 이 평균은 벤치마크마다 같은 비중을 준 값이지 모든 문항을 합친 정확도가 아니다.
또 하나의 비교는 각 모델의 독립 답 중 정답이 있으면 무조건 고르는 가상의 선택기다. 그 coverage는 평균 59.0%다. SAT가 이를 넘었다는 것은 이번에 관측한 독립 답들에는 없던 정답을 만들었다는 뜻이다. 개별 모델이 더 오래 생각하거나 더 많이 시도해도 절대로 풀 수 없다는 뜻은 아니다. 같은 계산 예산으로 독립 답을 아주 많이 만든 경우와도 다른 비교다.
차이의 크기도 봐야 한다. AIME26에서는 SAT가 71.2%로 best member보다 29.0퍼센트포인트 높지만, HMMT에서는 linearization과 39.4%로 동률이다. 물리에서는 독립 답의 가상 선택기보다 0.6퍼센트포인트 높을 뿐이다. 초기 토론 전략보다 좋아진 결과도 초기 전략 한 번과 열 전략+judge의 비교라 학습만의 효과로 나눌 수 없다.
저자들은 linearization의 예산을 팀 전체에 대략 맞췄다고 설명하지만 실제 토큰·호출·지연 수치는 제시하지 않는다. 모든 단일 모델 기준선이 같은 모델을 쓰는 것도 아니다. 따라서 이 결과를 곧바로 비용 대비 우월성이나 협업 자체만의 순수 효과로 바꾸어 말할 수는 없다.
6. 후보 속 정답을 놓치면 팀도 틀린다
지식·논리에서는 이야기가 달라진다. SAT의 평균 정확도는 72.8%로 linearization의 72.1%보다 조금 높다. 그러나 MMLU-Pro에서는 MoA가, BBEH에서는 같은 모델 세 복사본으로 만든 팀이 더 높다. ‘서로 다른 모델 셋이면 언제나 낫다’는 결과는 아니다.
핵심은 후보에 정답이 있는 비율인 **coverage 87.9%**다. 최종 정확도 72.8%와는 15.1퍼센트포인트 차이가 난다. BBEH만 보면 22.7퍼센트포인트다. 이 차이는 전체 문제 중 정답 후보가 있었는데 놓친 비율이며, 정답이 있었던 문제만 놓고 계산한 judge 오류율은 아니다. coverage도 대화 중 잠깐 나온 답이 아니라 최종 후보를 센다.
정답을 만들어도 알아보지 못하면 제출 답은 틀린다. 그래서 후보를 더 많이 만드는 노력과 더 잘 고르는 노력을 구분해야 한다. oracle 대비 최종 점수의 순차이도 새로 푼 문제의 총비율은 아니다. 새로 맞힌 문제와 원래 맞힐 수 있었는데 놓친 문제가 동시에 있을 수 있다.
숫자의 정밀도에도 주의가 필요하다. MMLU-Pro 100문항을 세 seed에서 한 번씩 이진 채점해 단순 평균하면 소수 첫째 자리 끝은 .0/.3/.7이어야 한다. 보고된 82.4, 81.2, 79.9는 그 해석과 맞지 않는다. 저자 숫자는 유지하되 추가 반복·가중치·유효 평균 분모는 미해결로 둔다. 정답 수나 신뢰구간을 추정하지 않으며, ‘세 seed’가 세 번의 독립 전략 학습이라는 보장도 없다.
7. 알아보기 쉬운 풀이가 더 도움이 될까
저자들은 정답 풀이와 그럴듯한 오답 풀이를 구별하는 정도를 demonstrability로 측정한다. 두 종류 후보가 모두 생긴 문제에서 한 쌍을 뽑아 순서를 균형 있게 보여 주고, 원래 팀에 없는 열 judge 모델이 고르게 한다. 그런 문제가 최소 열 개 있는 여덟 벤치마크가 대상이다. 정확한 적격 문항 수와 반복 세부는 충분히 공개되지 않았다.
구별 점수가 높은 과제일수록 SAT의 best member 대비 이득도 큰 경향이 있었다. 순위상관은 약 0.905다. 표의 모든 순열을 재계산한 양측 p값도 184/40,320≈0.00456으로 논문과 맞지만, 이는 모델 실험을 다시 한 것이 아니다. TQA의 구별 점수 0.423이 기준 0.5 아래라는 관찰도 통계적으로 우연보다 못함을 입증하지는 않는다.
이것은 사후 상관이며 학습에 사용한 신호가 아니다. 비슷한 AIME 연도들, 서로 다른 두 팀, 정답·오답이 함께 나온 문제만 고르는 조건이 섞여 있다. 한 쌍을 고르는 외부 패널의 성능을 실제 후보 전체 선택기의 정확도와 같게 볼 수도 없다. 설명을 더 읽기 쉽게 바꾸면 정확도가 오른다는 인과관계나, 새 업무에서 협업의 효과를 미리 예측하는 공식은 아직 없다.
8. 더 많은 목소리보다 더 나은 수정 절차
SAT의 교훈은 팀원을 무조건 늘리라는 것이 아니다. 풀이의 어느 부분이 충돌하는지 드러내고, 누가 그 부분을 다시 계산할지 정하며, 수정된 근거가 최종 답에 남았는지 확인하라는 쪽에 가깝다. 시작 장면의 두 번째 모델은 최고 풀이자가 아니어도 빠진 인자 하나를 찾아 팀에 기여했다.
부록에는 20개 전략과 최종 선택 프롬프트, 일부 샘플링·채점 설정이 공개되어 있다. 다만 전체 비용과 실행 설정, 정확한 문항 ID, 실행 가능한 탐색 구현까지 재현할 자료는 충분하지 않다. 검토한 v1에서는 공식 실행 저장소 링크를 확인하지 못했으며, 다른 곳에도 없다는 뜻은 아니다.
실제 적용에서도 먼저 물어야 할 것은 ‘정답 후보가 없었나, 있었는데 못 골랐나’다. 두 실패는 다른 처방을 요구한다. 전체 결과표와 비교의 조건은 상세 읽기에 정리했다. 판정과 추가 검토를 분리하는 관점은 JEV-as-a-Judge와도 함께 읽을 수 있다. 좋은 협업은 의견 수가 아니라 검토 가능한 근거가 끝까지 살아남는 과정에서 만들어진다.
References
Pappu, A., Suzgun, M., Kwon, Y., Bianchi, F., El, B., Kochenderfer, M. J., Cao, H., & Zou, J. (2026). Self-organizing agent teams learn to reason together [Preprint]. arXiv. https://arxiv.org/abs/2609.22682v1