Stellar Colosseum: A Many-Agent Harness for Long-Horizon Research in Mathematics and Theoretical Computer Science
Stellar Colosseum은 준비도 판정, 증명 분해, 부분 풀이와 전역 검토를 나눠 긴 연구 작업을 관리한다. TCS-Bench 71%는 두 실행을 선택한 결과이며, Codeforces의 5문제 증가는 실행 probe만의 효과가 아니다.
Paper: Honghao Lin; David P. Woodruff; Yuan Deng; Jieming Mao; Song Zuo; Vahab Mirrokni (2026). Stellar Colosseum: A Many-Agent Harness for Long-Horizon Research in Mathematics and Theoretical Computer Science. Google Research; David P. Woodruff는 Carnegie Mellon University에도 소속. Lin과 Woodruff는 공동 제1저자다. arXiv:2609.15983v1, 2026-09-14. PDF · 서지 정보. 부록의 축약 프롬프트를 포함해 27쪽을 검토한다.
Abstract: 긴 수학 연구는 답을 길게 쓰는 문제가 아니다. 유망한 접근을 찾고, 아직 증명되지 않은 연결고리를 드러내며, 여러 절의 가정을 일치시키고, 실패한 부분만 다시 풀어야 한다. Stellar Colosseum은 전략 탐색·준비도 판정·증명 분해·부분문제 해결·전역 검토를 분리한다. 각 단계에서는 후보와 그에 대한 반론을 함께 표집해 겹치는 트리로 합성한다. 다섯 연구 성과와 장문 증명 사례, TCS-Bench 71.0%, Codeforces 218/222를 보고한다. 그러나 71%는 두 모델 실행의 선택 결과이고, Codeforces 비교는 수정 예산까지 다른 전체 구성 비교다. 자연어 검토·기준 증명을 보는 자동 채점·숨은 테스트 통과도 서로 다른 증거다.
Executive Summary
| 항목 | 설명 |
|---|---|
| 핵심 질문 | 추가 추론을 어느 전략·보조정리·오류 수정에 배정할 것인가? |
| 외부 루프 | 전략 탐색 → readiness gate → 절별 DAG → 부분 증명 → 전역 검증 → 수정 또는 재탐색. |
| 내부 루프 | 후보 생성 → 표적 반증 → 후보와 비평의 묶음을 중첩 표집 → 트리 합성. 단순 다수결이 아니다. |
| 핵심 상태 | 직전 증명 전문+검토 의견, 별도의 지식 디렉터리에 정리·실패·문헌·관찰을 보존한다. |
| TCS-Bench | Gemini 3.1 Pro 실행 54%, Gemini 3.7 Flash 실행 55%, 두 후보 선택 71%, 사후 oracle 77.3%. |
| Codeforces | 222문제 중 실행 probe 포함 218개 통과, 미포함 213개. 수정 예산도 달라 probe의 순수 효과는 아니다. |
| 연구 성과 | coreset·희소 회귀·임베딩 하한·양자화·행렬 분해. 전체 증명·기여 귀속은 동반 논문에 위임된다. |
| 검증 경계 | 하네스의 수락은 형식 증명 커널의 soundness가 아니다. 공개 Erdős 초안에는 오류·공백이 명시돼 있다. |
읽기 안내: 논문 수치·정리는 저자 보고다. 이 글은 표의 산술과 추출 도판을 검사했으며 실험이나 수학 증명을 독립 재현하지 않았다. 외부 자료는 Hadamard·임베딩 하한 동반 논문 초록, 공개 증명 저장소 목록 및 Erdős README의 명시적 범위만 확인했다. 관련 선행 논문 전체를 다시 감사했다는 뜻은 아니다.
목차
- 긴 증명은 길게 쓰기보다 상태 관리의 문제다
- 준비도 게이트는 완성된 증명을 요구하지 않는다
- 겹치는 표본 트리는 투표가 아니라 합성이다
- 부분 증명과 전역 논증은 따로 검토한다
- 다섯 수학 성과에서 무엇이 개선됐는가
- 긴 초안과 독립 재발견의 증거 수준
- TCS-Bench의 점수와 채점기를 함께 읽는다
- 두 실행의 상보성을 선택기가 얼마나 회수했는가
- Codeforces의 숨은 테스트와 실행 피드백을 구분한다
- 설계의 설득력과 인과적 효과의 입증은 다르다
1. 긴 증명은 길게 쓰기보다 상태 관리의 문제다
보조정리 A를 증명한 뒤 B를 풀다가 A의 가정이 너무 강했다는 사실을 발견했다고 하자. A만 고치면 되는지, A에 의존하는 B와 C도 다시 봐야 하는지, 애초에 접근을 바꿔야 하는지가 다음 의사결정이다. 긴 출력 한 번이나 최종 답변의 다수결만으로는 이 상태를 표현하기 어렵다.
Colosseum은 새로운 기반 모델이나 학습 알고리즘이 아니라 연구 추론을 배치하는 model-agnostic harness다. 전략을 비교하는 단계와 증명을 쓰는 단계를 나누고, 각 단계의 여러 후보를 공격·합성한다. 논문은 Antigravity Teamwork의 Long Proof 패턴으로 통합됐다고 보고하지만 이 리뷰에서 해당 제품을 실행 확인한 것은 아니다.
Cogentic과는 실패 기록·부분 성과·검토 역할을 보존한다는 공통점이 있다. Colosseum은 준비도 판정, 절별 의존성 그래프, 후보–반론을 함께 넘기는 합성 구조를 더 명시적으로 기술한다. Self-Organizing Agent Teams의 과거 문제 기반 협업 전략 학습과 달리, 여기서는 현재 실행의 탐색과 수정이 중심이다. 연구 궤적을 모델의 사후학습에 쓰는 것은 §8.2의 향후 방향이지 이 논문의 완료된 학습 실험이 아니다.
2. 준비도 게이트는 완성된 증명을 요구하지 않는다
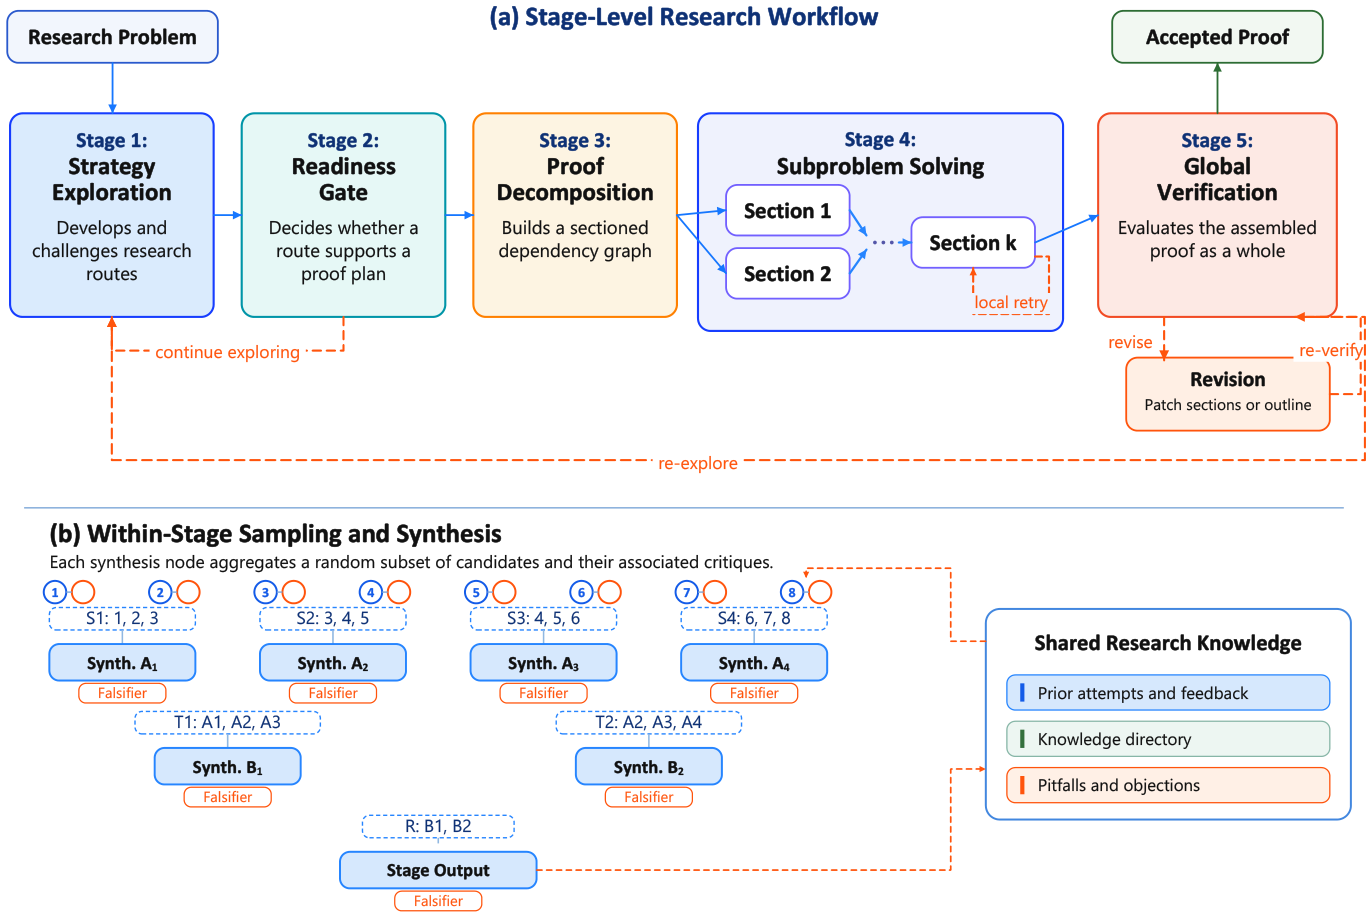
Figure 1. 위는 탐색·분해·검증·수정의 흐름, 아래는 후보와 반론을 함께 전달하는 트리다. 출처: Lin et al. (2026), v1, p. 2, Fig. 1 — 연구·학습 목적 인용.
2.1 전략 카드에 미해결 사항을 남긴다
Explorer는 즉시 증명 본문을 쓰지 않고 목표의 정규화, 핵심 환원·메커니즘, 필요한 보조정리, 첫 병목, 반증 가능한 시험을 담은 전략 카드를 만든다. 부록은 주 경로 하나와 서로 다른 보조 경로 최대 둘을 유지하도록 한다. 반증자는 경계 사례·숨은 가정·잘못된 부등식 방향·인용 정리의 조건·계산 결과의 과장을 공격한다.
Readiness gate의 질문은 ‘이미 증명했는가’가 아니라 미해결 문제를 안정적인 증명 구조의 각 절에 맡길 수 있는가다. 어려운 보조정리가 남아도 명제·역할·증명 또는 검증 경로가 구체적이면 분해할 수 있다. 반면 이를 해결하려면 목표나 중심 메커니즘을 바꿔야 할 정도라면 탐색으로 돌아간다.
2.2 조건부 진행은 조건부 주장의 은폐가 아니다
Appendix A의 문구는 미해결 fatal bridge를 ready로 표시하지 말라고 하면서도 명시적 obligations를 가진 분해를 허용한다. 둘을 함께 읽어야 한다. 안정된 구조 안에서 할당 가능한 과제는 남길 수 있지만, 해결 경로 없는 핵심 가정을 사실로 바꿔 진행하면 안 된다.
이것은 운영 정책이지 준비도가 수학적으로 판정 가능한 술어라는 보장은 아니다. 모델이 실제로 모든 치명적 공백을 찾아내는지, gate 때문에 잘못된 경로가 얼마나 일찍 중단됐는지는 별도 절제로 측정하지 않았다. 부록 프롬프트도 축약본이며 전체 구현을 그대로 재현하는 명세는 아니다.
3. 겹치는 표본 트리는 투표가 아니라 합성이다
후보 하나를 그 반론 기록과 묶어 z_i라고 하자. 레벨 ℓ의 후보 수는 m_\ell, 다음 레벨 합성 노드 수는 m_{\ell+1}이다. 각 합성 노드는 현재 후보 중 k_\ell개를 균일하게 비복원 표집한다. 한 그룹 안에서는 중복 없이, 서로 다른 그룹끼리는 독립적으로 뽑으므로 같은 후보가 여러 그룹에 들어갈 수 있다.
\mathbb E[R_i^{(\ell)}]=\frac{m_{\ell+1}k_\ell}{m_\ell}.원문의 예인 128→64, 그룹당 5개면 후보의 기대 재사용 횟수는 2.5다. 합성기는 단순 최고점 선택이나 평균을 하지 않는다. 호환되는 증명 조각을 합치고, 반론에 맞게 약화·수정하며, 해결하지 못한 충돌을 다음 레벨로 남긴다.
설명용 확률 검산: 같은 표집 규칙에서 특정 후보가 다음 레벨의 어느 그룹에도 들어가지 않을 확률은 다음과 같다.
\Pr(R_i^{(\ell)}=0)=\left(1-\frac{k_\ell}{m_\ell}\right)^{m_{\ell+1}}.128→64, k=5에서는 약 7.8%다. 여러 번 기여할 기회를 주지만 모든 후보를 보존하는 보장은 아니다. 이는 다음 레벨 입력에서 선택되지 않을 확률이며, 별도의 지식 디렉터리까지 포함해 그 아이디어가 시스템에서 영원히 사라진다는 뜻은 아니다.
트리 폭은 총 호출 수가 아니다
| 설정 | 단계 | 폭 | 그룹당 표본 수 |
|---|---|---|---|
| 열린 연구 | 전략 탐색 | 가변, 일부는 잎 100개를 조금 넘음 | 가변 |
| TCS-Bench·Codeforces | 전략 탐색 | (32, 16, 8, 5, 1) | 5, 현재 폭으로 제한 |
| 세 설정 모두 | 나머지 단계 | (16, 8, 5, 1) | 5, 현재 폭으로 제한 |
Table 1, p. 10.
폭을 더한 62개(32+16+8+5+1), 30개(16+8+5+1)는 해당 트리의 노드 수 설명일 뿐 전체 모델 호출 예산이 아니다. 반증자 수·부분문제 수·재시도·전역 수정 라운드가 추가된다. ‘100명의 에이전트가 모든 단계에서 계속 협업한다’거나 동일 토큰 예산으로 효율이 개선됐다고 바꾸지 않는다.
4. 부분 증명과 전역 논증은 따로 검토한다
Decomposer는 번호가 붙은 LaTeX 골격과 절별 부분문제의 DAG를 만든다. 문서의 절 순서는 설명 순서이고 DAG는 작업 가능 순서다. 선행 절이 완료된 뒤에만 해당 부분문제를 시작하며 독립 절은 병렬로 푼다.
| 구간 | 검사와 피드백 |
|---|---|
| 절별 검토 | 맡은 명제를 실제로 증명했는지, 선행 결과의 조건이 맞는지 확인한다. 실패한 절과 반론을 넣어 같은 부분문제를 재시도한다. |
| 전역 검토 | 전체 원문을 읽어 가정·표기 이동, 빠진 경우, 목표 불일치, 절 사이의 잘못된 의존을 찾는다. |
| 수정 | 문제가 생긴 절·주장을 지정해 고친 후 다시 전체를 검토한다. |
| 재탐색 | 오류가 중심 전략을 무너뜨리면 전략 탐색으로 돌아간다. |
전역 검토는 긍정 의견이 많다고 반론을 덮는 다수결이 아니다. 구체적인 치명적 결함 하나로도 거부할 수 있고, 같은 비판은 합치되 서로 다른 오류는 남긴다. ‘독립적인 리뷰 샘플’이라는 표현이 오류의 통계적 독립성을 보장하지는 않는다.
현재 local retry는 부분문제와 의존성을 고정한 채 본문을 다시 쓴다. 실패한 부분의 주변 DAG를 자유롭게 재분해하는 것은 §8.1의 미래 확장이다. Appendix A.4의 보수적 outline 수정도 절 추가·생존 절 재정렬·새 전략 도입을 금지한다. 따라서 일반적인 ‘outline 수정 가능’을 임의의 자동 그래프 재구성 구현으로 확대하지 않는다.
기억은 두 층이다. 직전 초안 전문과 verifier feedback을 함께 넘기고, curator가 정리·실패 경로·문헌·계산 관찰을 별도 knowledge directory에 정리한다. 출처와 단서를 유지하므로 이것은 모두 참인 정리만 들어가는 증명 커널의 저장소가 아니다. Context Language Models의 live context 편집과도 구현·신뢰 경계가 다르다.
5. 다섯 수학 성과에서 무엇이 개선됐는가
§5는 하네스 실행이 기여한 다섯 성과를 소개하고 전체 정의·기여 귀속·증명은 동반 논문에 위임한다. 따라서 여기서는 개선의 축과 조건을 읽으며 완전 자율 해결률로 합산하지 않는다.
5.1 Strong coreset: ε 의존성을 개선한다
행렬 A의 행을 표집·재가중해, 차원 k 이하의 모든 부분공간 F에 대한 비용을 동시에 1\pm\varepsilon로 보존하는 것이 strong coreset이다. p>2에서 기존 크기 \widetilde O_p(k^{p/2}\varepsilon^{-p})를 같은 표집 규칙으로 \widetilde O_p(k^{p/2}\varepsilon^{-2})까지 줄였다고 보고한다. 실행시간 \widetilde O_p(\mathrm{nnz}(A)+d^\omega)도 유지한다.
핵심은 생존 행 수 재귀식을 분석할 때 표집 확률의 truncation을 버리지 않아 고정점의 ε 의존성을 바꾸는 것이다. 새로운 샘플러를 만들었다거나 데이터의 모든 속성을 보존한다는 뜻이 아니다. 비용 보존 대상과 p>2 조건이 중요하다.
5.2 희소 최소제곱: 무조건 하한이 아니다
조건수 κ에 거의 선형으로 의존하는 출력 sparsity를 고정된 더 작은 지수로 개선할 수 있는지 묻는다. 보고된 불가능성은 randomized exact-volume Small-Set Expansion Hypothesis에 조건부다. 고정 γ∈(0,1]에 대해, 최선의 k-sparse 목적값에 ε 이내로 접근하면서 출력의 비영 좌표 수 s=|x|_0를 다음처럼 제한하는 randomized polynomial-time 알고리즘의 장벽이다.
s=O\!\left(k\kappa_{s+k}^{1-\gamma}\right).κ의 아래첨자는 제한된 sparsity 수준이다. 정리는 적어도 2/3의 성공 확률을 요구하는 알고리즘에 대한 장벽이다. 임의의 전역 조건수나 모든 희소 최적화 문제에 대한 무조건적인 불가능 정리로 바꾸면 안 된다. 전체 매개변수 영역은 동반 논문에 있다.
5.3 단일 벡터 임베딩: 차원 지수의 간격을 줄인다
크기 m 이하의 문서 점집합과 singleton query의 최대 내적을 additive error ε로 나타내는 단일 벡터 표현을 다룬다. 고정 δ∈(0,1), 충분히 큰 m에서 보고된 하한은
D\ge m^{c_\delta/\varepsilon^{2-2\delta}},\qquad c_\delta>0이다. 기존 하한의 ε 지수와 상한 m^{O(1/\varepsilon^2)} 사이 간격을 거의 닫는다. 데이터 의존적인 표현도 허용하는 하한이며 singleton query가 어려운 경우이므로 Chamfer에도 적용한다. δ 여유가 남는 ‘near-optimal’을 정확한 최적 차원으로 바꾸지 않고, 현실의 모든 문서 집합에서 단일 벡터가 쓸모없다는 결론도 내리지 않는다.
외부 초록 대조: 동반 논문은 충분히 작은 ε와 m\ge(1/\varepsilon)^{A_\delta}, 단위 질의·단위 문서 벡터 조건을 더 명시한다. 하한은 이러한 어려운 데이터가 존재한다는 주장이다. 모든 데이터셋에 동일한 차원 하한을 적용하는 정리가 아니다.
5.4 Hadamard 양자화: 잔여 단계를 없앤다
좌표당 b비트의 single-stage 비편향 추정기로 기존 1/(d4^b) 평균제곱오차 스케일을 유지하면서 잔여 양자화 단계의 O(d)비트 payload를 제거하고 상한의 선도상수를 약 5.93배 낮췄다고 보고한다. 이는 측정한 검색 성능·압축률·실행시간을 5.93배 개선했다는 말이 아니다.
외부 초록 대조: 동반 논문은 unit input과 fixed query, b→∞에서 dimension-free o(1)이라는 조건을 명시한다. 또한 증명을 자동 시스템이 먼저 얻었고 저자들이 검증·설명을 편집했다고 쓴다. 이 한 사례의 기여 설명을 나머지 모든 성과의 동일한 인간 개입 수준으로 일반화하지 않는다.
5.5 Prefix 행렬: 작은 로그 인자 간격이 남는다
n×n 하삼각 1행렬 Q의 분해 Q=AB에서 \gamma_{2,1}(Q)=\inf|A|{2\to\infty}|B|{1\to1}을 다룬다. 임의의 유한 내부 차원을 갖는 실수 분해에 대해
\gamma_{2,1}(Q)=\Omega\!\left(\frac{\log^{3/2}n}{(\log\log n)^{3/2}}\right)을 보이고, 알려진 상한은 O(\log^{3/2}n)이다. 차이는 (\log\log n)^{3/2} 인자다. Haar projection과 규모별 numerical sparsity 분석을 사용한다는 스케치이며, 이 리뷰가 각 하한 증명을 재구성한 것은 아니다.
6. 긴 초안과 독립 재발견의 증거 수준
Knuth cycles: 길이는 처리 능력의 증거이지 정확성 점수가 아니다
짝수 m의 단순한 국소 규칙이 세 Hamiltonian cycle을 만든다는 것을 보이려면 모든 방향 간선이 정확히 한 번 배정되고 각 색이 m^3개의 정점을 하나의 순환으로 방문함을 보여야 한다. 유한 m≤2000의 계산 검사는 모든 짝수 m에 대한 기호적 증명과 다르다.
논문은 기존 구성과 새 구성에 대해 각각 46쪽·75쪽 proof draft를 보고한다. 앞선 더 복잡한 구성에는 이미 다른 모델을 활용해 얻은 완전한 증명도 있었다고 설명한다. 따라서 이 사례를 Knuth 문제 전체의 최초 해결이라고 쓰지 않는다. 별도 저장소에서 두 proof PDF와 설명 문서의 목록은 확인했지만 전체 증명의 정확성을 독립 확인하지 않았다.
Erdős unit distance: 인터넷 차단은 학습 오염 부재의 증명이 아니다
논문은 Gemini 3.1 Pro에 인터넷 접근을 막고 15라운드 탐색을 실행해, 알려진 돌파구의 중심 구조를 재발견한 22쪽 초안을 얻었다고 보고한다. 새로운 반례를 최초 발견했다는 주장이 아니라 unramified towers·relative unit groups를 이용한 접근의 독립 재발견 사례다. 네트워크 차단은 실행 중 검색을 제한하지만 학습 데이터·초기 입력의 정보 격리를 단독으로 입증하지 않는다.
여기에 중요한 외부 확인이 있다. 공개 Erdős README의 고정 판본은 잘못된 Golod–Shafarevich 공식, 불완전한 van der Corput 논증, 엄밀성 공백을 명시한다. 작성자는 결론을 바꾸지 않고 고칠 수 있다고 판단하지만, 이 리뷰가 수정을 확인한 것은 아니다. 따라서 결함 없는 독립 증명 완성이 아니라, 오류를 포함한 공개 초안에서 중요한 전략 구조를 얻은 사례로 읽는다.
7. TCS-Bench의 점수와 채점기를 함께 읽는다
TCS-Bench는 2020–2026년 FOCS·STOC·SODA 논문에서 가져온 300개 증명 과제다. 필요한 수학 맥락을 주고 자립적인 증명을 요구한다. 채점기는 기준 증명도 읽는 reference-assisted 자동 grader다. 별도의 전문가 라벨 증명 100개로 prompt를 최적화했고 그 집합에서 90% 넘는 정확도를 보고했다. 이를 새 테스트셋에서 독립 검증한 채점 정확도나 모든 자연어 증명의 형식 검증으로 읽지 않는다.
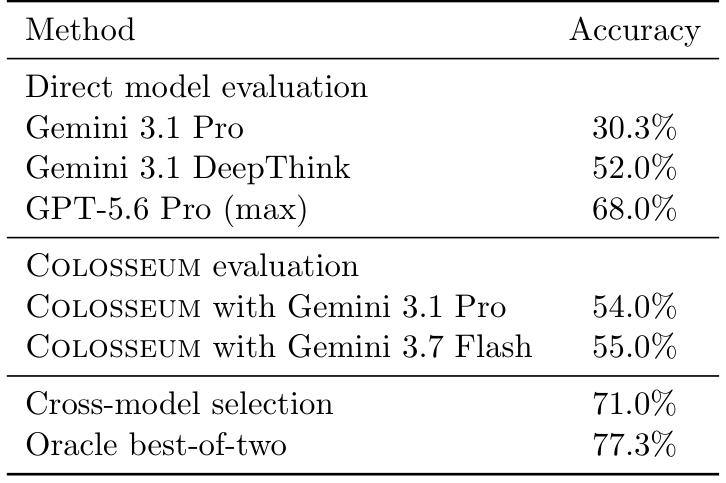
Table 2. 모든 수치는 benchmark grader에 따른 정확도다. 출처: Lin et al. (2026), v1, p. 13, Table 2 — 연구·학습 목적 인용.
| 방법 | 정확도 |
|---|---|
| 직접 평가: Gemini 3.1 Pro | 30.3% |
| 직접 평가: Gemini 3.1 DeepThink | 52.0% |
| 직접 평가: GPT-5.6 Pro (max) | 68.0% |
| Colosseum + Gemini 3.1 Pro | 54.0% |
| Colosseum + Gemini 3.7 Flash | 55.0% |
| 두 실행의 cross-model selection | 71.0% |
| 사후 oracle best-of-two | 77.3% |
같은 Gemini 3.1 Pro 명칭에서 30.3→54.0은 23.7%p 차이다. 그러나 추가 호출·추론·수정 예산을 동일하게 맞춘 실험이 아니므로 특정 모듈의 순수 이득이나 비용 효율로 해석하지 않는다. 71%와 GPT-5.6 Pro의 68%도 3%p 차이의 관측 결과이지 동등 비용에서의 통계적으로 확정된 우월성을 뜻하지 않는다.
8. 두 실행의 상보성을 선택기가 얼마나 회수했는가
71%를 만든 프로토콜은 두 기반 모델을 한 번 호출해 투표하는 것이 아니다.
- 각 문제에서 Colosseum을 Gemini 3.1 Pro와 Gemini 3.7 Flash로 따로 실행한다.
- Gemini 3.7 Flash가 Pro 실행의 증명을 여덟 번 독립 표집해 비평한다.
- 그중 최소 다섯 개가 맞다고 판정하면 Pro 증명을, 아니면 Flash 증명을 제출한다.
- 기준 증명을 보는 benchmark grader는 선택에 개입하지 않고 제출된 증명을 채점한다.
전역 검증은 치명적 반론 중심이라 다수결이 아니지만, 이 실행 간 선택 규칙은 5/8 임계값을 쓴다. 서로 다른 단계이므로 둘을 같은 정책으로 설명하면 안 된다. Flash 후보를 같은 방식으로 대칭 비교하는 절차도 아니다.
표에서 복원할 수 있는 집합 산술
300개 문제의 표시 정확도와 oracle을 정수 건수로 환산하면 Pro 162개, Flash 165개, 두 실행의 합집합 232개다. 77.3%는 232/300의 소수 첫째 자리 반올림과 맞는다. 같은 grader의 이진 판정이라는 전제에서 다음을 얻는다.
| 두 실행의 결과 | 건수 |
|---|---|
| 둘 다 정답 | 162+165−232=95 |
| Pro만 정답 | 67 |
| Flash만 정답 | 70 |
| 둘 다 오답 | 68 |
이것은 표의 집계로부터 얻은 산술이지 원시 로그를 확인한 confusion matrix가 아니다. 선택은 213개를 맞혀 더 좋은 단일 실행 165개보다 48개 늘었다. 여전히 oracle보다 19개 적다. 둘 중 하나만 맞은 137개 중 118개에서 정답 후보를 골랐다는 계산도 가능하지만, 이를 전체 문제에 대한 선택기 정확도나 실제 수학적 검증 정확도로 부르면 안 된다.
비평 신호의 AUC는 0.896, Pro 내부 verifier만으로 routing하면 64.7%라고 보고한다. AUC는 점수의 순위 구별력이지 89.6% 정답률이 아니고, 5/8 임계값에서의 precision·recall도 아니다. 소규모 표본의 문항별 변동, 두 모델의 오염 가능성, 비용·반복 실행 분산을 알 수 없으므로 관측된 상보성과 그 일반화를 분리한다.
9. Codeforces의 숨은 테스트와 실행 피드백을 구분한다
평가는 2025년 4–10월 대회의 clist.by 난도 추정 1500 초과 문제 222개다. 평가 snapshot은 52개 대회, 번호 범위 2084–2162에 걸친다. 난도 추정값의 중앙값은 2381, 범위는 1530–4599다. Codeforces 사이트의 문제 rating과 같은 값이라고 가정하지 않는다.
증명 파이프라인 끝에 C++ 구현을 둔다
프로그램 모듈을 나누는 대신 수학적·알고리즘적 부분문제 DAG를 만든 뒤 마지막 노드에서 C++로 구현한다. Table 4의 2084F 사례는 도달 가능성과 inversion의 동치, Fenwick tree 기반 경계 전파, EDF 스케줄링, 전역 검사, 구현으로 이어진다.
Execution probe는 공개 sample과 모델 생성 stress input으로 컴파일·실행하고 checker 결과·시간·메모리를 기존 검토·수정 루프로 돌려준다. 숨은 테스트는 workflow가 접근하지 않고 최종 채점에만 쓴다. 최종적으로 원래 checker와 전체 hidden test를 모두 통과해야 accepted다. 제출물 그대로 채점해도 같은 결과라는 보고도 있어 사후 output repair로 점수를 올린 결과로 설명하지 않는다.
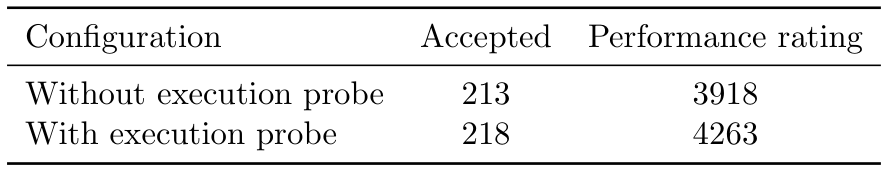
Table 5. 실행 probe뿐 아니라 revision budget도 다른 두 구성이다. 출처: Lin et al. (2026), v1, p. 15, Table 5 — 연구·학습 목적 인용.
| 구성 | 통과 | 통과 비율 | 논문의 corpus rating |
|---|---|---|---|
| Probe 없음 | 213/222 | 약 95.95% | 3918 |
| Probe 있음 | 218/222 | 약 98.20% | 4263 |
| 차이 | +5개 | +2.25%p | +345 |
비율과 차이는 이 글의 계산이다. 저자는 두 arm의 revision budget이 다르고 최종 probe→revision 경로를 독립 검증하지 못했다고 명시한다. 따라서 5개 개선을 probe만의 인과 효과로 주장하지 않는다. 또한 숨은 테스트 통과는 강한 실행 증거지만 모든 가능한 입력에 대한 수학적 증명은 아니다.
4263은 공식 참가자 rating이 아니다
문제 난도 r_i와 실력 x에 대해 논문은 다음 합이 푼 문제 수와 같도록 x를 맞춘다.
\sum_{i=1}^{222}\frac{1}{1+10^{(r_i-x)/400}}=n_{\mathrm{solved}}.이는 특정 corpus와 calibration 규칙의 산출값이다. 실제 대회 제한 시간·제출 횟수·오답 패널티를 같은 조건에서 적용해 얻은 공식 순위가 아니다. 개별 난도 222개가 없이 구간별 개수만으로 4263을 정확히 재계산할 수도 없다. 이 리뷰는 rating의 재현이 아니라 표시 차이 4263−3918=345만 검산했다.
10. 설계의 설득력과 인과적 효과의 입증은 다르다
저자가 명시한 현재 경계
- 모델이 반례를 못 찾았다고 참이 되는 것은 아니다(§4.1.2).
- 폭·표본 수는 호출 총량이 아니며 재시도·부분문제 수에 따라 비용이 달라진다(§4.4).
- 소수 전략이 섞인 집단에서 사라질 수 있어 전략별 clustering을 향후 확장으로 제안한다(§8.1).
- 부분문제 주변의 DAG 재구성, 적응적 추론 배정, 궤적 사후학습은 완료된 핵심 실험과 분리한다.
- Codeforces 두 구성은 probe의 인과 절제가 아니며, rating은 공식 참가자 rating이 아니다.
해설자 관점에서 필요한 추가 증거
같은 계산 예산의 대조군: 많은 후보·반증·합성·두 모델 실행은 서로 다른 비용이다. 총 호출·토큰·시간·금액과 단순 best-of-N, 반복 self-refine의 동일 예산 비교가 없으면 조직 방식의 이득과 더 많은 계산의 이득을 분해하기 어렵다. 특히 readiness gate·중첩 표집·지식 디렉터리 각각의 기여를 평가한 체계적 제거 절제는 제시하지 않는다.
검증의 신뢰성: 모델의 전역 검토, TCS의 reference-assisted grader, Codeforces checker는 다른 판정 체계다. 세 체계의 통과를 같은 ‘증명 완료’로 집계하지 않는다. grader의 전문가 라벨 100개는 prompt 최적화에 쓰였다는 설명이므로 독립 테스트 정확도라고 확대하지 않는다. 실제 벤치마크 출력에 대한 오류 분석·사람 재판정과 비용을 함께 보고할 필요가 있다.
데이터·기억의 경계: 기존 논문과 대회 문제는 학습 노출을 확인해야 하며 인터넷 차단만으로 해결되지 않는다. 반론을 붙여 보존하는 설계는 좋지만, 공유 기억의 판본·의존 주장 철회·후속 결과 무효화가 구현상 어떻게 강제되는지까지 보여 주지는 않는다. 이는 발견한 취약점이 아니라 재현·감사에 필요한 질문이다.
연구 사례의 귀속: 다섯 성과와 세 장문 초안은 서로 다른 성취다. 총 시도 문제 수·실패율·인간의 문제 설정과 수정 기록 없이 모두 완전 자율 발견이라고 부를 수 없다. 특히 공개 Erdős 초안의 결함을 숨기지 않아야 재발견의 가치와 완성된 증명의 신뢰도를 함께 판단할 수 있다.
Colosseum의 강점은 ‘에이전트를 많이 불렀다’는 말보다 구체적이다. 준비되지 않은 전략을 너무 일찍 분해하지 않고, 반론을 후보에서 떼어내지 않으며, 절별 작업과 전체 논증을 다른 단위로 검사한다. 수학적 결과를 조직적으로 만들어 내는 절차의 설득력은 높지만, 모든 구성요소의 효과·비용 효율·오류 없는 증명 보장을 입증한 것은 아니다. TCS의 선택 손실과 공개 초안의 공백을 함께 읽는 것이 이 연구를 가장 유용하게 평가하는 방법이다.
References
Lin, H., Woodruff, D. P., Deng, Y., Mao, J., Zuo, S., & Mirrokni, V. (2026). Stellar Colosseum: A Many-Agent Harness for Long-Horizon Research in Mathematics and Theoretical Computer Science [Preprint]. arXiv. https://arxiv.org/abs/2609.15983v1
원문이 연결하는 다섯 연구 성과: 아래 중 Hadamard·임베딩 하한 논문은 초록을 추가 확인했다. 나머지 결과 설명은 대상 논문 §§5.1–5.5를 따른다. 동반 논문의 전체 증명 독립 검증 목록이 아니다.
- Strong coresets: https://arxiv.org/abs/2608.26047
- Sparse least squares: https://arxiv.org/abs/2608.02588
- Maximum inner-product embedding lower bounds: https://arxiv.org/abs/2607.20393
- Hadamard quantization: https://arxiv.org/abs/2608.02564
- Prefix-matrix factorizations: https://arxiv.org/abs/2608.08238
추가 확인 자료: Erdős README revision c4e83e4921f1dc8418097632f8a1bc0f9ff82b03의 오류 공지와 Knuth 저장소의 파일 목록. TCS-Bench·Antigravity·선행 논문의 전체 구현이나 모든 공개 증명을 감사하지 않았다.