DynaFlow: Learning Free-Form Multi-Agent Orchestration
DynaFlow 쉬운 읽기
메인 에이전트가 협업이 필요한지 스스로 정하고 질문마다 JavaScript 작업 흐름을 짜도록, 하위 에이전트는 고정한 채 메인 에이전트만 두 단계로 학습한 DynaFlow를 설명합니다. 여섯 벤치마크 결과와 진 설정, 학습 전후 작업 흐름의 변화를 함께 봅니다.
Paper: Ruhao Liu; Qi Li; Shizun Wang; Xinchao Wang (2026). "DynaFlow: Learning Free-Form Multi-Agent Orchestration". arXiv preprint, arXiv:2610.34467v2 [cs.MA], 2026-10-29 (v1 2026-10-25). 원문 · PDF.
판본: arXiv:2610.34467v2, 2026-10-29, 20쪽 읽기 버전: 2026-11-01
1. 협업 방식을 미리 정해 두면 생기는 문제
여러 LLM 에이전트가 함께 문제를 푸는 **multi-agent system(다중 에이전트 시스템)**은 대개 역할과 대화 순서를 사람이 미리 정해 둡니다. 하지만 과제마다 필요한 협업은 다릅니다. 쉬운 질문은 에이전트 하나로 충분하고, 서로 독립인 하위 과제는 동시에 돌리는 편이 낫고, 앞 단계 결과에 기대는 단계는 그 결과를 정확히 넘겨받아야 합니다. 정해 둔 구조를 모든 질문에 쓰면 불필요한 통신과 계산이 생깁니다.
DynaFlow는 이 판단을 **main agent(메인 에이전트)**에게 맡깁니다. 메인 에이전트가 협업이 필요한지 스스로 정하고, 필요하면 그 질문에 맞는 작업 흐름을 직접 짭니다. 저자들은 이 능력을 **Free Orchestration(자유 형식 조율)**이라고 부릅니다.
2. 작업 흐름을 JavaScript 프로그램으로 씁니다
메인 에이전트가 할 수 있는 행동은 세 가지입니다. 바로 답하기, 일반 도구 부르기, 그리고 workflow(작업 흐름) 프로그램을 써서 실행하기입니다. 작업 흐름은 JavaScript로 씁니다. agent(...)로 **sub-agent(하위 에이전트)**에게 일을 맡기고, parallel(...)로 여러 일을 동시에 돌리며, 앞 단계의 출력을 변수로 받아 다음 단계의 지시에 넣습니다. 하위 에이전트는 프로그램이 넘겨준 지시와 입력만 보고, 메인 에이전트의 대화 기록은 자동으로 물려받지 않습니다.
프로그램이 끝나면 출력과 함께 하위 에이전트마다 무엇을 받고 무엇을 냈는지 적힌 **실행 기록(trace)**이 돌아옵니다. 메인 에이전트는 이를 보고 답을 내거나, 결과가 불완전하거나 서로 모순되면 작업 흐름을 고쳐 다시 실행합니다.
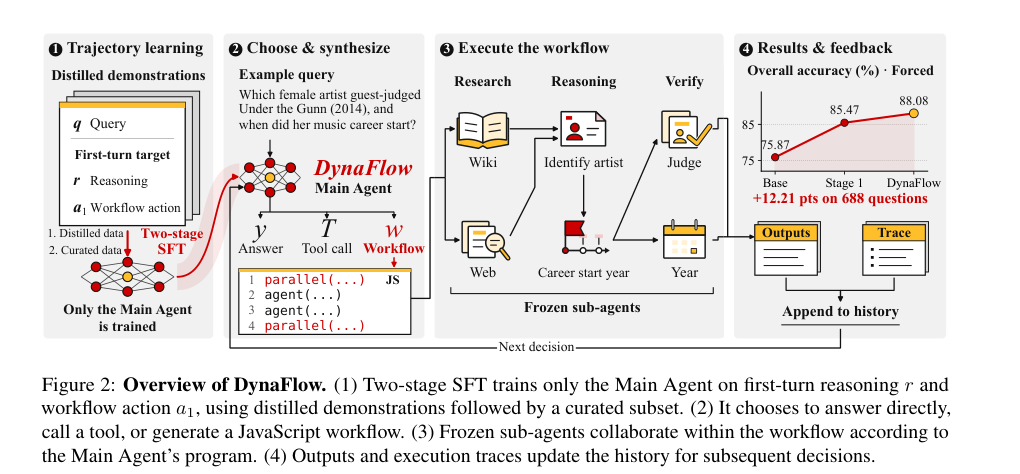
원 논문 Figure 2(논문 PDF 2쪽): ① 메인 에이전트만 두 단계로 학습하고, ② 메인 에이전트가 직접 답할지·도구를 부를지·JavaScript 작업 흐름을 쓸지 고르며, ③ 고정된 하위 에이전트들이 프로그램대로 조사·추론·검증을 나눠 맡고, ④ 출력과 실행 기록이 다음 결정의 입력이 됩니다. 원문 PDF에서 보기.
평가는 세 가지 방식으로 합니다. Direct는 도구와 작업 흐름 없이 답하고, Dynamic은 첫 결정에서 바로 답할지 작업 흐름을 쓸지 고르며, Forced는 처음에 반드시 작업 흐름을 실행합니다. 작업 흐름을 쓰면 메인 에이전트는 문제를 직접 풀지 않고 조율과 요약만 맡습니다.
3. 메인 에이전트만 두 단계로 가르칩니다
하위 에이전트는 모두 학습하지 않은 Qwen3.5-27B 그대로 고정합니다. 학습은 같은 Qwen3.5-27B로 만든 메인 에이전트에만 하며, 학습 대상은 첫 턴의 추론과 첫 작업 흐름 프로그램입니다. 이렇게 하면 성능 변화를 '조율을 잘하게 된 효과'로 볼 수 있습니다.
- Stage 1(시연 따라 하기): 교사 모델 GLM-5.3 Max가 같은 도구와 하위 에이전트로 문제를 풉니다. 정답을 맞히고 실질적 풀이를 작업 흐름 안에서 한 궤적 2,257개를 HotpotQA와 BrowseComp에서 모아 학습합니다.
- Stage 2(좋은 시연만 다시 학습): Stage 1 모델에서 세 가지 실수가 반복됐습니다. 근거 없는 답을 전제로 깔아 버리는 premise injection(전제 주입), 검증자를 기대한 답 쪽으로 이끄는 지시, 앞 단계 결과가 다음 단계에 제대로 전달되지 않는 정보 흐름 결함입니다. LLM 판정기가 질문과 프로그램만 보고 이런 결함이 없는 시연 712개를 골랐고, Stage 1 모델을 이것으로 더 작은 학습률로 이어서 학습합니다.
학습은 4비트 QLoRA로 H100 두 장에서 Stage 1 약 52, Stage 2 약 17 GPU-시간이 들었습니다.
4. 여섯 벤치마크에서 가장 높았습니다
평가는 AIME 2024·2025·2026(각 30문항), 다국어 수학 PolyMATH(200), 과학 객관식 GPQA-Diamond(198), 웹 검색을 쓰는 다단계 질의응답 HotpotQA(200), 모두 688문항입니다. 비교하는 모든 방법은 같은 Qwen3.5-27B를 씁니다.
| 방법 | AIME24 | AIME25 | AIME26 | PolyMATH | GPQA-D | HotpotQA | 전체 |
|---|---|---|---|---|---|---|---|
| CoT | 96.67 | 93.33 | 86.67 | 83.00 | 85.35 | 46.50 | 74.27 |
| Self-Refine | 96.67 | 93.33 | 93.33 | 87.50 | 88.38 | 48.00 | 77.18 |
| AFlow | 93.33 | 96.67 | 100.00 | 86.00 | 87.37 | 47.00 | 76.45 |
| Base + 웹 검색 | 83.33 | 73.33 | 73.33 | 66.00 | 79.80 | 77.50 | 74.71 |
| Base, Forced | 76.67 | 70.00 | 70.00 | 70.00 | 77.78 | 81.50 | 75.87 |
| DynaFlow, Dynamic | 93.33 | 100.00 | 96.67 | 91.50 | 83.84 | 84.50 | 87.94 |
| DynaFlow, Forced | 100.00 | 100.00 | 100.00 | 90.50 | 84.85 | 83.50 | 88.08 |
단위는 정확도(%)이고, 전체는 688문항을 한꺼번에 센 정답률입니다. 원문 Table 1의 일부 행만 옮겼습니다. DynaFlow Forced는 88.08%로 가장 강한 비교 방법 Self-Refine(77.18%)보다 10.90퍼센트포인트 높았고, AIME 90문항을 모두 맞혔습니다. HotpotQA에서는 웹 검색을 쓰는 Base(77.50%)보다 6–7점 높았습니다. 다만 검색을 쓰지 않는 CoT·Self-Refine과는 검색 권한이 다르므로 HotpotQA 수치를 같은 조건으로 비교할 수 없습니다.
GPQA-Diamond에서는 졌습니다. Self-Refine 88.38, AFlow 87.37, CoT-SC 85.86, CoT 85.35가 모두 DynaFlow Forced 84.85보다 높았습니다.
5. 학습 없이 쓰는 작업 흐름은 오히려 손해였습니다
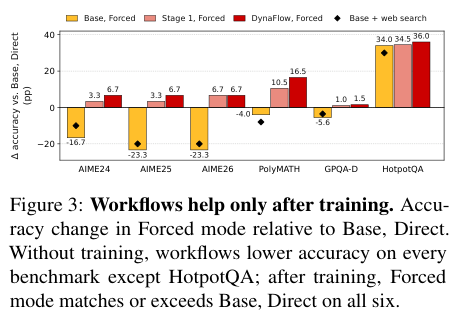
원 논문 Figure 3(논문 PDF 5쪽): 학습하지 않은 모델이 그냥 답할 때(Base, Direct)를 0으로 두고, 작업 흐름을 강제했을 때의 정확도 변화를 퍼센트포인트로 보여 줍니다. 노란 막대(학습 전)는 HotpotQA를 뺀 모든 벤치마크에서 아래로 내려가고, 학습 뒤(빨간 막대)에는 여섯 개 모두 0 이상입니다. 원문 PDF에서 보기.
학습 전 모델에게 작업 흐름을 강제하면 AIME에서 16.7–23.3점이 떨어졌습니다. HotpotQA만 작업 흐름이 웹 검색을 가능하게 해 34.0점 올랐습니다. 학습 단계별 전체 정확도는 다음과 같습니다.
| 메인 에이전트 | Direct | Dynamic | Forced |
|---|---|---|---|
| Base | 71.51 | 65.12 | 75.87 |
| Stage 1 | 76.74 | 84.45 | 85.47 |
| DynaFlow (Stage 2) | 77.18 | 87.94 | 88.08 |
혼자 답하는 Direct는 학습해도 거의 그대로이지만, 작업 흐름을 쓰는 두 방식은 크게 올랐습니다. 하위 에이전트는 그대로이므로 저자들은 이 상승을 메인 에이전트가 조율을 배운 효과로 해석합니다.
6. 학습 뒤 작업 흐름의 모양이 바뀌었습니다
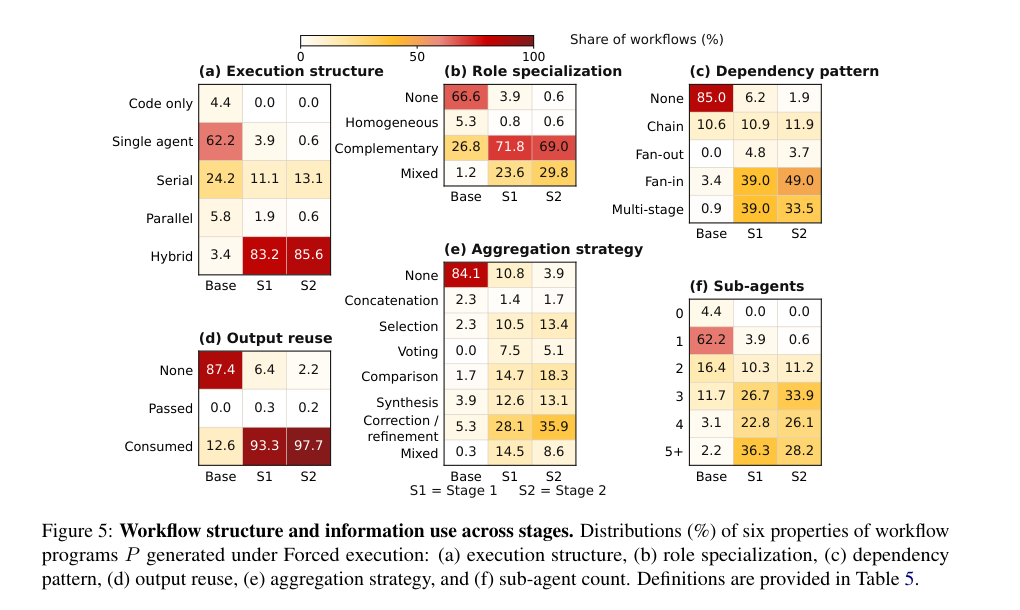
원 논문 Figure 5(논문 PDF 7쪽): Forced 모드에서 만든 작업 흐름의 여섯 가지 특성 분포(%)를 학습 전(Base), Stage 1(S1), Stage 2(S2)로 비교합니다. 칸이 진할수록 비율이 높습니다. 원문 PDF에서 보기.
학습 전에는 62.2%가 하위 에이전트 하나에 일을 통째로 넘겼습니다. 학습 뒤에는 병렬과 순차 단계를 섞은 구조가 85.6%가 되었습니다. 앞 단계 출력을 넘기고 그것을 쓰라고 명시하는 프로그램은 12.6%에서 97.7%로 늘었습니다. Stage 2에서는 심각한 정보 흐름 결함이 1.9%에서 0.9%로 줄고, 하위 에이전트 수도 평균 4.35개에서 4.16개로 줄었습니다. 이 품질 점수는 실행 결과 없이 판정 모델이 프로그램만 보고 매긴 값입니다. 과제별로도 달라서 HotpotQA에서는 조사 역할이 59.6%였고, 수학에서는 풀이와 검증이 90% 넘게 차지했습니다.
7. 필요할 때만 협업합니다
학습 전에는 Dynamic(65.12%)이 Forced보다 10.75점 낮았습니다. 학습 뒤 이 차이는 0.14점으로 줄었습니다. DynaFlow Dynamic은 질문의 47.1%를 작업 흐름 없이 바로 답하면서도 87.94%를 얻었고, 질문당 하위 에이전트는 평균 2.44개로 Forced(약 4.16개)보다 약 41% 적었습니다. 저자들은 에이전트를 늘린다고 성능이 오르는 것이 아니며, 협업은 질문마다 필요할 때 불러야 한다고 봅니다.
8. 저자가 밝힌 한계와 다음 과제
- GPQA-Diamond 실패 사례에서는 하위 에이전트의 잘못된 중간 결론이 이후 검증을 그르치거나, 올바른 중간 결과가 검증과 최종 종합 단계에서 묻히거나 덮어써졌습니다. 메인 에이전트가 최종 답을 고를 때 맞는 증거를 우선하지 못한 경우입니다.
- 하위 에이전트는 학습하지 않았습니다. 저자들은 정보 전달과 독립 검증을 믿을 수 있게 하위 에이전트도 학습하는 것을 다음 과제로 듭니다.
- 학습은 첫 턴만 감독합니다. 저자들은 불일치와 오류가 섞인 여러 턴의 궤적으로 확장해, 충돌하는 출력을 평가하고 작업 흐름을 고치는 능력을 가르치는 것을 제안합니다.
- 저자들은 Stage 2의 효과가 선별 때문인지 추가 학습 때문인지 가르려면 같은 크기의 무작위 부분집합으로 이어 학습하는 비교가 필요하다고 적습니다.
DynaFlow의 핵심은 하위 에이전트를 바꾸지 않고, 언제 협업할지와 어떻게 일을 나누고 결과를 이어 붙일지를 메인 에이전트에게 가르쳤다는 점입니다.
References
Liu, R., Li, Q., Wang, S., & Wang, X. (2026). DynaFlow: Learning free-form multi-agent orchestration (Version 2, arXiv:2610.34467) [Preprint]. arXiv. https://arxiv.org/abs/2610.34467v2