DynaFlow: Learning Free-Form Multi-Agent Orchestration
DynaFlow는 메인 에이전트에게 자유 형식 워크플로 작성을 어떻게 학습시키는가?
메인 에이전트가 협업이 필요한지 스스로 정하고 질문마다 JavaScript 작업 흐름을 짜도록, 하위 에이전트는 고정한 채 메인 에이전트만 두 단계로 학습한 DynaFlow를 설명합니다. 여섯 벤치마크 결과와 진 설정, 학습 전후 작업 흐름의 변화를 함께 봅니다.
Paper: Ruhao Liu; Qi Li; Shizun Wang; Xinchao Wang (2026). "DynaFlow: Learning Free-Form Multi-Agent Orchestration". arXiv preprint, arXiv:2610.34467v2 [cs.MA], 2026-10-29 (v1 2026-10-25). 원문 · PDF.
요약
| 항목 | 논문이 보고한 내용 |
|---|---|
| 문제 | 미리 정한 협업 구조는 과제마다 다른 요구(단일 에이전트로 충분한 질문, 독립 하위 과제, 상류 결과에 의존하는 단계)에 맞지 않는다. |
| 방법 | 메인 에이전트의 행동 공간에 JavaScript 워크플로 프로그램 작성·실행을 포함한다. 실행 결과와 trace가 다음 행동의 입력이 된다. 서브 에이전트는 모두 고정하고 메인 에이전트만 2단계 SFT로 학습한다. |
| 학습 | Stage 1은 교사 모델이 만든 2,257개 첫 턴 시연, Stage 2는 premise injection·verification defect·information-flow defect가 없는 712개 부분집합이다. |
| 평가 | AIME 2024/2025/2026, PolyMATH, GPQA-Diamond, HotpotQA의 688문항. 모든 시스템은 Qwen3.5-27B를 쓴다. |
| 헤드라인 | Forced 모드 전체 정확도 88.08%, Dynamic 모드 87.94%. 가장 강한 baseline인 Self-Refine(77.18%)보다 10.90 percentage point 높다. |
| 모드 간 격차 | Dynamic–Forced 격차는 Base 10.75, Stage 1 1.02, DynaFlow 0.14 percentage point로 줄어든다. Dynamic은 질문의 47.1%를 워크플로 없이 직접 답한다. |
| 논문이 보고한 열위 결과 | GPQA-Diamond에서는 Self-Refine(88.38), AFlow(87.37), CoT-SC(85.86), CoT(85.35)가 DynaFlow Forced(84.85)보다 높다. 학습 전 Base, Forced는 HotpotQA를 제외한 모든 벤치마크에서 Base, Direct보다 낮다. |
| 저자 논의 | GPQA-Diamond 실패 사례에서 올바른 중간 결과가 검증과 최종 종합 단계에서 손실되거나 덮어써진다. 서브 에이전트 학습과 다중 턴 시연이 향후 과제로 제시된다. |
목차
- 문제 설정과 동기
- 메인 에이전트의 행동 공간과 실행 모드
- 워크플로 프로그램, 런타임, 실행 trace
- 2단계 SFT: 시연 증류와 품질 선별
- 벤치마크, baseline, 평가 설정
- 주요 결과
- 학습 단계 × 실행 모드
- 워크플로 구조와 정보 흐름
- 적응적 워크플로 호출과 사례 연구
- 저자 논의와 결론
1. 문제 설정과 동기
1.1 고정된 협업 구조의 한계
논문은 LLM 기반 multi-agent system(MAS)의 효과가 협업 방식에 달려 있다고 보고, 기존 시스템 다수가 사전에 설계한 에이전트 역할, 통신 패턴, 워크플로 구성 요소에 의존한다고 설명한다. 그러나 과제 요구는 서로 다르다. 단순한 질문은 에이전트 하나로 충분할 수 있고, 독립적인 하위 과제는 병렬 실행의 이점이 있으며, 의존 관계가 있는 단계는 상류 결과에 신뢰성 있게 접근해야 한다. 고정 구조를 모든 상황에 적용하면 불필요한 통신, 지연, 계산이 생길 수 있다는 것이 저자들의 출발점이다.
저자들은 이 문제에 대해 Free Orchestration이라는 능력을 제안한다. 협업이 유용한지를 스스로 판단하고, 문제 해결 도중에 과제별 워크플로를 구성하는 능력이다.
1.2 기존 접근과 논문의 위치
논문 §1과 §2는 관련 연구를 다음처럼 구분한다.
| 계열 | 논문이 든 예 | 논문의 서술 |
|---|---|---|
| 실행 피드백으로 워크플로 탐색 | AFlow (J. Zhang et al., 2025) | 실행 피드백으로 효과적 워크플로를 탐색한다. |
| 질의별 시스템 생성 | 지도학습 MAS-GPT(Ye et al., 2025), 강화학습 FlowReasoner(Gao et al., 2025)·MAS-Orchestra(Ke et al., 2026) | MAS-Orchestra는 전체 조정 구조를 중간 실행 결과를 보지 않고 한 번의 결정으로 생성한다. |
| 실행 피드백 기반 재계획 | MAS-Zero(Ke et al., 2025), DyFlow(Y. Wang, Xu, et al., 2025) | DyFlow는 유한한 operator template 집합에서 계획을 구성한다. |
| 그래프 편집·공동 학습 | FlowSteer(M. Zhang et al., 2026), MetaAgent-X(Y. Zhang et al., 2026) | FlowSteer는 canvas 피드백으로 graph-editing 정책을 학습하고, MetaAgent-X는 설계자와 실행자를 함께 학습한다. |
논문은 이러한 접근들이 워크플로 구성과 적응에 여전히 제약을 남긴다고 정리한다.
DynaFlow는 자유 형식 실행 가능 워크플로 합성을 일반 tool 사용과 나란히 놓인 작업 수행 에이전트 자신의 네이티브 행동으로 둔다. 같은 에이전트가 (i) 협업할 시점을 정하고, (ii) 과제별 프로그램을 구성하며, (iii) 반환된 출력과 trace로 다음 진행을 결정한다. 학습 측면에서는 정답 여부만이 아니라 오케스트레이션 품질을 시연 선별 기준으로 삼고, 서브 에이전트는 학습하지 않는다.
1.3 논문의 기여 주장
논문 서론의 요지는 다음과 같다.
- 워크플로 합성을 메인 에이전트의 행동 공간에 통합하고 실행 피드백을 다음 결정에 연결한다.
- 메인 에이전트만 학습한다. 증류 시연으로 시작한 뒤 premise injection, 편향된 검증, 불완전한 정보 전달이 표시된 시연을 제외한 부분집합으로 이어서 학습한다.
- 학습 전후 워크플로를 구조와 정보 사용 지표로 분석하고 Direct·Dynamic·Forced 모드를 비교한다.
2. 메인 에이전트의 행동 공간과 실행 모드
2.1 세 가지 행동 형태
질문 q와 과제 지시 I가 주어지면 메인 에이전트는 정책 \pi_\theta를 따르며 행동 공간은 다음과 같다(논문 식 1).
\mathcal{A} = \mathcal{A}_{\text{tool}} \cup \{A_{\text{ans}}, (P, W(P))\}여기서 \mathcal{A}{\text{tool}}은 일반 tool 호출, A{\text{ans}}는 최종 답변 출력, (P, W(P))는 메인 에이전트가 합성한 JavaScript 프로그램 P와 workflow tool W를 통한 호출이다. 답변 내용과 일반 tool의 인자는 해당 행동과 함께 생성되며 식에서는 생략된다. 턴 k에서 행동은 a_k \sim \pi_\theta(\cdot \mid I, q, h_{k-1})로 샘플링되고, h_{k-1}은 이전 행동과 관찰의 순서 있는 이력이다.
2.2 피드백 루프
Algorithm 1은 다음 절차다. 첫 행동 a_1을 샘플링한 뒤, a_k \neq A_{\text{ans}}인 동안 반복한다. 행동이 워크플로이면 o_k \leftarrow W(P)를 실행하고, 일반 tool이면 o_k \leftarrow \text{Tool}(a_k)를 실행한다. (a_k, o_k)를 이력에 덧붙이고 다음 행동을 샘플링하며, 답변 행동이 나오면 종료한다. 메인 에이전트는 가용 정보가 충분하다고 판단할 때만 A_{\text{ans}}를 내고, 그렇지 않으면 tool이나 워크플로로 결과를 검증·정제·확장한다.
2.3 Direct, Dynamic, Forced
논문은 세 가지 실행 모드를 평가한다.
| 모드 | 정의 |
|---|---|
| Direct | tool이나 워크플로 없이 답한다. |
| Dynamic | 첫 결정에서 직접 답변과 워크플로 호출 중 하나를 고른다. |
| Forced | 첫 번째 실질적 행동이 반드시 워크플로 호출이어야 한다. 초기 라우팅 결정 없이 워크플로 구성 능력을 평가한다. |
Dynamic과 Forced 모두 이후의 tool 호출과 후속 워크플로를 허용한다. 워크플로가 호출되면 메인 에이전트는 조정과 요약으로 제한되고, 실질적 문제 풀이는 서브 에이전트에게 위임된다. 부록 F의 Forced 프롬프트는 메인 에이전트가 계획, 실행, 모니터링, 수정, 결과 평가, 최종 답변 요약만 할 수 있고, 첫 추론 턴에서도 답을 직접 도출하거나 서브 에이전트에게 미리 푼 답을 넘겨서는 안 된다고 명시한다. 완료 상태만으로는 충분하지 않으며 필요한 하위 과제가 결과를 반환하지 않았다면 실행을 미완료로 보고 워크플로를 수정하거나 다시 실행해야 한다.
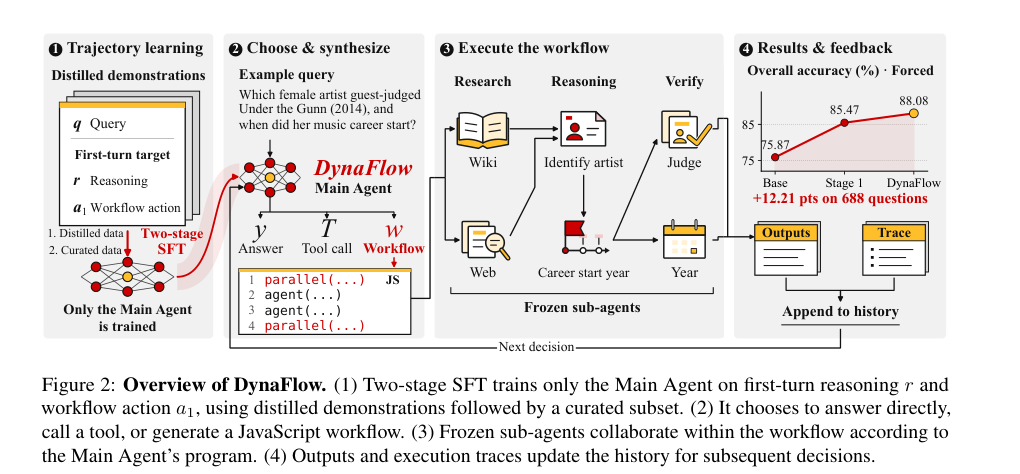
그림 1. DynaFlow 개요. (1) 2단계 SFT가 첫 턴 추론 r과 워크플로 행동 a_1로 메인 에이전트만 학습하고, (2) 직접 답변·tool 호출·JavaScript 워크플로 생성 중에서 선택하며, (3) 고정된 서브 에이전트가 프로그램에 따라 협업하고, (4) 출력과 실행 trace가 이력을 갱신한다. 출처: Liu, Li, Wang, & Wang (2026), DynaFlow, arXiv:2610.34467v2, Figure 2, PDF p.2. 연구·학습 목적 인용.
3. 워크플로 프로그램, 런타임, 실행 trace
3.1 프로그램이 정의하는 것
프로그램 P는 agent 호출, 병렬 실행, 선택적 phase 라벨로 서브 에이전트의 역할, 단계, 의존성을 정의한다. 독립 호출은 동시에 실행되고, 의존 호출은 상류 출력을 명시적으로 받는다. 각 서브 에이전트는 P가 지정한 지시와 입력만 받으며, 메인 에이전트의 상호작용 이력은 자동으로 상속되지 않는다. 호출은 JSON schema로 구조화된 출력을 요청할 수 있다.
3.2 실행 primitive
부록 B와 F는 인터페이스를 다음처럼 기술한다.
| primitive | 역할 |
|---|---|
agent(prompt, options) |
서브 에이전트를 시작하고 최종 텍스트를 반환한다. JSON schema가 있으면 검증된 객체를 반환한다. |
parallel(thunks) |
호출들을 동시에 실행하고 결과를 기다린다. |
pipeline(items, stages...) |
각 항목을 의존 단계들로 처리하며 무관한 항목을 기다리지 않는다. |
phase(title) |
단계 라벨을 붙인다. |
args |
호출 입력을 노출한다. |
상류 출력의 전달과 변환은 일반 JavaScript로 비동기 문맥에서 수행한다. 각 스크립트는 name과 description을 담은 literal meta 객체로 시작하고 선택적으로 phase를 기술한다. 도구는 script 또는 저장된 프로그램의 scriptPath, 선택적 args로 호출하며, 백그라운드로 실행을 시작해 task identifier를 반환하고 완료 알림이 프로그램의 반환 결과를 전달한다.
3.3 실행 trace와 피드백
워크플로 tool은 고정된 서브 에이전트로 자원 제약 안에서 P를 실행한다. 관찰 o_k = W(P)는 프로그램 출력과, 각 서브 에이전트 호출의 상태와 출력을 기록한 실행 trace를 합친 것이다. 메인 에이전트는 이 관찰로 워크플로를 수정하거나 최종 답을 낸다. 결과 처리 지침은 워크플로의 문제 풀이를 메인 에이전트가 중복 수행하지 말고, 결과가 불완전하거나 불확실하거나 증거와 모순되면 워크플로를 수정·재실행하며, 워크플로를 쓸 수 없거나 완료할 수 없으면 실패를 보고하라고 규정한다.
3.4 서브 에이전트는 고정
모든 DynaFlow 평가 설정에서 워크플로 서브 에이전트는 오케스트레이션 학습을 받지 않은 Base Qwen3.5-27B 체크포인트이며 고정된다. 메인 에이전트와 서브 에이전트 모두 thinking을 켠다. 이 설계로 오케스트레이션 학습과 실행자 능력 향상이 분리되고, 사전학습 모델을 재학습 없이 실행자로 재사용할 수 있다고 저자들은 설명한다.
4. 2단계 SFT: 시연 증류와 품질 선별
4.1 학습 목표
두 단계 모두 같은 SFT 목적을 최소화한다(논문 식 2).
\mathcal{L}_{\text{SFT}}(\theta; D) = -\sum_{(I, q, s) \in D} \log \pi_\theta(r, a_1 \mid I, q)감독 대상 s = (r, a_1)은 메인 에이전트의 첫 턴 출력으로, r은 추론 토큰, a_1 = (P, W(P))는 워크플로 행동이다. 지시, 질문, tool 정의는 loss에서 마스킹된다. 즉 감독은 첫 턴의 과제 분석과 워크플로 합성을 겨냥한다.
4.2 Stage 1: 궤적 증류
교사 모델이 같은 워크플로 인터페이스, tool, 고정 서브 에이전트로 궤적을 만든다. 최종 답이 맞고 논문 §3.1의 위임 규약(실질적 풀이는 워크플로 안에서 수행)을 따르는 궤적만 유지해 데이터셋 D_1을 얻는다. 교사 모델은 GLM-5.3 Max이다. 부록 C에 따르면 Stage 1 학습 세트는 HotpotQA와 BrowseComp에서 얻은 2,257개 첫 턴 시연이다.
4.3 Stage 2: 고품질 데이터 선별
Stage 1 시연은 정답 정확성과 실행 규약 기준을 충족하지만 오케스트레이션 품질은 제각각이다. Stage 1 모델 평가에서 저자들은 정보 전달 실패와 메인 에이전트의 잘못된 판단이 워크플로를 오답으로 이끌 수 있음을 관찰했다. LLM judge는 질문 q와 프로그램 P를 보고 세 종류의 결함을 점검한다.
| 결함 | 정의 |
|---|---|
| Premise injection | 메인 에이전트가 과제 주어진 정보를 넘어서는 답 결정적 주장을 확립된 전제로 제시한다. |
| Verification defect | 검토 지시나 출력 제약이 검증자를 기대 답 쪽으로 유도하거나, 독립적 확인·수정을 제한한다. 검토 단계가 있을 때만 평가한다. |
| Information-flow defect | 누락된 문맥, 잘못된 참조, 손실 있는 전달, 상류 출력을 대체한 하드코딩 값 때문에 필요한 정보가 하류 에이전트에 도달하지 못한다. |
보고된 결함은 프로그램 또는 launch argument의 해당 발췌문으로 뒷받침되어야 한다. 이 증거 확인을 통과한 완전한 첫 턴 예시만 유지하며, 선별 절차 J에 대해
D_2 = J(D_1) \subseteq D_1이다(논문 식 3). 부록 E에 따르면 judge는 thinking을 켠 deepseek-flash(high reasoning effort, temperature 0)이고, 질문, 첫 턴 워크플로 프로그램, launch argument만 받는다. 메인 에이전트의 추론, 최종 답, 정답, 실행 결과는 받지 않는다. 2,257개 중 712개가 남는다. Stage 2는 Stage 1 체크포인트에서 같은 목적함수와 더 작은 learning rate로 D_2에 대해 이어서 학습한다.
본문 §3.2는 curation 효과와 추가 학습 효과를 구분하려면 동일 크기 무작위 부분집합으로 이어 학습하는 대조가 필요하다고 적는다.
4.4 학습 설정
| 항목 | Stage 1 | Stage 2 |
|---|---|---|
| 학습 예시 수 | 2,257 | 712 (HotpotQA 449 + BrowseComp 263) |
| Learning rate | 5 \times 10^{-5} |
1 \times 10^{-5} |
| Epoch | 2 | 2 |
| 공통 | LoRA rank/α/dropout 16/32/0, fused AdamW, cosine schedule/warmup 0.05, effective batch size 4, max sequence length 67,584, seed 42 | 동일 |
학습은 ms-swift 4.6.0.dev0, 4-bit NF4 QLoRA(Dettmers et al., 2023), double quantization, BF16 계산, gradient checkpointing으로 수행한다. Qwen3.5-27B의 학습 가능 파라미터는 116,727,808개이고, LoRA는 eligible linear layer를 all-linear로 지정하며 visual encoder와 alignment module은 고정한다. 별도 validation split은 없다. 각 단계는 NVIDIA H100 80GB 두 장에서 실행되고 전체 job wall-clock 기준 Stage 1은 약 52, Stage 2는 약 17 GPU-hours로 합계 약 69 GPU-hours이다(교사 궤적 생성, 평가, LLM 판정은 제외).
5. 벤치마크, baseline, 평가 설정
5.1 벤치마크
| 벤치마크 | 문항 수 | 특징 |
|---|---|---|
| AIME 2024 / 2025 / 2026 | 각 30 | 정수 답 |
| PolyMATH (Y. Wang, Zhang, et al., 2025) | 200 | 다국어 수학, 자유 형식 답. seed 42로 샘플링 |
| GPQA-Diamond (Rein et al., 2024) | 198 | 객관식 과학 문항(생물·화학·물리) |
| HotpotQA (Yang et al., 2018) | 200 | 다중 홉 QA, 웹 검색 사용. seed 42로 샘플링 |
합계는 688문항이다. 메인 에이전트의 backbone은 Qwen3.5-27B이다.
5.2 체크포인트와 모드
비교하는 메인 에이전트 체크포인트는 Base(오케스트레이션 학습 없음), Stage 1(궤적 증류), DynaFlow(Stage 2까지 학습)이고, 각각을 Direct·Dynamic·Forced 모드로 평가한다.
5.3 Baseline
| 방법 | 설명 |
|---|---|
| CoT | 단일 에이전트 chain-of-thought |
| CoT-SC | 샘플링한 답 5개를 집계(X. Wang et al., 2023) |
| Self-Refine | 답을 반복적으로 비평하고 수정(Madaan et al., 2023) |
| AFlow | 공개된 MATH 워크플로를 AIME와 PolyMATH에, 공개된 HotpotQA 워크플로를 HotpotQA와 GPQA-Diamond에 이식. 평가 과제에서 새 워크플로 탐색은 하지 않음 |
| Base + Web search | 검색 의존 문항의 이득을 맥락화하기 위한 비교 |
모든 baseline은 Qwen3.5-27B를 쓴다. tool을 쓰지 않는 baseline은 워크플로 설정과 같은 검색 접근이 없으므로 저자들은 HotpotQA 결과를 검색 가능한 시스템과의 비교와 분리해 해석한다고 밝힌다.
5.4 지표와 디코딩
정확도는 최종 답 기준이며 유효한 최종 답 없이 끝난 실행은 오답으로 센다. Overall은 688문항 전체의 micro-average이다. DynaFlow의 예측은 메인 에이전트의 FINAL ANSWER 줄에서 추출하며 중간 추론이나 서브 에이전트 출력으로 대체하지 않는다. AIME는 선행 0을 정규화한 정수 일치, GPQA-Diamond는 선택지 라벨 일치, PolyMATH는 정확한 수학적 동치, HotpotQA는 참조 개체·관계를 식별하는 동등한 이름과 별칭을 허용한다.
| 파라미터 | 값 |
|---|---|
| 메인 에이전트 context length / 최대 출력 토큰 | 131,072 / 81,920 |
| Temperature / top-p / top-k | 1.0 / 0.95 / 20 |
| Presence penalty / seed | 1.5 / 42 |
| 서브 에이전트 최대 출력 토큰 | 65,536 |
워크플로 설계 품질은 deepseek-flash(thinking, high reasoning effort, temperature 0)가 질문과 프로그램만 보고 실행 결과 없이 평가한다. 기준은 task consistency, decomposition appropriateness, logical continuity, information-flow correctness이며 각각 0(중대한 결함), 1(경미한 약점), 2(결함 없음)로 채점한다. 관련 의존성이 없어 구조적으로 해당되지 않는 logical-continuity와 information-flow 평가는 2로 매핑하고, 증거 부족 평가는 제외한다.
6. 주요 결과
6.1 Table 1: 전체 비교
아래 값은 모두 논문 Table 1의 보고 수치다(정확도 %, Qwen3.5-27B).
| 방법 | AIME24 | AIME25 | AIME26 | PolyMATH | GPQA-D | HotpotQA | Overall |
|---|---|---|---|---|---|---|---|
| CoT | 96.67 | 93.33 | 86.67 | 83.00 | 85.35 | 46.50 | 74.27 |
| CoT-SC | 90.00 | 93.33 | 96.67 | 84.50 | 85.86 | 50.50 | 76.16 |
| Self-Refine | 96.67 | 93.33 | 93.33 | 87.50 | 88.38 | 48.00 | 77.18 |
| AFlow | 93.33 | 96.67 | 100.00 | 86.00 | 87.37 | 47.00 | 76.45 |
| Base, Direct | 93.33 | 93.33 | 93.33 | 74.00 | 83.33 | 47.50 | 71.51 |
| Base + Web search | 83.33 | 73.33 | 73.33 | 66.00 | 79.80 | 77.50 | 74.71 |
| Base, Dynamic | 63.33 | 63.33 | 73.33 | 64.00 | 77.78 | 53.00 | 65.12 |
| Base, Forced | 76.67 | 70.00 | 70.00 | 70.00 | 77.78 | 81.50 | 75.87 |
| DynaFlow (Direct) | 93.33 | 90.00 | 90.00 | 87.00 | 86.87 | 51.50 | 77.18 |
| DynaFlow (Dynamic) | 93.33 | 100.00 | 96.67 | 91.50 | 83.84 | 84.50 | 87.94 |
| DynaFlow (Forced) | 100.00 | 100.00 | 100.00 | 90.50 | 84.85 | 83.50 | 88.08 |
헤드라인은 Forced 88.08%와 Dynamic 87.94%이며, 논문은 둘 다 가장 강한 baseline을 10 percentage point 넘고 각각의 Base 대응 설정보다 높다고 서술한다. 가장 강한 baseline의 Overall은 Self-Refine의 77.18%이고(DynaFlow Direct도 같은 77.18%), 88.08 - 77.18 = 10.90이다(계산). Base 대비로는 88.08 - 75.87 = 12.21 percentage point이며 논문 Figure 2에도 +12.21 pts로 표기된다.
6.2 수학 추론
Forced 실행은 AIME 90문항 전부를 풀어 2024, 2025, 2026에서 모두 100%를 기록한다. PolyMATH에서는 Dynamic 91.50%, Forced 90.50%로 가장 강한 baseline(Self-Refine 87.50%)을 3–4 percentage point 넘는다. 저자들이 분석한 워크플로는 유도, 계산, 검증 단계가 서로 보완하도록 수학 풀이를 조직한다. 예컨대 PolyMATH 워크플로는 기호적 유도와 작은 인스턴스의 수치 검사를 짝지어 중간 식의 오류를 찾는다.
AIME 세부를 보면 AIME26에서 AFlow도 100.00%이고, AIME25 Dynamic도 100.00%이다. AIME24는 CoT와 Self-Refine이 96.67%, Forced가 100.00%이다.
6.3 과학 지식·추론: GPQA-Diamond
DynaFlow Forced는 84.85%로 Base, Forced(77.78%)를 7.07 point 앞서고 Base, Direct(83.33%)도 넘는다. Dynamic도 Base 대응(77.78%)보다 높은 83.84%이다. 그러나 논문은 Self-Refine과 AFlow가 이 벤치마크에서 여전히 앞선다고 명시한다. Table 1의 GPQA-D 열에서 Forced(84.85)와 Dynamic(83.84)보다 높은 baseline은 Self-Refine 88.38, AFlow 87.37, CoT-SC 85.86, CoT 85.35이다. 실패 사례 분석은 §10에서 다룬다.
6.4 웹 검색 다중 홉 QA: HotpotQA
DynaFlow는 Dynamic 84.50%, Forced 83.50%로 HotpotQA 최고 성능을 낸다. 둘 다 Base + Web search(77.50%)를 6–7 point 넘고, Forced는 같은 워크플로 요구 아래의 Base, Forced(81.50%)도 개선한다. 분석된 검색 워크플로는 중간 개체를 중심으로 검색을 조직하고 연속 홉 사이의 연결을 검증한다. 예로 한 워크플로는 먼저 장소와 연결된 도시를 식별하고, 도시의 별칭을 검색한 뒤, 두 홉이 같은 개체를 가리키는지 확인한다. 웹 검색이 없는 설정(CoT 46.50, Self-Refine 48.00, DynaFlow Direct 51.50, Base Direct 47.50)과 검색 가능한 설정은 접근 권한이 다르다.
7. 학습 단계 × 실행 모드
7.1 Table 2
Table 2는 Overall 정확도(%)를 학습 단계와 모드로 나눈 것이다. 행마다 메인 에이전트만 다르다.
| 메인 에이전트 | Direct | Dynamic | Forced |
|---|---|---|---|
| Base | 71.51 | 65.12 | 75.87 |
| Stage 1 | 76.74 | 84.45 | 85.47 |
| DynaFlow (Stage 2) | 77.18 | 87.94 | 88.08 |
Direct 열은 71.51 → 76.74 → 77.18로, Stage 1 이후 변화가 작다. 반면 Dynamic은 65.12 → 84.45 → 87.94, Forced는 75.87 → 85.47 → 88.08로 크게 변한다. 단계별 Forced 증가는 Base→Stage 1이 85.47 - 75.87 = 9.60, Stage 1→Stage 2가 88.08 - 85.47 = 2.61 point이다(계산).
7.2 학습 전에는 워크플로가 도움이 되지 않는다
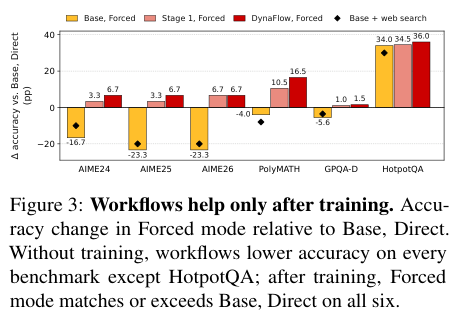
그림 2. Base, Direct 대비 Forced 모드 정확도 변화(percentage point). 학습하지 않은 워크플로는 HotpotQA를 제외한 모든 벤치마크에서 정확도를 낮추고, 학습 후 Forced는 여섯 벤치마크 모두에서 Base, Direct와 같거나 높다. 출처: Liu, Li, Wang, & Wang (2026), DynaFlow, arXiv:2610.34467v2, Figure 3, PDF p.5. 연구·학습 목적 인용.
Figure 3에 표기된 Base, Forced의 변화량은 AIME24 −16.7, AIME25 −23.3, AIME26 −23.3, PolyMATH −4.0, GPQA-D −5.6, HotpotQA +34.0이다. Stage 1, Forced는 +3.3, +3.3, +6.7, +10.5, +1.0, +34.5이고, DynaFlow, Forced는 +6.7, +6.7, +6.7, +16.5, +1.5, +36.0이다. 논문은 HotpotQA에서 워크플로가 검색을 가능하게 하므로 이 벤치마크만 학습 전에도 이득이 있다고 설명한다.
7.3 Stage 1의 효과
Stage 1 이후 Forced는 여섯 벤치마크 모두에서 Base, Direct 기준선과 같거나 높고, 같은 체크포인트의 Direct보다 Overall에서 8.73 point 높다(85.47 - 76.74). 여기에는 HotpotQA의 검색 이득이 포함된다. 저자들은 오케스트레이션 학습이 워크플로 접근을 효과적인 협업으로 바꾸며, 학습된 메인 에이전트의 단독 성능을 넘는 이득을 낸다고 해석한다. 이 패턴은 협업의 이득이 과제 특성과 조정 구조에 달려 있다는 선행 연구(Kim et al., 2026)와 일치한다고 인용된다.
7.4 Stage 2의 효과
Stage 2는 Forced와 Dynamic 성능을 모두 더 올린다. 논문은 이 향상이 더 높은 설계 품질, 상류 결과의 더 잦은 사용과 정제, Stage 1보다 적은 평균 서브 에이전트(4.16 대 4.35)를 동반한다고 연결짓는다(§8). Table 6 기준 Stage 2에서 Forced의 AIME24는 96.67 → 100.00, AIME25는 96.67 → 100.00, PolyMATH는 84.50 → 90.50이며, HotpotQA는 82.00 → 83.50, GPQA-D는 84.34 → 84.85로 변화가 작다.
8. 워크플로 구조와 정보 흐름
8.1 구조 지표 정의
논문은 Forced 모드에서 생성된 프로그램 P를 여섯 구조 차원으로 분석한다(Table 5).
| 차원 | 범주 |
|---|---|
| Execution structure | Code only, Single agent, Serial, Parallel, Hybrid |
| Role specialization | None, Homogeneous, Complementary, Mixed |
| Dependency pattern | None, Chain, Fan-out, Fan-in, Multi-stage |
| Output reuse | None, Passed(상류 출력이 전달되나 의미 있는 사용을 요구하지 않음), Consumed(상류 출력이 전달되고 하류 지시가 사용·분석·비교·정제·비평·변환을 명시적으로 요구) |
| Aggregation strategy | None, Concatenation, Selection, Voting, Comparison, Synthesis, Correction/refinement, Mixed |
| Agent count | 0, 1, 2, 3, 4, 5+ (결정적 코드·포맷팅·단순 tool 호출 제외) |
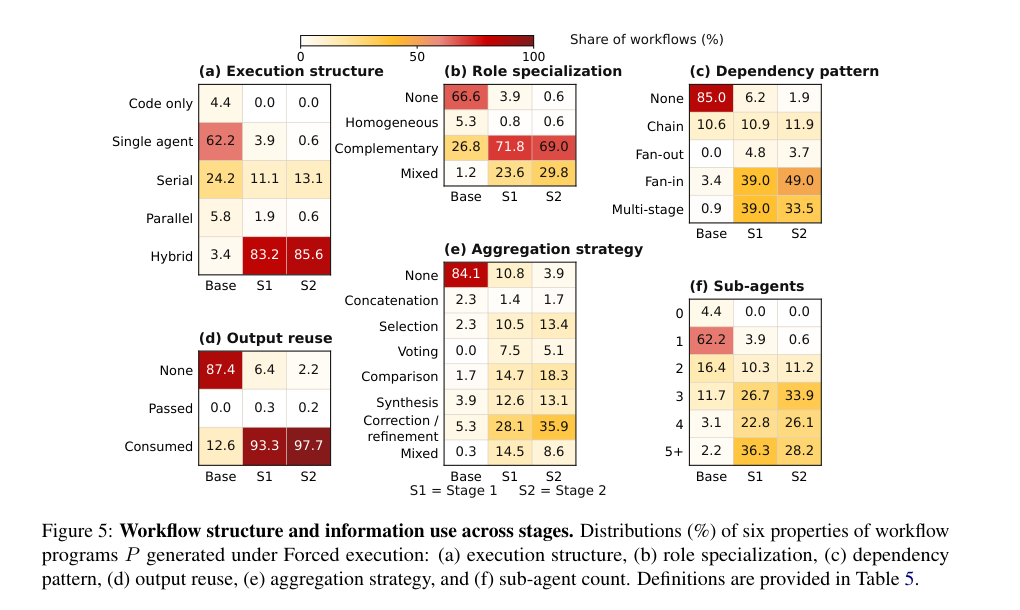
그림 3. Forced 실행에서 생성된 워크플로 프로그램 P의 여섯 속성 분포(Base, Stage 1, Stage 2): (a) 실행 구조, (b) 역할 특화, (c) 의존 패턴, (d) 출력 재사용, (e) 집계 전략, (f) 서브 에이전트 수. 출처: Liu, Li, Wang, & Wang (2026), DynaFlow, arXiv:2610.34467v2, Figure 5, PDF p.7. 연구·학습 목적 인용.
8.2 연결된 단계와 상류 출력 사용
Figure 5(a,c)에서 Base는 대체로 서브 에이전트 하나에 위임하거나 의존 없는 호출을 만든다. 학습된 프로그램은 대부분 병렬과 순차 단계를 결합하며, hybrid 워크플로는 Base 3.4%에서 Stage 1 83.2%, Stage 2 85.6%로 늘어난다. 상류 출력을 전달하고 하류 에이전트에게 사용을 명시적으로 지시하는 프로그램의 비율(Consumed)은 Base 12.6%, Stage 1 93.3%, Stage 2 97.7%이다. 저자들은 이를 메인 에이전트가 중간 결과가 이후 풀이와 검증에 어떻게 쓰여야 하는지를 점점 더 명시하게 된 변화로 해석하며, 단계 간 체계적 재사용이 가능해진다고 설명한다.
8.3 설계 품질과 결함 감소
Stage 1 오류 분석에서 저자들은 세 가지 반복 패턴을 식별했다. 메인 에이전트가 도입한 근거 없는 전제, 기대 결론 쪽으로 유도된 검증, 중간 정보의 불완전하거나 잘못된 전달이다. 이 관찰이 Stage 2의 선별 기준(§4.3)이 되었다. 선별 데이터로 학습한 뒤 네 설계 기준(Figure 4) 모두에서 결함 없는 워크플로의 비율이 더 높아졌다고 보고한다. 중대한 information-flow 결함은 Stage 1의 1.9%에서 Stage 2의 0.9%로 줄고, 중간 결과의 수정·정제를 명시하는 워크플로(Figure 5(e)의 Correction/refinement)는 28.1%에서 35.9%로 늘며, 평균 서브 에이전트 수는 Stage 1의 4.35에서 Stage 2의 4.16으로 줄어든다.
이 점수는 deepseek-flash가 프로그램만 보고 매긴 값이며 실행 결과는 반영되지 않는다(§5.4). 저자들은 Base의 logical-continuity 점수가 상대적으로 높은 이유를 Base 워크플로가 더 단순하고 흔히 단일 에이전트여서 단계 간 의존이 적기 때문이라고 해석한다.
8.4 과제별 역할 배분
Figure 6은 DynaFlow Forced 모드에서 실행된 서브 에이전트 노드의 역할 분포를 벤치마크 계열별로 보인다(AIME 세 해는 합산, 역할은 노드 라벨의 키워드로 Verifier, Aggregator, Interpreter, Researcher, Solver, Other 중 하나로 분류).
| 벤치마크 | 보고된 특징 |
|---|---|
| AIME, PolyMATH | Solver와 Verifier가 노드의 90% 넘게 차지 |
| HotpotQA | Researcher가 59.6% |
| GPQA-Diamond | 상당한 Solver 비중에 수학 벤치마크보다 많은 research |
| 전 과제 | Verification이 노드의 33.2–43.9% |
메인 에이전트는 서브 에이전트마다 목표, 관련 입력, 현재 질문에서 상류 결과를 쓰는 방식을 지정하는 프롬프트를 생성한다. 따라서 역할 분담과 지시문이 함께 과제에 맞춰진다. 저자들은 이전된 AFlow 워크플로와 비교해 이런 유연성이 질문별 수학적 유도, 증거 수집, 독립 검증을 지원한다고 서술한다.
9. 적응적 워크플로 호출과 사례 연구
9.1 Dynamic–Forced 격차의 축소
Table 2에서 Dynamic과 Forced의 Overall 격차는 Base 10.75 percentage point(75.87 - 65.12), Stage 1 1.02(85.47 - 84.45), DynaFlow 0.14(88.08 - 87.94)로 줄어든다. 저자들은 서브 에이전트가 고정되어 있으므로 이 추세가 선택적 협업에 대한 메인 에이전트 학습의 기여를 보여 준다고 해석한다. Base에서는 Dynamic(65.12)이 Direct(71.51)와 Forced(75.87) 모두보다 낮았다.
9.2 직접 답변 비율과 서브 에이전트 수
Dynamic 모드의 DynaFlow는 질문의 47.1%를 워크플로 없이 직접 답하면서 87.94%의 정확도를 보이며, Forced의 88.08%에 근접한다. 직접 답한 질문을 포함한 전체 평균에서 질문당 서브 에이전트는 2.44개로, Forced의 약 4.16개보다 약 41% 적다(1 - 2.44/4.16 \approx 0.41). 저자들은 단일 메인 에이전트 정책이 과제 요구에 맞게 풀이 전략을 조정하면서 더 적은 서브 에이전트로 성능을 유지할 수 있다고 본다. 직접 답변과 워크플로 실행 사이의 선택을 오케스트레이션의 일부로 보며, 에이전트를 늘린다고 성능이 반드시 오르지는 않고 협업은 질문별 필요에 따라 호출되어야 한다는 입장이다.
Figure 1은 질문당 평균 agent role 수 대비 Overall 정확도를 그리며, Forced 모드에서 Base의 75.9%가 DynaFlow의 88.1%로 오르고 Dynamic이 87.9%를 달성하며 질문의 47%를 워크플로 없이 답한다고 캡션에 쓴다.
9.3 부록 H의 사례 연구
부록 H는 Forced 실행의 Base와 DynaFlow 워크플로를 네 가지 사례(Figures 8–11)로 비교한다. 각 도식은 워크플로 프로그램과 실행 기록에서 재구성한 것이다.
| 사례 | Base | DynaFlow |
|---|---|---|
| AIME 2026 회문 개수 세기 | 솔버 하나가 산술 오류 후 59를 반환 | 열거, 동적 계획법, 포함-배제를 병렬 솔버에 할당하고 출력을 검증자에 넘겨 비교·독립 재계산. 세 솔버와 검증자가 모두 62를 얻음. 재시도 분기는 작동하지 않음 |
| GPQA-Diamond 반응 생성물 | 두 분석을 순차 실행하나 결과를 서로 전달하지 않음 | 서로 다른 화학적 제약마다 research 호출 네 개를 두고 후보 생성물을 확인. 두 확인 모두 초기 후보에 이의를 제기하고, 결정 에이전트가 research 증거와 검증 결과를 함께 받음 |
| HotpotQA 인물 식별과 연도 검색 | 투자 회사와 설립 연도를 검색(표시된 것은 세 호출 중 첫 호출) | 세 검색 경로로 후보 개체를 찾고 중복 제거·순위화한 뒤 이름, 인용, 출처를 후보별 resolution 에이전트에 전달. 이후 선택안을 확인. 상위 3개 제한 아래 두 후보를 resolve했고, 유효한 구조화 출력이 없는 호출은 걸러짐 |
| AIME 2025 기하 최적화 | 제공된 유도를 확인하고 고정 숫자 필드를 반환(두 번째 호출 표시) | 기하 구성, 병렬 최적화, 식 맞춤, 독립 감사를 연결. 두 감사가 후보를 확인하여 조건부 repair 호출은 실행되지 않음. 유효한 출력을 반환하지 않은 optimizer는 맞춤 전에 제외됨 |
저자들은 이 사례들이 논문 §5.3의 관찰, 즉 과제별 오케스트레이션이 에이전트가 무엇을 받고 어떻게 쓰며 출력이 이후 작업을 어떻게 이끄는지를 지정해 단계를 연결한다는 점을 예시한다고 쓴다.
10. 저자 논의와 결론
10.1 §6 Discussion
§6 Discussion에서 저자들은 과제 분해와 함께 신뢰할 수 있는 정보 사용이 오케스트레이션의 핵심이라고 보고, 서브 에이전트를 고정한 상태의 이득이 기존 능력을 조정하는 법을 학습한다는 관점을 뒷받침한다고 서술한다. Stage 2의 이득은 더 나은 정보 전달, 중간 결과의 더 잦은 정제와 함께 나타나며, 이는 근거 없는 전제, 제한된 검증, information-flow 결함을 선별한 것과 일치한다고 쓴다.
10.2 GPQA-Diamond 실패 분석
본문 §5.1과 §6은 GPQA-Diamond 실패 사례를 이렇게 기술한다. 서브 에이전트가 낸 잘못된 중간 결론이 이후 검증을 그르칠 수 있고, 메인 에이전트가 최종 답 종합 단계에서 올바른 증거에 우선순위를 두지 못할 수 있다. 올바른 중간 결과가 검증과 최종 종합 과정에서 손실되거나 덮어써지는 경우가 있다는 것이다. 저자들은 이를 워크플로 내부의 독립 검증과 메인 에이전트의 신뢰할 수 있는 최종 답 선택이 중요하다는 근거로 든다. GPQA-Diamond에서 Self-Refine과 AFlow가 앞선다는 점(§6.3)도 본문에 명시된다.
10.3 향후 과제
논문이 제시한 향후 연구는 두 가지다.
- 신뢰할 수 있는 정보 전달과 독립 검증을 위해 서브 에이전트를 학습한다.
- 첫 턴 감독을 불일치와 오류 결과가 포함된 다중 턴 궤적으로 확장한다. 이런 감독은 충돌하는 출력을 독립적으로 평가하고 오류를 식별하며 오류 복구, 워크플로 수정, 최종 답 선택을 위한 행동을 고르는 메인 에이전트의 능력을 강화할 수 있다고 저자들은 쓴다.
10.4 결론
DynaFlow는 자유 형식 실행 가능 워크플로 행동과, 궤적 증류 및 오케스트레이션 품질 기반 시연 선별의 2단계 메인 에이전트 학습을 결합하며 서브 에이전트는 고정한다. 여섯 벤치마크에서 평가한 방법 중 가장 높은 Overall 정확도(Forced 88.08%, Dynamic 87.94%)를 달성하고, Dynamic 실행은 질문의 거의 절반을 Forced에 근접한 정확도로 직접 답한다. 워크플로 분석은 학습이 구조와 중간 결과 사용을 어떻게 바꾸는지 보여 준다.
References
Dettmers, T., Pagnoni, A., Holtzman, A., & Zettlemoyer, L. (2023). QLoRA: Efficient finetuning of quantized LLMs. Advances in Neural Information Processing Systems, 36, 10088–10115.
Gao, H., Liu, Y., He, Y., Dou, L., Du, C., Deng, Z., Hooi, B., Lin, M., & Pang, T. (2025). FlowReasoner: Reinforcing query-level meta-agents. arXiv preprint arXiv:2504.15257.
Ke, Z., Ming, Y., Xu, A., Chin, R., Nguyen, X.-P., Jwalapuram, P., Wang, J., Yavuz, S., Xiong, C., & Joty, S. (2026). MAS-Orchestra: Understanding and improving multi-agent reasoning through holistic orchestration and controlled benchmarks. Proceedings of the 43rd International Conference on Machine Learning, 306, 56527–56570. PMLR.
Ke, Z., Xu, A., Ming, Y., Nguyen, X.-P., Chin, R., Xiong, C., & Joty, S. (2025). MAS-ZERO: Designing multi-agent systems with zero supervision. arXiv preprint arXiv:2505.14996.
Kim, Y., Gu, K., Park, C., Park, C., Schmidgall, S., Heydari, A. A., Yan, Y., Zhang, Z., Zhuang, Y., Liu, Y., Malhotra, M., Liang, P. P., Park, H. W., Yang, Y., Xu, X., Du, Y., Patel, S., Althoff, T., McDuff, D., & Liu, X. (2026). Capable language models can outgrow the benefits of collaboration. Nature Machine Intelligence, 8(7), 1157–1172.
Liu, R., Li, Q., Wang, S., & Wang, X. (2026). DynaFlow: Learning free-form multi-agent orchestration (Version 2, arXiv:2610.34467) [Preprint]. arXiv. https://arxiv.org/abs/2610.34467v2
Madaan, A., Tandon, N., Gupta, P., Hallinan, S., Gao, L., Wiegreffe, S., Alon, U., Dziri, N., Prabhumoye, S., Yang, Y., Gupta, S., Majumder, B. P., Hermann, K., Welleck, S., Yazdanbakhsh, A., & Clark, P. (2023). Self-Refine: Iterative refinement with self-feedback. Advances in Neural Information Processing Systems, 36, 46534–46594.
Rein, D., Hou, B. L., Stickland, A. C., Petty, J., Pang, R. Y., Dirani, J., Michael, J., & Bowman, S. R. (2024). GPQA: A graduate-level Google-proof Q&A benchmark. First Conference on Language Modeling.
Wang, X., Wei, J., Schuurmans, D., Le, Q. V., Chi, E. H., Narang, S., Chowdhery, A., & Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. The Eleventh International Conference on Learning Representations.
Wang, Y., Xu, Z., Huang, Y., Wang, X., Song, Z., Gao, L., Wang, C., Tang, R., Zhao, Y., Cohan, A., Zhang, X., & Chen, X. (2025). DyFlow: Dynamic workflow framework for agentic reasoning. Advances in Neural Information Processing Systems, 38, 174148–174181.
Wang, Y., Zhang, P., Tang, J., Wei, H., Yang, B., Wang, R., Sun, C., Sun, F., Zhang, J., Wu, J., Cang, Q., Zhang, Y., Huang, F., Lin, J., Huang, F., & Zhou, J. (2025). PolyMath: Evaluating mathematical reasoning in multilingual contexts. Advances in Neural Information Processing Systems, 38.
Yang, Z., Qi, P., Zhang, S., Bengio, Y., Cohen, W., Salakhutdinov, R., & Manning, C. D. (2018). HotpotQA: A dataset for diverse, explainable multi-hop question answering. Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, 2369–2380. Association for Computational Linguistics.
Ye, R., Tang, S., Ge, R., Du, Y., Yin, Z., Chen, S., & Shao, J. (2025). MAS-GPT: Training LLMs to build LLM-based multi-agent systems. Proceedings of the 42nd International Conference on Machine Learning, 267, 72063–72090. PMLR.
Zhang, J., Xiang, J., Yu, Z., Teng, F., Chen, X., Chen, J., Zhuge, M., Cheng, X., Hong, S., Wang, J., Zheng, B., Liu, B., Luo, Y., & Wu, C. (2025). AFlow: Automating agentic workflow generation. The Thirteenth International Conference on Learning Representations.
Zhang, M., Liu, W., Shen, T., Lin, Q., Mao, R., Cambria, E., Tang, X., & Luo, H. (2026). FlowSteer: Towards agents designing agentic workflows via reinforced progressive canvas editing. arXiv preprint arXiv:2602.01664.
Zhang, Y., Zhao, Y., Wang, N., Wu, Y., Chang, J., Chen, Y., Wu, Q., Zhao, J., & Wang, H. (2026). MetaAgent-X: Breaking the ceiling of automatic multi-agent systems via end-to-end reinforcement learning. arXiv preprint arXiv:2605.14212.
Keywords: DynaFlow, free-form orchestration, executable workflow, main agent training, Dynamic/Forced mode, Qwen3.5-27B Author: PaperWiki Last Updated: 2026-11-01