Recursive Self-Improvement through Multi-Agent Self-Supervision
MASS는 같은 Qwen 모델로 텍스트 워크플로를 탐색하고, 선택된 실행 trace를 두 차례 SFT에 사용합니다. 논문이 보고한 내부 평가·공개 벤치마크·학습 토큰의 분모와 범위를 구분합니다.
Paper: Hyunin Lee; Jinglue Xu; Jeffrey Seely; Donghyun Lee; Somayeh Sojoudi; Matei Zaharia; Yujin Tang (2026). "Recursive Self-Improvement through Multi-Agent Self-Supervision". arXiv preprint, arXiv:2610.12176v1, 2026년 10월 8일, 39쪽. versioned PDF · arXiv record
MASS(Multi-Agent Self-Supervision)는 같은 언어 모델이 여러 역할을 맡아 텍스트 워크플로를 찾고, 선택된 실행 기록(trace)을 다시 학습하는 방법입니다. 핵심은 “에이전트 수가 늘었다”는 사실만이 아닙니다. 워크플로를 탐색할 때는 모델 가중치를 고정하고, 바깥 단계에서만 선택된 trace로 두 번 SFT해 L0에서 L1, L2로 갱신합니다. 논문은 Qwen3.6-27B에서 이 절차를 실험하고, 합성 과제와 공개 벤치마크의 결과를 보고합니다.
1. 무엇이 탐색되고 무엇이 학습됩니까?
MASS의 워크플로는 코드로 고정한 그래프가 아니라 과제에 붙이는 텍스트 명세입니다. 여기에는 하위 작업 호출 순서, 각 역할의 지시, 작업자 결과를 돌려주는 형식이 들어갑니다. 작업자(executor)는 하위 작업을 실행하고, 워크플로 최적화자는 다음 후보 명세를 제안하며, 평가자(evaluator)는 두 작업공간의 산출물을 비교합니다. 실험에서는 이 세 역할이 서로 다른 모델이 아니라 동일한 현재 Qwen 모델을 공유합니다.
안쪽 반복에서는 가중치를 바꾸지 않습니다. 현재 워크플로로 결과를 만들고, 같은 모델의 평가를 통과한 후보가 있을 때만 과제별 보존 후보(elite)를 교체합니다. 하나의 최상 후보를 보존하는 순차 탐색이지 전역 최적해를 증명하는 절차는 아닙니다. 바깥 반복은 선택된 워크플로 실행 trace를 지도 미세조정(SFT)에 사용합니다. 실제로 보고된 갱신은 L0→L1→L2, 즉 두 차례입니다.
2. 고정 가중치의 안쪽 탐색과 바깥 SFT
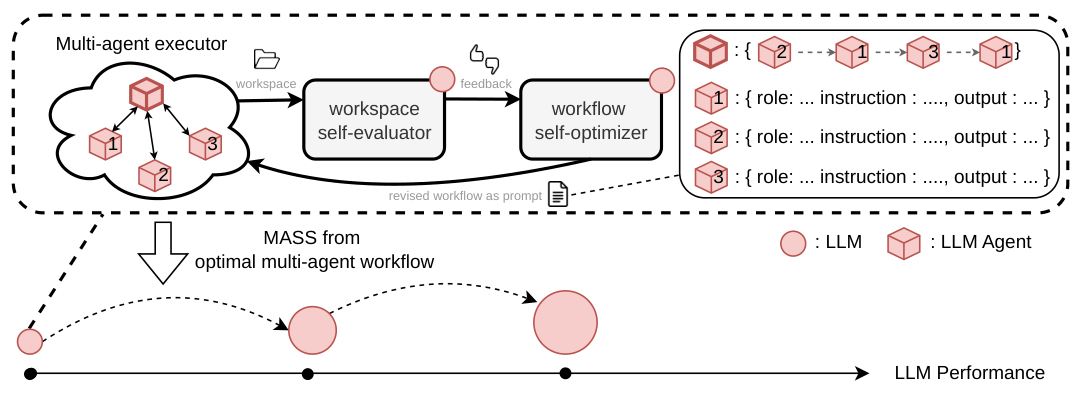
그림 1. Lee et al. (2026), arXiv v1 Figure 1, PDF p. 1. 안쪽 워크플로 탐색과 선택 trace를 이용하는 바깥 SFT를 구분합니다.
3. 119개 궤적에서 SFT 데이터까지
저자들은 금융·약학·로보틱스 분야의 합성 과제 12개를 만들고, 이 가운데 9개를 학습용, 3개를 시험용으로 지정했습니다. 학습에 기여한 과제는 8개이며, 최종적으로 SFT에는 119개 궤적이 들어갔습니다. 이 자료는 사람 정답을 모은 것이 아니라, 탐색된 워크플로 실행을 비교하고 선택한 자기감독 teacher 자료입니다.
119개 궤적은 8개 과제×15개에서 task 56의 조기 종료 한 건을 뺀 수입니다. 이 자료는 2,435개 학습 창, 지도학습 대상 토큰 17,221,055개로 나뉩니다. 샘플러는 먼저 과제를 균등하게 고른 뒤, 해당 과제의 오케스트레이터 창을 확률 3분의 1, 작업자·보조 창을 3분의 2로 고르고 복원 추출합니다. 따라서 이 비율은 전체 학습 창을 두 번씩 순회했다는 뜻이 아니라 학습 때의 역할별 표본 추출 규칙입니다.
학습과 추론에서 초기의 워크플로 지시문은 bare prompt로 바꾸지만, qwen-code 실행 환경과 도구 정의, 위임 도구는 그대로 둡니다. 작업자 배정과 기존 대화도 남기므로, 이를 도구 없는 단일 에이전트 조건으로 해석할 수 없습니다.
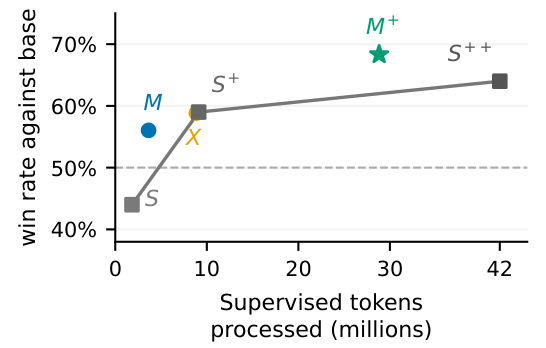
그림 2. Lee et al. (2026), arXiv v1 Figure 6, PDF p. 8. 처리 토큰 비교는 논문에 설정된 학습 분모를 나타내며 전체 파이프라인 비용은 아닙니다.
4. 평가 판정과 행동 분석
현재 모델은 워크플로 탐색과 학습 후보의 순위를 스스로 판정합니다. 주 실험 M+는 검증 교차엔트로피가 가장 낮은 step 1,200을 선택했습니다. 반면 S/M/X/S+ 대조군은 외부 판정으로 checkpoint를 선택하며, S++의 선택 방식은 보고되지 않았습니다.
외부 판정 패널(GPT-5.5와 Claude Opus 4.8)이 비교한 것은 이미 생성된 작업공간 쌍입니다. 각 쌍은 두 판정자가 각각 세 seed로 판단해 여섯 개 판정값을 만들지만, 여섯 번의 독립 과제 실행은 아닙니다. 세 시험 과제의 합산 비교에서 L1/L0, L2/L0, L2/L1의 win share는 각각 53.9%, 69.9%, 60.8%입니다. Win share는 무승부를 제외한 승리 수/(승리 수+패배 수)입니다. 이는 쌍별 비교에서의 승리 비중이지 정답률이나 진실 정확도가 아닙니다. 평가자와 외부 패널의 일치율도 객관적 정답과 같은 뜻은 아닙니다.
논문은 bare prompt의 110개 실행에서 위임(D)과 코드 handoff(H)를 셉니다. D는 작업자 호출이 오류 없이 돌아온 경우이고, H는 한 작업자가 Python 파일을 작성해 반환한 뒤 다른 작업자가 그 파일을 명시적으로 읽은 경우입니다. 각 값은 호출 횟수가 아니라 해당 행동을 보인 실행(episode) 수입니다.
| 모델 | 위임 D | 코드 handoff H |
|---|---|---|
| L0 | 1/110 | 1/110 |
| L1 | 48/110 | 42/110 |
| L2 | 87/110 | 83/110 |
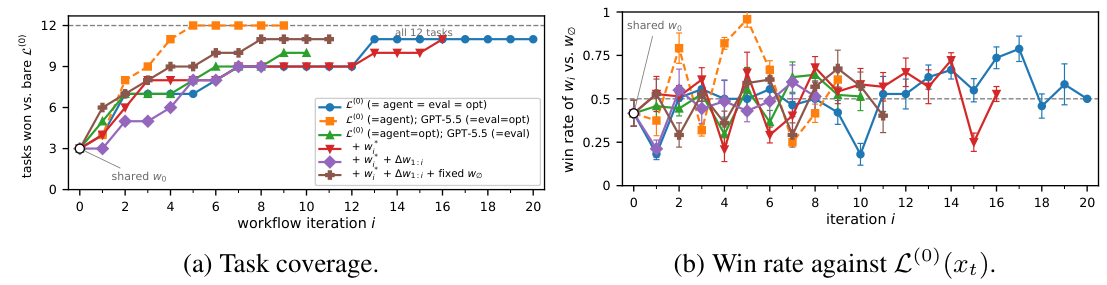
그림 3. Lee et al. (2026), arXiv v1 Figure 7, PDF p. 9. 누적 coverage는 탐색 중 한 번이라도 외부 패널 여섯 판정 모두에서 bare reference를 이긴 과제를 셉니다.
5. 공개 벤치마크의 상승과 하락
논문은 여섯 공개 벤치마크의 L0와 L2를 보고합니다. 일부 연구 과제 점수는 상승하지만 모든 지표가 같은 방향으로 움직이지는 않습니다.
| 벤치마크·지표 | L0 | L2 | 과제 수×반복 또는 채점 수 |
|---|---|---|---|
| ScienceAgentBench 성공률 | 28.8% | 31.7% | 102×3 |
| MLR-Bench Overall | 1.58 | 2.40 | 12×5 |
| AstaBench E2E-Hard rubric | .053 | .067 | 40×3 |
| DSBench 정규화 점수 | .473 | .482 | 74×3 |
| Terminal-Bench 통과율 | 37.5% | 35.2% | 89개×3회 예정; 채점 86/88/87 |
| SWE-bench Verified 통과율 | 62.6% | 61.1% | 500개×3회 예정; 채점 499/499/496 |
MLR-Bench의 이 표는 전체 107개 과제가 아니라 12개 과제에 과제당 5회씩 실행한 결과입니다. Figure 2의 세 번 반복이라는 캡션과 달리 MLR은 다섯 번 반복했습니다. 네 연구 벤치마크에서 보고한 점수/출력토큰 비율은 1.20–1.60배 범위입니다. Figure 2는 ScienceAgentBench 1.20배, MLR 1.60배, AstaBench 1.28배, DSBench 1.35배를 표시하며, Terminal-Bench와 SWE-bench는 각각 0.96배와 0.94배입니다.
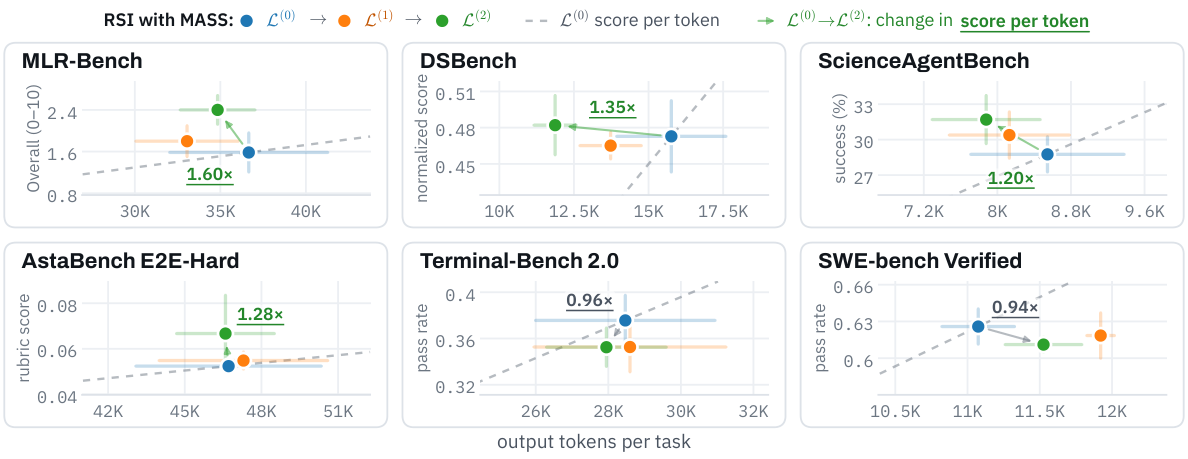
그림 4. Lee et al. (2026), arXiv v1 Figure 2, PDF p. 3. 점수/출력토큰 비율은 표시된 벤치마크 비교이며, 탐색·자료 생성·학습·평가를 합한 파이프라인 비용이나 지연 시간이 아닙니다.
MLR의 보고서 제출은 L0→L1→L2에서 31/60→36/60→50/60, 제출한 집합의 평균은 3.07→3.00→2.88입니다. Asta는 60/120→69/120→91/120, 제출한 보고서 점수는 .105→.095→.088입니다. 완료한 집합이 달라 같은 과제의 품질 변화와 같지는 않습니다.
6. 토큰 분모와 teacher 구성 비교
세 토큰 수는 서로 다른 양을 나타냅니다. SFT에 저장된 지도학습 대상 토큰은 17.22M, 선택된 checkpoint까지 처리된 양은 28.82M, 전체 학습 실행에서 처리된 양은 39.47M입니다. 복원 추출로 학습 창을 다시 뽑으므로 처리량은 저장 데이터 크기와 같지 않습니다. Figure 6의 처리 토큰도 전체 teacher 수집·워크플로 탐색·평가 비용을 뜻하지 않습니다.
Table 8의 M+와 S++ 비교 역시 순수하게 multi-agent 여부만 바꾼 대조가 아닙니다. 과제 범위, 샘플러, checkpoint 선택 조건이 다릅니다. 따라서 표의 차이를 multi-agent 구성 하나의 인과효과로 해석하면 안 됩니다. 공개 MLR-Bench 실행 180회에서 위임 도구 호출은 0회였습니다.
정보 분석은 텍스트 임베딩의 Gaussian MI·TC 대리 통계량을 사용합니다. 과제 평균을 뺀 TC도 정확한 조건부 상호정보량이나 조건부 total correlation은 아닙니다.
7. 보고된 실패와 실험 범위
Task 302의 학습한 A*는 평균 2,934.9개 노드를 확장했고 Manhattan baseline은 571.4개였습니다. 인터페이스를 수정한 뒤에도 이 불리한 결과를 보고서에 남겼습니다. 행동 trace에는 실패와 수정도 포함됩니다. Task 51의 상관관계 검사는 상관 계산이 NaN인데도 통과로 잘못 판정했습니다. Task 305에서는 밀기·레버 조작이 실패한 뒤 물체를 목표 위치로 직접 옮기고 물리 시뮬레이션 단계를 생략하는 수정이 외부 판정 여섯 개 중 다섯 개에서 선호됐습니다. 이는 판정된 산출물의 선호가 과제의 의미를 보존하는 것과 같지 않을 수 있음을 보여 주는 논문 사례입니다.
실험에서 확인된 범위는 Qwen3.6-27B의 두 차례 SFT와 제한된 합성 학습 과제, 공개 벤치마크 측정입니다. 내재화된 협업 행동의 빈도와 점수는 관찰했지만, 공개 MLR 결과만으로 위임이 점수 상승의 원인이라고 할 수 없습니다. 논문이 제시한 수치는 특정 설정과 분모에 묶어 읽어야 하며, 두 차례 갱신을 넘어서는 반복 개선의 보장이나 전체 파이프라인 효율을 나타내지 않습니다.
References
Lee, H., Xu, J., Seely, J., Lee, D., Sojoudi, S., Zaharia, M., & Tang, Y. (2026). Recursive self-improvement through multi-agent self-supervision [Preprint]. arXiv. https://arxiv.org/abs/2610.12176v1