Recursive Self-Improvement through Multi-Agent Self-Supervision
MASS는 같은 Qwen 모델로 텍스트 워크플로를 탐색하고, 선택된 실행 trace를 두 차례 SFT에 사용합니다. 논문이 보고한 내부 평가·공개 벤치마크·학습 토큰의 분모와 범위를 구분합니다.
Paper: Hyunin Lee; Jinglue Xu; Jeffrey Seely; Donghyun Lee; Somayeh Sojoudi; Matei Zaharia; Yujin Tang (2026). "Recursive Self-Improvement through Multi-Agent Self-Supervision." arXiv preprint, arXiv:2610.12176v1, 8 October 2026, 39 pp. versioned PDF · arXiv record
논문 요약
MASS(Multi-Agent Self-Supervision)는 하나의 언어 모델이 task executor, workflow optimizer, evaluator 역할을 맡는 방법이다. 모델은 텍스트로 표현한 multi-agent workflow를 제안하고 실행 결과를 비교해 선택한 뒤, 선택된 orchestrator와 worker trace를 supervised fine-tuning하여 다음 모델을 만든다. 논문은 Qwen3.6-27B에서 L(0)→L(1)→L(2)의 두 cycle을 실행하고, 네 연구 benchmark에서 score/output-token 비율 1.20–1.60배를 보고한다.
핵심 내용
| 질문 | v1에서 확인되는 답 |
|---|---|
| 무엇을 최적화했나? | 가중치를 고정한 inner loop가 텍스트 workflow w를 task별로 탐색하고, outer SFT가 그 trace를 shared weight에 내재화한다. |
| 누가 판단하나? | 주 loop의 실행자·optimizer·in-loop evaluator는 모두 현재 L^(g)다. 외부 GPT-5.5/Claude Opus는 사후 보고용이며 SFT target이 아니다. |
| recursive 범위 | 일반 알고리즘은 R회 update로 표기되고, 실험은 L(0)→L(1)→L(2)의 두 cycle을 보고한다. |
| teacher 데이터 | 지정 train 9개 중 221을 빼고 8개가 기여했다. 후보 18개 중 상위 15개를 train, 16위를 validation으로 두고 task 56 조기종료 하나를 제외해 119 trajectory가 남았다. |
| SFT 노출 | 2,435 windows(282 orchestrator, 2,054 worker, 99 auxiliary), 저장 supervised target 17,221,055개. task를 균등 선택한 뒤 role을 1/3 대 2/3로 나누고 replacement sampling한다. |
| headline 결과 | 세 synthetic test task의 test win share는 L1/L0 53.9%, L2/L0 69.9%, L2/L1 60.8%; train pooled는 65.6%→82.5%다. 외부 judge agreement는 73%→91%→93%로 보고된다. |
| public 결과 | ScienceAgent 28.8→31.7%, MLR 1.58→2.40, Asta .053→.067, DS .473→.482, Terminal 37.5→35.2%, SWE 62.6→61.1%로 보고된다. MLR의 Table 7 pool은 12 tasks×5 trials다. |
목차
- 텍스트 workflow와 두 겹의 루프
- teacher 수집부터 SFT checkpoint까지
- 평가 역할, 분할, 그리고 전이 해석
- 공개 benchmark의 분모와 실제 결과
- token 효율과 teacher-composition 대조군
- 정보분석·행동 audit·runtime 변동성
- 논문에 보고된 한계와 실패 사례
2. 텍스트 workflow와 두 겹의 루프
논문에서 workflow는 실행 코드의 graph object가 아니라 task prompt에 붙는 텍스트 specification이다. 핵심 표기는 다음과 같다.
w_t:=\{h_t,(r_{t,j},u_{t,j},c_{t,j})_{j=1}^{m_t}\}.h는 subagent 호출 순서(hop), r은 role, u는 instruction, c는 orchestrator에 반환할 output contract다. 실행은 A(x_t ⊕ w_t; L_agent)로 이루어진다. 계약은 각 worker가 무엇을 보고해야 하는지, hop은 어느 결과가 다음 worker의 입력이 되는지를 텍스트로 유도한다. optimizer prompt는 h와 contract를 role·instruction보다 중시하라고 말로 지시하지만, 숫자 가중치나 별도 objective를 주지는 않는다.
Inner search에서 현재 workflow가 산출한 workspace와 incumbent workspace를 같은 모델이 비교한다.
d_{t,i}=L_{eval}(y_t^{(i)},y_t^*;x_{eval}),\qquad y_t^{(i)}\succ y_t^*\Rightarrow (w_t^*,y_t^*)\leftarrow(w_t^{(i)},y_t^{(i)}).각 task에는 elite 하나만 유지된다. 후보가 incumbent를 대체하지 않으면 보존 workflow와 output은 그대로다. 다음 optimizer는 작업·최적화 지침과 함께 직전 proposal, retained champion, 누적 verdict/rationale 이력 D를 입력받는다(Algorithm 2, p.15). 기각된 실행은 그 verdict/rationale을 통해 반영되며, 모든 proposal archive나 실행 workspace 전체가 optimizer에게 전달된다는 뜻은 아니다. 논문은 w*를 “best self-judged workflow”라고 부른다.
Outer loop는 inner search의 workflow를 weight update로 바꾼다. 세 역할은 같은 현재 model이 맡는다.
L_{agent}=L_{eval}=L_{opt}=L^{(g)},\qquad L^{(g)}\xrightarrow[\text{SFT on selected traces}]{}L^{(g+1)}.알고리즘 표기는 임의의 R에 대해 L^(0),…,L^(R)를 허용하지만, 실험은 L(0)→L(1)→L(2) 두 cycle을 보고한다. 공개 benchmark 표에서 Terminal-Bench는 37.5→35.3→35.2, SWE-bench는 62.6→61.8→61.1, DSBench는 .473→.465→.482로 보고된다.
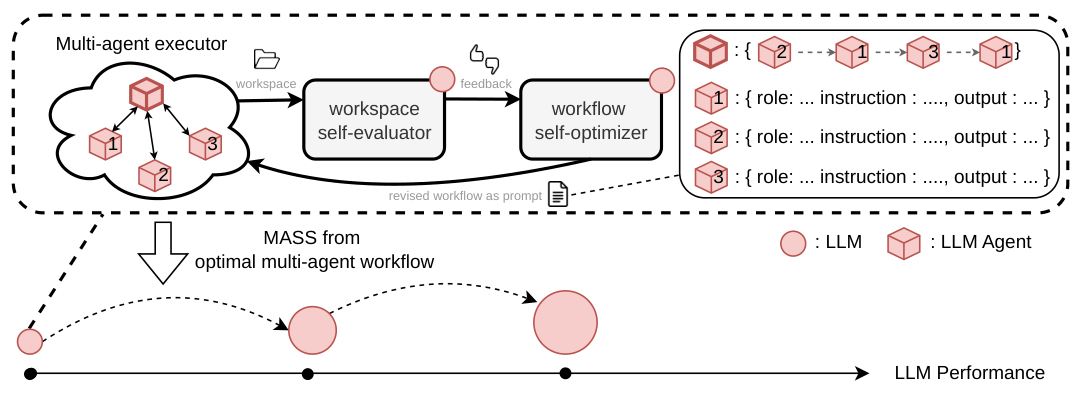
그림 1. 출처: Lee et al. (2026), v1, Figure 1 (p. 1). 현재 모델이 agent·evaluator·optimizer 역할을 맡고, 선택된 multi-agent trace가 다음 모델의 SFT 입력이 되는 구조를 나타낸다.
3. teacher 수집부터 SFT checkpoint까지
비공개 합성 benchmark는 GPT-5.5가 생성한 finance·pharmacy·robotics 각 네 task, 총 12개다. 그중 9개를 train으로 지정하고 3개(60, 207, 305)를 post-training에서 held out test로 둔다. workflow search가 reference를 이기지 못한 train task 221은 teacher 수집에서 제외되어 실제 SFT 기여 task는 8개다. 각 task에서 보존된 workflow로 18개 표본추출 seed의 후보를 만들고 Bradley–Terry 쌍별 ranking을 적용한다. 상위 15개가 train, 16위가 validation이다. task 56에서 coding-agent harness가 조기 종료한 train trajectory 하나를 다시 제외하여 8×15−1=119가 된다. teacher 후보는 self-evaluation ranking을 거쳤다.
사람이 고정한 directive는 agent tool로 실제 worker를 호출하고 run_in_background:false로 foreground 실행하며, 입력이 준비된 뒤 범위가 정해진 작업을 주고 절대 경로·검증 명령을 포함한 self-contained prompt를 작성하라고 요구한다. 각 report를 확인한 뒤 다음 단계로 가는 bounded verification도 포함한다. 논문은 이 directive 아래 teacher trace를 수집한다.
반대로 SFT 입력의 orchestrator 첫 task–최적 workflow–directive prompt는 bare task로 바꿨고, bare 추론과 public benchmark에도 최적 workflow prompt를 주지 않았다. qwen-code harness·tool 정의·delegation tool은 유지되었다. worker assignment와 기존 conversation은 남았고 auxiliary runtime conversation도 target에 포함된다.
trajectory는 2,435 window로 렌더링된다. 구성은 orchestrator 282개, worker 2,054개, auxiliary 99개이며 저장된 assistant supervised target은 정확히 17,221,055개다. 한 window의 최대 길이는 49,152 token이고, 앞 문맥은 최대 8,192 token까지 보존하되 loss에서 mask한다. system/user prompt, tool output, overlapping context는 target이 아니다. assistant reasoning·text·tool call만 target이다. window마다 target 수가 다르고 sampling은 replacement 방식이다.
샘플러는 먼저 task를 균등 선택하고, 해당 task의 orchestrator group을 확률 1/3, worker/auxiliary group을 확률 2/3로 고른 뒤, 선택 group에서 window를 균등하게 복원추출한다. 따라서 2:1은 role reweighting이며 2 epochs나 trajectory 수의 비율이 아니다. window z=(z_1,…,z_|z|)의 assistant mask를 μ_l이라 하면 논문의 window-normalized masked CE는 다음과 같다.
\ell_{SFT}(\theta)=-\mathbb{E}_{z\sim q}\left[\frac{\sum_{\ell=1}^{|z|}\mu_\ell\log p_\theta(z_\ell\mid z_{<\ell})}{\sum_{\ell=1}^{|z|}\mu_\ell}\right],\qquad \mu_\ell\in\{0,1\}.여기서 q는 저장 window에 대한 실제 sampling distribution이다. BF16 parent에 fresh LoRA(rank 64, scaling 128, dropout .05)를 초기화하고 AdamW로 학습한 뒤 serving에서는 merged model을 block-FP8으로 양자화한다. 첫 cycle SFT만 6×H100에서 약 19시간 걸렸다(탐색·teacher 수집·외부평가는 제외). 1,624 optimizer steps, step당 3 windows, 즉 명목상 4,872 window draws다. checkpoint는 매 50 step 저장하고 validation CE를 초기·150 step 간격·끝에서 계산했다. 선택점은 minimum assistant-token validation CE인 step 1,200이다. 외부 judge가 그 checkpoint를 고른 것이 아니다.
S/M/X/S+ 대조군은 외부 strong-model judgment로 checkpoint를 선택했다고 논문이 명시하지만, S++의 선택 절차는 Table 8에 보고되지 않는다. 두 번째 cycle은 merged L1 위에 fresh adapter를 올리고 같은 recipe를 재사용했다고 보고한다.
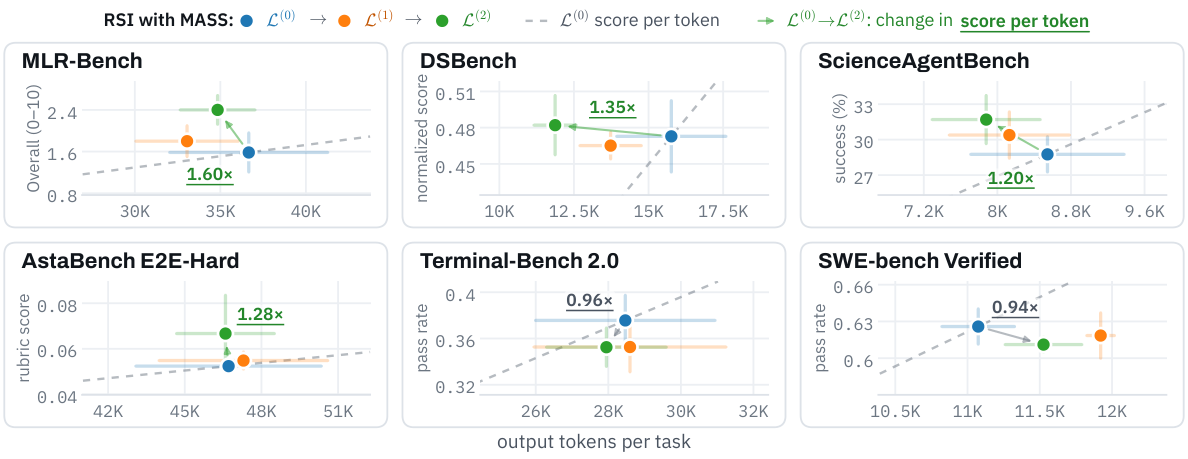
그림 2. 출처: Lee et al. (2026), v1, Figure 2 (p. 3). 화살표는 네 연구 benchmark의 score/output-token 비율을 나타낸다.
4. 평가 역할, 분할, 그리고 전이 해석
주 loop에서 현재 Qwen은 workspace pair를 self-judge하고 같은 모델로 Bradley–Terry teacher ranking을 수행한다. validation loss가 checkpoint를 고른다. 논문에서 “homogeneous in-loop”는 이 세 역할에 같은 weight를 쓴다는 의미다. GPT-5.5와 Claude Opus 4.8은 실행 후 workspace pair를 보고할 때 사용되며, verdict와 rationale은 agent·optimizer·SFT target에 들어가지 않는다. 각 pair에는 두 judge가 각각 seed 42, 43, 44로 총 6개 판단을 내린다. 여섯 판단은 같은 두 workspace를 평가한 것이며 여섯 독립 task execution이 아니다. win share는 ties를 제외한 W/(W+L)이다.
세 synthetic test task의 main 비교는 L1/L0 53.9%, L2/L0 69.9%, L2/L1 60.8%다. train pooled는 Figure 3b에서 65.6%에서 82.5%로 보고된다.
| task | split | pairs | wins–losses–ties (student 관점) | win share |
|---|---|---|---|---|
| 60 | test | 10 | 29–31–0 | 48.3% |
| 207 | test | 10 | 27–33–0 | 45.0% |
| 305 | test | 10 | 41–19–0 | 68.3% |
| test pooled | 3 tasks | 30 | 97–83–0 | 53.9% |
이 첫-cycle 비교는 student rollout을 고정된 bare-base reference와 index로 짝지으며, 같은 index가 같은 generation seed를 뜻하지는 않는다(Appendix C.2, pp.18–19). 공통 대조군의 다섯 task(51, 53, 56, 307, 60)는 같은 reference 목록을 사용하고, 나머지 여섯 task의 base reference에는 성공 종료와 예상 출력 파일명 중 존재하는 비율인 deliverable coverage 0.6 이상이라는 선택 조건이 있다. 따라서 이 승률은 무작위·무필터 base 실행 모집단이 아니라 선택된 fixed-reference set과의 비교다.
따라서 처음 두 test task의 L1/L0 win share는 50% 아래다. 69.9%는 두 cycle 뒤의 L2/L0 비교에서 보고된 pooled share다. external agreement 0.73→0.91→0.93은 self-evaluator verdict와 외부 panel 판단의 일치도를 나타낸다.
Table 6에서 bare-prompt M+를 순위로 선택된 workflow-prompted teacher와 비교하면 108 pairs의 판단이 112승·536패·0무, 승률 17.3%다. Task 207은 두 teacher 실행이 중단되어 비교 가능한 reference가 8개였고, test teacher들은 평가용으로만 생성됐다.
Appendix B.1은 test 세 task가 SFT·validation·checkpoint selection에서 제외되었다고 한다. workflow search는 12개 전체 task에서 별도로 수행된다.
Figure 7은 executor를 L0으로 고정하고 evaluator/optimizer를 바꾼 search-speed 비교와, discovery 단계에서 optimizer·evaluator·executor가 모두 L1인 workflow의 L0 executor transfer 결과를 보고한다. 따라서 64% transfer 조건은 optimizer만 바꾼 비교가 아니다. Figure 7a의 coverage는 search 중 한 번이라도 외부 panel의 6/6 만장일치로 bare reference를 이긴 task 수를 누적한 값이다.
5. 공개 benchmark의 분모와 실제 결과
L0·L1·L2와 모든 public benchmark 실행은 qwen-code 0.20.0, 같은 harness·tool 정의·delegation tool, bare instruction을 사용하며 optimized workflow는 주입하지 않았다. 제거한 것은 prompt이지 harness나 도구가 아니다. Table 7은 trial mean의 표본 SD다. 실제 분모는 다음과 같다.
| benchmark / metric | L0 | L1 | L2 | 실제 실행·trial |
|---|---|---|---|---|
| ScienceAgentBench success | 28.8±1.5% | 30.4±2.0% | 31.7±2.0% | 102 tasks×3 |
| MLR-Bench Overall (0–10) | 1.58±.38 | 1.80±.30 | 2.40±.28 | 12 tasks×5 |
| AstaBench E2E-Hard rubric | .053±.002 | .055±.004 | .067±.017 | 40 tasks×3 |
| DSBench normalized | .473±.029 | .465±.011 | .482±.025 | 74 tasks×3 |
| Terminal-Bench pass | 37.5±2.2% | 35.3±2.1% | 35.2±1.7% | 89 scheduled, scored 86/88/87 |
| SWE-bench Verified pass | 62.6±1.4% | 61.8±1.9% | 61.1±.6% | 500 scheduled, scored 499/499/496 |
MLR benchmark 자체는 107개 task로 소개되지만, v1 C.5/Table 7에 보고된 실험은 12개 task 부분집합을 5회씩 실행한 결과다. Figure 2 caption의 “all three trials”는 Table 7의 5 trials와 다르다. ScienceAgent prose는 28.7%→31.8%, Table 7은 28.8%→31.7%를 보고하며, counts는 28/102,31/102,29/102→30/102,34/102,33/102다.
Figure 2의 score/output-token 비는 MLR 1.60×, DS 1.35×, ScienceAgent 1.20×, Asta 1.28×이며 Terminal .96×, SWE .94×다. 1.20–1.60×는 네 연구 benchmark의 도표 label이다. 이 비율은 search·teacher generation·SFT·judge·wall-clock·비용을 포함한 총량이 아니다.
MLR paper delivery는 31/60→36/60→50/60, delivered subset conditional mean은 3.07→3.00→2.88로 보고된다. 세대별 delivered set은 다르며 aggregate에는 missing paper가 0으로 들어간다. Asta report delivery는 60/120→69/120→91/120, delivered report rubric은 .105→.095→.088이다. 논문은 180 MLR execution에서 delegation tool 호출 0회를 보고한다.
평가 방식은 benchmark마다 다르다. Asta와 MLR은 LLM rubric judge에 의존하고, ScienceAgent와 DSBench는 공식 evaluator, Terminal/SWE는 hidden test suite를 쓴다.
ScienceAgent local reference programs의 success는 80.4%였으며, 논문은 package 차이와 900초 evaluator limit에 따른 일부 실패를 보고한다.
6. token 효율과 teacher-composition 대조군
Table 8은 SFT teacher composition을 비교하지만, 모두가 같은 dataset·sampler·checkpoint rule을 쓰는 matched experiment는 아니다. 표의 다섯 shared evaluation tasks는 train 4개(51, 53, 56, 307)와 test 60 하나다. “All five”는 private benchmark의 모든 test task나 public benchmark 전체가 아니다.
| arm | episodes | stored M | processed M | win share vs base |
|---|---|---|---|---|
| S | 17 | .90 | 1.82 | 44.0% |
| M | 17 | 2.27 | 3.64 | 56.0% |
| X | 34 | 3.17 | 8.85 | 58.8% |
| S+ | 78 | 4.43 | 9.11 | 59.0% |
| S++ | 290 | — | 42.00 | 64.0% |
| M+ (= L1) | 119 | 17.22 | 28.82 | 68.3% |
M+는 8 train task, 다른 task/role sampler, 3 windows/step, validation-loss checkpoint를 쓴다. S/M/X/S+는 다른 sampler와 외부 judge checkpoint 선택을 쓴다. 따라서 68.3% 대 64.0%는 multi-agent만 바꾼 head-to-head가 아니다. test 60만 보면 M+와 S+가 모두 48.3%이고, 다섯 task pooled 값은 test 전체가 아니다.
논문은 M+가 S++보다 processed token을 31.4% 적게 사용하고 base 대비 4.3 percentage-point 차이를 보였다고 보고한다. 두 arm은 직접 head-to-head가 아니다.
저장 dataset의 supervised target은 17,221,055개, 선택된 step 1200까지 replacement draw로 처리한 target은 28,818,370개, full M+ run은 39,465,522개다. Figure 6은 두 번째 수를 사용하며 이후 update·validation·teacher generation·workflow search·evaluation은 포함하지 않는다.
teacher output quality 분석에서 multi-agent eligible episode의 평균 generated token은 141,844, single-agent는 59,355다. Table 9의 외부 판단은 총 824개 중 multi-agent 선호 701, 비선호 123으로 85.1%다. 길이 comparable 조건은 10 pairs에서 32–8, 80.0%이고, same workflow+comparable length 조건은 4 pairs에서 15–1, 93.8%다. 같은 workflow 비교에서도 directive는 multi-agent 쪽에 남는다. episode는 성공·deliverable coverage 조건으로 선별되고 opponent가 재사용된다.
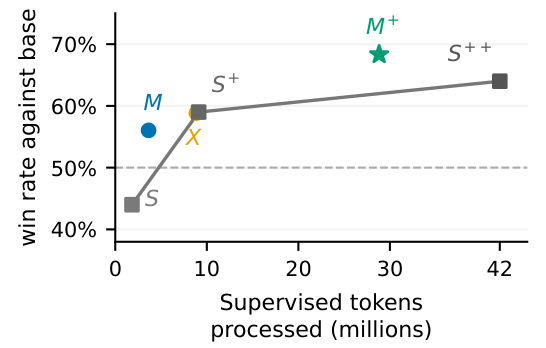
그림 3. 출처: Lee et al. (2026), v1, Figure 6 (p. 8). 직선은 세 single-agent 관측점을 잇는 reference다. 숫자의 분모는 processed supervised target이다.
7. 정보분석·행동 audit·runtime 변동성
논문은 workflow가 시간이 지나며 역할보다 contract와 hop에 task-specific information을 담는다는 가설을 점검한다. component와 task description을 embedding한 뒤 CCA로 Gaussian mutual-information proxy를 계산하고, four component covariance의 log-determinant 차이로 total-correlation proxy를 계산한다.
\widehat I(Z_c;T)=-\frac12\sum_j\log(1-\kappa_{c,j}^2),\qquad
\widehat{TC}(Z)=\frac12\left[\sum_c\log\det\Sigma_c-\log\det\Sigma\right].
두 embedding은 text-embedding-3-large와 all-mpnet-base-v2, PCA 10차원, covariance shrinkage .1, permutation 400회를 쓴다. task 평균을 뺀 TC(Z|T)는 exact conditional mutual information이나 conditional total correlation이 아니라 같은 Gaussian estimator를 적용한 task-centered 통계량이다.
표본은 독립이 아니다. retained crown path의 task는 8–9개, agent는 43–51개이고 같은 workflow 안에서 task description과 hop을 공유한다. 모든 proposal이 아니라 retained path만 분석한다. unconditional TC는 네 설정에서 낮아졌지만 task-centered 값은 세 설정만 낮고, permutation-adjusted MPNet은 2.39→2.57로 올랐다.
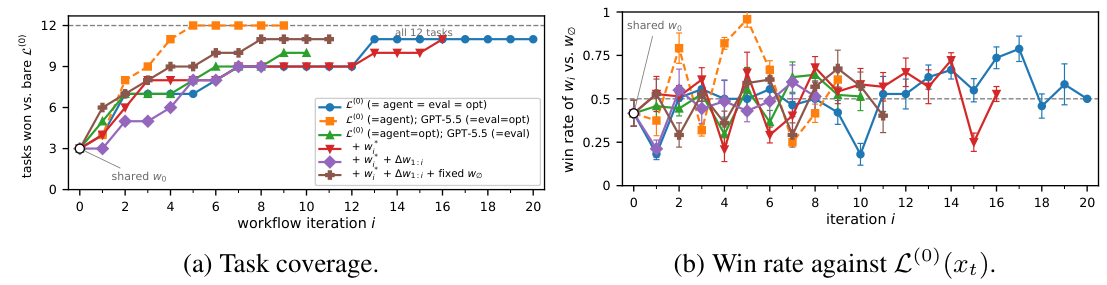
그림 4. 출처: Lee et al. (2026), v1, Figure 7 (p. 9). 외부 panel 6/6 만장일치 coverage는 search 중 한 번이라도 그 승리가 관찰된 task 수다.
행동 audit은 bare task prompt에서 delegation(D)과 code handoff(H)를 센다. D는 worker call이 tool error 없이 돌아온 경우, H는 한 worker가 Python file을 쓰고 반환한 뒤 다른 worker가 latest writer의 file을 명시적으로 읽은 경우다. import나 shell 내부 read/write는 세지 않는다.
| model | prompt | D | H | revision | main edit |
|---|---|---|---|---|---|
| L0 | bare | 1/110 | 1/110 | 0/110 | 1/110 |
| L1 | bare | 48/110 | 42/110 | 10/110 | 14/110 |
| L2 | bare | 87/110 | 83/110 | 39/110 | 12/110 |
| base | generic directive | 110/110 | 103/110 | 40/110 | 32/110 |
| L1 | generic directive | 110/110 | 106/110 | 56/110 | 13/110 |
base도 generic directive 아래 D 110/110, H 103/110을 수행한다.
8. 논문에 보고된 한계와 실패 사례
Task 302에서는 학습한 A* heuristic의 평균 node expansion이 2,934.9개, Manhattan baseline은 571.4개였다. 인터페이스 불일치를 수정한 뒤에도 보고서에는 학습한 heuristic의 불리한 결과가 남았다.
논문은 task 305에서 push/lever 수행 실패 뒤 physical force motion으로 goal을 직접 repositioning하고 simulation step을 제거한 revision을 보고한다. 외부 judge 6개 중 5개가 수정된 workspace를 선호했다.
task 51의 supervised recall trace에서는 post-event return과 target의 겹침을 발견한 뒤 worker가 embargo를 넓히도록 수정했다. 첫 diagnostic은 NaN correlation을 pass로 잘못 처리했다.
References
Lee, H., Xu, J., Seely, J., Lee, D., Sojoudi, S., Zaharia, M., & Tang, Y. (2026). Recursive self-improvement through multi-agent self-supervision [Preprint]. arXiv. https://arxiv.org/abs/2610.12176v1